

Python大数据量绘图性能优化:该选Bokeh还是Datashader
面对数十万至上千万级别的大规模数据可视化,深入对比Bokeh与Datashader的渲染机制、性能瓶颈、数据承载边界及交互差异,提供明确的选型决策树与实战优化代码。
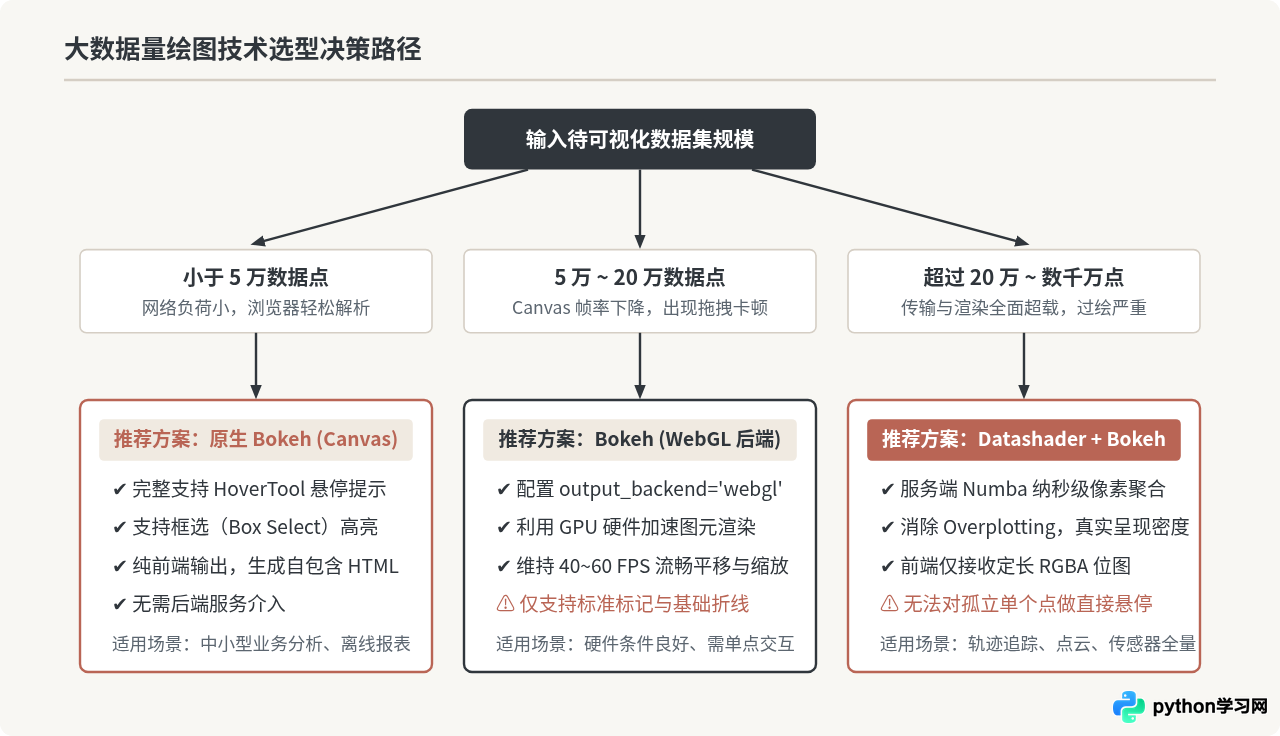
处理 Python 大数据量绘图时的核心选型准则是:十万点以内且需要悬停单点交互,优先选 Bokeh(并开启 WebGL 后端);超过二十万点直至数千万点以上,必须选用 Datashader 将原始数据在服务端预先栅格化为固定尺寸像素图像,再配合 Bokeh 呈现缩放与平移交互。
一、底层架构差异:为什么绘图会卡死
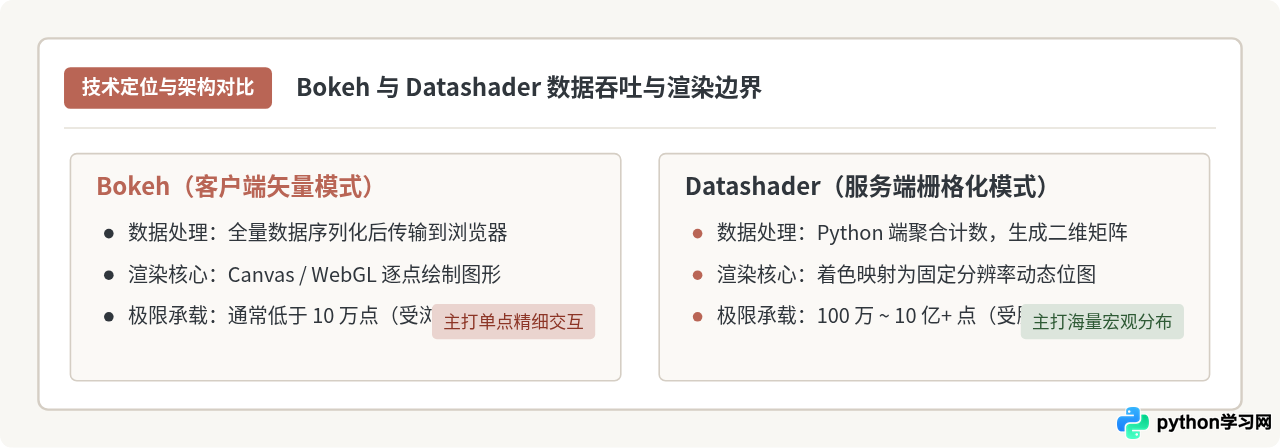
在数据科学和工程监控中,当散点或轨迹折线从几万上升到几十万、几百万时,使用常规工具(如 Matplotlib 静态图或原生 Bokeh 动态图)经常出现浏览器无响应、页面崩溃甚至机器内存耗尽的情况。这并非单纯的“算力不足”,而是渲染管线架构所决定的几何瓶颈。
1. Bokeh 的客户端渲染机制
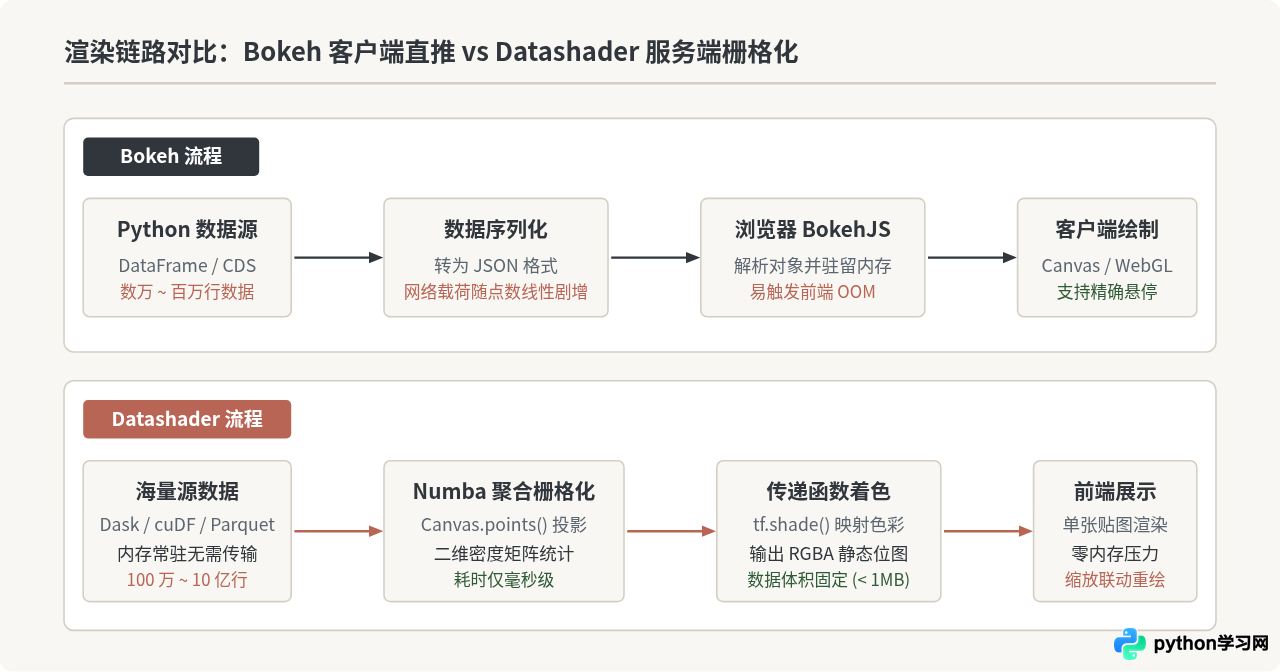
Bokeh 是一款功能全面的交互式数据可视化库。其典型工作流是在 Python 端将数据组织为 ColumnDataSource,然后序列化为 JSON 字符串传输到浏览器。前端的 BokehJS 接收数据后,通过 HTML5 Canvas 或 WebGL 在客户端进行逐点计算和几何图元绘制。
这种架构赋予了前端极强的交互能力:用户鼠标移动到任意散点上,都可以立即弹出该点的属性详情(HoverTool),还能实现框选、多图联动高亮等功能。然而,当数据量达到 10 万级别以上时,缺点极为突出:
- 网络传输巨大:数百万个浮点坐标转为 JSON 格式,体积往往达到数百兆字节,传输与反序列化耗时极大。
- 浏览器内存暴涨:DOM 或前端 Canvas 必须持有所有图元对象,极易触发浏览器的标签页崩溃机制(Out of Memory)。
- 过绘(Overplotting)导致失真:海量点重叠挤压在一起,深色墨水遮盖了底层分布,不仅丢失了局部密度信息,还产生了大量无意义的渲染计算。
2. Datashader 的服务端聚合管线
Datashader 并不是一个独立的前端图表库,而是一个专门针对大规模数据集的服务端几何图形栅格化引擎。它的设计哲学非常明确:屏幕的物理像素是有限的(例如 1920×1080 屏幕仅有约 200 万个像素点),无论源数据有 1 亿还是 10 亿行,最终投射到屏幕上的有效像素点不可能超过视口尺寸。
Datashader 借助 Numba JIT 编译器在 Python 端以极高的速度将点、线、多边形投影到二维网格中,生成一个离散的数值数组(比如统计每个像素内落入的数据点计数),然后再通过传递函数(Transfer Function)进行自动对数拉伸或直方图均衡着色,输出一张固定分辨率的 RGBA 图像。传送到前端的不再是千万行坐标,而仅仅是一张几百 KB 的位图。
二、选型决策树:按数据规模与交互深度做选择
选择 Bokeh 还是 Datashader,不应视作“二选一”的非此即彼,而应结合数据样本规模与交互业务场景进行分级决策。
核心判断标准详解
- 如果核心需求是“单点属性探查”:业务需要查看具体的某一条订单编号、设备告警原始文本时,必须使用 Bokeh。因为 Datashader 的栅格化将独立点融合为了像素密度值,单个离散点的数据元信息在图像化过程中被丢弃。如果数据量确实超过了 10 万点,应该在服务端先进行空间降采样或局部聚类,再交给 Bokeh 渲染。
- 如果核心需求是“全局形态与密度分布感知”:如地理打车轨迹、金融高频交易散点、网络流拓扑,数据重叠度极高。此时如果强行用 Bokeh 绘制几十万个半透明圆点,会导致中心区域完全饱和成单色墨团(即过绘失真)。Datashader 具有自动对数归一化与直方图均衡化能力,能够准确还原从 1 到 100,000 的真实密度层级,这是 Bokeh 无法达到的。
三、具体实战配置与实现范式
下面给出三种典型场景的完整 Python 实现代码及配置参数,确保可直接在本地环境验证测试。
场景 1:Bokeh 开启 WebGL 优化中等数据量(10 万点)
执行环境准备:pip install bokeh。在定义 figure 容器时,明确指定 output_backend="webgl"。该选项会将绘制后端从 2D Canvas 切换至浏览器的 WebGL 着色器管线,极大地降低 GPU 绘制 draw call 的开销。
import numpy as np
from bokeh.plotting import figure, show
from bokeh.io import output_file

# 1. 模拟生成 100,000 个二维正态分布点
np.random.seed(42)
n_points = 100_000
x = np.random.normal(0, 1, n_points)
y = np.random.normal(0, 1, n_points)

# 2. 导出目标静态文件
output_file("bokeh_webgl_demo.html", title="Bokeh WebGL 10万点散点图")

# 3. 创建画布,启用 WebGL 硬件加速
# 关键参数:output_backend="webgl"
p = figure(
    title=f"Bokeh WebGL 散点图性能测试 (数据量: {n_points:,} 点)",
    width=800,
    height=500,
    output_backend="webgl",
    tools="pan,wheel_zoom,box_zoom,reset,save"
)

# 4. 绘制半透明圆形标记
p.circle(x, y, size=3, color="#B96555", alpha=0.3)

# 5. 显示图表(或在本地生成 HTML 文件)
# show(p)注意:Bokeh 的 WebGL 后端并非支持所有高级图元。目前支持常见的基础图元(如 circle、line、rect 等),但不支持复杂的贝塞尔曲线、嵌套多边形遮罩以及部分特殊滤镜样式。此外,如果用户设备的显卡驱动较旧或启用了无头浏览器(Headless),WebGL 可能降级失败导致白屏。
场景 2:Datashader 服务端纯栅格化生成百万级位图
执行环境准备:pip install datashader pandas。以下代码示范如何使用纯 Python 后端直接处理 500 万点,并在几百毫秒内渲染出高保真密度图像。
import pandas as pd
import numpy as np
import datashader as ds
import datashader.transfer_functions as tf
from colorcet import fire

# 1. 构造 500 万行经纬度轨迹模拟数据
num_points = 5_000_000
np.random.seed(101)
df = pd.DataFrame({
    'x': np.random.normal(120.0, 0.5, num_points),
    'y': np.random.normal(30.0, 0.5, num_points)
})

# 2. 定义几何视口画布(指定像素宽度和高度)
canvas = ds.Canvas(plot_width=800, plot_height=500)

# 3. 执行聚合投影:计算落入每个像素网格的点数
# 采用 Numba JIT 加速,支持多核并行计算
agg = canvas.points(df, 'x', 'y')

# 4. 传递函数着色:对数拉伸以突出低密度和高密度细节
# cmap 推荐使用感知均匀的色板(如 fire 或 blues)
img = tf.shade(agg, cmap=fire, how='eq_hist')

# 5. 保存生成的栅格图像(体积仅约 200 KB)
# img.to_pil().save("datashader_5m_rendered.png")
场景 3:Datashader + Bokeh 组合架构(动态自适应缩放)
在实际生产系统中,最佳实践往往是:Datashader 负责在服务端快速重采样与像素化,Bokeh 提供前端视口容器与交互控件(工具栏、缩放轴、地图瓦片底图)。推荐通过生态中的高层封装 holoviews 进行装配。
环境准备:pip install holoviews datashader bokeh。
import numpy as np
import pandas as pd
import holoviews as hv
from holoviews.operation.datashader import datashade, dynspread

hv.extension('bokeh')

# 1. 生成 100 万级散点
points_num = 1_000_000
data = pd.DataFrame({
    'x': np.random.randn(points_num),
    'y': np.random.randn(points_num)
})

# 2. 构建 HoloViews 散点对象
points = hv.Points(data, ['x', 'y'])

# 3. 接入 Datashader 动态图(DynamicMap)
# datashade: 当浏览器进行平移缩放时,通过 WebSocket 通知 Python 端重新计算当前视口的栅格
# dynspread: 当放大到极小视野只有稀疏几点时,自动将孤立单像素扩张为显眼图元
interactive_plot = dynspread(datashade(points, cmap=["#F8F7F3", "#B96555"]))

# 4. 配置 Bokeh 画布参数
interactive_plot.opts(width=800, height=500, bgcolor="#30363C")

# 在 Jupyter Notebook 或 Bokeh Server 中直接呈现:
# interactive_plot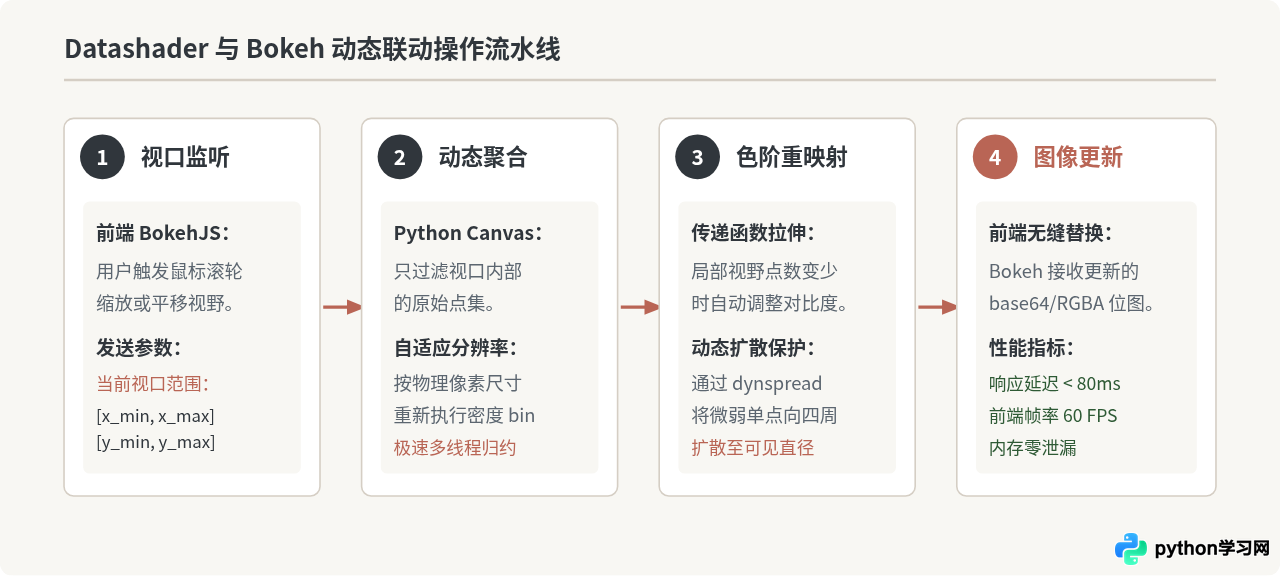
四、关键注意事项与避坑指南
在落地生产级大数据可视化系统时,除了单纯的库选型,还需要注意以下工程实现细节:
-
Web Mercator 坐标投影坑:地理数据通常以经纬度(WGS84,EPSG:4326)保存,但在配合 Bokeh 底图瓦片(如 OSM、Carto)时,必须转换为墨卡托投影(EPSG:3857)。如果直接将经纬度传给 Datashader 和 Bokeh 底图,不仅缩放变形,还会出现坐标不匹配导致的白屏。可在 Python 端使用
pyproj预先转换。 - 内存预留与数据分块:Datashader 本身执行聚合非常迅速,但如果直接将 5000 万行的单张 Pandas DataFrame 加载进内存,容易引发主进程内存耗尽。推荐将数据存储为 Parquet 格式,并结合 Dask DataFrame 或 cuDF(GPU 加速),Datashader 原生支持对 Dask 延迟对象进行流式分块聚合。
-
如何在 Datashader 图像上恢复单点检查:若业务强烈要求“宏观用热力图、微观能点击查看具体某条记录”,业界成熟的解决方案是:Datashader 负责全局视图绘制 + 空间索引(如 KD-Tree 或 R-Tree)辅助点击事件。在 Bokeh 端监听
Tap或Selection点击坐标,通过后端在 KD-Tree 中就近检索最近邻的 1~5 个数据行返回详情弹窗,从而兼顾海量性能与离散探查。
五、选型与性能核心维度总结
为了直观对比两者在开发、运维及用户交互各维度的差异,以下汇总了两者的核心技术指标:
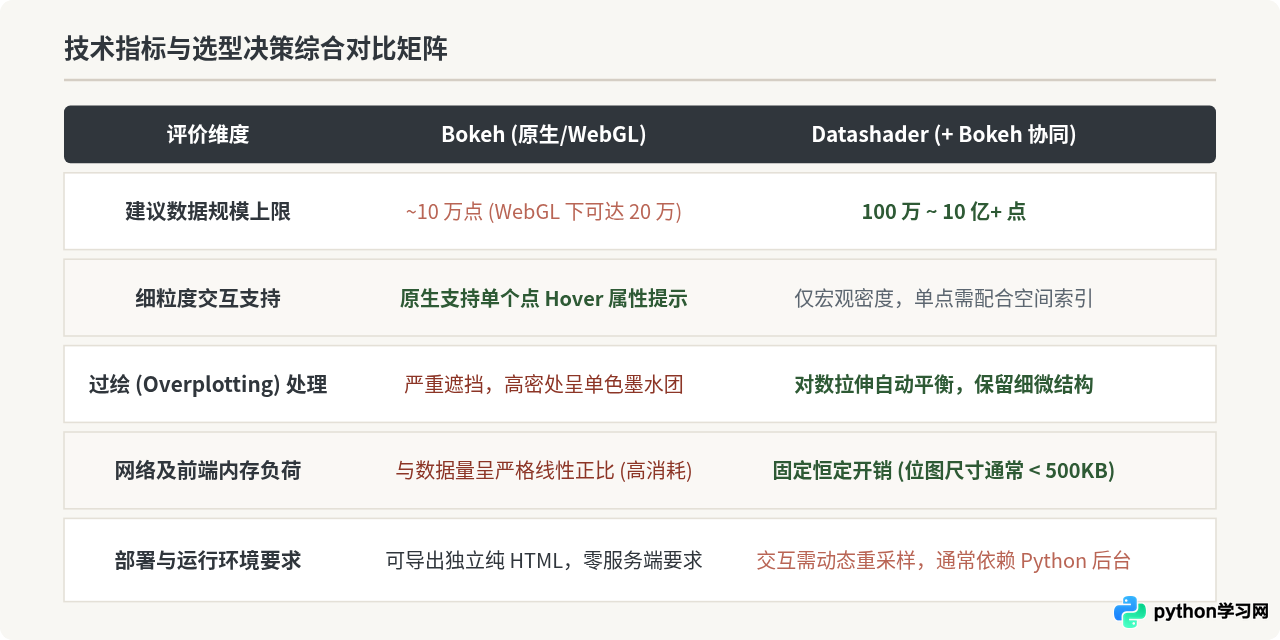
综上所述,在项目工程落地中,无需纠结于 Bokeh 与 Datashader 的孰优孰劣:中小型业务报表与需要精确点选排查的场景,优先使用原生或 WebGL 加速的 Bokeh;而对于千万级以上的连续轨迹、传感器物联网、海量金融 Tick 数据或高密点云的可视化,应毫不犹豫地采用 Datashader 作为服务端聚合中枢,并依托 Bokeh 构建流畅交互的可视化前端。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









