

Python字典读取:方括号[]与get()方法的区别及用法
深入解析Python字典读取的两种核心方式:方括号[]与get()方法的语法用法、KeyError错误机制、默认值陷阱、嵌套字典安全读取及性能选型准则。
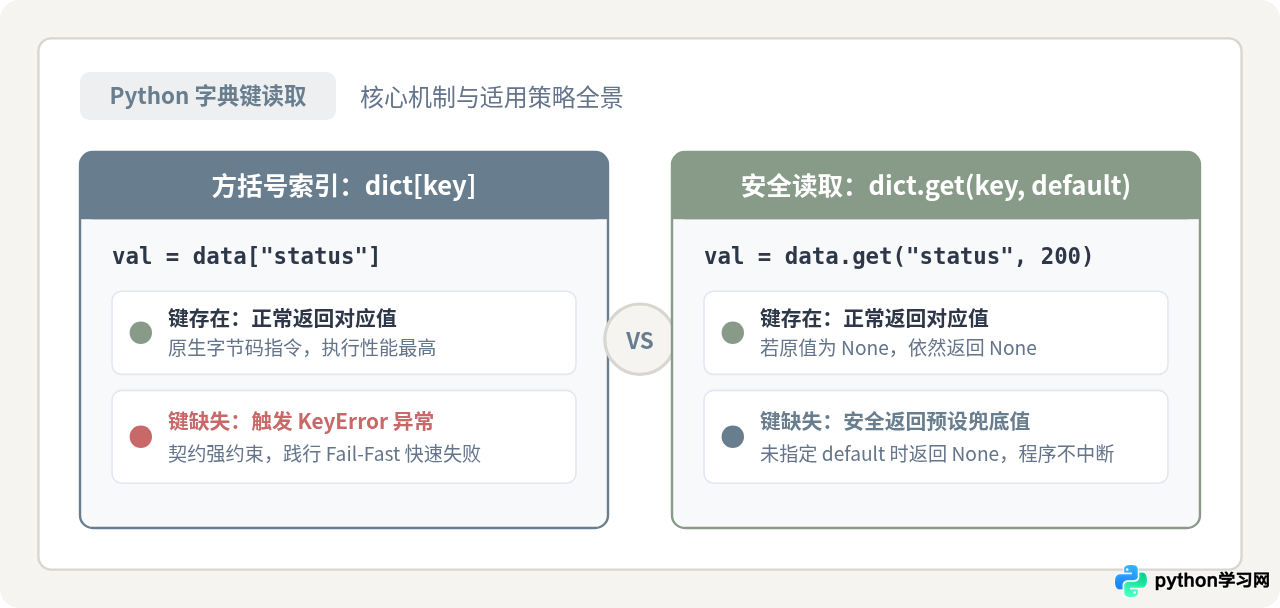
dict)内部的数据,最常用也最基础的两种方式是方括号索引 dict[key] 与内置方法 dict.get(key, default)。二者的本质差异在于处理“目标键不存在”时的设计策略:方括号索引在键缺失时直接抛出 KeyError 异常,要求调用方严格保证数据存在或显式处理异常;而 get() 方法则会平稳返回预设的默认值(缺省为 None),避免中断运行。本文从错误机制、默认值陷阱、嵌套取值技巧与底层字节码四个角度展开全面对比,帮助你在实际开发中做出清晰且健壮的代码选择。
一、两种读取方式的基础语法与相同表现
在目标键确实存在于字典中的前提下,方括号语法与 get() 方法的执行结果与取值行为是完全一致的。
# 定义一个示例用户信息字典
user_profile = {
    "username": "zhangsan",
    "role": "admin",
    "login_count": 42
}

# 方式 1:方括号直接索引
name = user_profile["username"]
print(name)  # 输出: zhangsan

# 方式 2:使用 get() 方法读取
role = user_profile.get("role")
print(role)  # 输出: admin
两者在基本语法上的直接对应关系如下:
dict[key]:直接通过 Python 的下标操作符访问键对应的值。该操作符兼具“读取”和“写入(赋值)”两种能力。dict.get(key[, default]):字典对象的内建方法,仅用于安全查询。第一个参数为待查询的键,第二个可选参数为键未命中时的兜底返回值。
二、核心区别:键不存在时的处理机制与设计哲学
两者的核心分水岭发生在字典中并不包含所请求的键时。理解这两种行为背后的设计哲学,是写出规范 Python 代码的关键。
1. 方括号读取:严格契约与“快速失败”(Fail-Fast)
使用 data[key] 时,若键不存在,Python 解释器会立即中断当前执行流程并抛出 KeyError 异常。若未在外部使用 try...except KeyError 捕获,程序将直接退出。
# 键不存在时的方括号操作
try:
    email = user_profile["email"]
except KeyError as e:
    print(f"捕获到异常: KeyError {e}")
    # 必须显式处理异常或阻断执行
抛出异常并不是缺点,而是一种严格的数据约束。在处理高可信、格式严苛的内部数据结构(例如数据库主键、API 必须返回的核心字段)时,缺失键本身就意味着上游数据损坏或程序逻辑 Bug。此时抛出 KeyError 能让错误在发生的第一时间暴露,防止脏数据继续流入后续业务流程。
2. get() 方法:宽容读取与平稳降级
与方括号相反,dict.get(key) 始终不会因为键不存在而抛出异常。如果查询不到键,它会静默返回 None(或者调用者指定的 default 值)。
# 键不存在时的 get() 操作
email = user_profile.get("email")
print(email)  # 输出: None(程序继续平稳运行)

nickname = user_profile.get("nickname", "未设置昵称")
print(nickname)  # 输出: 未设置昵称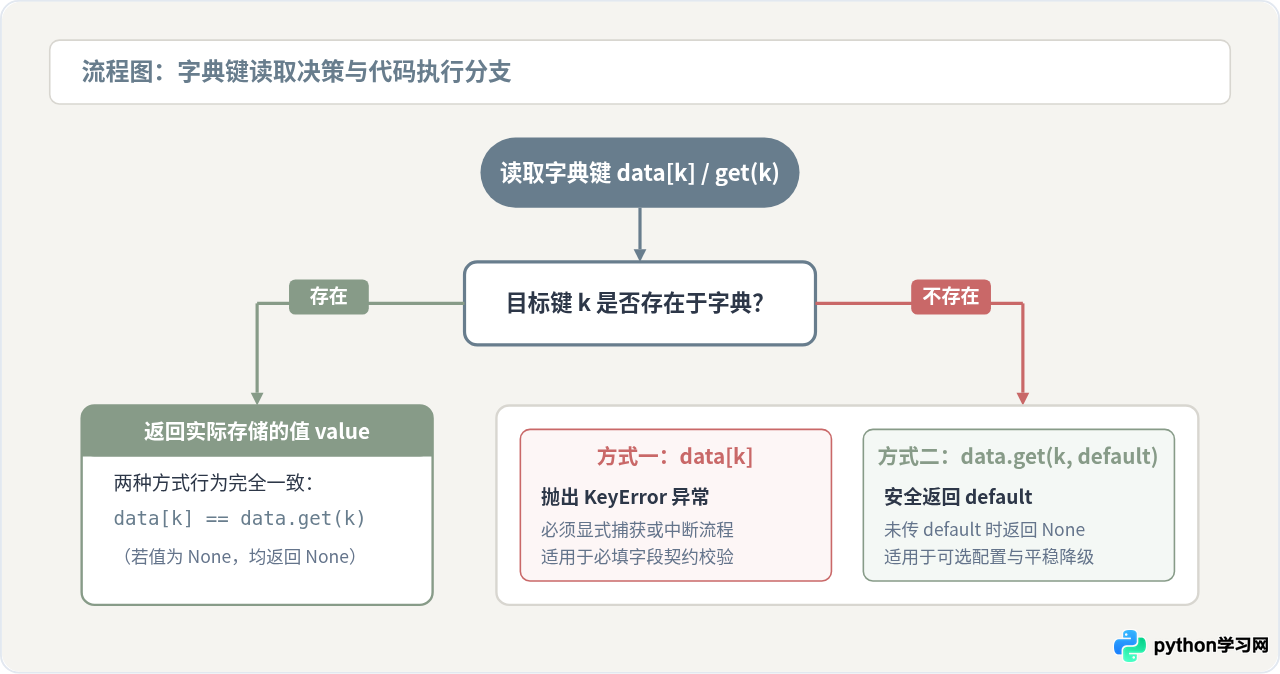
get() 方法代表“此键可能缺失,如果缺失请给我一个安全备选项”。
三、机制对比:查找逻辑与“值为 None”的常见陷阱
在日常开发中,许多初学者容易产生一个误区:认为 get(key, default) 的作用是“当取出的值为 None 时使用 default”。这种理解是错误的。
get() 方法的判定依据是键是否存在于字典的哈希表中,而不是对应的值是否为 None。只要键存在,无论其值是字符串、空列表、0 还是 None,get() 都会原样返回该值,绝不会触发 default。
# 典型易错案例:键存在,但其存储的值本身就是 None
app_settings = {
    "timeout": None,       # 显式配置了 None
    "max_retries": 3
}

# 尝试用 30 秒作为默认超时时间
val = app_settings.get("timeout", 30)
print(val) # 输出仍然是: None!并不是 30!"timeout" 键确实存在于字典中,get() 找到了该键并返回了它所关联的对象 None,默认参数 30 被直接忽略。
若实际业务需求是“当键不存在,或者键的值为 None / 假值时,均启用备选兜底”,应该配合 Python 的布尔短路运算符 or:
# 解决方案:使用 or 表达式兜底 None 与空值
safe_timeout = app_settings.get("timeout") or 30
print(safe_timeout)  # 输出: 30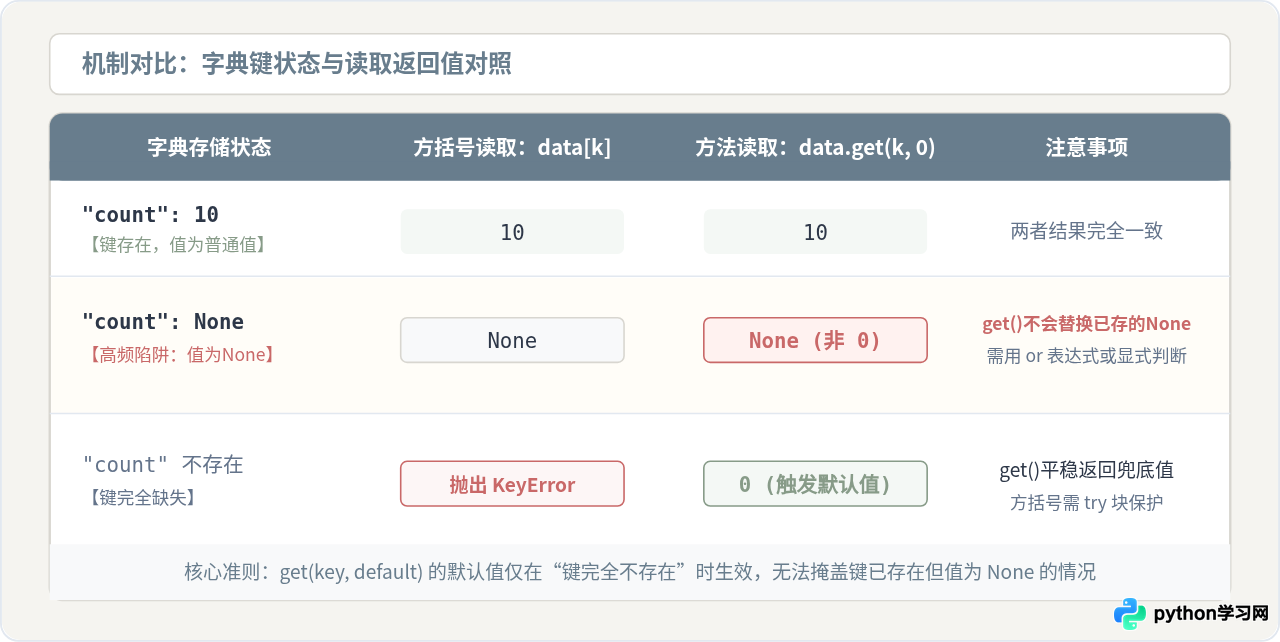
如果需要严格区分“键不存在”与“键存在但值为 None”,应当使用 in 关键字进行前置检验:
if "timeout" in app_settings:
    print(f"键存在,当前设定的值为: {app_settings['timeout']}")
else:
    print("键完全未配置")
四、多层嵌套字典的安全读取实践
在解析 Web API 响应、JSON 文件或复杂业务数据时,多层嵌套字典是极其常见的结构。处理这类数据时,取值方式的选择尤为关键。
# 模拟从第三方 API 获取的响应数据
api_response = {
    "status": 200,
    "data": {
        "user": {
            "id": 9527,
            "address": {
                "city": "Hangzhou"
            }
        }
    }
}
1. 两种常见反模式(Anti-Patterns)
-
反模式 A:全链路连续方括号索引
city = api_response["data"]["user"]["address"]["city"]
只要其中任意一层键(如user或address)在接口变更中缺失,或者为None,就会抛出KeyError或TypeError: 'NoneType' object is not subscriptable导致程序崩溃。 -
反模式 B:以为安全但依然致命的连续 get()
city = api_response.get("data").get("user").get("address").get("city")
如果data缺失,api_response.get("data")会返回None。接下来对None继续调用.get(),会立即触发AttributeError: 'NoneType' object has no attribute 'get',并没有达到容错目的。
2. 生产环境推荐的安全读取写法
若希望安全、优雅地逐层深挖且不报错,应在每一层 get() 中传入空字典 {} 作为缺省值:
# 推荐方案 1:中间层使用空字典 {} 兜底,最后一层提供业务默认值
city = (
    api_response
    .get("data", {})
    .get("user", {})
    .get("address", {})
    .get("city", "未知城市")
)
print(city)  # 输出: Hangzhou
若上游返回的某个中间层字段可能显式为 None(如 "user": None),则可在中间层结合 or {}:
# 推荐方案 2:兼容“键缺失”与“值为 None”的链式防御
user_dict = api_response.get("data") or {}
user_info = user_dict.get("user") or {}
city = user_info.get("address", {}).get("city", "未知城市")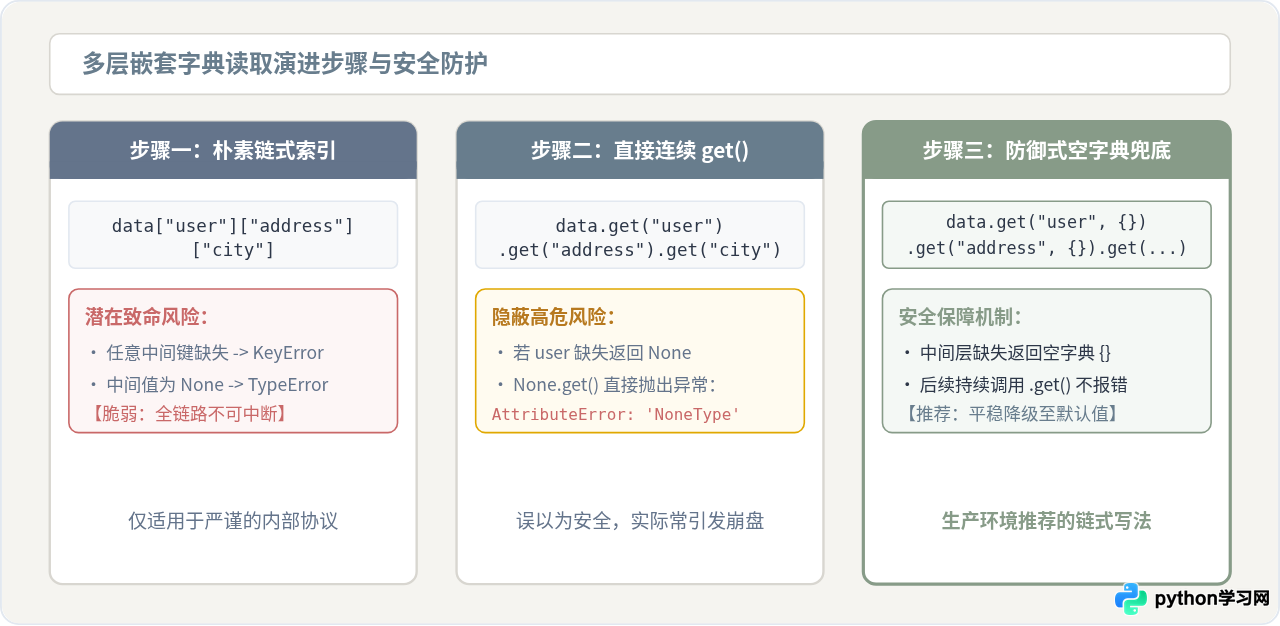
五、底层机制与执行性能差异
在 Python 解释器(CPython)内部,方括号语法与 get() 方法对应的底层字节码存在显著差异。
import dis

def access_by_bracket(d):
    return d["key"]

def access_by_get(d):
    return d.get("key")

print("--- 方括号字节码 ---")
dis.dis(access_by_bracket)

print("--- get() 字节码 ---")
dis.dis(access_by_get)
反编译输出的字节码主要特征如下:
access_by_bracket仅需执行LOAD_FAST、LOAD_CONST以及BINARY_SUBSCR。BINARY_SUBSCR是原生操作码,在 C 语言层直接由字典的mp_subscript槽函数处理,分发路径极短。access_by_get则需要经历LOAD_METHOD(查找get属性)与CALL_METHOD(压入调用帧、参数传递与函数返回),经历了一次完整的 Python 方法调用生命周期。
性能差异的影响:在微基准测试(以数百万次紧密循环读取已存在的键)中,方括号索引通常比 get() 快约 20% 到 35%。但在常规的 Web 框架、数据库查询或业务流中,这种纳秒级的差异完全不是瓶颈所在。因此,在两者之间做选择时,首要考量始终应是业务逻辑的健壮性与语义准确性,而不是盲目追求微小的速度优势。
六、场景选型准则与速查总结
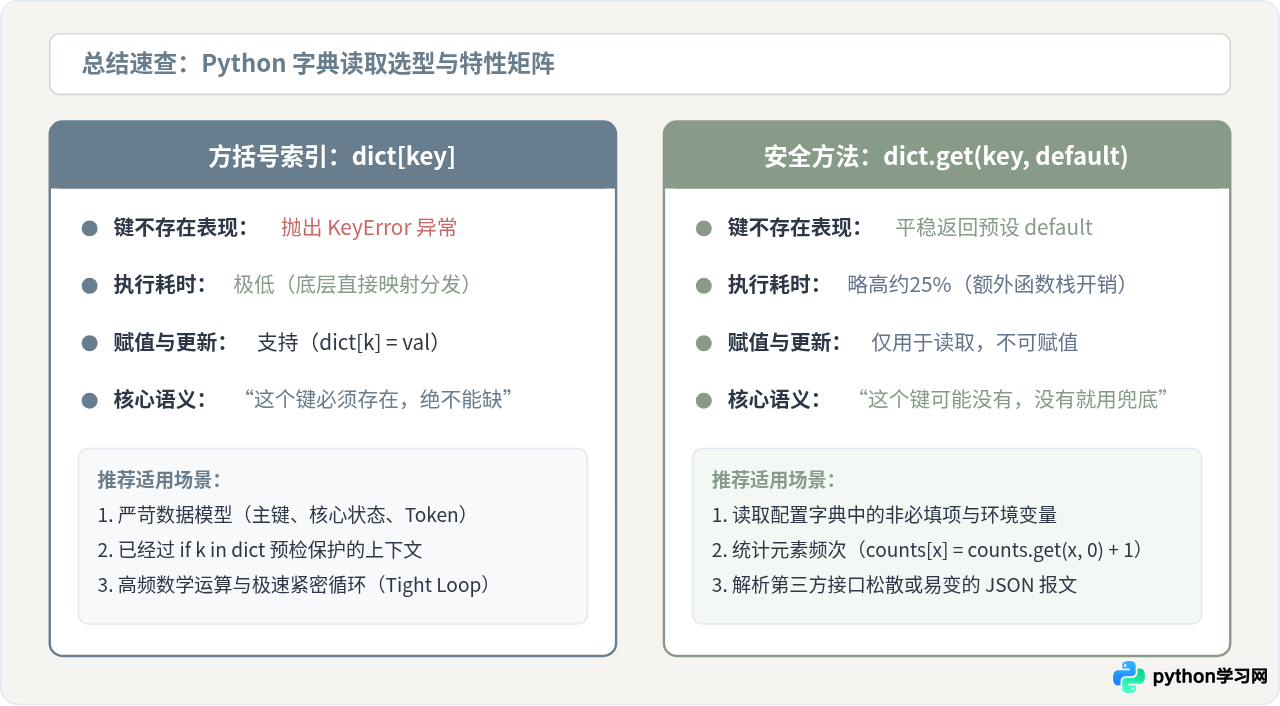
为了帮助你在编写代码时迅速做出规范的选择,下表系统总结了两种读取方式的各项指标:
| 比较维度 | 方括号索引 dict[key] |
安全方法 dict.get(key, default) |
|---|---|---|
| 键不存在时的行为 | 抛出 KeyError 异常(可强行中断) |
返回 default(默认 None),程序继续 |
| 默认值支持 | 不支持直接设定默认值 | 支持第二个参数自定义兜底值 |
| 值为 None 时的表现 | 返回 None |
返回 None(不会触发默认值) |
| 修改/赋值能力 | 支持赋值:d[k] = v |
仅用于读取,不可赋值 |
| 字节码开销 | BINARY_SUBSCR(极轻量) |
LOAD_METHOD + CALL_METHOD(略高) |
| 设计意图 | 强调“必须存在”,体现强数据契约 | 强调“平稳兜底”,体现防御性编程 |
选型决策指南:
-
优先使用
dict[key]的场景:- 业务强制要求该字段必须存在(如用户 ID、订单流水号、状态码)。如果缺失说明前端传参错误或上游系统故障,需要利用
KeyError快速失败并记录告警。 - 上下文已经通过
if key in data:做了明确的存在性检查,后续直接使用方括号索引更加干净利落。 - 需要对键进行赋值操作或原地累加。
- 业务强制要求该字段必须存在(如用户 ID、订单流水号、状态码)。如果缺失说明前端传参错误或上游系统故障,需要利用
-
优先使用
dict.get(key, default)的场景:- 读取可选配置、环境变量或用户个性化偏好(如
config.get("theme", "light"))。 - 处理未经验证的外部输入(如 Web 爬虫解析页面、对接变动频繁的第三方开放平台)。
- 在字典计数模式中初始化并累加计数(如
counts[char] = counts.get(char, 0) + 1)。
- 读取可选配置、环境变量或用户个性化偏好(如
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









