

适合有声书制作的AI配音音色推荐及批量生成教程
针对长篇有声书制作,本文推荐zh-CN-XiaoxiaoNeural和zh-CN-YunxiNeural作为试听起点,强调通过多场景试读固定音色。教程基于Windows环境,使用Python构建Azure Speech批量合成请求,解析异步任务的状态追踪逻辑,并提供章节验收与文件整理的实操建议,避免盲目重做和超时误判。
有声书批量配音的核心不在于一次性生成所有音频,而在于建立可追踪的制作流:先固定音色与章节边界,再提交异步任务,最后按状态取回结果并验收。在Windows环境下,利用Python与Azure Speech批量合成接口配合,可以有效避免将整本书塞入同步调用导致的超时与重复处理问题。批量接口的本质是异步任务,请求提交、任务完成与音频验收是三个独立阶段,必须分开管理。
音色先用同一段试读,章节才有一致的听感
普通话有声书制作中,音色的稳定性直接决定听众的长期体验。建议从微软公开支持的音色中选择两个候选作为对照起点:zh-CN-XiaoxiaoNeural(女声)和zh-CN-YunxiNeural(男声)。这两个音色在多数区域可用,但具体可用性仍需以你的资源实例为准,不声称某一种音色适合所有书籍类型。
试读环节切忌只使用一句简短的广告语或开场白。应选取包含叙述、人物对话以及书中专有名词的混合段落,在相同语速和音量条件下进行对比。判断重点在于连续听读是否舒适、角色对话界限是否清晰、姓名和多音字处理是否自然,而非声音初次播放时的惊艳程度。没有经过实际音频测试,任何关于音色自然度的排名都缺乏依据。
确定候选音色后,先生成一章小样进行复听,确认无误后再扩展至整本书。正文字幕、章节标题和制作备注应分开管理,数字及名称读法需预先统一。批量合成会放大稿件中的一致性错误,它不会自动修正读音问题,因此前期的小样验证至关重要。
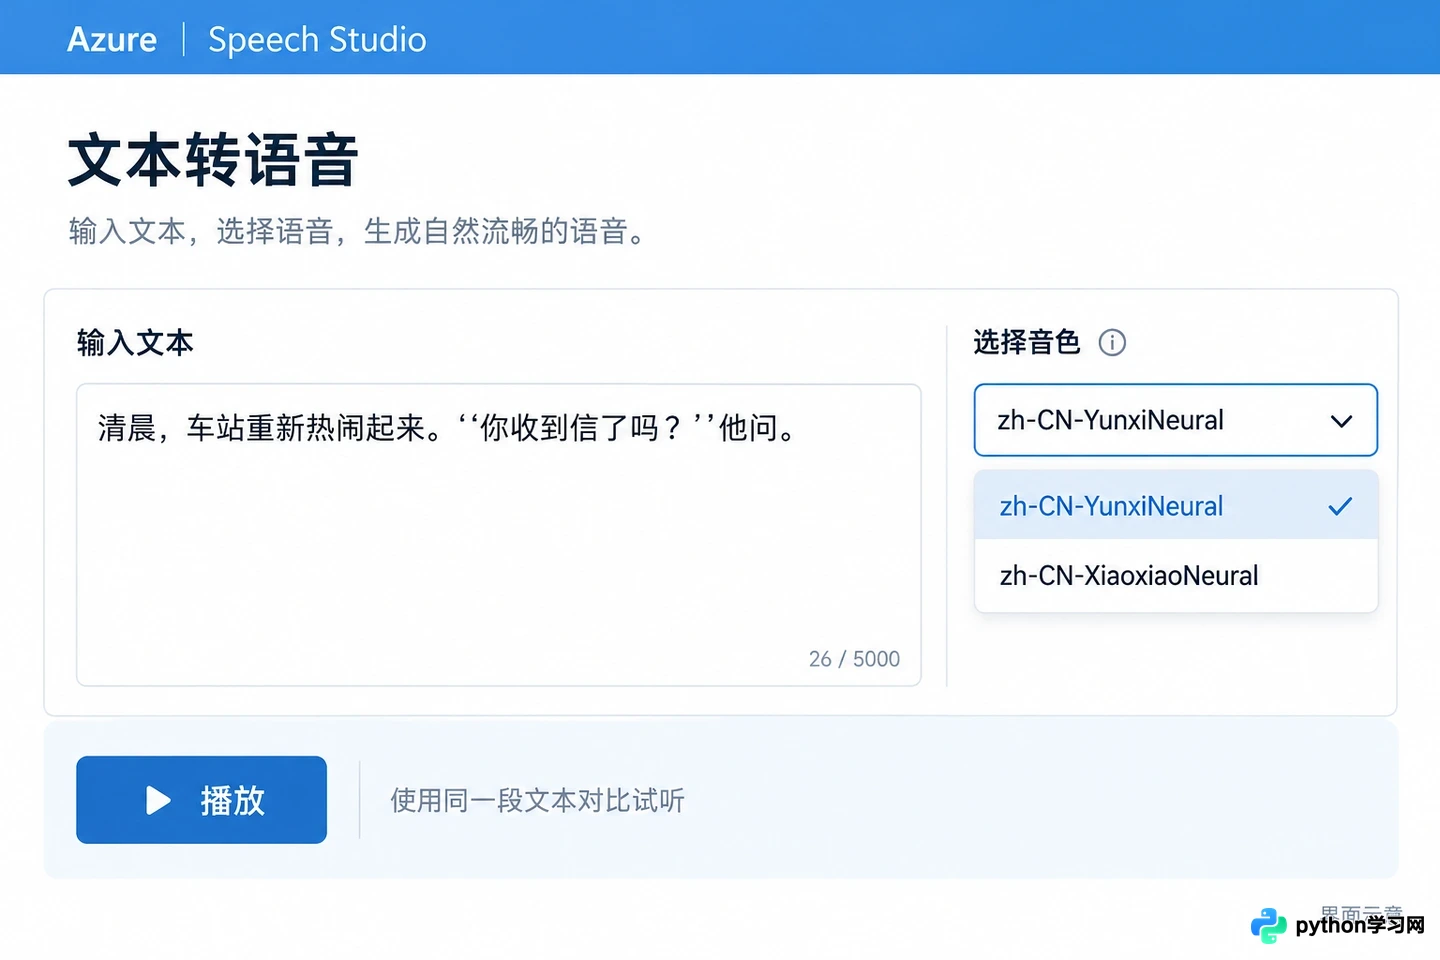
在Azure Speech Studio中对比不同音色的试读效果
请求写成多条输入,异步状态才能正确追踪
微软批量合成接口支持纯文本或SSML输入。为简化演示,以下示例使用PlainText模式固定一个音色,将两个章节作为两条独立输入提交。Python脚本仅负责组装请求体,API密钥等敏感信息不应硬编码在脚本中或记录在日志里。
import json
from pathlib import Path

chapters = [
    "第一章。清晨,车站重新热闹起来。",
    "第二章。他停下来,重新读了一遍信。",
]
payload = {
    "inputKind": "PlainText",
    "synthesisConfig": {"voice": "zh-CN-YunxiNeural"},
    "inputs": [{"content": text} for text in chapters],
}
assert len(payload["inputs"]) == 2
Path("batch.json").write_text(
    json.dumps(payload, ensure_ascii=False), encoding="utf-8"
)
print("inputs=2; voice=" + payload["synthesisConfig"]["voice"])
在Windows环境中安装Python后,将上述代码保存为make_batch.py,在对应目录运行python make_batch.py,即可得到结构正确的请求文件。输出结果如下:
inputs=2; voice=zh-CN-YunxiNeural
该输出仅证明输入数量和音色字段构造正确,不代表服务端已接受任务或生成声音。实际提交时,需使用资源专属的endpoint、认证信息及制作清单中的任务ID,调用texttospeech/batchsyntheses/{任务ID}接口。创建任务使用PUT方法,查询状态使用GET方法。具体API版本、认证配置和额度限制请以官方资源文档为准,严禁直接使用他人的区域地址和密钥。
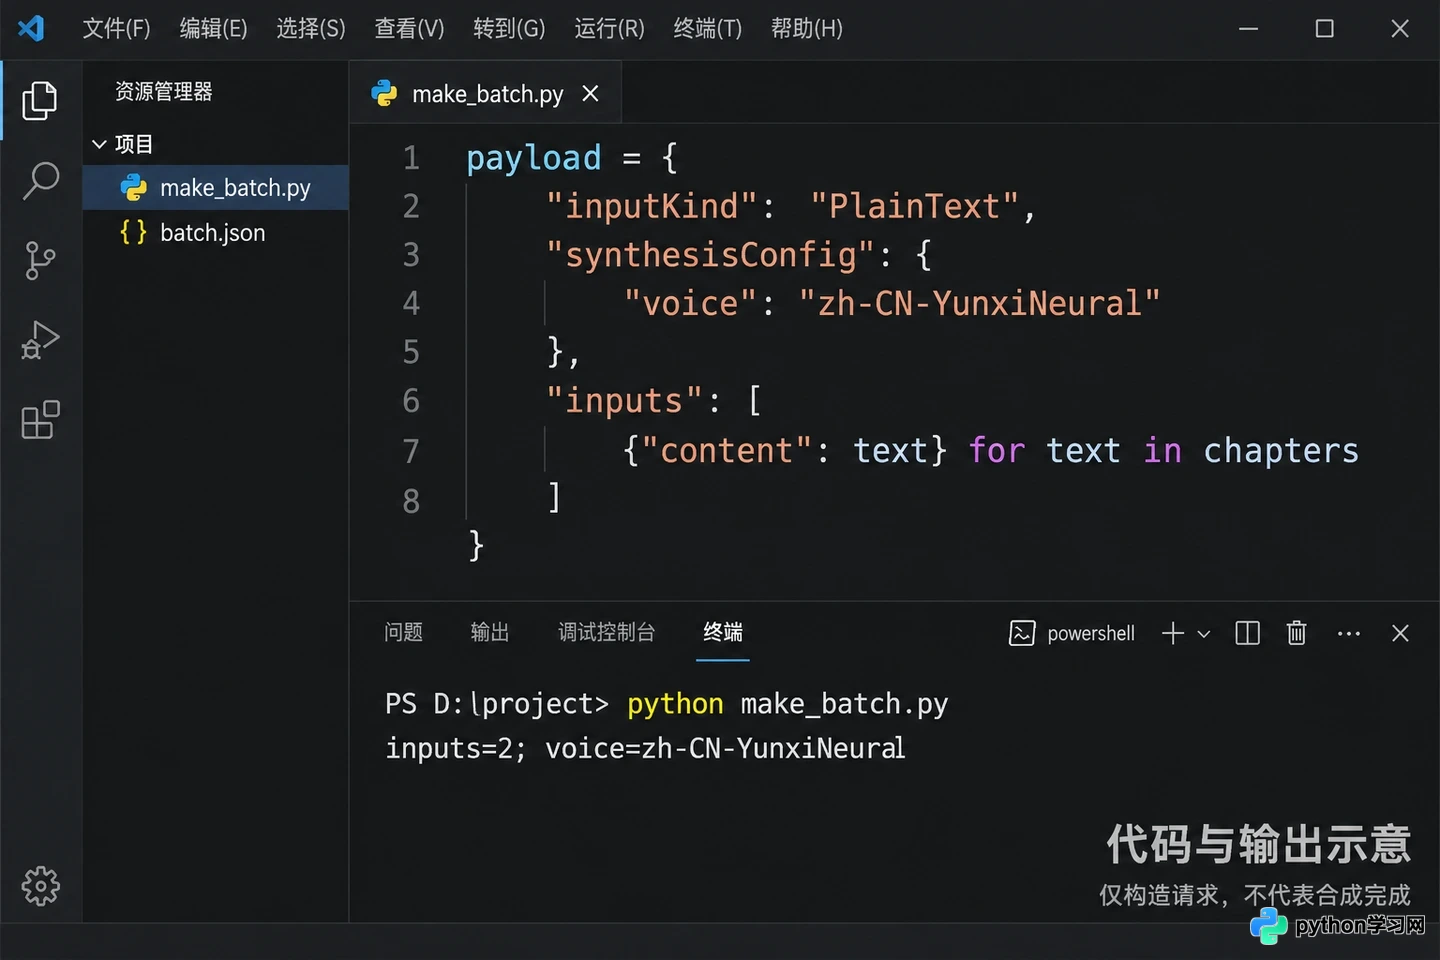
使用Python脚本组装批量合成请求体
任务创建返回后,务必保存任务ID用于后续查询。**当网络未返回明确结果时,应先通过原ID查询任务状态,不能将超时直接等同于提交失败。**在任务排队或运行期间,切勿以相同章节另建一批任务试图“加速”,这可能导致资源浪费和数据混乱。收到明确错误时,需先区分是认证、额度、输入格式还是任务本身的问题,再决定修正范围。
下载成功还要核对章节,批量并不等于免验收
任务状态显示成功后,根据查询返回的outputs.result位置下载产物。注意,outputs.result在创建请求刚返回时通常不可用,需等待任务完成。下载后,应保留原始数据包和任务状态记录,解包后建立章节编号、原稿与音频文件之间的对应关系。
即使只有两条输入,也不能完全依赖文件排序判断章节顺序。应先核对结果记录与文件内容,再按照本地约定的规则重命名文件。建议章节编号采用一致长度(如01、02而非1、2),避免在文件管理器中出现第一章、第十章、第二章的错误排序。这是本地整理规则,并非服务端输出文件名的承诺。
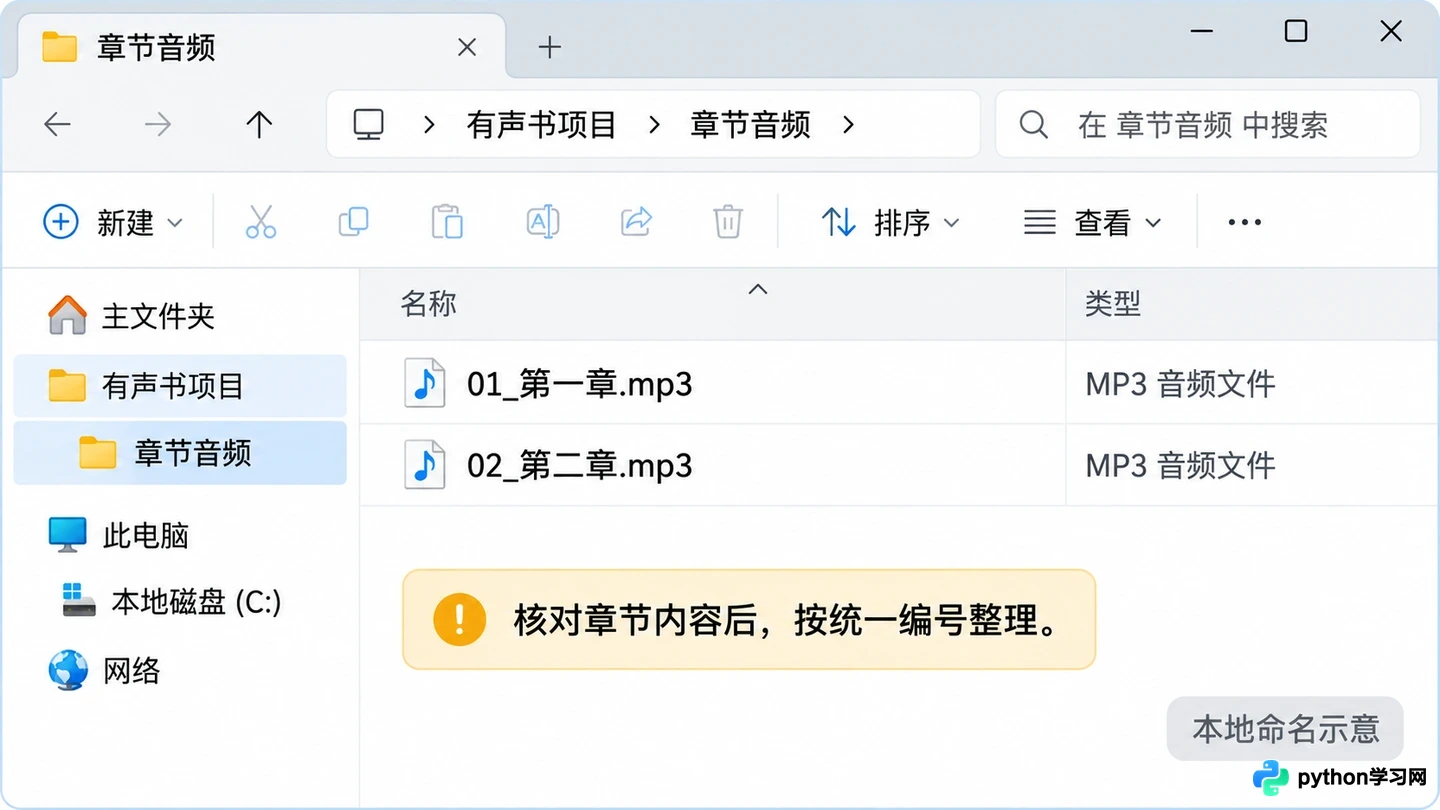
按统一编号规则整理的章节音频文件
复听环节至少覆盖每章开头、结尾及全部关键名称;正式交付前应完整检查正文。若发现漏字、多音字或停顿异常,应修订对应章节稿件,并记录新任务与旧版本的关联关系。不要因为某一章出现错误,就盲目重做已验收的全部章节。批量接口适用于有明确章节清单且愿意维护任务状态的制作流程;若仅有几段短文本,使用可视化试听工具可能更高效。此外,平台资源费用与作品发行授权需分别核实,接口可用不代表原稿可直接出版。先验收小样,再扩大批次,才是让有声书制作可追踪、可控的做法。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









