

Python基础语法练习题及答案:变量、循环与列表操作详解
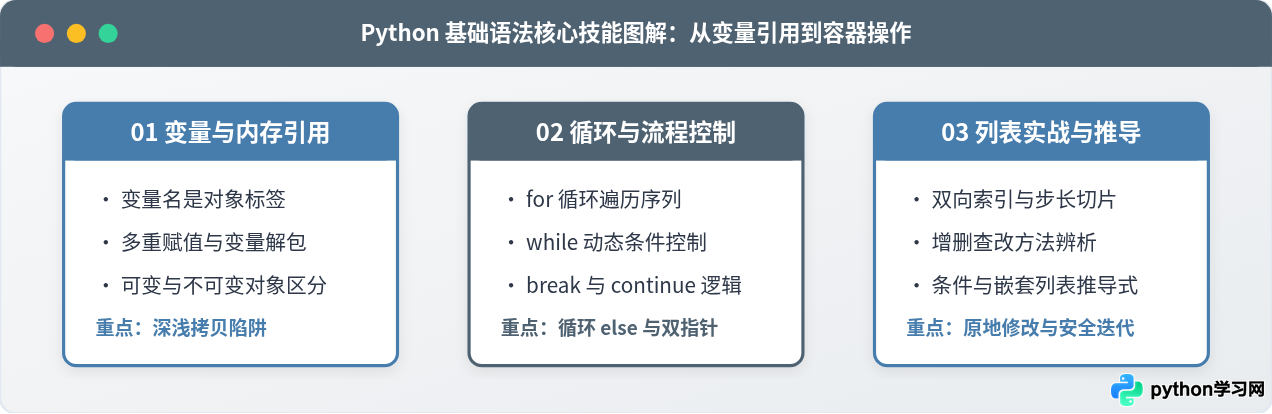
精选Python基础语法核心练习题,涵盖变量赋值与深浅拷贝、for与while循环控制、列表增删改查与列表推导式,提供完整代码答案、执行逻辑与内联SVG原理图解。
第一部分:变量赋值、解包与对象引用机制
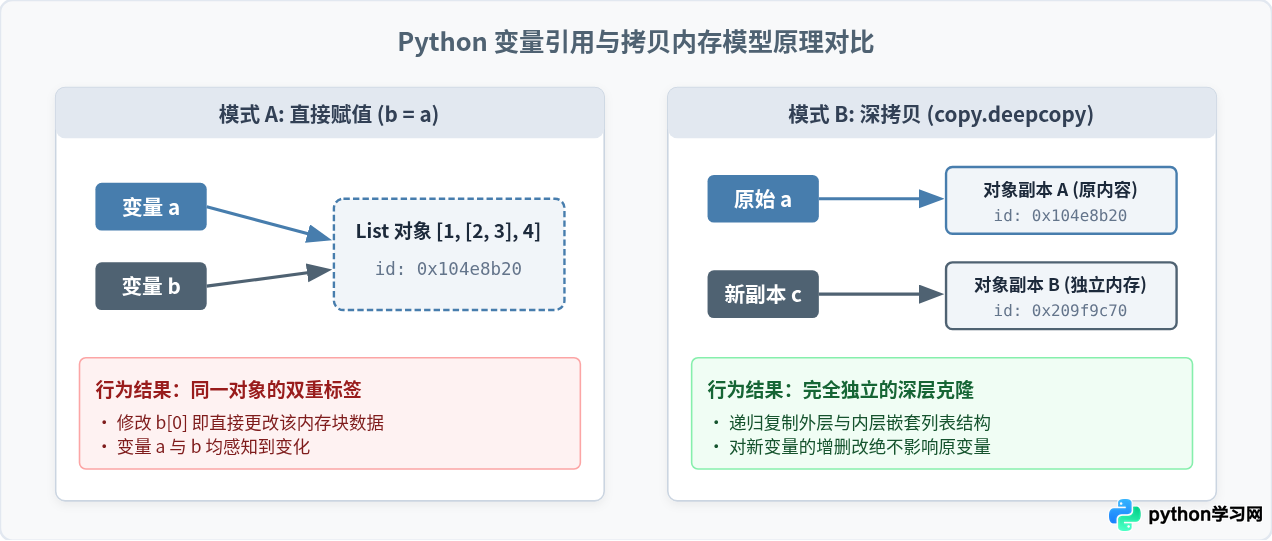
在 Python 中,“变量”并不是存储数据的盒子,而是贴在内存对象上的标签(引用)。理解变量名与底层对象的关系,是编写正确程序的前提。
题目要求:给定两个变量 x = 100 和 y = 200,要求在不引入显式临时变量的前提下,完成两者的值交换。随后,使用一行代码将列表 data = ["Alice", 95, 88, 92, "A"] 中的姓名、三次成绩列表和等级分别提取到独立变量中。
参考解答
# 任务 1:多元赋值交换变量
x = 100
y = 200
x, y = y, x

print(f"交换后: x = {x}, y = {y}")

# 任务 2:扩展序列解包(Extended Sequence Unpacking)
data = ["Alice", 95, 88, 92, "A"]
name, *scores, grade = data

print(f"姓名: {name}")
print(f"成绩列表: {scores}")
print(f"综合评级: {grade}")代码原理解析:
x, y = y, x的执行逻辑是:Python 解释器先在底层构造一个元组(y, x),计算出对应的值;随后将元组按位置解包,依次将引用绑定给左侧的x和y。这一过程天然规避了值覆盖问题。- 在
name, *scores, grade = data中,带星号的变量*scores会贪婪匹配中间所有未被首尾变量捕获的元素,并将它们打包为一个新的列表(即使匹配到0个元素也是空列表)。
题目要求:分析以下代码片段,写出最终输出结果,并修改代码使 b 的修改不会污染原始列表 a:
a = [1, [2, 3], 4]
b = a
b[0] = 99
b[1].append(100)
# 此时 a 的值是什么?为什么?
参考解答与修正方案
import copy

# 1. 直接赋值产生的问题演示
a = [1, [2, 3], 4]
b = a
b[0] = 99
b[1].append(100)
print("直接赋值后 a 的值:", a)  # 此时 a 变成了 [99, [2, 3, 100], 4]

# 2. 正确解决方案:使用深拷贝隔离嵌套对象
original = [1, [2, 3], 4]
safe_clone = copy.deepcopy(original)

safe_clone[0] = 888
safe_clone[1].append(999)

print("修改 safe_clone 后 original:", original)
print("修改后的 safe_clone:", safe_clone)copy.copy()(浅拷贝)只会复制最外层容器,内部嵌套的子列表依然共享内存地址。只有 copy.deepcopy() 会递归复制所有子对象。
第二部分:循环控制流(for、while 与分支跳转)
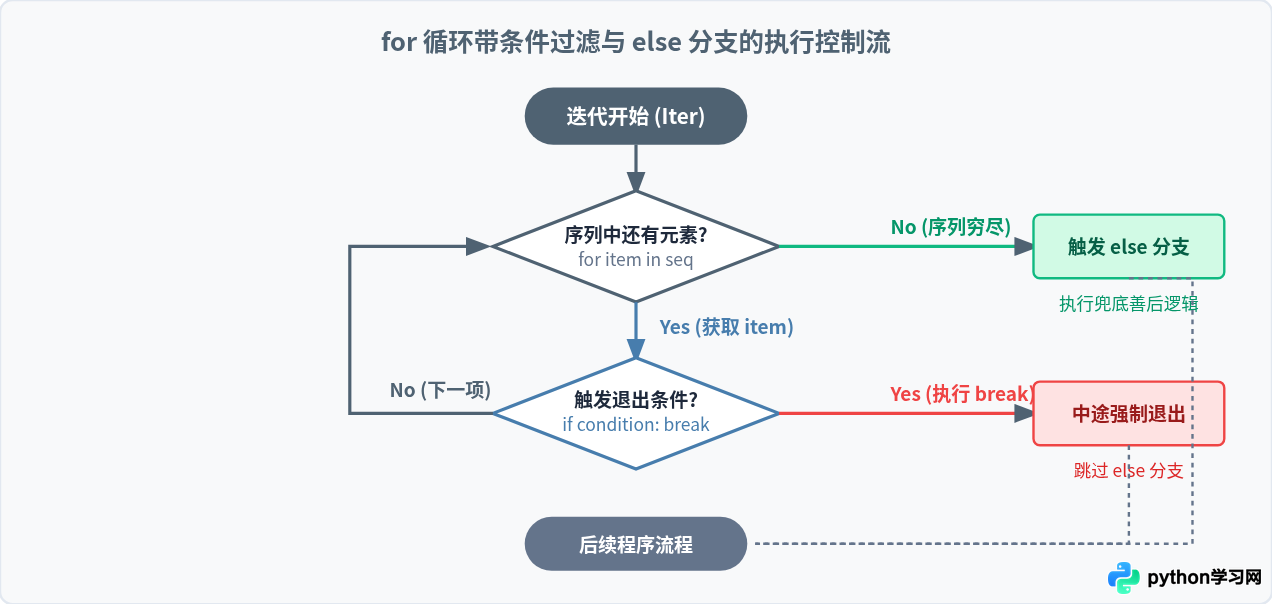
Python 循环包含两种基本形式:适用于确定序列遍历的 for 循环,以及适用于动态条件等待的 while 循环。结合 break、continue 与循环专属的 else 语法,能够优雅地实现复杂检索与流程控制。
题目要求:现有两个并列数据列表:学生学号 student_ids = ["S101", "S102", "S103", "S104"],学生得分 scores = [78, 92, 59, 84]。要求打印出带序号的及格(得分 ≥ 60)名单,格式为:序号: 1 | 学号: S101 | 成绩: 78;对不及格项予以标记。
参考解答
student_ids = ["S101", "S102", "S103", "S104"]
scores = [78, 92, 59, 84]

passed_rank = 1

# 使用 zip 将两个列表打包为二元组序列,并从 0 遍历
for idx, (sid, score) in enumerate(zip(student_ids, scores), start=1):
    if score < 60:
        print(f"[警告] 原始行 {idx}: 学号 {sid} 成绩为 {score} 分,未达到及格线!")
        continue

    print(f"序号: {passed_rank} | 学号: {sid} | 成绩: {score}")
passed_rank += 1核心解析:很多初学者习惯用 range(len(student_ids)) 做下标索引,这种写法不仅冗长,而且容易在索引越界时报错。通过 zip() 进行组合,再由 enumerate() 提供计数器,既符合 Pythonic 风格,又保障了代码简洁度。
题目要求:编写一段程序,利用 for ... else 机制判断正整数 n = 29 是否为质数(素数)。如果找到能整除它的数则打印出因数并立刻终止;若循环正常结束未被中途打断,则确认其为质数。
参考解答
import math

def check_prime(n: int):
    if n <= 1:
        print(f"{n} 不是质数(质数定义为大于 1 的自然数)")
        return

    # 只需要检查到根号 n
    limit = int(math.isqrt(n))

    for divisor in range(2, limit + 1):
        if n % divisor == 0:
            print(f"{n} 是合数,因数包括: {divisor} (与 {n // divisor})")
            break
    else:
        # 当 for 循环正常跑完且没有触发 break 时,才会执行 else
        print(f"{n} 是一个质数!")

# 验证测试
check_prime(29)
check_prime(49)for ... else 或 while ... else 的 else 代码块并不是“条件不满足”的分支,而是“循环没有遇到 break 完整结束后的善后处理”。用它来替代传统设置 flag = True 的写法,能显著减少状态标记变量的使用。
第三部分:列表切片、修改与推导式技巧
列表是 Python 最常用的动态数组容器。灵活掌握切片语法 [start:stop:step] 以及推导式,不仅能让代码更精炼,还能规避“迭代中删除元素”的经典陷阱。
题目要求:给定一个包含偶数的列表 numbers = [1, 2, 4, 3, 6, 8, 7, 10],要求将其中所有偶数全部删除。初学者常直接在 for x in numbers: 中执行 numbers.remove(x),指出其为何产生 Bug,并给出两种规范解法。
错误代码与成因排查
# 错误示例:边遍历边删除
nums = [1, 2, 4, 3, 6, 8, 7, 10]
for x in nums:
    if x % 2 == 0:
        nums.remove(x)
print("错误删除结果:", nums) # 结果居然还保留了偶数 4 和 8!Bug 原理解释:列表是连续内存结构。当遍历到索引 1(值为 2)并执行删除后,后面的元素 4 会立即前移至索引 1;而在下一轮循环中,迭代器内部索引自增到 2,导致元素 4 被无声跳过。
正确解法与实现
# 解法 1:使用列表推导式生成过滤后的全新列表(推荐,最直观高效)
raw_nums = [1, 2, 4, 3, 6, 8, 7, 10]
odds_only = [x for x in raw_nums if x % 2 != 0]
print("解法 1 (列表推导式):", odds_only)

# 解法 2:如果必须在原列表上原地修改,采用倒序切片遍历
in_place_nums = [1, 2, 4, 3, 6, 8, 7, 10]
for i in range(len(in_place_nums) - 1, -1, -1):
    if in_place_nums[i] % 2 == 0:
        del in_place_nums[i]
print("解法 2 (倒序原地删除):", in_place_nums)

# 解法 3:切片替换保留对象 id
in_place_nums2 = [1, 2, 4, 3, 6, 8, 7, 10]
in_place_nums2[:] = [x for x in in_place_nums2 if x % 2 != 0]
print("解法 3 (切片整体替换):", in_place_nums2)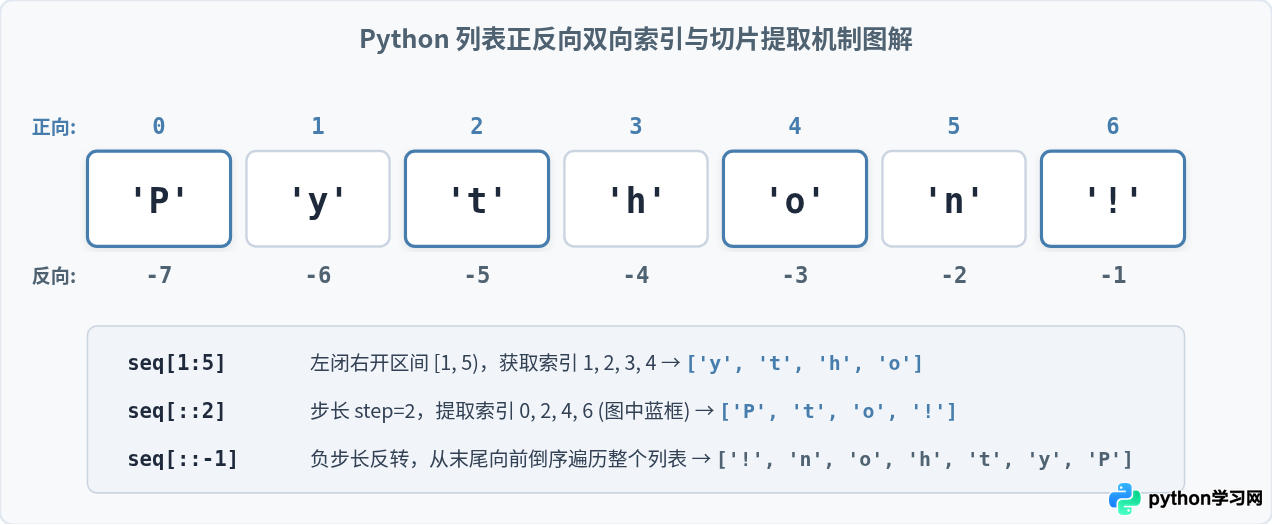
题目要求:给定一个 3×3 的二维矩阵 matrix = [[1, 2, 3], [4, 5, 6], [7, 8, 9]],分别完成:
1. 将矩阵展开为一维列表;
2. 仅保留大于 4 的偶数,并计算其平方;
3. 对矩阵进行行列转置(行变列、列变行)。
参考解答
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

# 任务 1:嵌套推导式展平(双重 for 从外层到内层)
flat = [num for row in matrix for num in row]
print("展平后的一维列表:", flat)

# 任务 2:条件过滤与数值计算
filtered_squares = [num ** 2 for row in matrix for num in row if num > 4 and num % 2 == 0]
print("大于4的偶数平方:", filtered_squares)  # 6^2=36, 8^2=64

# 任务 3:矩阵转置 (两种写法)
# 写法 A: 嵌套列表推导式
transposed = [[row[col] for row in matrix] for col in range(len(matrix[0]))]
print("推导式转置结果:", transposed)

# 写法 B: 更加 Pythonic 的 zip(*) 方式
transposed_zip = [list(col) for col in zip(*matrix)]
print("zip 解包转置结果:", transposed_zip)理解秘诀:阅读多层列表推导式时,其书写顺序与嵌套 for 循环的嵌套层级完全一致。先写的 for row in matrix 对应最外层循环,后写的 for num in row 对应内层循环,末尾跟条件判断 if ...。
第四部分:综合实战题目(串联变量、循环与容器操作)
在实际项目和面试中,很少单独考查某一个语法点,往往需要综合运用变量解包、多层遍历、容器更新与边界处理。
题目背景:系统导出一组员工打卡打卡记录日志列表,每条记录为一个元组 (员工ID, 部门, 每日工时列表):
records = [
    ("E01", "技术部", [8.5, 9.0, 8.0, 10.0, 8.5]),
    ("E02", "运营部", [8.0, 7.5, 8.0, 8.0, 7.0]),
    ("E03", "技术部", [9.5, 11.0, 10.5, 9.0, 12.0]),
    ("E04", "市场部", [8.0, 8.5, 8.0]),
    ("E05", "技术部", [8.0, 8.0, 8.0, 8.0, 8.0])
]
功能要求:
1. 过滤掉数据不完整(有效考勤天数少于 5 天)的记录;
2. 计算每位员工的总工时与日均工时;
3. 筛选出“技术部”且日均工时超过 9.0 小时的加班预警员工,输出其工时排序结果(工时由高到低)。
完整代码实现
def analyze_attendance(raw_data):
    clean_reports = []

    for eid, dept, hours in raw_data:
        # 步骤 1:完整性校验(过滤少于5天的记录)
        if len(hours) < 5:
            continue

        # 步骤 2:聚合与均值统计
        total_hours = sum(hours)
        avg_hours = round(total_hours / len(hours), 2)

        # 步骤 3:部门与加班预警条件筛选
        if dept == "技术部" and avg_hours > 9.0:
            clean_reports.append({
                "eid": eid,
                "dept": dept,
                "total": total_hours,
                "avg": avg_hours,
                "peak_hour": max(hours)
            })

    # 步骤 4:基于日均工时降序排序 (使用 key 函数)
    clean_reports.sort(key=lambda item: item["avg"], reverse=True)
    return clean_reports

# 执行测试
records = [
    ("E01", "技术部", [8.5, 9.0, 8.0, 10.0, 8.5]),
    ("E02", "运营部", [8.0, 7.5, 8.0, 8.0, 7.0]),
    ("E03", "技术部", [9.5, 11.0, 10.5, 9.0, 12.0]),
    ("E04", "市场部", [8.0, 8.5, 8.0]),
    ("E05", "技术部", [8.0, 8.0, 8.0, 8.0, 8.0])
]

alerts = analyze_attendance(records)
print(f"技术部高负荷预警人数: {len(alerts)}")
for r in alerts:
    print(f"员工编号: {r['eid']} | 总工时: {r['total']}h | 日均工时: {r['avg']}h | 单日峰值: {r['peak_hour']}h")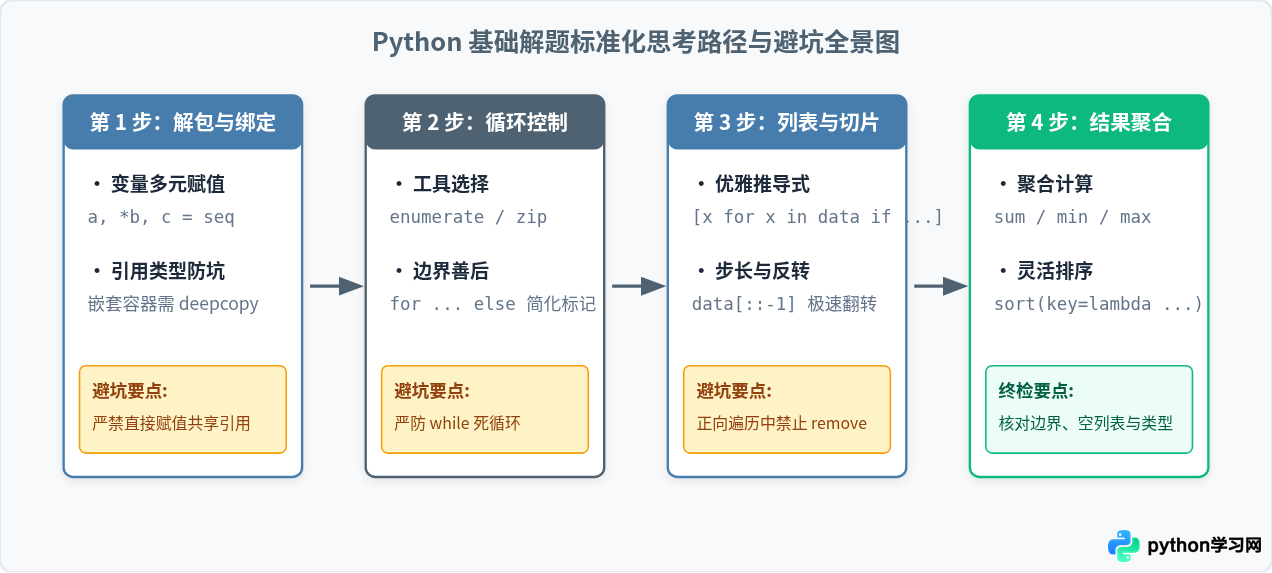
总结与日常练习建议
掌握 Python 的核心在于理解“引用而非容器”的底层模型,以及学会用简洁、直观的内置工具表达业务逻辑。建议在日常编码中保持以下三个良好习惯:
- 善用解包与推导式:多利用
a, b = b, a、enumerate()以及列表推导式简化代码,减少繁琐的手动索引维护。 - 留心可变对象的副作用:当需要传递列表、字典并在局部做破坏性修改时,提前评估是否需要
copy.deepcopy()。 - 避免边遍历边改容器:过滤列表优先选择生成新列表或倒序索引删除,切勿在常规
for ... in循环内调用remove()或pop()。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









