

Python字符串格式化对比:format()、f-string与%操作符怎么选择
深入对比Python中f-string、str.format()与%操作符三种字符串格式化方案的底层运行机制、语法表达力、性能差异与适用场景,提供系统化的工程选型决策指南。
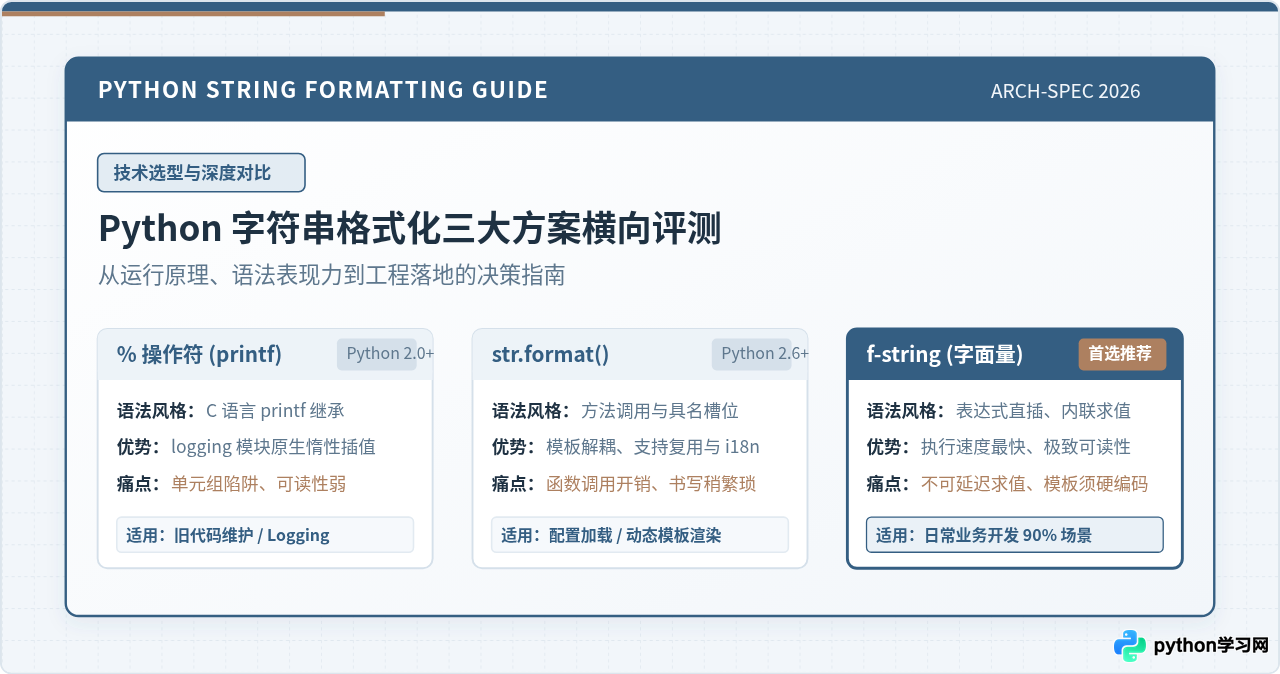
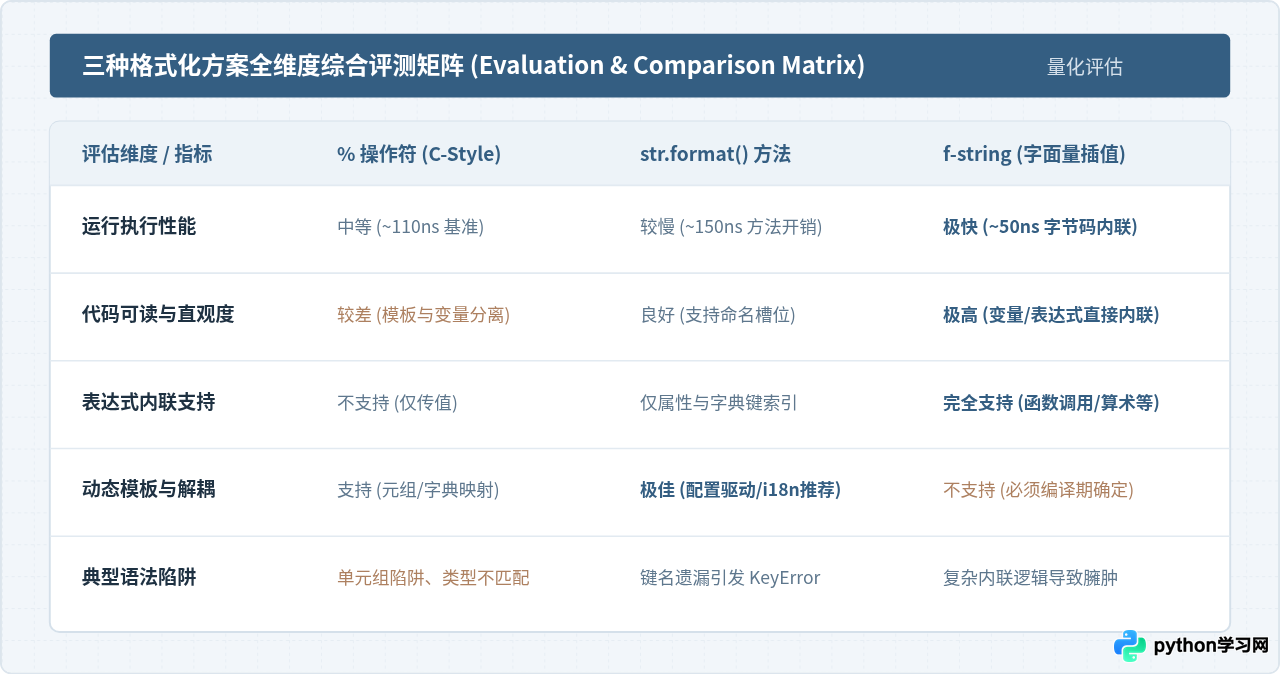
核心结论速览:在 Python 3.6 及更新的现代开发环境中,首选方案始终是 f-string,它在编译期直接转化为高效字节码,代码可读性与运行性能均明显优于其他方案。仅在模板需外部持久化或解耦复用(如配置文件、国际化 i18n 多语言)时选用 str.format();而在标准库 logging 日志输出时保留 % 操作符的传参风格以利用其惰性格式化特性。
一、三种格式化机制的语法特性与使用场景
在 Python 的发展历程中,字符串格式化经历了三次重大演进:从源自 C 语言风格的 % 操作符,到 Python 2.6 / 3.0 引入的 str.format() 方法,再到 Python 3.6 确立的 f-string(PEP 498 格式化字符串字面量)。理解每一代方案的设计意图与语法形态,是做出现实工程决策的基础。
1. % 操作符(printf 风格格式化)
% 格式化操作符直接继承自 C 语言的 printf 系列函数。它的语法是将左侧的格式字符串与右侧的值(或包含多个值的元组/字典)通过 % 符号连接。
# 基础传参:单变量与多变量元组
user_name = "Alex"
login_count = 5
ratio = 98.456

# 示例:基础输出
msg = "用户 %s 登录了 %d 次,成功率为 %.2f%%" % (user_name, login_count, ratio)
print(msg)

# 字典映射方式传参
data = {"host": "127.0.0.1", "port": 8080}
server_info = "服务地址:%(host)s,端口:%(port)d" % data
print(server_info)避坑提示(单元素元组陷阱):当格式化单个变量且该变量恰好是元组类型时,% 操作符会尝试对其解包匹配,从而导致极易忽略的运行时崩溃。例如:data = (1, 2); "数据是: %s" % data 会抛出 TypeError: not all arguments converted during string formatting。必须显式写为 "数据是: %s" % (data,) 才能正常运行。
2. str.format() 方法
为了摆脱 % 的语法陷阱并提供更灵活的格式控制,Python 2.6 引入了 str.format()。它将占位符统一规范为花括号 {},支持位置参数、具名参数以及字典和对象的直接解构。
# 1. 位置参数与重复使用
item = "服务器"
count = 3
text_pos = "{0}状态异常,请管理员检查这 {1} 台{0}。".format(item, count)
print(text_pos)

# 2. 具名参数与解包
config = {"env": "Production", "db_host": "192.168.1.100"}
text_named = "当前运行环境:{env},主库IP:{db_host}".format(**config)
print(text_named)

# 3. 对象属性与索引访问
class Point:
    def __init__(self, x, y):
        self.x, self.y = x, y

p = Point(12, 34)
text_obj = "坐标位置:X={0.x}, Y={0.y}".format(p)
print(text_obj)str.format() 的核心价值在于模板与数据解耦。格式化字符串本身是一个普通的 str 对象,可以存放在 JSON、YAML 或数据库中,在运行时按需获取并动态绑定数据。
3. f-string(格式化字符串字面量)
Python 3.6 引入的 f-string 彻底改变了字符串拼接的书写习惯。只需在字符串前加 f 或 F 前缀,花括号内即可直接填写变量、表达式甚至函数调用。
# 1. 表达式内联与方法调用
user_id = 1024
scores = [85, 92, 78]

report = f"用户 #{user_id:06d} 平均分: {sum(scores) / len(scores):.1f},状态: {'优秀' if sum(scores)/len(scores) >= 85 else '合格'}"
print(report)

# 2. Python 3.8+ 自说明调试语法 (f"{var=}")
width = 1920
height = 1080
print(f"{width=}, {height=}, 面积={width * height}")f-string 不仅语法极其紧凑,而且在代码重构或变量重命名时,IDE 能够识别花括号内的变量引用并自动完成联动修改,维护体验远胜于将变量剥离在括号外部的其他两种方式。
二、底层原理与执行机制剖析
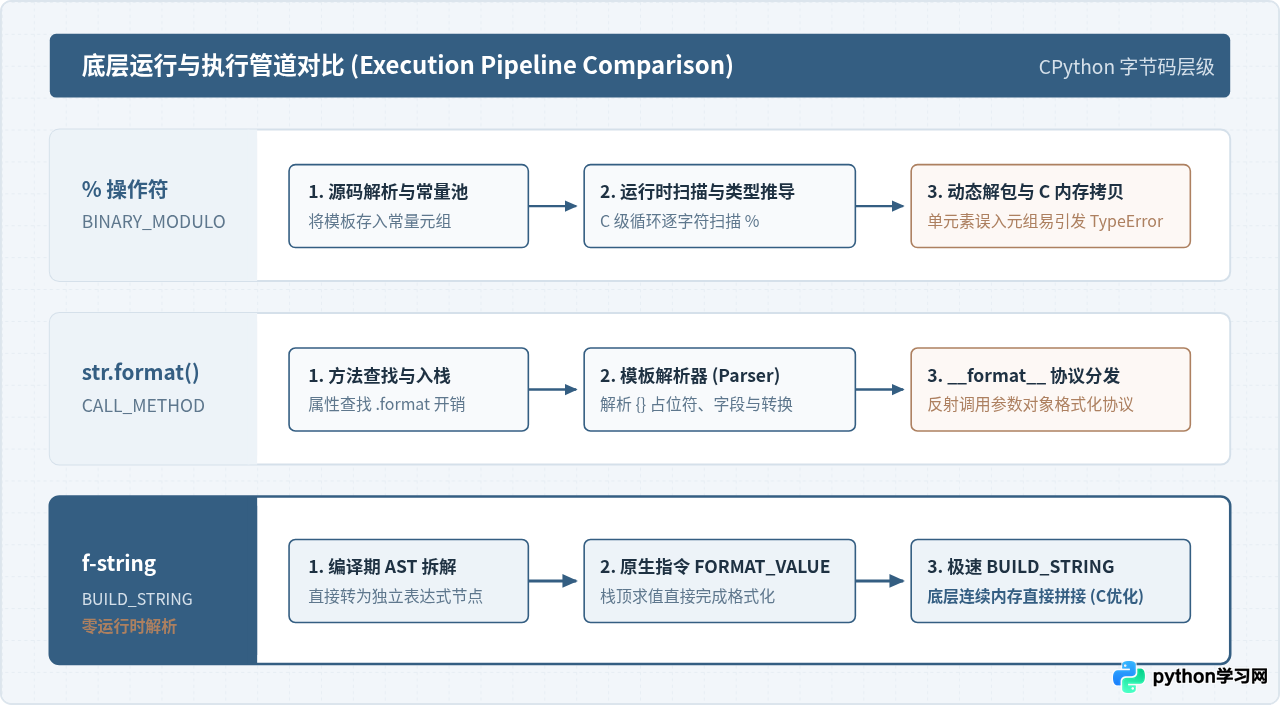
为什么在大多数基准测试中,f-string 的速度比 str.format() 快 2 到 3 倍,甚至比 C 编写的 % 操作符更快?答案藏在 CPython 编译与字节码生成机制中。
通过 Python 标准库 dis 模块反编译三者的执行字节码,可以清晰看清内部差异:
import dis

# 1. % 操作符字节码
dis.dis('"Hello %s" % name')

# 2. str.format() 字节码
dis.dis('"Hello {}".format(name)')

# 3. f-string 字节码
dis.dis('f"Hello {name}"')- % 操作符执行过程:首先将常量字符串和变量压栈,随后触发
BINARY_MODULO操作码。底层 C 函数必须在运行时逐字符解析%,判断格式修饰符并尝试拆解右侧操作数。若传参为元组,则执行元素解包和校验。 - str.format() 执行过程:首先触发
LOAD_METHOD (format),产生一次属性查找与方法对象封装;接着加载参数并执行CALL_METHOD函数调用。函数进入 C 源码后调用内部解析器扫描{}结构,最后通过__format__协议动态分发。这层方法查找和函数调用的开销在密集循环中非常明显。 - f-string 执行过程:由于带
f前缀的字符串在词法分析阶段即被识别,编译器在构建抽象语法树(AST)时就将其拆解为独立表达式。编译出的字节码是专用的FORMAT_VALUE与BUILD_STRING指令。变量在运行时直接从局部变量表(LOAD_FAST)读取并由底层 C 代码一次性分配连续内存进行拼接,完全没有运行时的模板扫描或字典/元组开销。
三、格式规范微语言(Format Specifier)与高频控制技巧
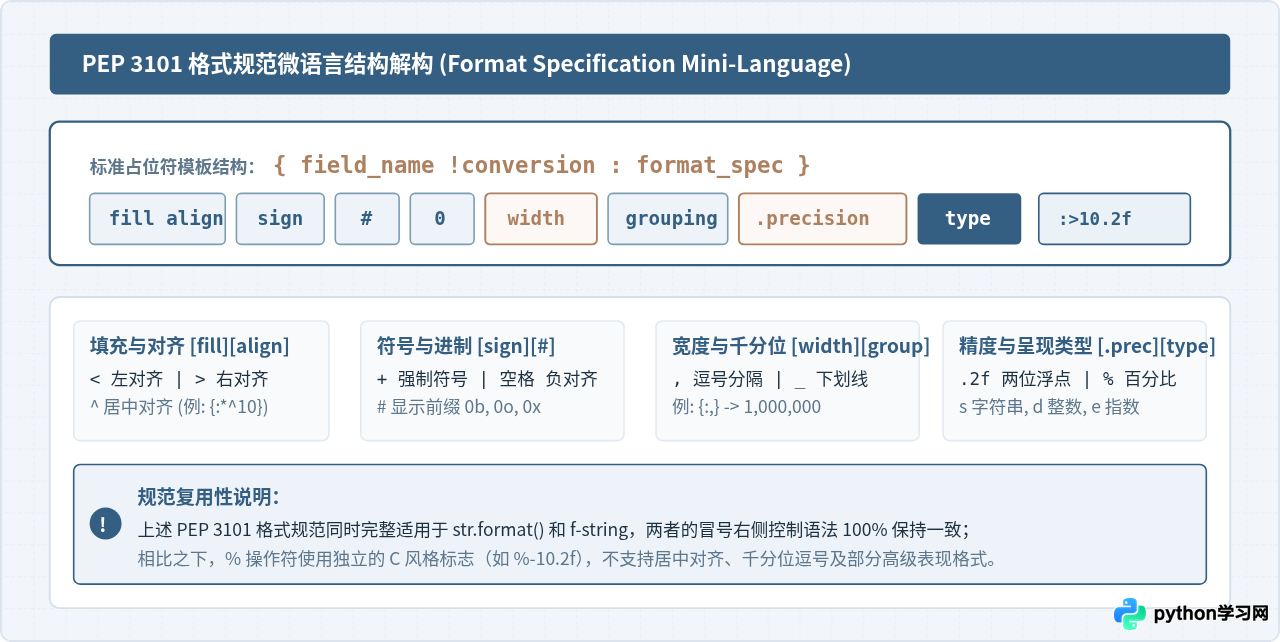
无论是 str.format() 还是 f-string,冒号 : 后面的格式控制规则完全统一,均遵循 PEP 3101 制定的微语言规范。掌握这些常用控制符可以避免手写复杂的字符串补齐或截断逻辑。
| 控制目标 | 控制语法 | 代码示例 | 实际渲染结果 |
|---|---|---|---|
| 数值补零对齐 | :0<width>d |
f"{42:06d}" |
000042 |
| 浮点数精度截断 | :.<prec>f |
f"{3.1415926:.3f}" |
3.142(四舍五入) |
| 千分位分隔符 | :, 或 :_ |
f"{1234567890:,}" |
1,234,567,890 |
| 文本居中与自定义填充 | :<char>^<width> |
f"{\"TITLE\":*^14}" |
****TITLE***** |
| 百分比自动转换 | :.<prec>% |
f"{0.8526:.1%}" |
85.3% |
| 进制转换(带前缀) | :#b / :#x |
f"{255:#x}" |
0xff |
# 综合排版示例:表格行格式化对齐
headers = ["服务名称", "响应延迟", "可用率"]
services = [
    ("AuthService", 12.45, 0.9998),
    ("PaymentGateway", 145.80, 0.9950),
    ("CacheCluster", 1.20, 1.0)
]

print(f"| {headers[0]:<16} | {headers[1]:>10} | {headers[2]:>8} |")
print("|" + "-"*18 + "|" + "-"*12 + "|" + "-"*10 + "|")
for name, latency, avail in services:
    print(f"| {name:<16} | {latency:>8.2f}ms | {avail:>7.2%} |")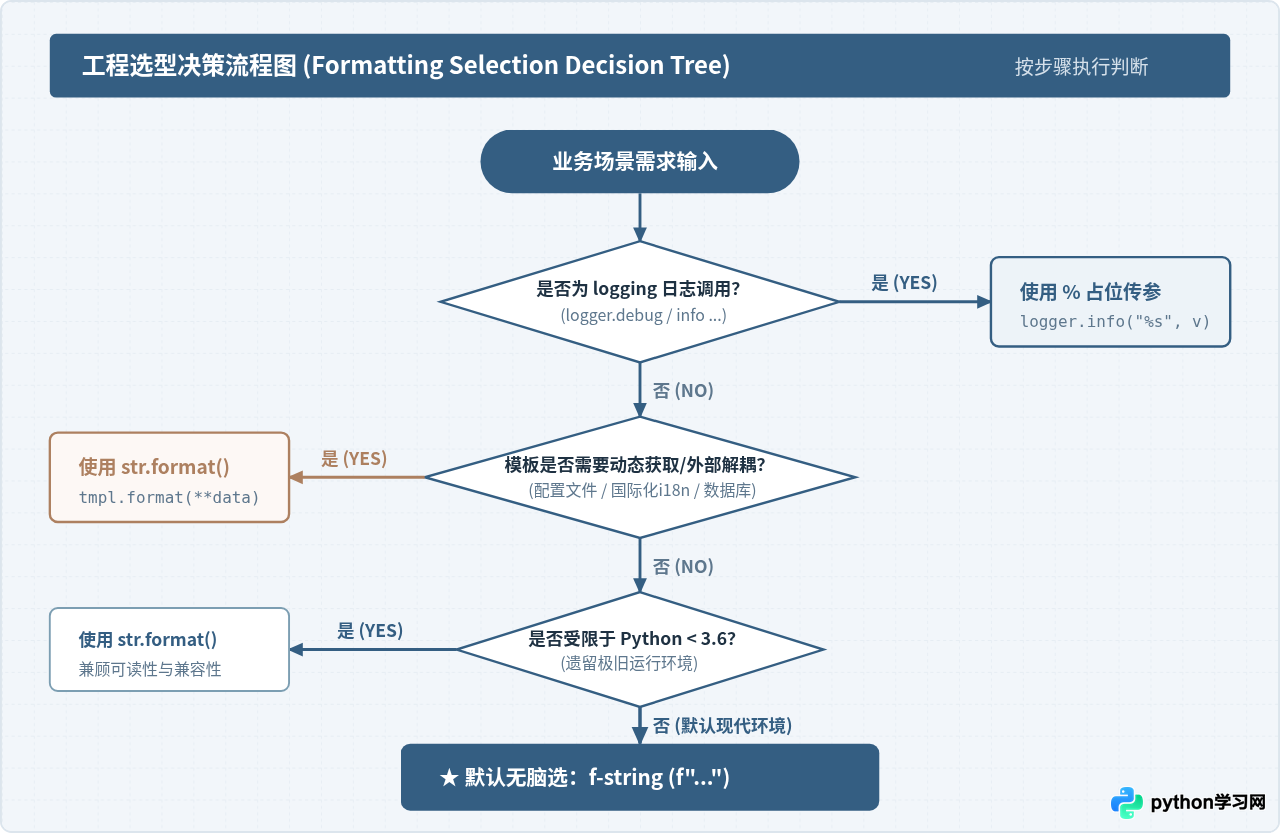
四、工程实战中的场景化选型与决策步骤
面对具体的开发任务,开发者不需要犹豫。遵循以下四步检查清单,即可得出最优选择:
场景 1:标准库 logging 日志记录——唯一推荐使用 % 传参风格
许多初学者习惯在写日志时直接使用 f-string:logger.debug(f"Query returned {len(records)} items from {db_name}")。这是典型的反模式。
当日志级别设置为 INFO 或 WARNING 时,该条 DEBUG 日志本应被直接丢弃。然而,如果使用 f-string,Python 会在进入 logger.debug 之前无条件完成字符串格式化计算;如果里面涉及大列表长度计算、复杂对象序列化或函数调用,哪怕日志不输出,性能消耗也已经发生。
import logging

logger = logging.getLogger("AppEngine")

# 正确做法:利用 logging 的原生惰性求值
# 当日志级别高于 INFO 时,后面的参数完全不会被转换为字符串
logger.info("用户请求完成,耗时: %.2f ms,处理记录数: %d", 42.15, 100)

# 避免在低级别频繁日志中使用 f-string
# logger.debug(f"调试明细: {expensive_serialize(huge_object)}") # 产生无谓开销
场景 2:外部模板、国际化多语言与配置驱动——选择 str.format()
因为 f-string 的花括号内变量在定义时必须能在当前词法作用域内被解析,所以它无法从外部加载动态模板。如果模板内容存储在外部配置、国际化资源包或数据库中,必须选用 str.format()。
# 国际化语言包示例
I18N_TEMPLATES = {
    "zh_CN": "你好,{user_name}!您有 {unread_count} 条未读提醒。",
    "en_US": "Hello, {user_name}! You have {unread_count} unread notifications."
}

def render_notification(lang: str, user: str, count: int) -> str:
    template = I18N_TEMPLATES.get(lang, I18N_TEMPLATES["en_US"])
    return template.format(user_name=user, unread_count=count)

print(render_notification("zh_CN", "张伟", 3))
print(render_notification("en_US", "David", 3))场景 3:常规业务开发、数据分析与算法逻辑——无条件首选 f-string
只要是代码中硬编码的字符串、API 响应组装、路径拼接、报表输出或内部格式化,无条件默认使用 f-string。它不仅语法最短、拼写直观,而且在现代 Python 解释器(Python 3.11/3.12+ 引入专有自适应编译器)中享有持续的字节码优化红利。
五、安全红线与开发常见误区
字符串格式化虽然是基础操作,但在安全和复杂逻辑处理上存在几个高发隐患,必须严格防范:
1. 绝不要使用任何字符串格式化拼接 SQL 语句
无论是 %、str.format() 还是 f-string,它们的作用仅限于纯文本合成,对参数不具备任何 SQL 语义转义功能。用其拼接 SQL 参数是 SQL 注入漏洞的头号根源。
# 致命错误:无论用哪种格式化都存在注入风险
# cursor.execute(f"SELECT * FROM users WHERE username = '{user_input}'")

# 正确做法:必须交给数据库驱动的参数化占位符
cursor.execute("SELECT * FROM users WHERE username = %s", (user_input,))
2. 防止 str.format() 暴露敏感对象属性
str.format() 允许访问对象属性,如 "{user.password_hash}".format(user=current_user)。如果格式化模板来源于不受信任的用户输入(例如用户自定义的邮件通知模板),恶意用户可能通过 {0.__class__.__init__.__globals__} 等路径渗透全局命名空间获取敏感配置与密钥。当需要支持用户自定义模板时,应改用标准库 string.Template。
3. 控制 f-string 内联逻辑的复杂度
虽然 f-string 允许在 {} 内写任意复杂的 Python 表达式(包括列表推导式、三元运算甚至 lambda),但如果表达式过长,会严重破坏代码可读性。建议遵循单行规则:如果表达式需要折行或超过 2 个逻辑操作符,应提前在上一行赋值给有明确语义的局部变量,再传入 f-string。
六、全文选型速查表
通过下表即可在 5 秒钟内确定团队代码规范中的技术选型策略:
| 场景分类 | 推荐方案 | 选用理由与判定规则 |
|---|---|---|
| 日常业务逻辑、拼接输出 | f-string | 速度最快、代码最简洁、支持 IDE 语法检查与符号重构 |
| logging 模块输出 | % 操作符风格 | logger.info("msg: %s", v) 具备原生惰性求值特性,避免无谓计算 |
| 配置模板、外部国际化资源 | str.format() | 模板与数据彻底解耦,支持从文件动态载入与参数批量解包 |
| 包含用户输入的外部自定义模板 | string.Template | 禁止访问对象内部属性,彻底切断沙箱逃逸与信息泄露隐患 |
| 兼容极旧项目 (Python < 3.6) | str.format() | 比 % 更安全、无单元素元组陷阱,且语法规范通用 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









