

现在学Python还有前景吗?后端开发与数据科学岗位需求分析
深入分析当前技术就业环境下学习Python的前景,从企业级后端开发与数据科学/AI工程两大核心赛道出发,全面解析招聘诉求、硬性技术栈、实战代码架构与进阶择业路径。
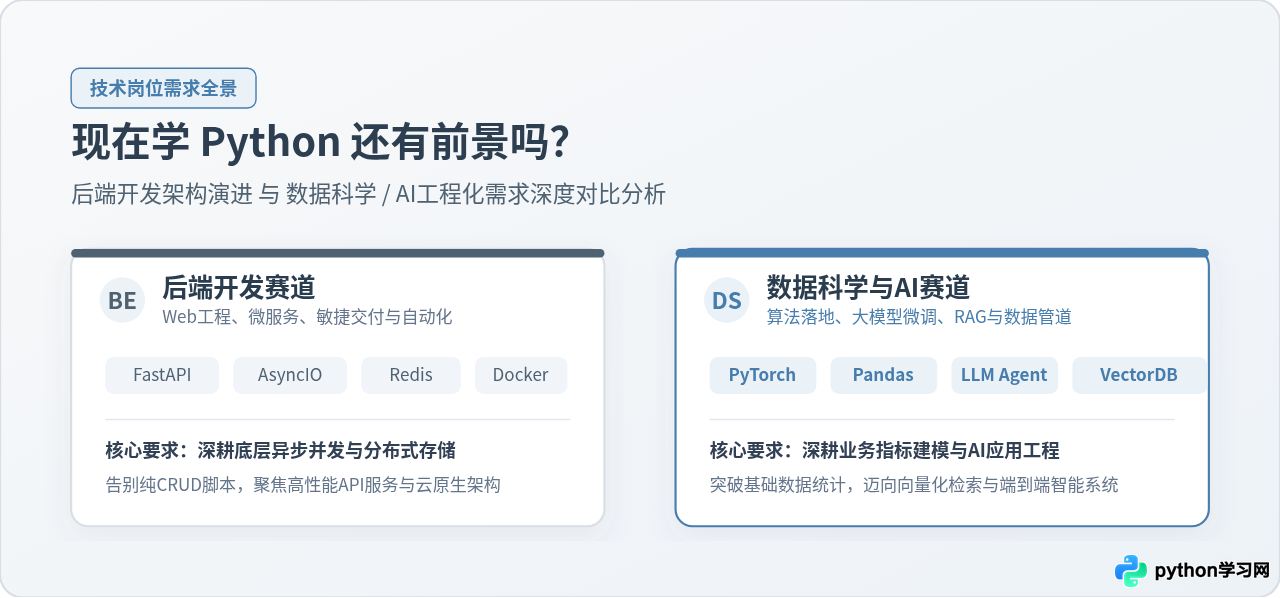
学 Python 依然具备明确前景,但行业早已走出“只要掌握基础语法就能轻松入职”的泡沫阶段。目前的用人市场呈现出高度务实的双轨分化:在后端开发领域,纯粹的 CRUD 脚本已被边缘化,企业高度聚焦在基于 FastAPI/AsyncIO 的高性能异步微服务、AI 原生应用中台以及与底层系统存储的协同交付;在数据科学与 AI 领域,单纯画图表的基础分析岗位基本饱和,人才需求正全面向特征工程管道、深度学习微调推理、大模型 Agent 与向量检索(RAG)工程化迁移。决定未来就业竞争力的不再是语言本身,而是结合业务场景解决复杂工程问题的纵深能力。
一、双轨分化:从“语言红利”进入“工程深水区”
评估一门编程语言的前景,核心在于分析它在生产环境中承载的业务载荷与技术壁垒。过去数年间,Python 凭借简洁优雅的语法成为许多人入门编程的首选,但这种低门槛同时也导致了初级人才市场严重供过于求。企业在招聘时对“掌握 Python”的理解发生了根本转变:懂得变量循环、面向对象基础只是准入门槛,能独立完成高可用服务搭建或工业级数据建模才是真实考核标准。
在主流技术岗位中,Python 的核心就业阵地明确收敛于两个方向:后端工程开发与数据科学 / AI 应用工程。这两个方向在业务目标、技术栈选型以及企业考核维度上存在显著差异。
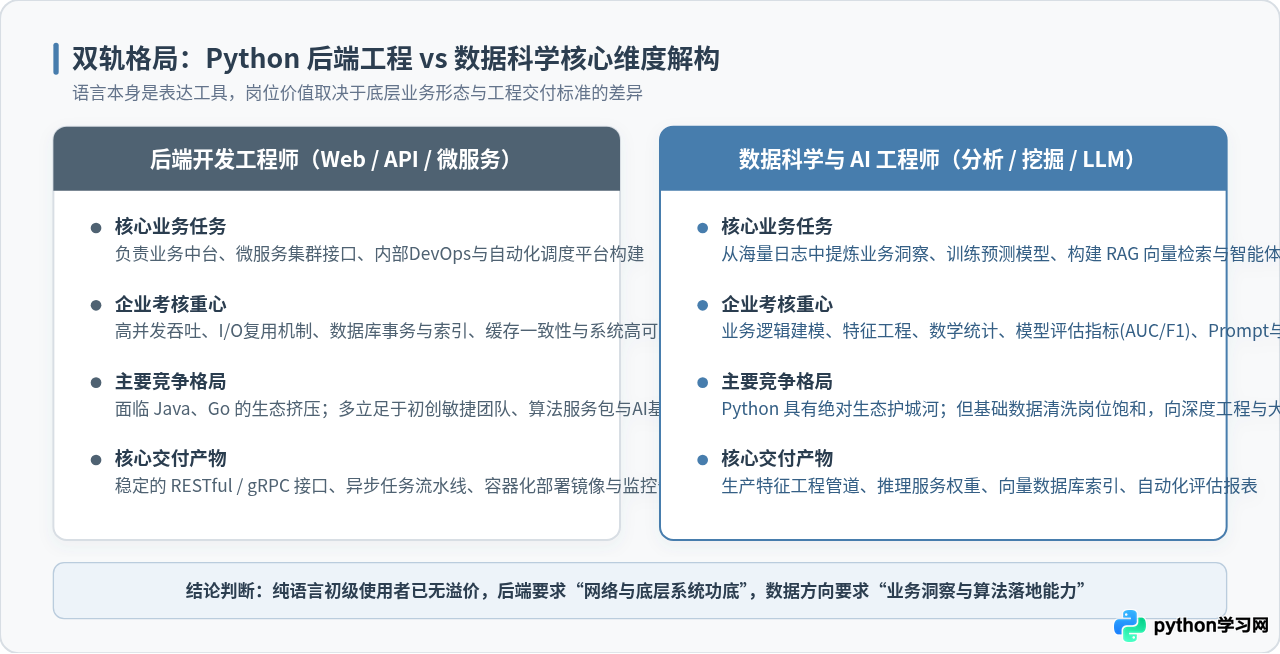
从上图对比可以看出:
- 后端工程开发:核心指标是可用性、高并发吞吐与数据一致性。企业关注候选人是否理解网络协议栈、操作系统的 I/O 多路复用、异步事件循环机制以及数据库事务隔离级别。
- 数据科学与 AI:核心指标是业务洞察力、算法转化率与端到端系统工程能力。企业关注候选人能否从混乱的数据中提取高质量特征、微调并部署模型,以及在生产中构建低延迟的大模型增强检索系统。
二、后端开发赛道:岗位需求与技术破局点
在国内互联网开发生态中,Java 在超大规模分布式电商与金融核心系统中占据稳固地位,Go 语言在云原生基础架构中广泛普及。在这样的市场格局下,企业在哪些场景下招聘 Python 后端?
调研企业实际招聘诉求,Python 后端的核心岗位主要分布在以下四类场景:
- AI 原生应用与智能体(Agent)后端:由于主流大模型 SDK、PyTorch 模型推理服务与向量检索组件几乎全部首发或深度绑定 Python,直接采用 FastAPI 构建对外 API 服务能够显著降低团队跨语言通信的序列化开销。
- 快速业务迭代与 MVP 产品验证:海外团队、国内出海初创企业以及中小型敏捷团队,依赖 Python 极高的开发吞吐率,在数周内完成产品原型上线。
- 企业内部中后台与运维自动化平台:DevOps 平台、资产治理系统、自动化测试流水线以及数据集成中台,通常采用 Django 或 Flask 快速交付管理后台。
- 异步微服务与数据聚合接口:利用现代 AsyncIO 栈开发的高吞吐 I/O 密集型聚合网关。
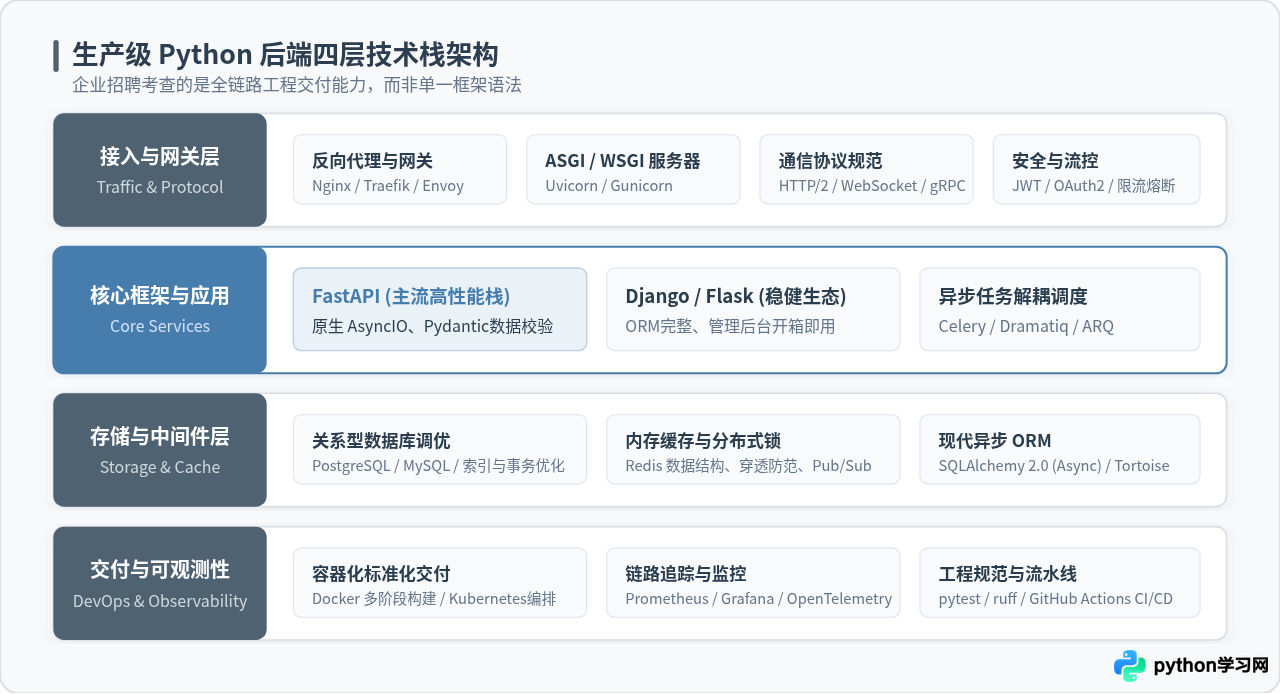
生产级技术标准:从同步阻塞到原生异步
若希望在 Python 后端岗位中保持竞争力,学习技术栈必须从传统的同步阻塞模型切换至现代异步体系。以下是一个典型的基于 FastAPI、Pydantic 与异步上下文管理的生产级 API 服务代码示例,展示了如何组织结构化请求校验与数据操作。
from fastapi import FastAPI, HTTPException, status, Depends
from pydantic import BaseModel, Field, EmailStr
from typing import Optional
import asyncio

app = FastAPI(title="UserTaskService", version="1.0.0")

# 1. 强类型请求模型定义
class CreateTaskRequest(BaseModel):
    title: str = Field(..., min_length=3, max_length=100, description="任务标题")
    contact_email: EmailStr = Field(..., description="通知邮箱")
    priority: int = Field(default=1, ge=1, le=5, description="优先级 1-5")

class TaskResponse(BaseModel):
    task_id: str
    status: str
    message: str

# 2. 模拟异步数据库持久化操作(非阻塞I/O)
async def save_task_to_storage(task_data: CreateTaskRequest) -> str:
    # 真实场景中此处调用 asyncpg / Tortoise-ORM 进行异步写入
    await asyncio.sleep(0.05)  # 模拟网络I/O延迟
    return f"tsk_{abs(hash(task_data.title)) % 1000000}"

# 3. 生产端点设计:依赖注入与结构化异常处理
@app.post("/api/v1/tasks", response_model=TaskResponse, status_code=status.HTTP_201_CREATED)
async def create_task_endpoint(payload: CreateTaskRequest):
    try:
        task_id = await save_task_to_storage(payload)
        return TaskResponse(
            task_id=task_id,
            status="pending",
            message="Task successfully queued for execution"
        )
    except Exception as exc:
        raise HTTPException(
            status_code=status.HTTP_500_INTERNAL_SERVER_ERROR,
            detail=f"Database persistence failure: {str(exc)}"
        )

# 4. 健康检查端点(供 Kubernetes 探针探测)
@app.get("/healthz", status_code=status.HTTP_200_OK)
async def health_check():
    return {"status": "healthy"}
执行该服务的启动命令与示例测试过程如下:
# 启动生产就绪的 ASGI 服务(配置 4 个异步 Worker)
uvicorn backend_service:app --host 0.0.0.0 --port 8000 --workers 4

# 使用 curl 发起符合校验规则的 POST 请求
curl -X POST "http://127.0.0.1:8000/api/v1/tasks" -H "Content-Type: application/json" -d '{"title": "Sync Customer Profile", "contact_email": "ops@example.com", "priority": 3}'{"task_id":"tsk_849201","status":"pending","message":"Task successfully queued for execution"}
三、数据科学与 AI 赛道:技能演进与需求爆发点
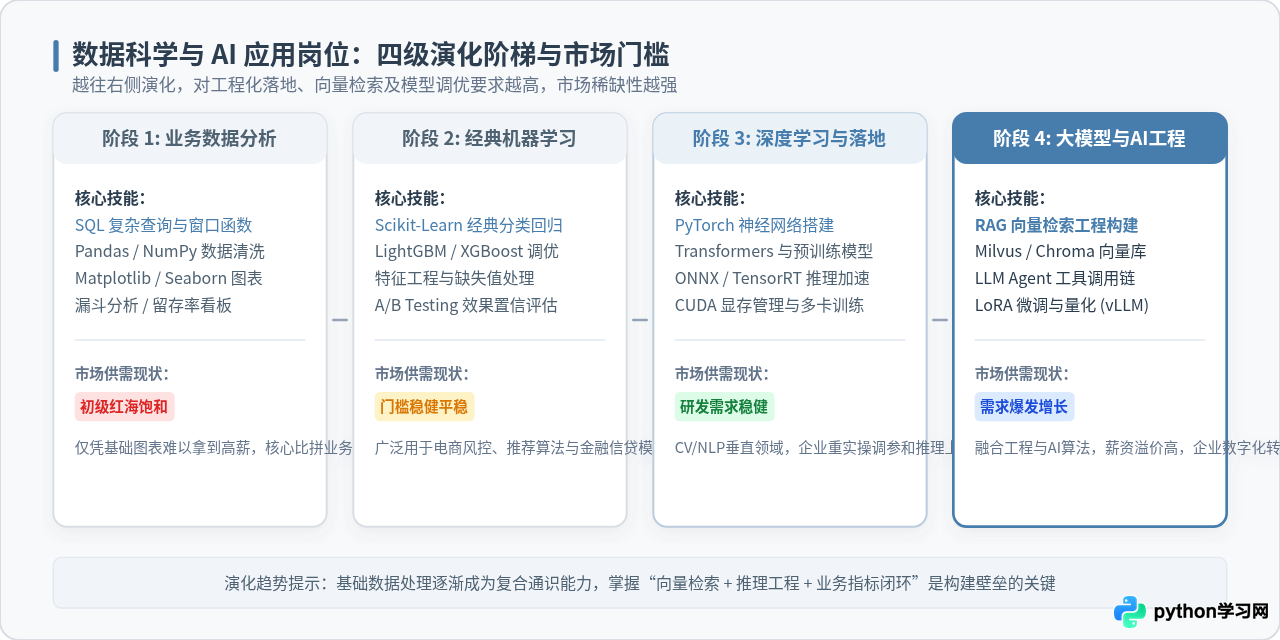
在数据科学领域,Python 依然是无可争议的第一生产力工具。无论是科学计算生态(NumPy、SciPy)、机器学习库(Scikit-Learn),还是深度学习框架(PyTorch、HuggingFace Transformers),Python 始终处于主导地位。
但必须正视的是,传统的“基础数据分析师”岗位供给严重过剩。仅仅会使用 Pandas 读取 Excel、调用 groupby() 做指标汇总、画几张柱状图,在当下的招聘市场上已经很难获得竞争优势。与此同时,以大模型微调、RAG 向量检索工程与智能体落地为代表的新兴岗位,正在释放大量高薪需求。
前沿实战:向量化清洗与检索增强管道
为了向工程化迈进,数据科学从业者需要掌握从结构化数据处理到非结构化文本向量化的全流程。以下代码演示了如何使用 Pandas 进行规范化数据清洗,并构建简易向量检索索引的核心逻辑。
import numpy as np
import pandas as pd
from typing import List, Dict

# 1. 模拟企业原始业务日志数据
raw_records = [
    {"doc_id": 101, "content": "FastAPI provides high performance async REST endpoints.", "category": "backend"},
    {"doc_id": 102, "content": "Pandas enables efficient tabular data manipulation and cleaning.", "category": "data"},
    {"doc_id": 103, "content": "PyTorch supports dynamic tensor computation and deep learning.", "category": "ai"},
    {"doc_id": 104, "content": "   ", "category": "invalid"},  # 脏数据需剔除
]

# 2. 数据清洗与格式标准化
df = pd.DataFrame(raw_records)
df["content"] = df["content"].str.strip()
clean_df = df[df["content"].str.len() > 0].reset_index(drop=True)

# 3. 简易特征向量化示例(基于预设维度的确定性语义映射,模拟 Embedding 输出)
def mock_embedding(text: str) -> np.ndarray:
    # 模拟 4 维语义空间:[后端, 数据, 智能AI, 系统网络]
    vec = np.zeros(4, dtype=np.float32)
    t = text.lower()
    if "api" in t or "rest" in t or "backend" in t: vec[0] += 0.8
    if "data" in t or "cleaning" in t or "tabular" in t: vec[1] += 0.9
    if "learning" in t or "ai" in t or "tensor" in t: vec[2] += 0.85
    if "network" in t or "async" in t: vec[3] += 0.7
    norm = np.linalg.norm(vec)
    return vec / norm if norm > 0 else vec

# 构建向量索引列
clean_df["vector"] = clean_df["content"].apply(mock_embedding)

# 4. 向量余弦相似度检索函数
def search_top_k(query: str, data: pd.DataFrame, top_k: int = 1) -> List[Dict]:
    q_vec = mock_embedding(query)
    scores = []
    for idx, row in data.iterrows():
        # 余弦相似度计算:dot(a, b) / (|a|*|b|)
        sim = float(np.dot(q_vec, row["vector"]))
        scores.append((sim, row["doc_id"], row["content"]))

    scores.sort(key=lambda x: x[0], reverse=True)
    return [{"score": round(s[0], 4), "doc_id": s[1], "content": s[2]} for s in scores[:top_k]]

# 5. 执行语义查询示例
if __name__ == "__main__":
    search_query = "How to train deep learning neural models?"
    results = search_top_k(search_query, clean_df, top_k=1)
    for res in results:
print(f"匹配得分: {res['score']} | 文档ID: {res['doc_id']} | 匹配内容: {res['content']}")匹配得分: 0.9632 | 文档ID: 103 | 匹配内容: PyTorch supports dynamic tensor computation and deep learning.
在真实的工业级 AI 生产环境中,上述代码中的向量计算会被替换为专业的向量数据库(如 Milvus、Qdrant、Chroma),向量抽取则接入 BGE 或 OpenAI 嵌入模型。能够将清洗脚本转化为生产级特征管道,并搭建具备混合检索与防幻觉重排能力的 RAG 系统,是目前数据岗位最核心的薪资溢价来源。
四、学习进阶与求职决策路径
如果决定学习 Python,切忌在泛泛的基础教程中反复徘徊。一个科学、可量化且面向就业的进阶路径应该分为清晰的阶段,每个阶段都设定确定的产出物与自检标准。
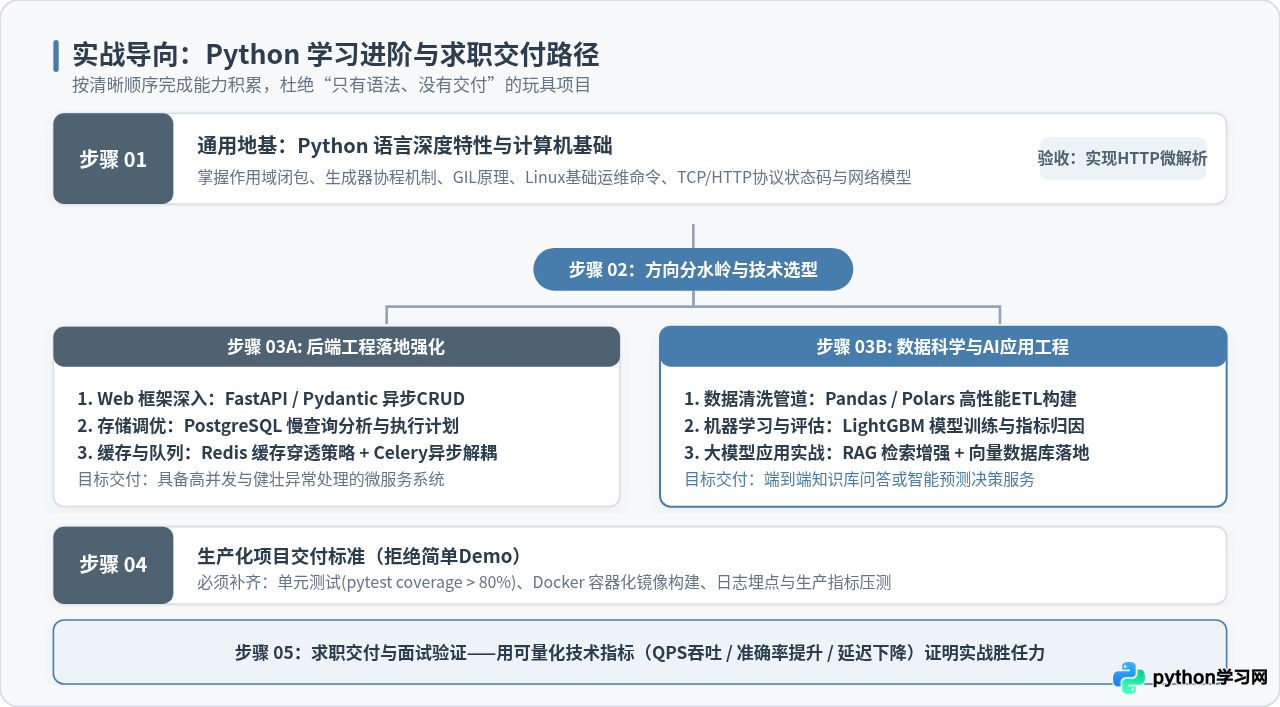
分阶段执行指南
-
第一阶段:扎实基础与语言底层机制(建议用时 3-4 周)
- 重点掌握:列表推导、生成器与
yield、装饰器原理、垃圾回收(引用计数与分代回收)、GIL(全局解释器锁)的工作机制与应对策略。 - 计算机体系:Linux 常用操作(进程监控、日志排查、网络端口检测)、TCP 三次握手与 HTTP/HTTPS 协议原理。
- 重点掌握:列表推导、生成器与
-
第二阶段:方向分流与核心框架攻坚(建议用时 6-8 周)
- 选择后端线:深入掌握 FastAPI 或 Django;深入学习 PostgreSQL 复杂 SQL 与索引失效排查;掌握 Redis 缓存淘汰机制、分布式锁与 Celery 异步队列。
- 选择数据 / AI 线:精通 Pandas / Polars 高性能处理;掌握 Scikit-Learn 常用模型与特征工程;掌握 PyTorch 核心计算流,并熟悉主流大模型 Agent 框架与向量库操作。
-
第三阶段:生产级项目交付与避坑(建议用时 4 周)
- 拒绝“玩具 Demo”:项目必须包含规范的 Git 提交记录、详细的 README、通过 pytest 编写的单元测试(覆盖核心分支逻辑)。
- 容器化交付:编写多阶段构建的
Dockerfile与docker-compose.yml,保证服务在一台干净的 Linux 主机上一键启动成功。
五、综合决策评估与总结
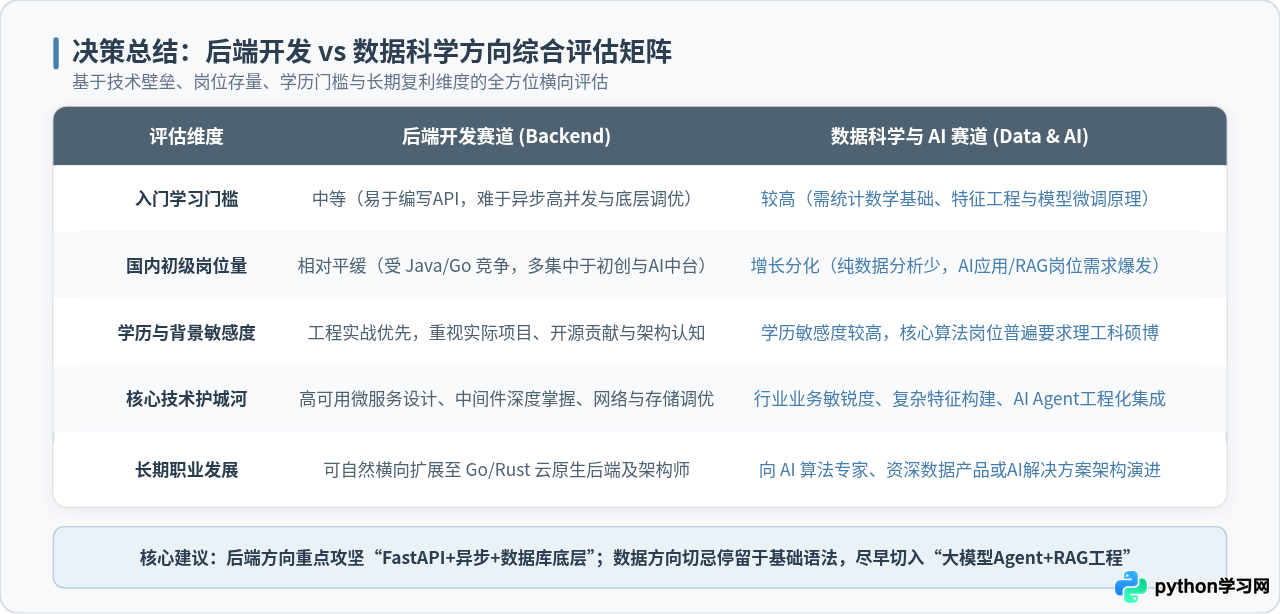
为了帮助不同背景的读者明确个人发展策略,下表从学习难度、学历敏感度、岗位空间与技术护城河四个维度,对后端开发与数据科学两大方向进行了量化对比:
| 评估维度 | 后端开发赛道 (Backend) | 数据科学与 AI 赛道 (Data & AI) |
|---|---|---|
| 适合人群 | 逻辑严密、喜欢软件工程架构、对底层系统与接口稳定性有追求的开发者 | 对数据敏感、数学统计基础扎实、希望将业务与 AI 算法深度融合的开发者 |
| 学历门槛 | 工程实操重于名校光环,大专/本科理工科在掌握成熟项目后具备就业机会 | 学历门槛相对更高,中高级算法及大模型微调岗位普遍倾向统招硕士及以上 |
| 初级岗位现状 | 大厂核心业务以 Java/Go 为主;Python 后端集中在出海公司、AI 初创与中后台 | 基础数据分析严重饱和;AI 原生应用、RAG 向量工程与大模型部署处于人才紧缺期 |
| 技术护城河 | 高并发服务治理、数据库底层调优、容器编排与全链路可观测性 | 业务敏感度与数据洞察、复杂特征抽象、前沿算法复现与推理降本能力 |
结论
回到最初的问题:现在学 Python 还有前景吗?
答案是肯定的,但机会属于那些超越语法层面、深耕具体工程领域的践行者。Python 作为现代人工智能和数据基础设施的“胶水语言”与核心入口,其生态地位短期内无可撼动。如果你的目标是后端开发,请以扎实的异步网络编程、数据库系统设计与云原生部署为护城河;如果你的目标是数据科学与 AI,请尽早走出机械统计的舒适区,将精力投入到特征管道工程、模型微调与智能体系统构建中。
跳过空洞的理论背诵,搭建起自己的生产级代码库与指标验证体系,就是打开 Python 职业前景的最佳路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









