

初学者该学Python还是R语言?语法难度与学习曲线对比分析
针对零基础与初学者的Python与R语言深度对比指南,从语法设计哲学、数据处理范式、三阶段学习曲线心智阻力及职业选型决策树,帮助读者快速找到适合自己的学习路径。
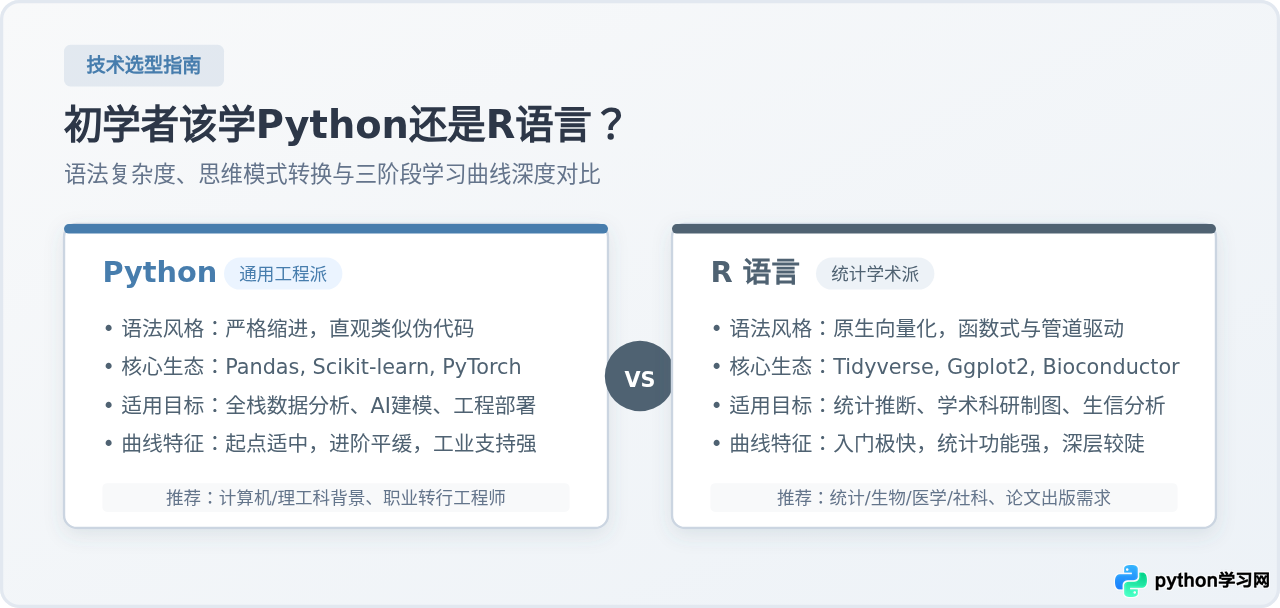
一、语法设计哲学:计算机思维与统计学思维的碰撞
编程语言的语法风格直接决定了初学者敲下前一百行代码时的心智负担。Python 和 R 语言在这个维度上呈现出完全不同的底层设计逻辑:Python 诞生的初衷是一门优雅而通用的面向对象脚本语言,而 R 语言从一开始就是统计学家为统计分析量身打造的领域专用环境。
1. Python 语法特征:规则高度统一的工程范式
Python 奉行“显式优于隐式”与“只有一种最佳写法”的原则。它的核心语法特征是严格的代码缩进和面向对象的方法调用链。初学者在编写 Python 代码时,必须时刻保持逻辑结构的严谨性,例如缩进错误(IndentationError)会直接阻断程序运行。
在数据处理领域,Python 并不依赖语言内建的数据表结构,而是通过第三方工业级库(最典型的如 Pandas)来提供支持。这意味着初学者需要先掌握模块导入、对象实例化、方法调用等基础软件工程概念,才能正式开始操作数据。
2. R 语言语法特征:原生向量化与直觉流式管道
与 Python 形成鲜明对照的是,R 语言将“向量”(Vector)和“数据框”(data.frame)作为一等公民内置于语言核心中。在 R 中,对一个数值集合做加减乘除不需要编写显式循环,解释器会自动在向量级别完成并行运算。
在现代 R 语言生态(特别是 Tidyverse 体系)中,代码的书写方式极度接近自然语言流程。通过原生管道操作符 |>(或 Magrittr 管道符 %>%),数据像流水一样在各个处理函数之间传递,省去了深层函数嵌套或不断覆盖临时变量的繁琐步骤。
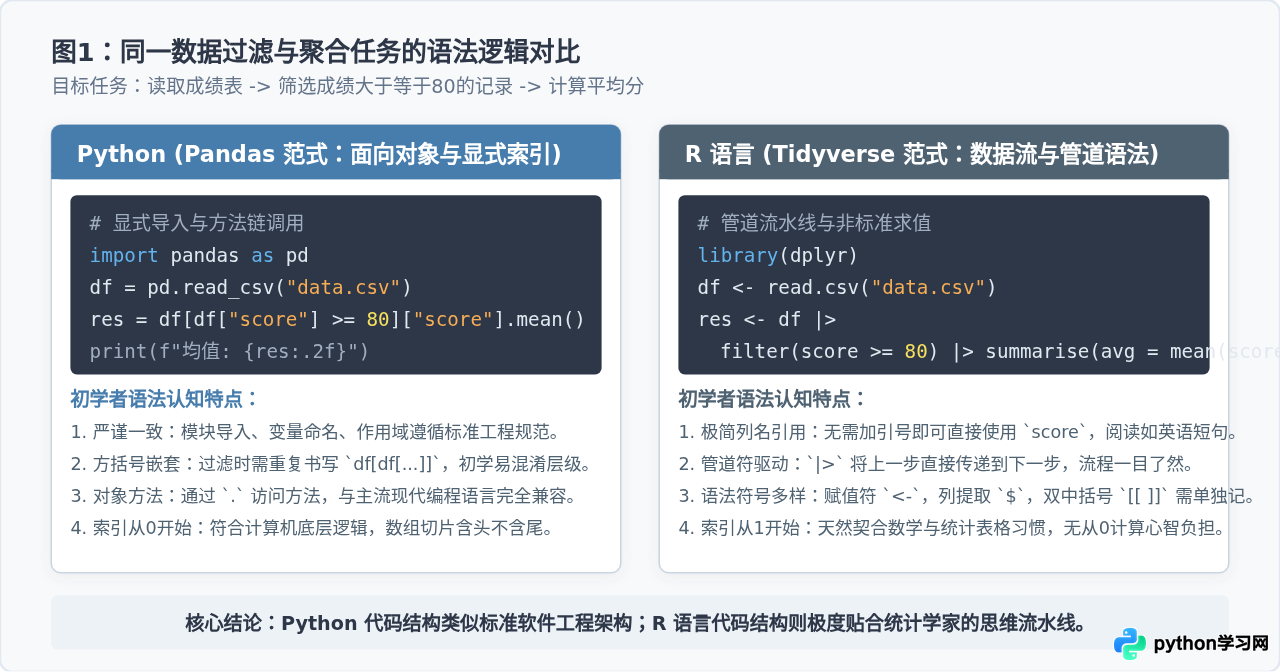
3. 具体代码任务横向对比
为了直观展现两者在具体书写时的差异,我们设定一个常见的数据清洗场景:从一张成绩单中读入数据,筛选出得分大于等于80分的样本,并计算其平均分。
import pandas as pd

# 读取并完成条件过滤与均值统计
df = pd.read_csv("scores.csv")
filtered_df = df[df["score"] >= 80]
mean_val = filtered_df["score"].mean()

print(f"筛选平均值: {mean_val:.2f}")library(dplyr)
# 读取并通过管道完成过滤与均值统计
df <- read.csv("scores.csv")
res <- df |>
filter(score >= 80) |>
summarise(mean_val = mean(score))
cat("筛选平均值:", round(res$mean_val, 2))从上述对比中可以清晰发现两者的语法认知差异:
- 变量选择与作用域:Python 中引用列名必须通过方括号字符串下标
df["score"],初学者在写布尔筛选时容易被df[df[...] >= 80]的双层嵌套弄晕;而 R 的filter()函数采用非标准求值机制(NSE),直接把score当作上下文变量传入,书写如同直接说话,极其符合人类直觉。 - 基础符号习惯:Python 遵循通用的等号赋值
=和以 0 为起点的数组索引(符合硬件指针偏移逻辑);R 语言更习惯使用箭头符号<-赋值,列属性提取使用$符,且数组与向量索引从 1 开始(符合人类统计表格习惯)。
二、学习曲线演进轨迹:两门语言在不同阶段的心智阻力
很多初学者会单纯询问“哪门语言更容易学”,但事实上,“容易”是一个随学习阶段动态变化的相对概念。两门语言的学习曲线并不是平行的,而是在不同时间节点展现出迥异的陡峭度。
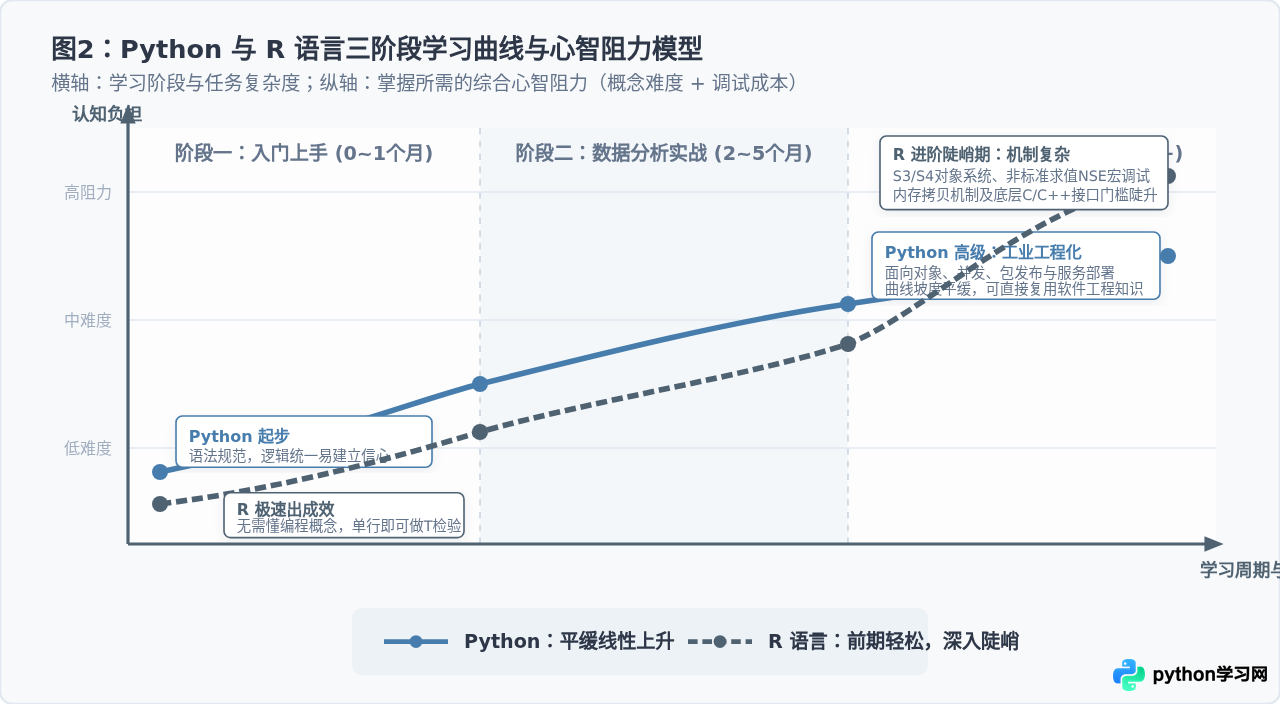
1. 入门上手期(0~1个月):R 语言见效更快,Python 规则更通用
在最初接触的几周里,非计算机背景的初学者(如医学、文科、经济类学生)通常会觉得 R 语言更亲切。因为在这个阶段,初学者只需要把 R 当作一个“功能极其强大的超级统计计算器”。你无需理解类、模块、对象继承或虚拟环境,只要安装好 RStudio,加载一个内置数据集,输入 summary(df) 或 t.test(x, y),就能瞬间获得标准的统计报表输出。
相比之下,Python 在入门第一周需要花时间配置开发环境、搞清 pip 包管理、理解缩进规则、以及习惯列表、字典、元组的区别。虽然初期搭建环境的阻力稍大,但 Python 传授给初学者的是标准的计算机科学通用思维,这种思维在未来学习任何其他语言时都可以直接迁移。
2. 数据分析实战期(2~5个月):两门语言旗鼓相当
当学习进入数据清洗、表格转换、异常值排查和基础可视化时,两门语言的体验进入最舒适的阶段:
- R 语言的 Tidyverse 协同效应:通过
dplyr进行切片重排,通过tidyr展开长宽表,通过ggplot2叠加图层。这一整套工具链的设计理念高度统一,语法规范严丝合缝,初学者一旦建立起“数据流与图形语法”的概念,生产力会呈爆发式增长。 - Python 的 Pandas 体系成熟:初学者开始掌握
groupby、透视表pivot_table和merge操作。尽管 Pandas 存在部分历史遗留语法(例如.loc与.iloc的区分、视图与副本的SettingWithCopyWarning警告),但因其文档极其详实、Stack Overflow 上的社区解答极为海量,初学者遇到的绝大多数报错都能在 30 秒内检索到现成解决方案。
3. 深入拓展与底层机制期(6个月以上):Python 平缓上升,R 语言陡然升高
当项目规模从单次数据分析作业,扩大到自动化批量处理、复杂算法实现或系统部署时,两者的曲线彻底分道扬镳:
Python 的进阶过程平缓而清晰:进一步学习函数式装饰器、多进程并发、面向对象设计模式、FastAPI 接口封装,其逻辑依然遵循现代软件工程的一贯准则。代码组织结构模块化,非常容易编写单元测试并持续交付。
R 语言的进阶阻力显著上升:深入 R 语言底层时,初学者会迎面撞上其复杂的历史演进产物——多套并存的面向对象系统(S3、S4、RC、R6),各自有一套截然不同的方法派发机制;为了实现优雅的管道求值,内部运用了复杂的非标准求值(NSE)和 rlang 闭包环境,一旦出现深层报错,调用栈的调试门槛极高;此外,R 默认的传值副本机制(Copy-on-Modify)在处理超大规模数据时容易触发内存瓶颈,需要开发者深入理解内存指针或借助 data.table / C++ (Rcpp) 进行重构优化。
三、生态与交付物对比:决定终局的关键不是语言本身
编程语言只是实现目标的载体。初学者在选择时,必须考察自己未来需要向外界交付什么成果,因为两者的生态圈侧重点有着明确的天然分界。
| 核心任务场景 | Python 推荐工具链 | R 语言 推荐工具链 | 场景实操体验与权衡要点 |
|---|---|---|---|
| 前沿学术制图 | Matplotlib, Seaborn | ggplot2, ggpubr | ggplot2 遵循图形语法(Grammar of Graphics),图例自动对齐,默认配色与学术排版水准极高;Python 制图虽自由,但精细微调需要书写大量底层坐标轴属性代码。 |
| 经典统计假设检验 | SciPy, Statsmodels | Base R, car, lme4 | 统计学界最新研发的假设检验、混合效应模型与贝叶斯推断方法,绝大多数优先以 CRAN 形式首发 R 包;Python 覆盖常用检验,但前沿小众细分领域常无现成库。 |
| 机器学习与深度学习 | Scikit-learn, PyTorch | tidymodels, torch (R接口) | Python 是当今人工智能、计算机视觉、大语言模型开发的绝对世界通用语;R 语言虽然具备完备的传统机器学习包,但前沿深度学习多为调用 Python 的接口包装。 |
| 网络爬虫与数据采集 | Requests, Scrapy, Selenium | rvest, httr2 | Python 拥有无可比拟的底层网络自动化抓取生态,应对反爬虫与复杂无头浏览器测试轻而易举;R 语言更适合抓取结构规范的静态网页。 |
| 自动化与工程系统集成 | FastAPI, Celery, Airflow | Plumber, Shiny | Python 可以轻松写进后端微服务、定时触发任务和数据管道;R 语言最亮眼的工程产物是 Shiny,允许数据分析师在纯 R 环境下几天内搭建出交互式可视化仪表盘。 |
四、初学者选型决策树:按步骤确认你的最优起点
为了帮助读者摆脱纠结,我们梳理了一套明确的四步选型决策路径。请结合你当前的专业背景、直接目标与团队协作环境进行匹配。
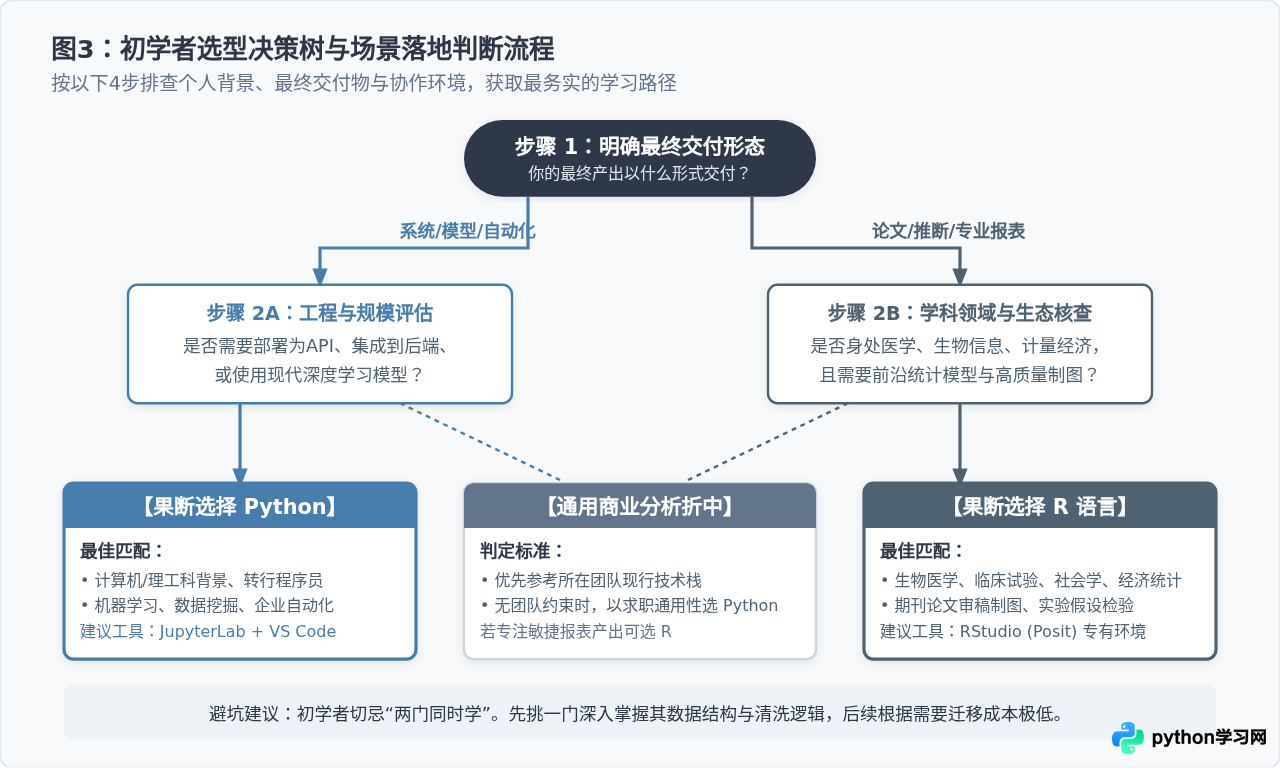
决策步骤拆解:
- 步骤 1:排查你的专业学科与直接任务
如果你身处生物医学、公共卫生、临床科研、农林生态、社会学统计或计量经济领域,且当务之急是处理问卷、做方差分析、绘制 SCI 期刊论文插图,毫不犹豫直接从 R 语言起步。在这个赛道上,R 语言能以最快速度帮你拿到发表级图表与规范的统计 p 值。
- 步骤 2:排查你的职业规划与岗位通用性
如果你期望未来从事商业数据分析师(Data Analyst)、数据挖掘工程师、算法工程师,或者希望未来保留向后端开发、测试开发或系统运维转型的自由度,请坚定选择 Python。在通用招聘市场上,企业对 Python 的招聘需求体量远大于 R 语言,其全技术栈的通用性无出其右。
- 步骤 3:核对团队已有的代码资产
如果你的实验室或导师全盘使用 R 语言脚本,不要特立独行选择 Python,否则你将失去前辈代码模板与求助支持;反之,若公司技术架构基于 Linux 服务器和微服务,团队已有现成的 Python ETL 脚本,那么顺应团队工具链是成本最低的选择。
- 误区一:“我必须两门语言同时学起”。初学者最忌讳多线并进,两门语言的赋值符、管道符与切片索引规则极易产生混淆。务必在一门语言中扎实掌握数据清洗的思维模型后,再横向学习另一门,届时仅需对照语法字典即可快速上手。
- 误区二:“R 语言已经过时了”。这是一种常见的认知偏见。R 语言在学术界、制药行业(如 FDA 新药审批)以及顶级专业咨询机构中占据极高且稳固的生态壁垒,它是一门高精尖的统计利器,而非被淘汰的旧语言。
- 误区三:“学了 Python 就等于掌握了数据分析”。工具不等于方法。无论是 Python 还是 R,语言本身只是语法表达式,数据分析的核心灵魂始终是统计学常识、指标拆解逻辑与对业务问题的深刻理解。
五、综合对比矩阵与行动建议总结
综合以上分析,我们将 Python 与 R 语言的关键能力维度进行量化总结,为初学者提供一个清晰的全景视角。
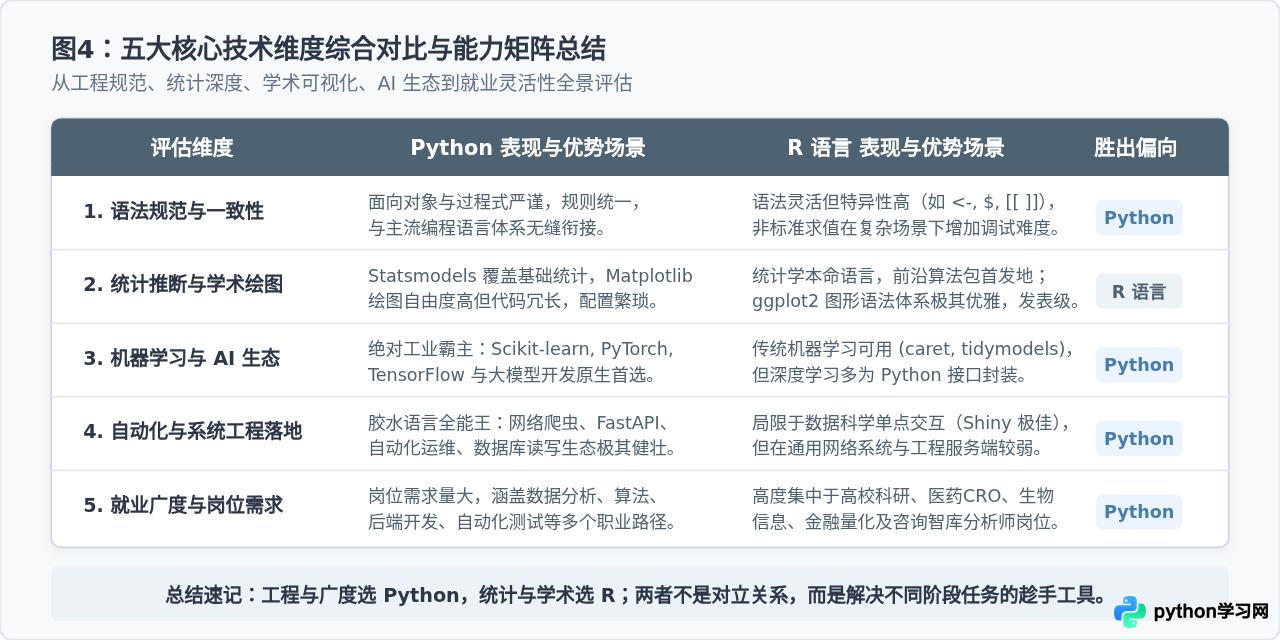
初学者的落地执行建议:
选择第一门编程语言,本质上是选择你的第一套“思维脚手架”:
如果你选择了 Python:推荐使用 Anaconda 或 Miniconda 作为环境管理器,开发界面首选 JupyterLab 辅助练习交互式代码片段,再逐步过渡到 VS Code 掌握规范的脚本与工程化管理。前期重点攻克基础数据结构(列表、字典)、推导式以及 Pandas 的 groupby 与聚合计算。
如果你选择了 R 语言:请直接从官网安装最新版 R 原生解释器,并搭配官方推荐的集成开发环境 RStudio (Posit)。学习路径切忌死记硬背 Base R 繁杂的历史函数,建议直接以现代 Tidyverse 生态为核心主线,顺次学习 readr(数据导入)、dplyr(数据变换)与 ggplot2(图层绘图)。
把精力聚焦在“解决手头一个具体的数据问题”上,完成属于你的第一个数据分析小项目,远比在选择哪门语言的争议中犹豫不决有价值得多。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









