

怎么制作AI数字人视频:从上传照片到生成口播视频的完整教程
本文以HeyGen网页端为例,详解从上传单人清晰照片创建Photo Avatar,到在Studio中配置台词、选择声音引擎,最终生成口播视频的完整流程。重点区分素材图片与可动角色的区别,强调先定声音节奏再调整画面的操作逻辑,帮助新手避开常见误区,高效产出可用的课程介绍或短视频内容。
想做一条课程开场视频,自己又不方便对着镜头录一遍,把照片上传后让人物开口,确实是一条可以考虑的路。不过,照片出现在画布上,并不等于已经创建了会对口型的数字人;能试听台词,也不等于人物动画已经生成。
第一次制作,最值得追求的是把短台词完整走通,而不是立刻加入复杂动作和很多场景。先确认照片能用、声音读对、嘴部动作与台词对应,再做字幕与背景,返工会少一些。
下面以HeyGen网页端的Photo Avatar和AI Studio为例,制作一条简短的课程介绍。它是浏览器工作流,不需要把其他桌面软件的菜单套进来。功能入口、可用引擎和额度可能随版本、地区与账号变化;以实际页面提示为准,本文不承诺免费次数或固定生成时间。
照片先变成角色,才有后面的口播
准备一张你自己或已获授权使用的人物照片。优先选择脸部清楚、光线均匀、没有遮挡的单人照片,让嘴部与脸部轮廓容易辨认。多人合照、脸太小或模糊的图片,会增加识别困难。
进入HeyGen的Avatars角色区域,按当前页面的New Avatar、Upload Photo路径上传,给角色命名并提交创建。若页面布局变化,寻找照片角色的创建入口,不要只把图片放入素材库后就开始排版。等待角色创建完成,再检查列表中的缩略图是否对应正确人物。
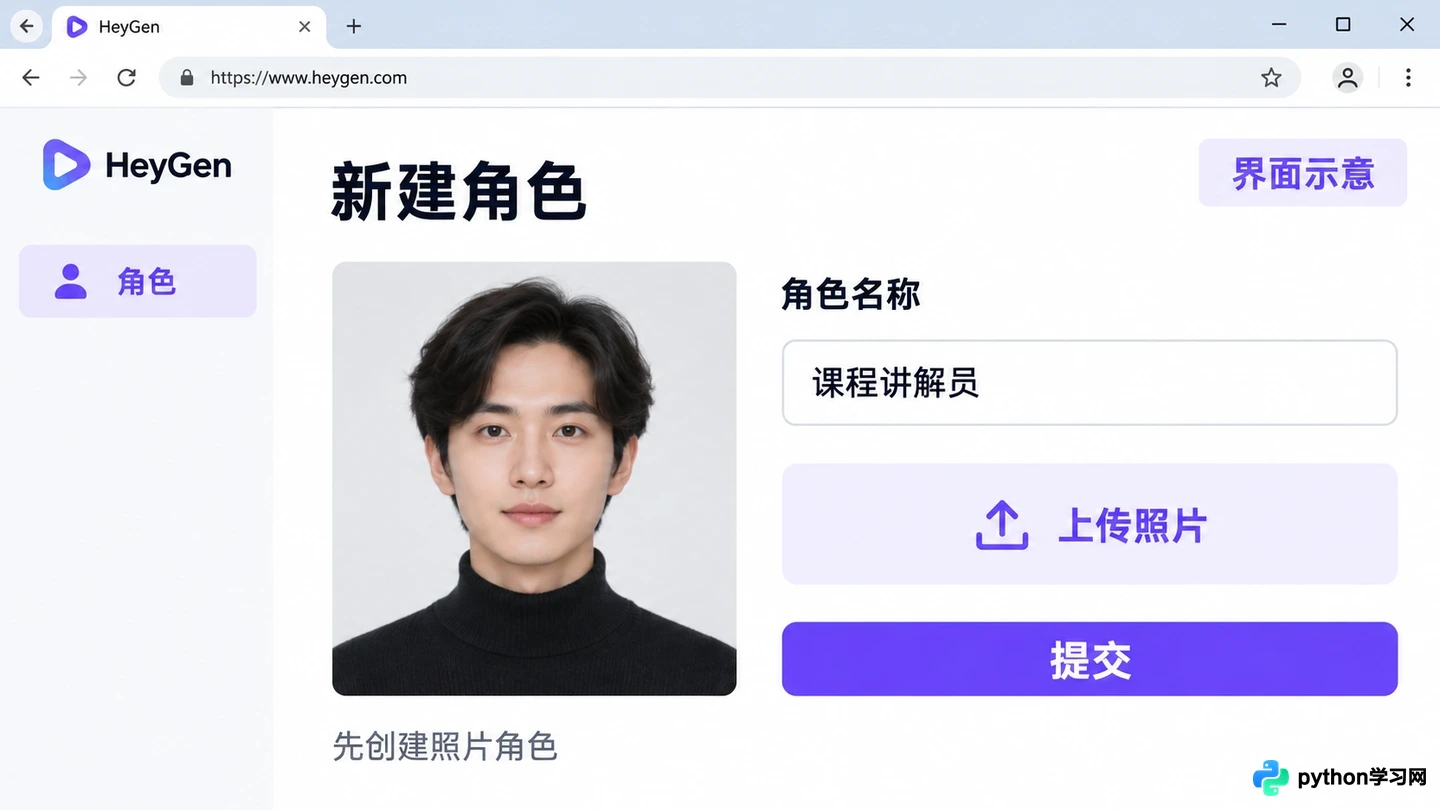
在Avatars区域上传清晰单人照并命名角色
这是整个流程最容易忽略的区别。HeyGen官方Studio说明特别提醒:把照片当作Assets素材加到画布上,并不会自动得到可对口型的角色。若成片只有一张不动的照片和旁白,先检查是否真正选择了Photo Avatar。
照片被拒绝时,根据原提示检查文件是否损坏、格式是否支持,以及脸部是否清楚。官方故障说明建议使用脸部可见的清晰JPG或PNG照片;这不是要求人为放大到某个统一尺寸。若触发身份或授权验证,按平台要求完成,不用替换身份或绕过验证来继续。
一段短台词,先把声音和节奏定下来
角色准备好后,可以从角色列表进入Studio,或在当前AI Studio的创建视频流程里选择对应照片角色。官方说明介绍了Create、Create a Video的入口,并可选择横版或竖版。课程讲解需要与课件并排时可考虑横版,手机信息流内容可考虑竖版;先确定交付用途,避免后面重新裁切人物。
把角色放进场景,确认选择的是刚创建的照片角色,而非一个同名素材。第一段只写课程开场,例如:“大家好,这节课介绍表格整理。我们先看数据,再处理格式。”这是一段演示用文本,不代表已经生成或测过效果。
需要平台合成声音时,选择当前账号有权限使用的声音,检查语言与台词是否匹配,再试听。名字、数字、英文缩写最容易出现读法偏差,可以先换成更明确的文字表达。句子太长,就按意思拆开,不靠堆标点追求夸张停顿。
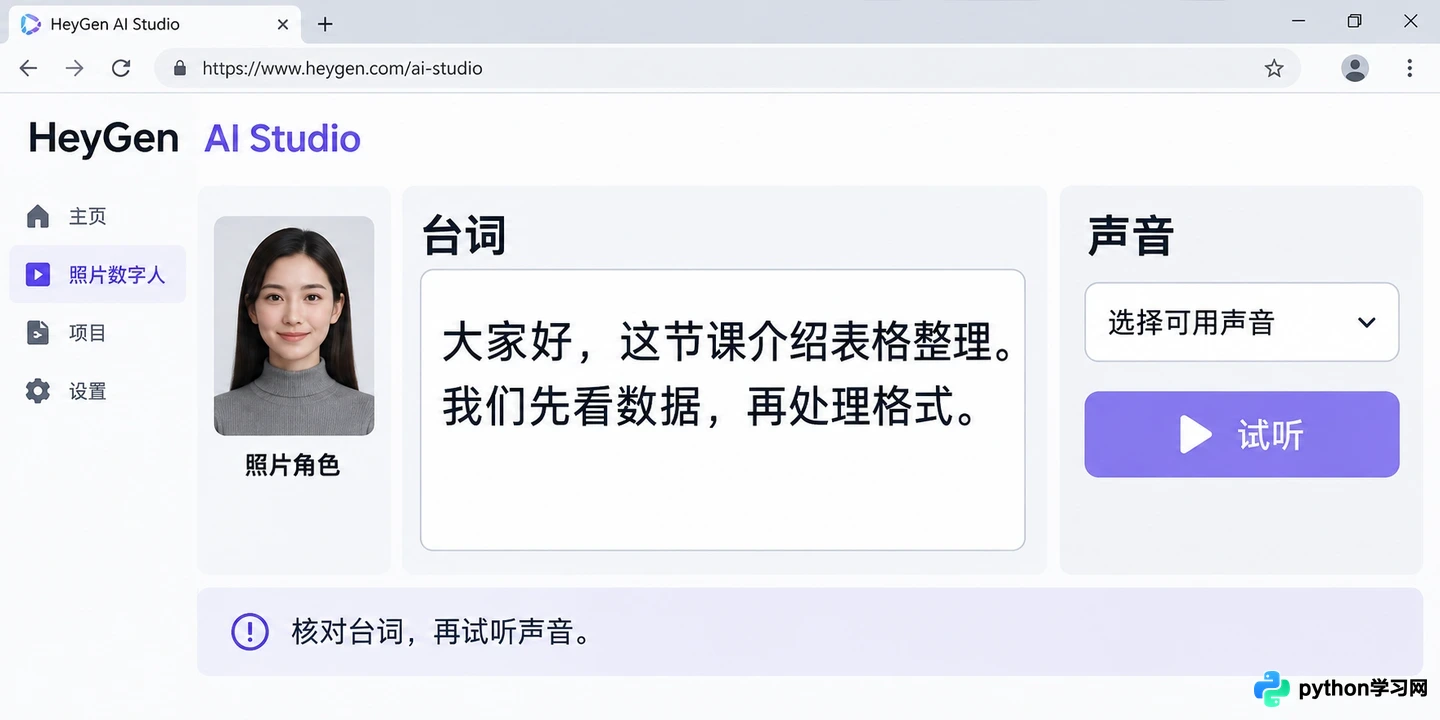
输入台词并试听AI合成声音
如果采用自己录制的音频,要走当前页面支持的上传音频路径,并先听清内容。文本台词与上传录音是不同的声音来源,不要在不确认规则的情况下重复叠加。音频里有背景人声或强回声时,先准备清楚的版本,比后面一边改口型一边猜原因更直接。
确认声音后再完善文案。字幕或屏幕上的文本改了,不一定意味着已经生成的旁白同步更新;每次换台词或声音,都要重新核对角色使用的实际音频版本。
先做稳定讲解,再添加动作与背景
一条课程开场不需要人物同时转身、走动和挥手。先让角色正对观众,以自然表情讲完短句,才容易判断脸部和嘴部表现是否适合这张照片。
照片角色可以在Studio中选择支持的运动引擎,但不同引擎的适用角色和消耗条件不同。不要因为列表里某个引擎更新,就默认它适用于当前照片。遇到升级提示或角色类型不兼容,先看说明,再选择账号中实际可用的组合。
HeyGen也提供Single Scene单场景入口。其官方说明区分偏讲解的Presenter模式和更重场景表演的Cinematic模式;如果只是让照片人物清楚介绍课程,通常先按讲解需求选择就够了。这里是一条替代路径,不要求同时建立Studio和Single Scene两个重复任务。
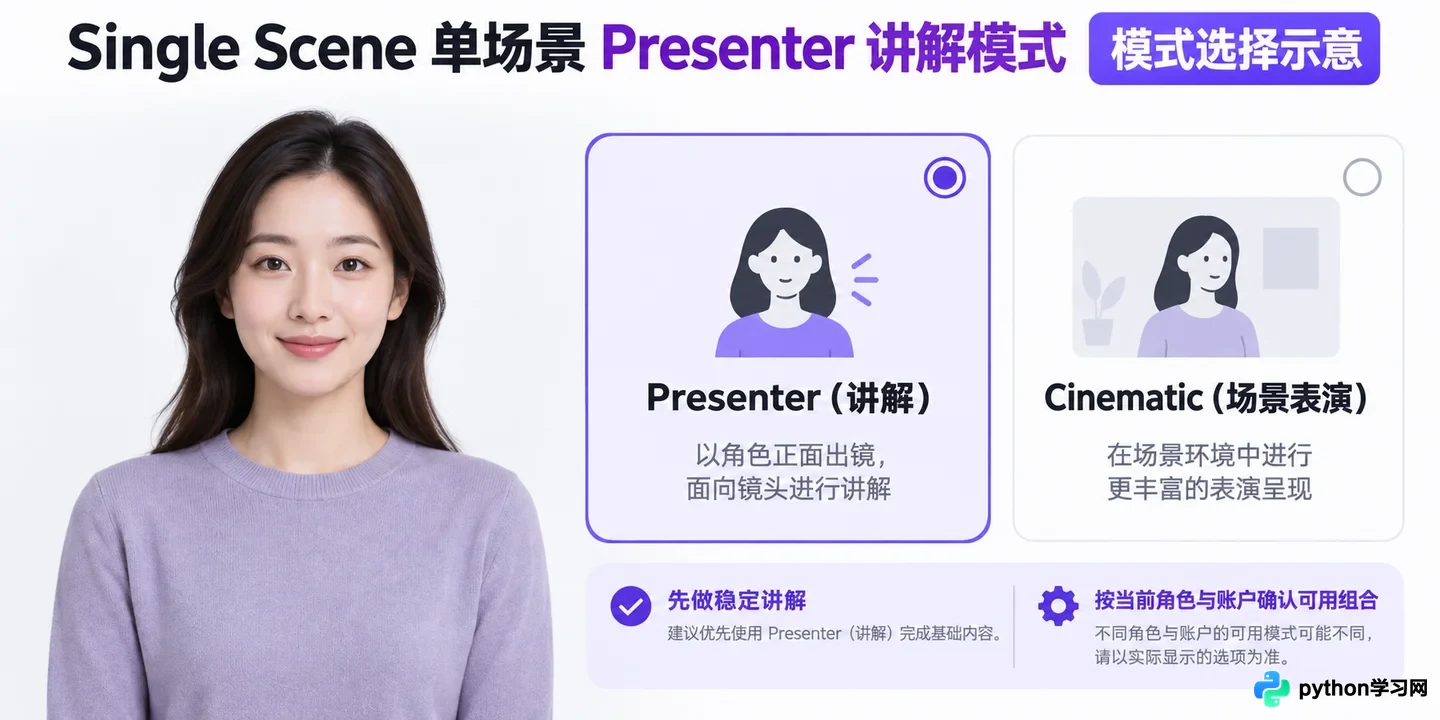
选择Presenter模式进行稳定讲解
人物位置确定后,再添加简洁背景与课程标题。给脸部留出空间,别让文字覆盖嘴部,画面边缘也不要把头顶和下巴切得太紧。背景和字幕能帮助观众理解内容,却不能补救一份读错的台词,所以应放在声音核对之后。
编辑阶段能试听声音,但不一定能直接预览完整人物动画。HeyGen官方说明指出,人物动画需要正式生成才能查看;因此,编辑预览里人物没有动,不能直接当成故障。先检查角色、台词、声音和画幅是否正确,再进入提交环节。
提交一次,拿到成片后再验收
生成前最后检查四件事:场景里是否有正确角色,台词是否为最终版本,声音是否可用,页面是否提示额度或其他待处理问题。看清本次生成的条件后再提交,保留任务记录,等待原任务返回。
页面卡住或浏览器暂时断开时,先回原项目查看状态。没有明确失败结果之前,不要连续重复提交同一段内容。生成时长取决于具体任务和平台状态,不能把超过某个经验等待时间直接判为失败。
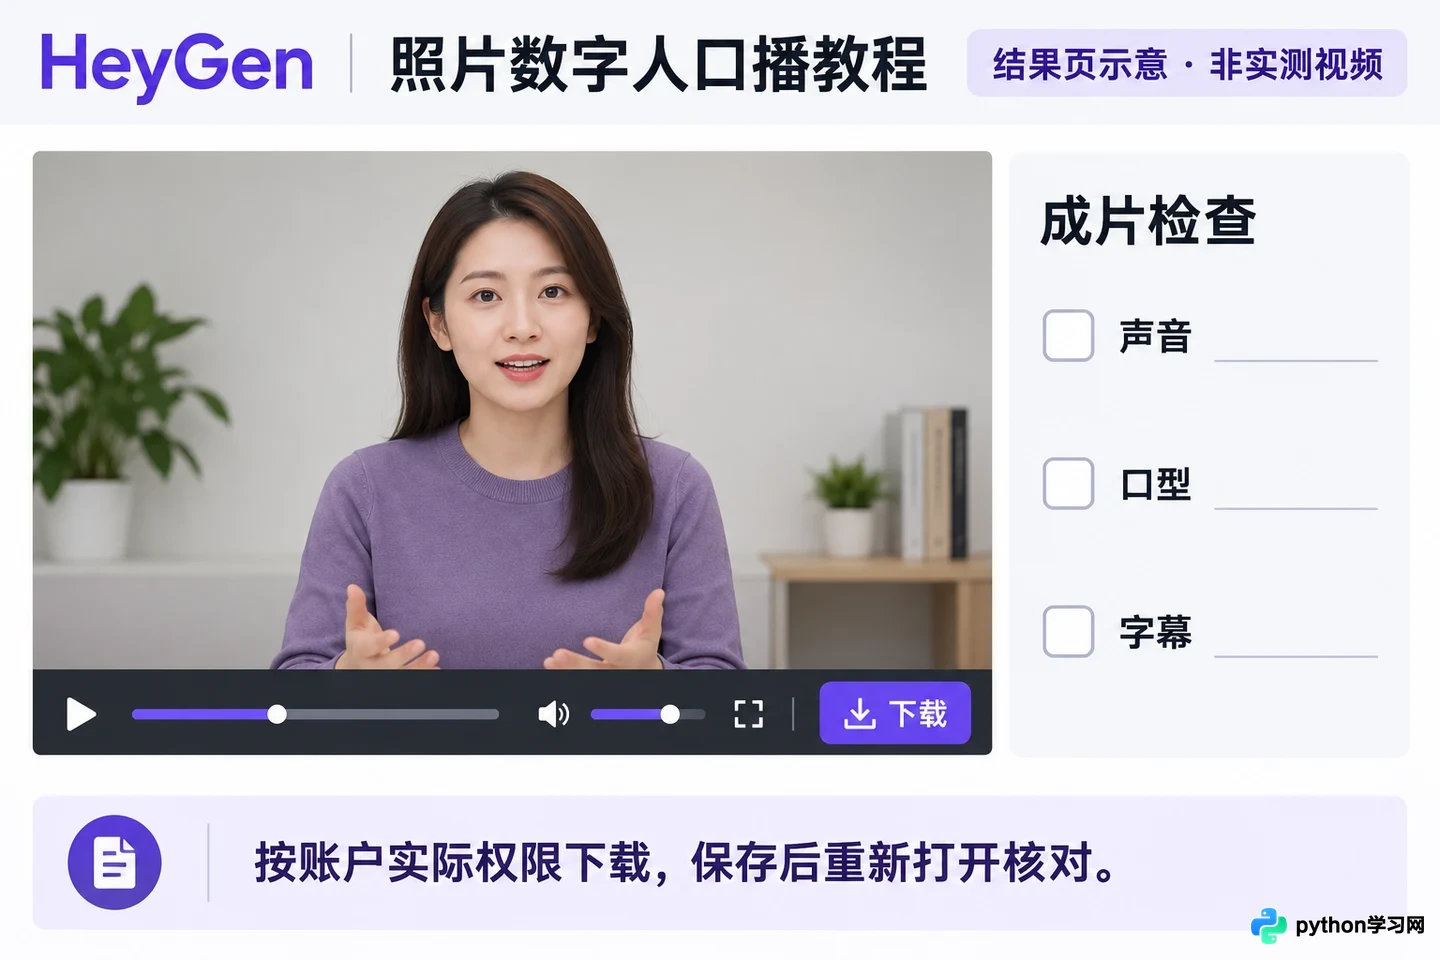
检查成片质量并导出本地文件
成片可播放后,从头听到尾,再分别检查开头、中间和结束位置。听声音有没有漏字,看嘴部动作与台词是否大致对应,留意脸部是否有明显异常,以及字幕有没有挡住重要内容。若只是个别词读错,先修文字或音频;若人物形象持续失真,再检查照片与引擎选择,别一次改动所有因素。
需要保存本地文件时,在完成结果页检查账号实际提供的下载或导出选项,按可用条件保存,并重新打开文件核对画面与声音。若该账号没有需要的输出权限,先解决交付条件,不把在线播放当成已经获得本地视频。本文没有实际生成视频,也不承诺特定账号的导出规格。
这条流程适合把一张合适照片做成简短讲解,不等于建立了能用于任何镜头的完整人物模型。先完成一段短口播,确认角色、声音与输出都符合用途,再扩展场景和时长,往往比第一轮就追求一支复杂宣传片更容易得到可用结果。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









