

为什么不能修改Python元组元素?TypeError错误解析
深入解析在Python中尝试修改元组元素时触发TypeError: 'tuple' object does not support item assignment的根本原因。结合内存模型、哈希安全机制、增量赋值陷阱及4种实用解决方案,帮助开发者全面掌握元组的不可变性原理与正确用法。
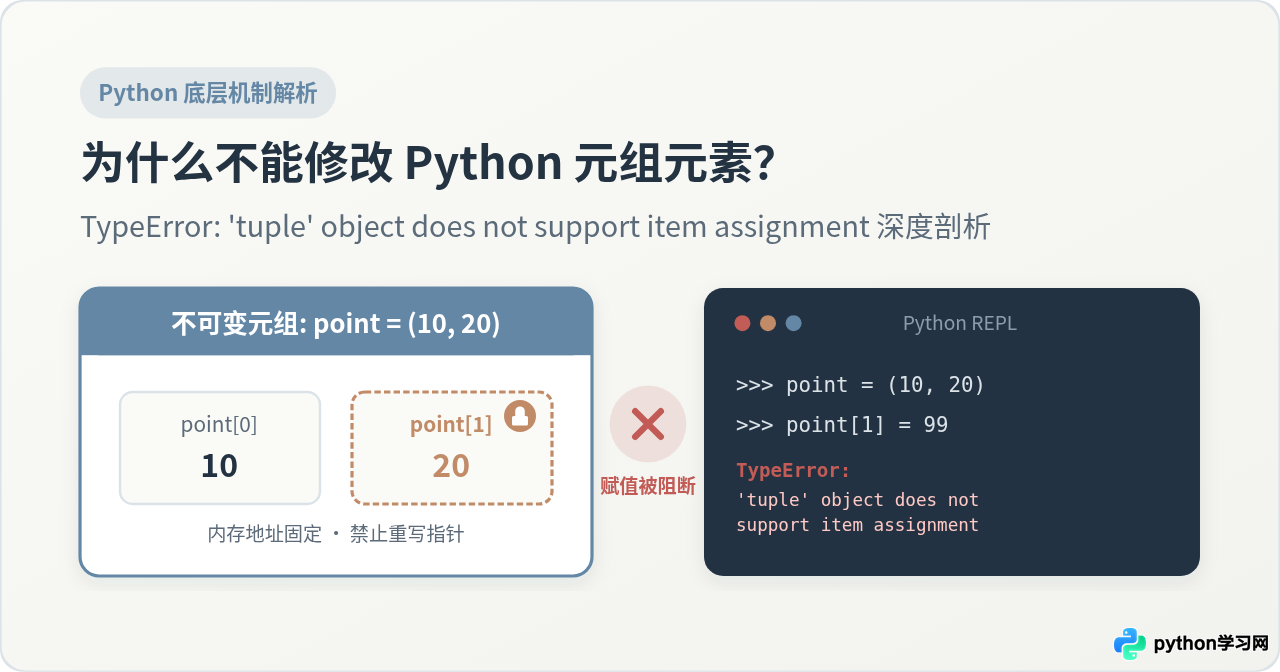
point[0] = 99)时,解释器会立即抛出 TypeError: 'tuple' object does not support item assignment。造成该错误的直接原因在于:元组在 Python 中被设计为严格的“不可变序列(Immutable Sequence)”。它的底层内存结构在创建后即刻固化,不提供也不允许任何原地修改操作。这一机制既不是语法限制,也不是代码缺陷,而是 Python 为了保障数据安全、维持哈希稳定性及优化执行效率而做出的底层架构决策。
一、错误现场还原:TypeError 是如何被触发的?
我们首先来看一个最典型也是最常导致该错误的交互示例。许多初学者在刚从列表(List)过渡到元组(Tuple)时,容易顺理成章地认为元组也可以通过索引进行就地更新:
# 定义一个表示二维坐标的元组
coords = (120.15, 30.28)

# 尝试将经度坐标修改为 120.16
coords[0] = 120.16
仔细观察报错信息中的核心短语:does not support item assignment(不支持项赋值)。
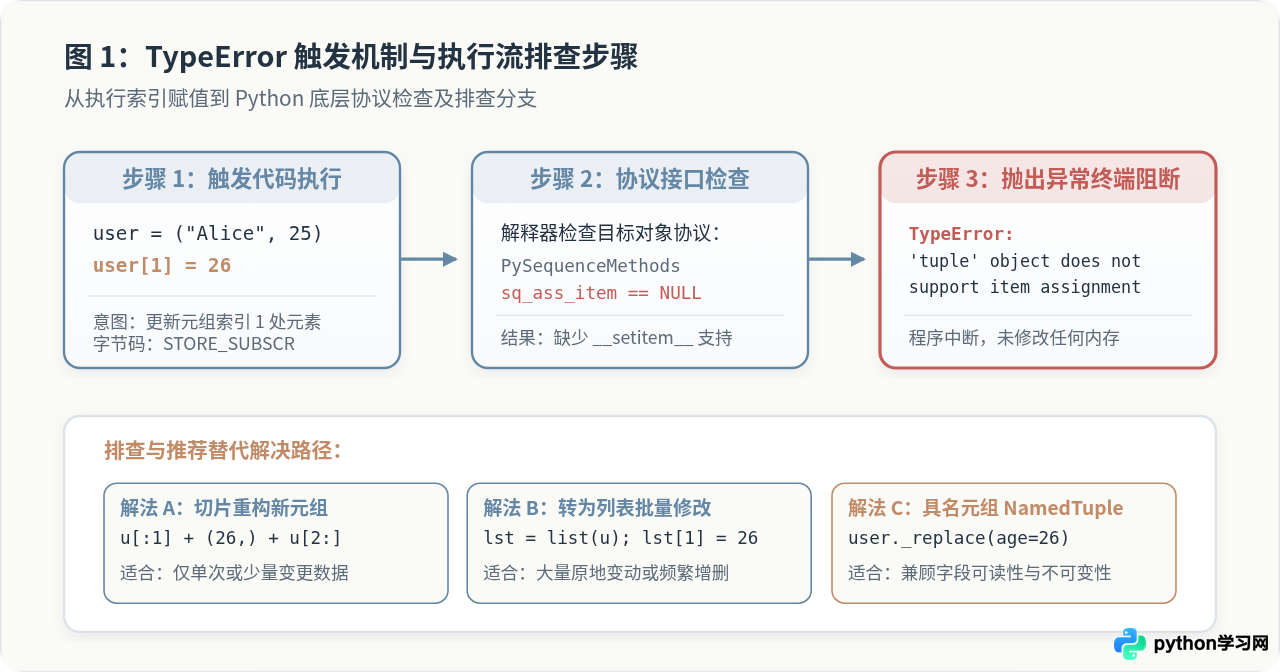
在 Python 底层,类似 obj[key] = value 的索引赋值语句,在编译成字节码后对应的是 STORE_SUBSCR 指令。当虚拟机执行该指令时,会检查目标对象所属类型是否实现了序列协议中的赋值方法(即 Python 层的 __setitem__,在 CPython C-API 中体现为 tp_as_sequence->sq_ass_item 或 tp_as_mapping->mp_ass_subscript 插槽)。
元组类型(tuple)在类型定义时,明确将这些赋值插槽指针置为 NULL。当解释器发现目标对象根本没有实现索引赋值接口时,便直接中止执行并抛出 TypeError。
二、核心原因一:定长内存结构与不可变性保证
为什么 Python 语言核心团队在设计元组时,坚决不开放 __setitem__ 接口?根本原因首先体现在底层的内存布局与运行性能上。
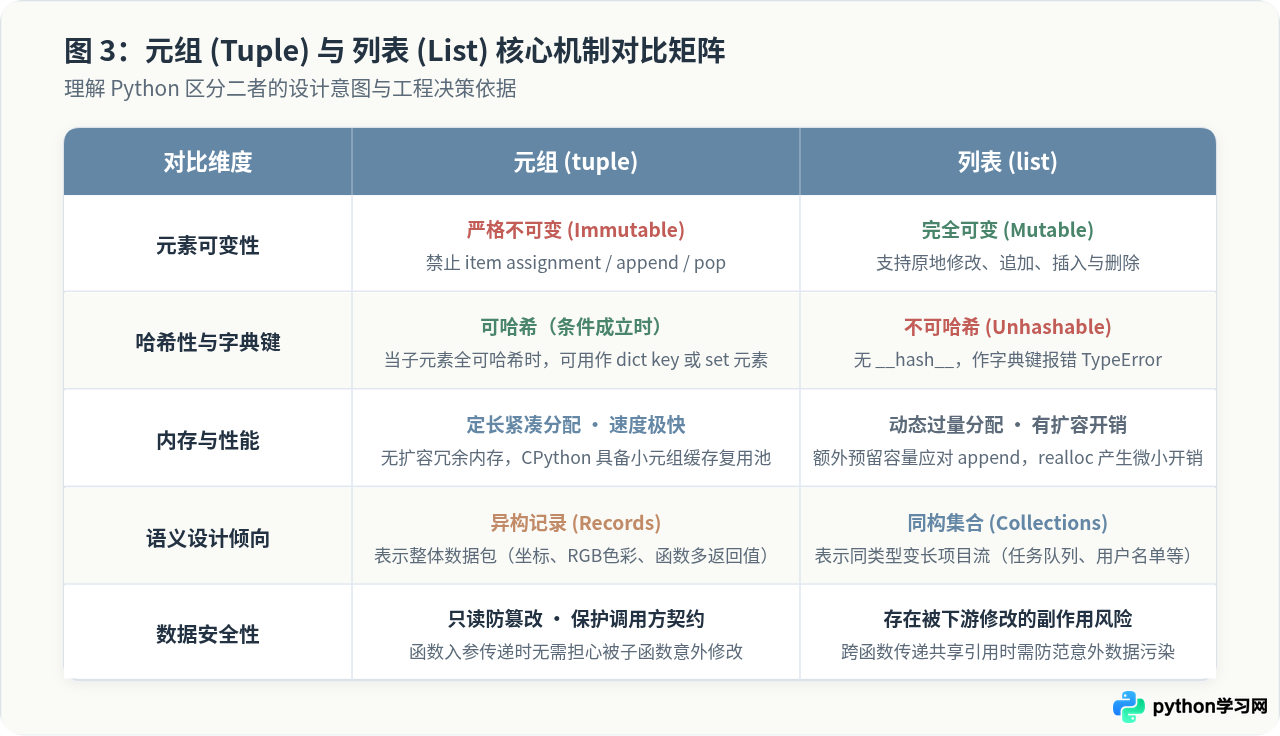
在 CPython 实现中,列表(list)与元组(tuple)在内存结构上有着本质差别:
-
列表是动态扩容数组(Dynamic Array):列表不仅要记录当前的元素个数(
ob_size),还要预留额外的分配空间(allocated字段)。当调用append或修改元素时,列表在预留空间内原地变动;空间不足时则触发整体内存重分配(realloc)。这使得列表需要维持额外的内存冗余和指针寻址负担。 -
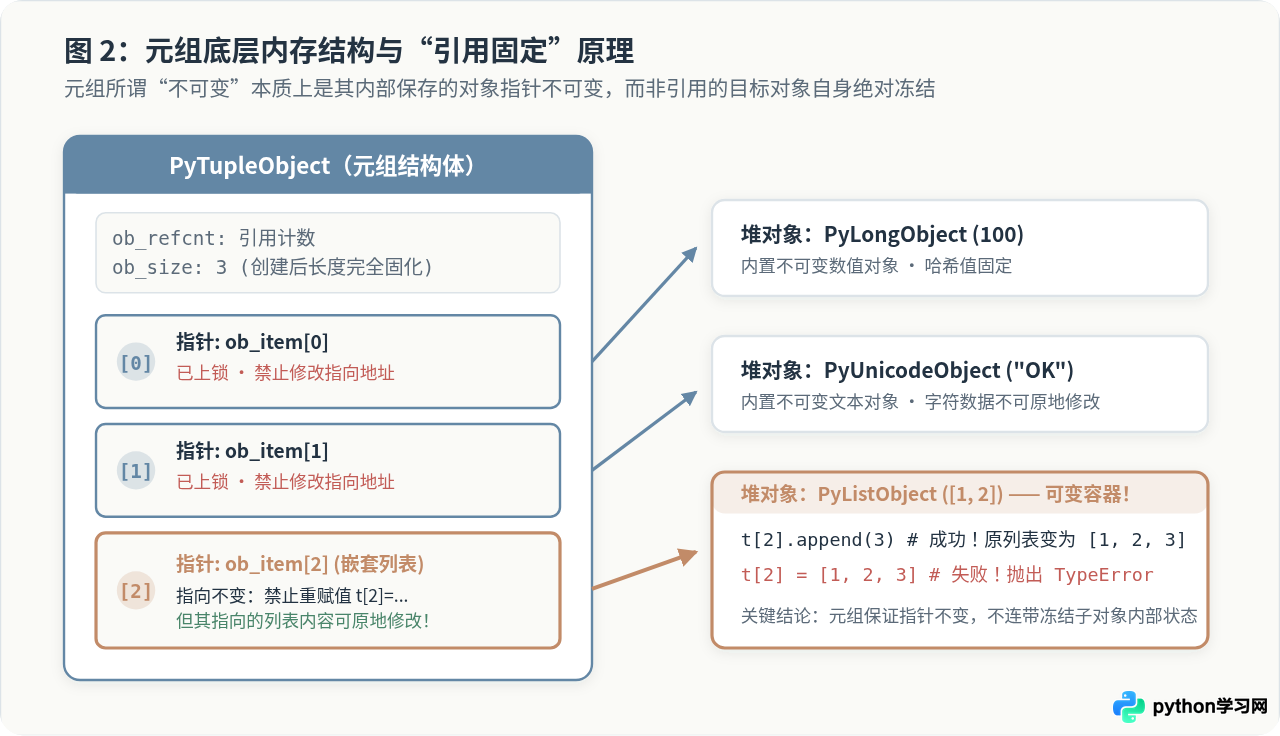
元组是定长紧凑数组(Fixed-Size Array):元组一旦实例化,其占用的内存块大小和内部指针数组长度就永久固定(结构体为
PyTupleObject,其包含一个固定大小的PyObject* ob_item[]指针数组)。因为元素不可增删或修改,元组不需要预分配多余空间,内存布局极其紧凑。
这种定长设计为 Python 带来了一系列立竿见影的性能优势:
- 更轻量的内存占用:存储相同数量的元素,元组占用的字节数显著低于列表。
- 极速的对象创建与缓存池优化:CPython 对元组实现了全局空闲缓存列表(Free List)。对于长度小于等于 20 的小元组,当它们被垃圾回收时,其分配的底层内存块不会直接归还给操作系统,而是留在缓存池中等待下一次复用。这使得在 Python 中创建和销毁小元组的速度极快。
三、核心原因二:哈希安全性与字典键(Dict Key)支持
除了内存性能,元组不可变性另一个至关重要的工程原因,在于维护 哈希表(Hash Table)的数据完整性。
Python 中的核心数据结构——字典(dict)和集合(set),均基于哈希表实现,具备极高的 $O(1)$ 查找和写入性能。能够作为字典键或集合元素的对象,必须满足一个基本前提:它是可哈希的(Hashable)。
可哈希的充要条件要求:对象的哈希值在其整个生命周期中必须保持绝对恒定,且能够与其他对象进行相等性比较。
假设元组允许就地修改元素,试想会发生什么灾难性的后果:
# 假想场景:如果元组允许修改元素
t = (1, 2)
d = {t: "位置数据"}    # 哈希表根据 (1, 2) 的哈希值将其存放在某个 Hash Bucket 中

t[0] = 999             # 若此行成立,元组内容改变,对应的哈希值也随之改变!
# 结果:d[t] 将无法通过新哈希值寻址到原 Bucket,导致数据“在字典中凭空失联”,哈希表结构彻底损坏
因此,Python 严谨地禁止了列表作为字典键(直接抛出 TypeError: unhashable type: 'list'),同时规定:当且仅当元组包含的所有子元素均为可哈希对象时,该元组才具备哈希性,可以安全地作为字典键和集合元素使用。元组不可变,正是维系整个哈希体系安全稳定的基石。
四、容易混淆的陷阱:“不可变”究竟锁住了什么?
在深入理解了不可变性后,许多开发者常会遇到一个极具迷惑性的现象:元组中的元素明明不能修改,为什么有时元组里的数据好像又“变了”?
必须明确区分一个核心概念:元组的不可变性指的是“引用的不可变(Immutable References)”,而非“引用对象内部状态的不可变(Deep Immutability)”。
元组内部存储的是指向各个堆对象的内存地址指针(PyObject*)。元组保证的是这些指针永远不会被替换指向新的内存地址,但如果某个指针指向的是一个可变对象(如列表),那么通过该对象自身的方法修改其内部数据是完全合法的。
# 元组包含一个整数和一个可变列表
record = ("服务配置", [8080, 8443])

# 尝试直接给索引 1 赋新列表 —— 试图改写指针,必然报错!
try:
    record[1] = [9000]
except TypeError as e:
    print("直接修改指针失败:", e)

# 通过列表的原生方法就地追加数据 —— 指针本身未改变,操作成功!
record[1].append(9090)
print("修改后的元组内容:", record)考虑以下代码:t = (1, [2, 3]); t[1] += [4]。执行后会发生什么?
答案是:它既抛出了 TypeError,又成功将 4 追加进了列表!
这是因为 += 操作对于列表会先调用 __iadd__(列表原地追加成功),随后 Python 解释器尝试执行赋值回写(等价于 t[1] = ...),在回写步骤触发了元组的 TypeError。这一经典案例再次印证了:元组只在赋值回写(改变指针)那一刻坚决拦截。
五、实用应对指南:需要“修改”元组时的四种正确解法
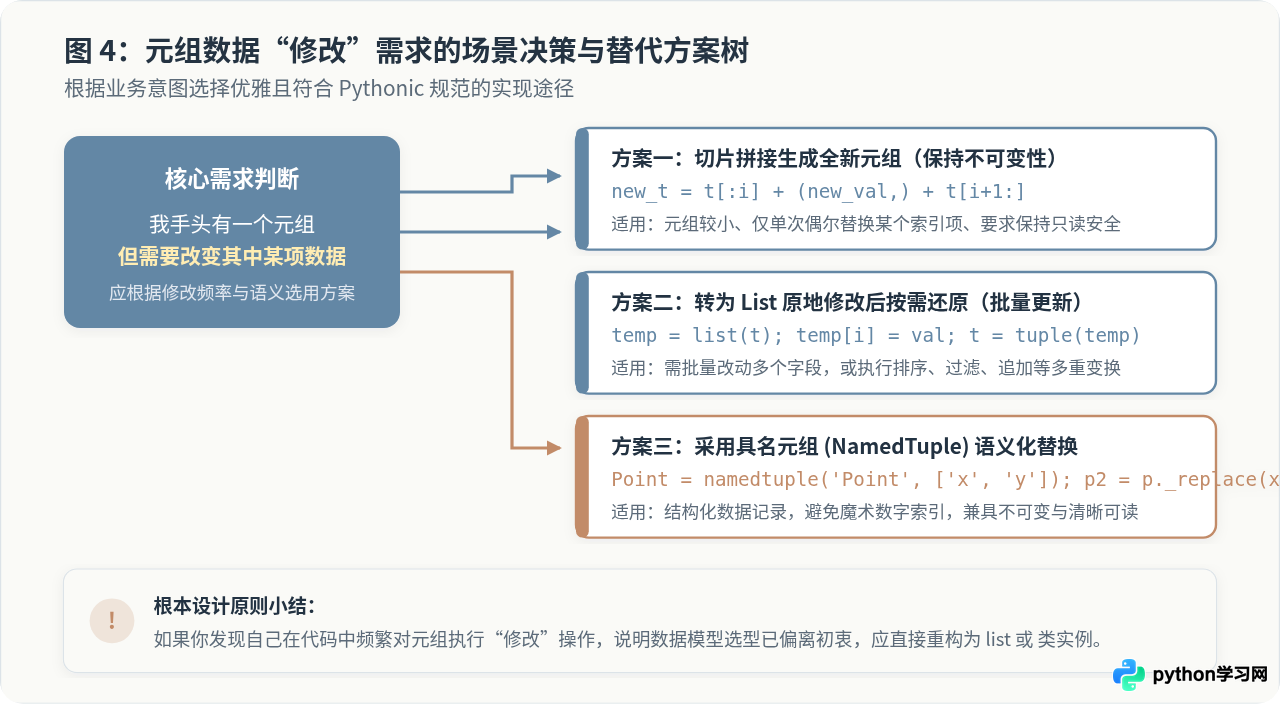
在实际工程开发中,如果你遇到了需要更新元组数据的场景,千万不要试图去绕过 Python 的类型限制。根据业务需求和数据规模,有以下四种标准且规范的解决方案:
解法 1:切片重构生成新元组(保留只读契约)
若元组规模较小,且你仅需要偶尔替换某个固定位置的元素,最自然的方式是利用切片拆分后拼接,生成一个全新的元组对象:
point = (10, 20, 30)

# 需要将索引 1 的值由 20 替换为 99
# 注意:单个元素的元组必须带尾随逗号 (99,)
new_point = point[:1] + (99,) + point[2:]

print("原元组:", point)
print("新元组:", new_point)解法 2:转换为列表批量修改后按需转回
如果需要进行复杂、频繁的修改(如同时修改多个元素、插入、删除、排序等),应先通过内置函数 list() 将其转为可变列表,操作完成后若仍需只读保护,再通过 tuple() 冻结:
config = ("127.0.0.1", 8000, "DEBUG")

# 1. 转换为列表
temp_list = list(config)

# 2. 进行任意原地修改
temp_list[1] = 8080
temp_list[2] = "RELEASE"

# 3. 重新封包为元组
updated_config = tuple(temp_list)
print("批量更新结果:", updated_config)解法 3:使用具名元组(NamedTuple)的 _replace() 方法
对于包含特定业务字段的数据记录,强行使用数字下标不仅容易出错,而且可读性差。推荐使用标准库 collections.namedtuple,它提供了专用的 _replace() 方法,既保留了元组的轻量和不可变安全,又能优雅地创建指定字段更新后的新实例:
from collections import namedtuple

# 定义具有语义的具名元组类型
User = namedtuple('User', ['name', 'age', 'role'])
alice = User(name="Alice", age=25, role="Engineer")

# 使用 _replace 方法进行语义化替换,返回全新实例
promoted_alice = alice._replace(role="Tech Lead", age=26)

print("原始用户记录:", alice)
print("更新后的记录:", promoted_alice)解法 4:重构数据模型,直接选用合适的可变类型
当你的数据集合本质上就需要随业务流程频繁增删改查时,强行使用元组本身就是一种数据建模失误。此时应直接将数据定义为列表(list)、字典(dict)或未冻结的数据类(@dataclass)。
六、常见问题与注意事项解答
del t[0] 删除元组中的某个元素?del t[0] 同样会触发 TypeError: 'tuple' object doesn't support item deletion。在 Python 协议中,元素删除由 __delitem__ 控制,元组同样没有实现该方法,因此既不能改,也不能删。
(item,) 带有尾随逗号?() 同时承担数学运算优先级分组和元组定义两重职责。单纯写 (42) 会被解释器视为普通的整数表达式;只有添加逗号写成 (42,),解释器才能明确识别其为单元素元组。这在构建切片替换逻辑时格外重要。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









