

Python集合、列表和元组有什么区别?
深入对比Python中的列表(list)、元组(tuple)与集合(set)。从有序性、可变性、唯一去重、底层内存模型、时间复杂度到实战选型场景与常见开发陷阱,全面解答三者的核心区别与最佳实践。
假设你正在编写一个电商数据处理脚本:从接口拿到的订单商品序列需要按添加先后顺序展示,服务器连接地址与端口号配置在启动后绝不允许被代码误篡改,而用户的数十万个历史搜索标签则需要快速去重并极速判断是否命中了敏感词黑名单。面对这三组截然不同的需求,如果选错底层数据结构,轻则引发数据被意外修改的隐蔽 Bug,重则导致程序查询性能从毫秒级暴跌至数十秒卡顿。在 Python 中,这三个需求分别对应的最优解正是列表(List)、元组(Tuple)与集合(Set)。
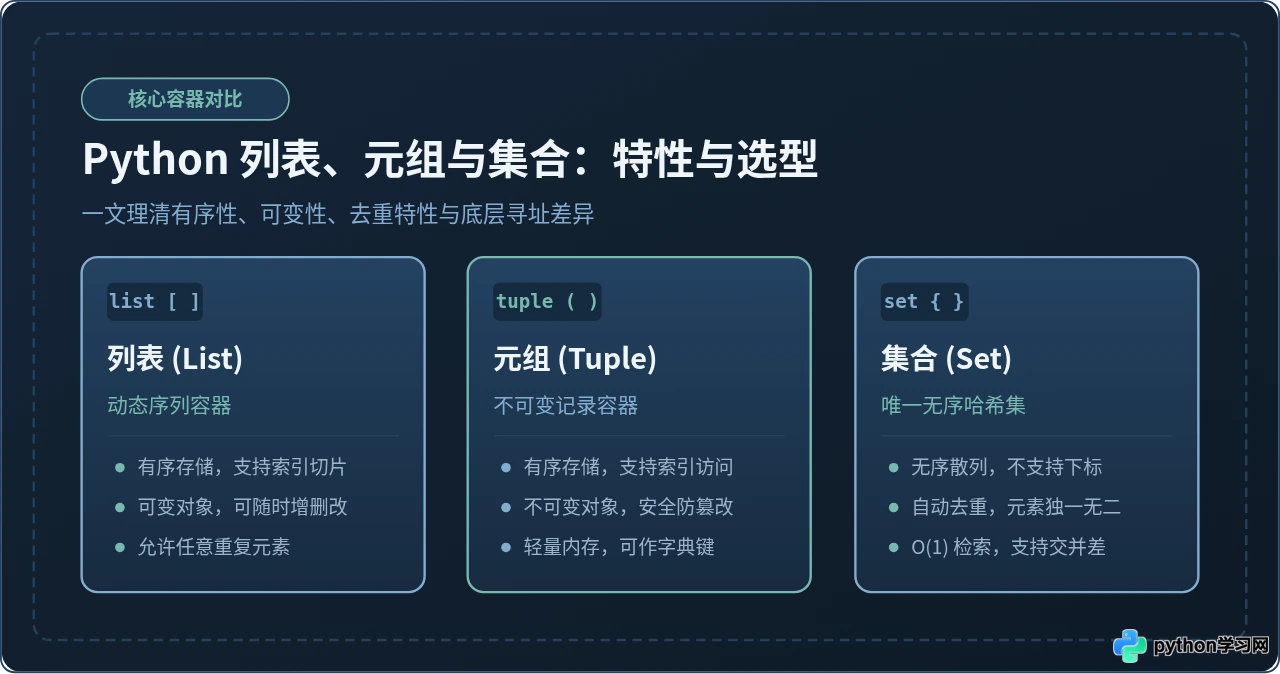
核心结论速览:
• 列表 (List, [ ]):有序、可变、允许元素重复。像一个可随时增删换项的储物格,用于处理需要频繁更新的动态序列。
• 元组 (Tuple, ( )):有序、不可变、允许元素重复。像一份打印出来盖章的文件,一旦生成便无法更改,占用内存小且安全,可作为字典键。
• 集合 (Set, { }):无序、可变(元素必须不可变)、唯一不可重复。基于底层哈希表实现,专为极速成员查找与数学集合运算设计。
一、核心特征横向对比:有序性、可变性与重复性
初学者容易被三者的括号语法所混淆,但它们在 Python 运行时的底层约定有根本性差异。理解这三者的区别,首先要从有序性、可变性与元素唯一性三个核心维度切入。
1.1 顺序性与索引切片
列表与元组是有序序列(Sequence)。这意味着元素存入时的顺序会被永久保留,每个元素都拥有明确的整数索引(下标从 0 开始),支持通过下标直接取值、负数逆序索引以及切片(Slice)操作。
集合是无序容器。集合内部并不维护插入次序,而是根据元素的哈希值分散在哈希桶中。因此,集合完全不支持索引访问与切片,如果尝试对集合执行 my_set[0],Python 会直接抛出 TypeError: 'set' object is not subscriptable 异常。
# 示例代码:有序与无序访问对比(环境:Python 3.8+)
items_list = ["apple", "banana", "orange"]
items_tuple = ("apple", "banana", "orange")
items_set = {"apple", "banana", "orange"}

# 列表与元组支持通过下标和切片定位元素
print(items_list[0])    # 示例输出: 'apple'
print(items_tuple[1:])  # 示例输出: ('banana', 'orange')

# 集合不支持下标索引(尝试调用将报错)
# print(items_set[0])   # 抛出异常: TypeError
1.2 可变性与数据安全性
可变性(Mutability)决定了容器在创建后,其内部包含的引用能否被就地新增、删除或重分配:
- 列表是可变对象(Mutable):可以随时使用
append()、pop()、extend()或下标赋值items_list[0] = "pear"就地修改内容,对象的内存地址保持不变。 - 元组是不可变对象(Immutable):一旦创建,其元组长度及每个索引位所指向的对象引用均不可更改。任何试图执行
items_tuple[0] = "pear"的操作都会触发TypeError: 'tuple' object does not support item assignment。 - 集合本身是可变容器:可以通过
add()、remove()、discard()增删元素,但集合内的元素本身必须是不可变(精确地说是可哈希 Hashable)的对象。例如,不能将列表作为集合的元素,否则会触发TypeError: unhashable type: 'list'。
二、底层实现与检索性能:为什么查找速度天差地别?
除了语法和特征的区别,很多开发者在面对海量数据时,最常遇到的瓶颈是成员检查(x in container)的执行效率。为什么检查一个值是否存在于拥有 100 万个元素的列表中需要数毫秒,而在集合中几乎瞬间完成?答案在于它们底层完全不同的内存模型。
2.1 连续指针数组 vs 哈希散列表
在 CPython 源码底层:
- 列表(PyListObject)与元组(PyTupleObject)都是连续的指针数组,里面存储的是指向各个 Python 对象的引用地址。当使用
item in my_list时,解释器只能从头到尾进行线性扫描(Linear Scan),逐个对比对象的值是否相等,平均时间复杂度为 O(n)。 - 集合(PySetObject)则是基于哈希表(Hash Table)实现的。当执行
item in my_set时,Python 首先调用hash(item)计算哈希值,并通过位运算直接映射到对应的哈希槽(Bucket)。绝大多数情况下,只需一次散列定位即可确定元素是否存在,平均时间复杂度为 O(1)。
# 示例代码:海量数据下的成员检索性能对比逻辑
import time

data_count = 1_000_000
raw_list = list(range(data_count))
raw_set = set(raw_list)

target = -1  # 查找不存在的元素,触发最坏情况遍历

# 列表检索:需遍历全部 1,000,000 个元素
start = time.perf_counter()
_ = target in raw_list
list_duration = time.perf_counter() - start

# 集合检索:直接计算 hash(-1) 并定位槽位
start = time.perf_counter()
_ = target in raw_set
set_duration = time.perf_counter() - start

# 示例输出参考(具体耗时依机器硬件而定):
# List 耗时约为 ~0.015 秒,而 Set 耗时约为 ~0.0000005 秒(相差数万倍)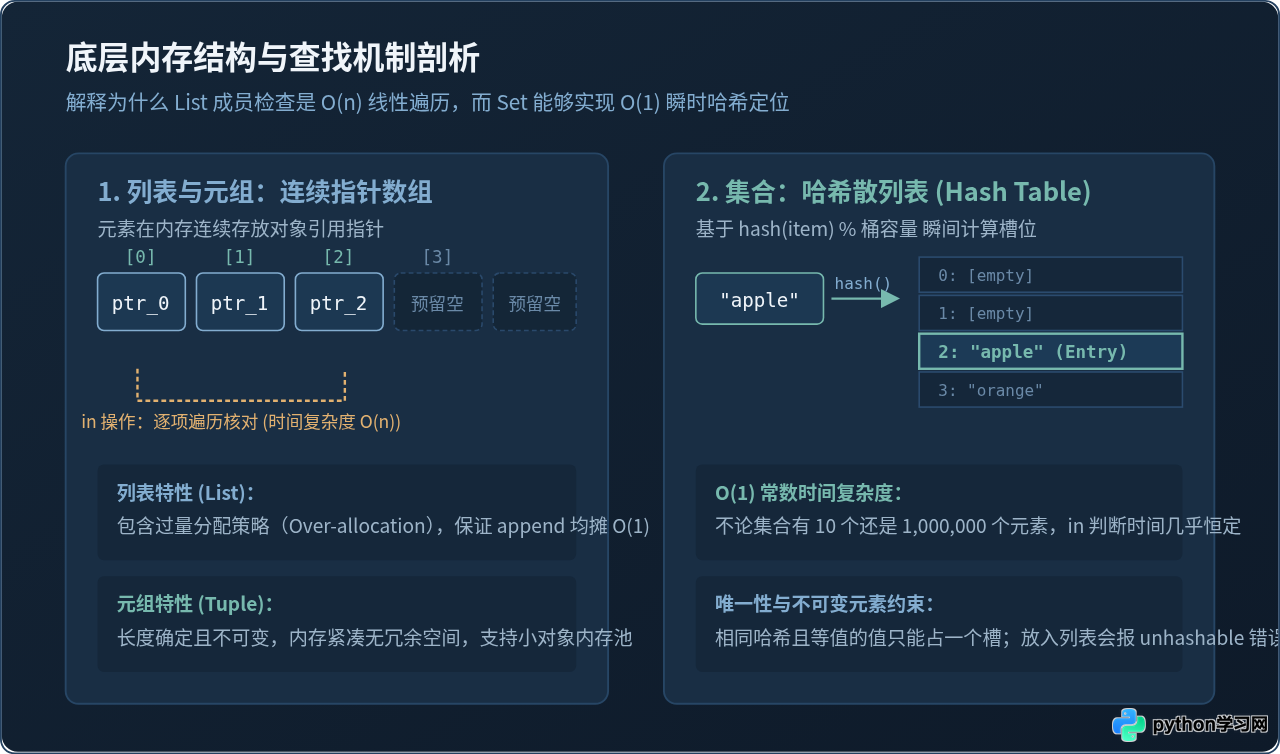
2.2 内存开销与小对象优化
内存利用率方面,元组具有天然优势:
- 元组最为紧凑:因为长度固定不可变,CPython 可以在分配时精确申请所需内存,没有任何冗余槽位,且 Python 对小元组(长度小于 20)内置了空闲对象缓存池,频繁创建和销毁元组开销极小。
- 列表带有过量分配(Over-allocation):为了避免每次
append()都触发昂贵的内存重分配(realloc),列表会预留一定的空闲容量槽,因此内存开销略大于元组。 - 集合内存开销最大:为了维持哈希表的低装载因子(Load Factor,避免过多哈希冲突),集合通常会预留至少 1/3 以上的空闲哈希槽,同等元素数量下占用的内存通常是元组或列表的数倍。
三、实战选型指南:我应该选用哪一种?
在实际工程开发中,选择列表、元组还是集合,应该遵循清晰的业务逻辑决策流,而不是凭个人感觉随意编写。
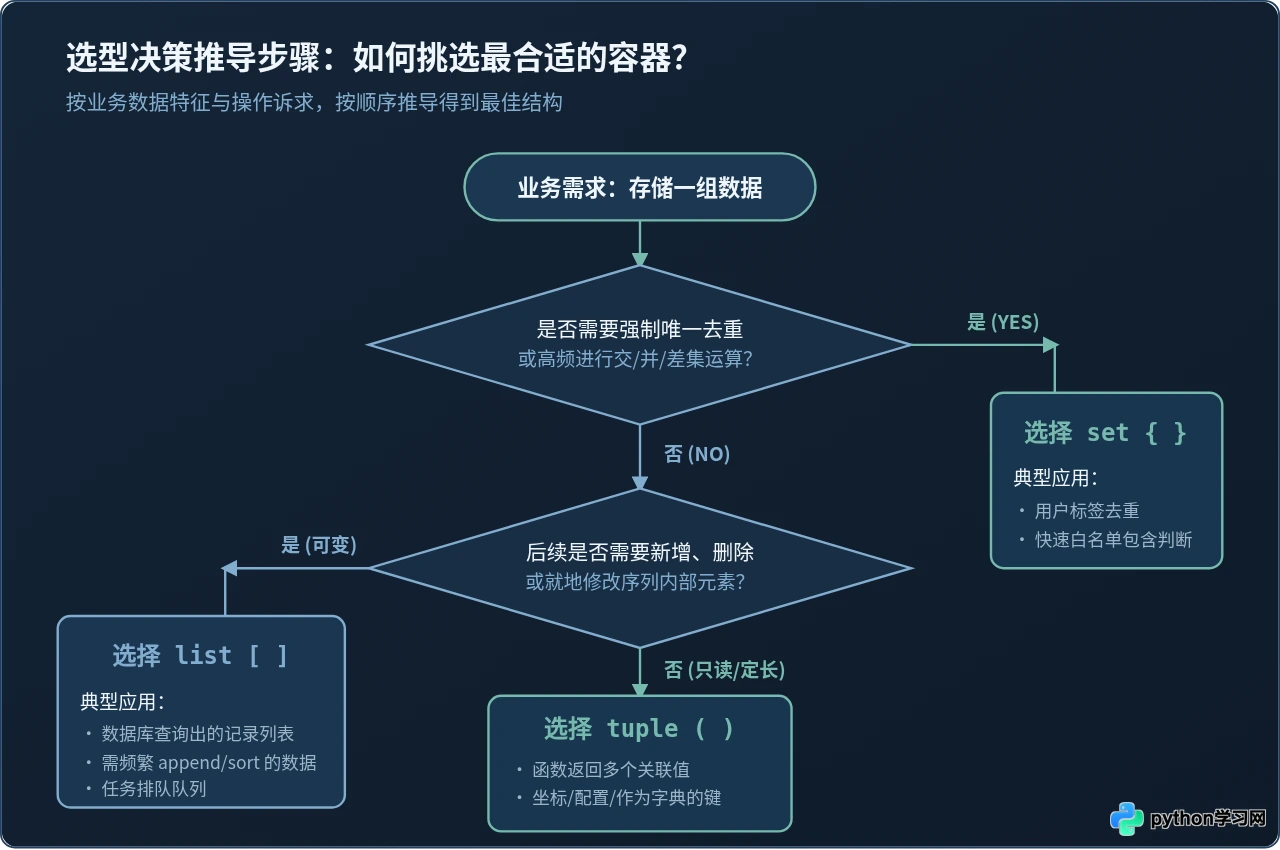
3.1 选择列表(List)的典型场景
- 业务数据具有前后序列关联:例如时间序列监控点、订单按加入时间排序的明细列表、消息队列等。
- 集合内容需要动态扩充与变更:需要频繁调用
append()追加数据、使用pop()弹出任务,或对数据进行原地排序(list.sort())。 - 允许存在相同内容的重复项:例如日志记录行、学生成绩单(允许有多人考出相同的 95 分)。
3.2 选择元组(Tuple)的典型场景
- 函数需要同时返回多个关联结果:例如
return status_code, response_data, error_msg,解包赋值简洁优雅。 - 系统常量、配置与数据记录(Record):例如网络监听地址
HOST_CONFIG = ("127.0.0.1", 8080),不可变特性能够从语法层面杜绝协同开发时的意外覆写。 - 作为字典的键(Dictionary Key):由于元组是可哈希的(前提是其包含的元素都可哈希),可以作为复合主键,如
user_matrix[(user_id, group_id)] = True,而列表绝对不行。
3.3 选择集合(Set)的典型场景
- 海量数据去重:例如将包含数万条带有重复项的列表直接清洗为唯一值:
unique_ids = list(set(raw_ids))。 - 高频成员包含检查(Membership Testing):权限拦截系统、敏感词屏蔽过滤、黑白名单过滤等场景。
- 数学集合关系运算:求两批用户的交集(共同好友
friends_A & friends_B)、并集(全部有效标签tags_A | tags_B)或差集(流失客户old_users - active_users)。
四、避坑指南:日常开发最容易踩的四个陷阱
陷阱 1:单元素元组的逗号遗漏
在 Python 中,决定元组语法的核心符号其实是逗号(,)而不是圆括号。如果只写 t = ("apple"),Python 会将其识别为普通字符串加了运算优先级括号,类型为 str。声明单元素元组必须包含末尾逗号:t = ("apple",)。
陷阱 2:创建空集合使用了花括号 {}
在 Python 中,花括号 {} 优先分配给了字典。直接写 s = {} 得到的是一个空字典(dict),而非空集合。创建空集合必须显式调用构造函数:s = set()。
陷阱 3:以为“元组不可变”就绝对不可变
不可变性指的是元组内部引用指针不可变,但如果元组内嵌套了可变对象(例如列表),该列表内部的内容依然可以被修改:
nested_tup = (1, 2, ["a", "b"])
# nested_tup[2] = [1, 2]  # 会抛出 TypeError
nested_tup[2].append("c") # 完全合法!列表内容变成了 ['a', 'b', 'c']此外,包含可变列表的元组是不可哈希的,无法作为集合元素或字典键。
陷阱 4:慎用可变对象作为函数默认参数
函数的默认参数在模块加载时只求值一次。如果写 def add_item(val, container=[]):,多次调用该函数且不传参时,所有调用将共享同一个列表实例。正确的做法是使用 None 作为占位符,或在只读场景下使用不可变元组作为默认值。
五、全景特性与高频方法速查总结
为了便于在编码中随时参考,以下将列表、元组和集合最核心的方法、时间复杂度与关键区别归纳在一览表中:
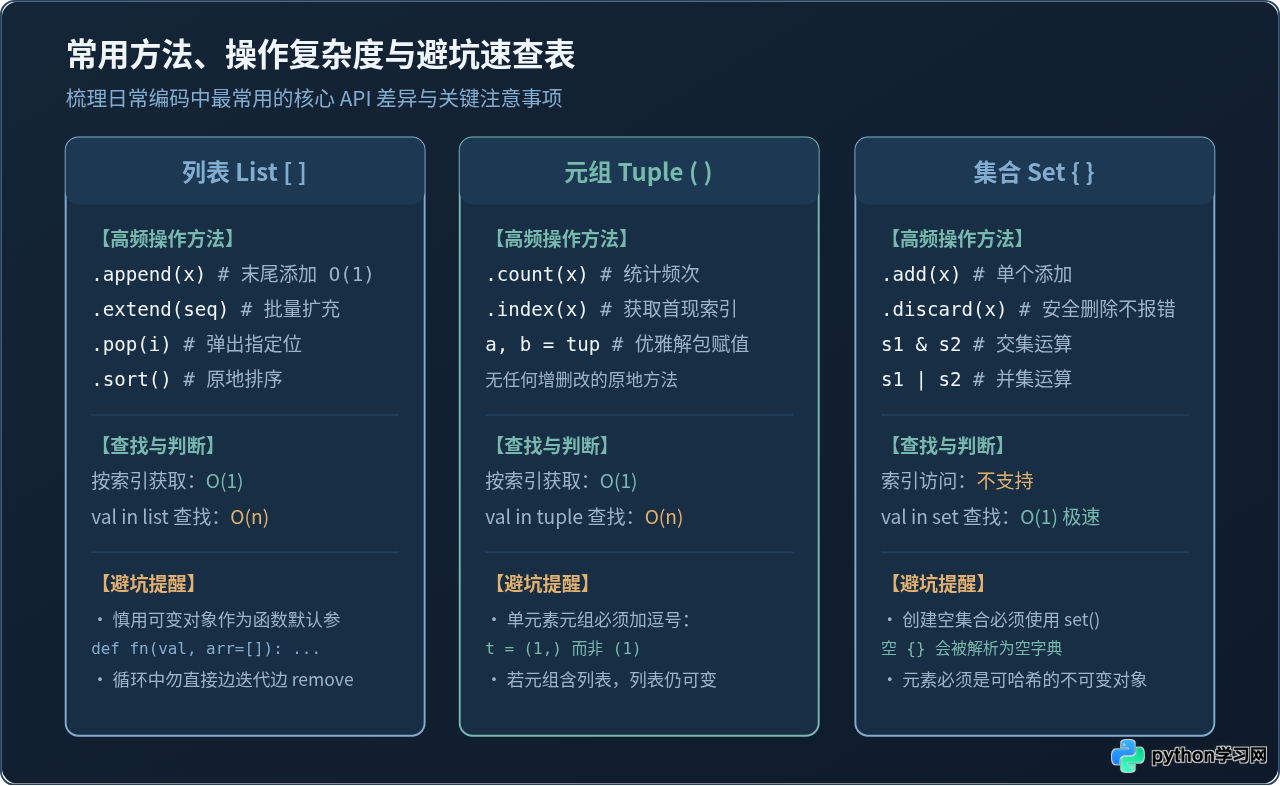
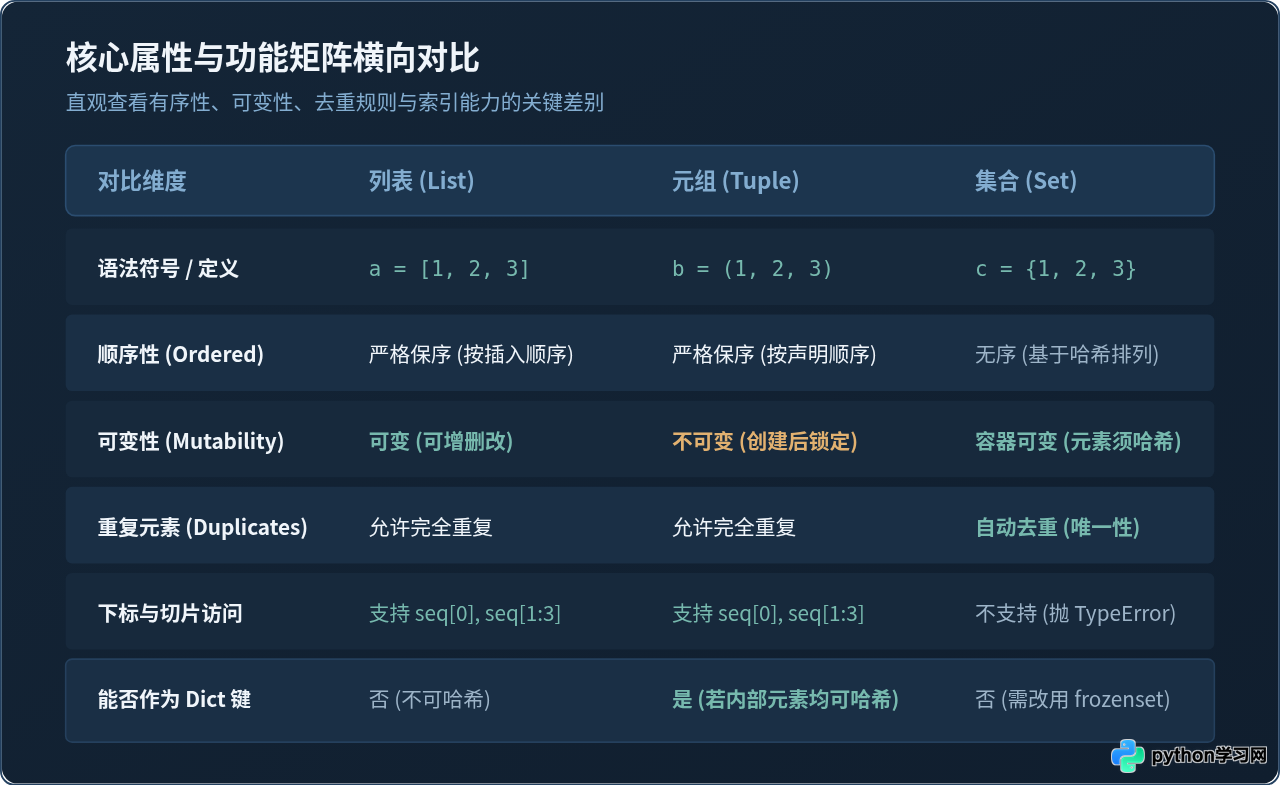
| 对比维度 | 列表 (List) | 元组 (Tuple) | 集合 (Set) |
|---|---|---|---|
| 语法字面量 | [1, 2, 3] |
(1, 2, 3) 或 (1,) |
{1, 2, 3} 或 set() |
| 顺序性 | 有序(按插入顺序保持) | 有序(按声明顺序保持) | 无序(按哈希散列分布) |
| 可变性 | 可变(增、删、改) | 不可变(定长定值) | 集合可变(元素不可变) |
| 是否允许重复 | 允许重复 | 允许重复 | 强制唯一(自动去重) |
| 索引与切片 | 支持 list[0], [1:3] |
支持 tup[0], [1:3] |
不支持(抛 TypeError) |
| 查找复杂度 (in) | O(n) 线性扫描 | O(n) 线性扫描 | O(1) 哈希常数定位 |
| 典型用途 | 动态序列、堆栈队列、批量修改 | 函数多返回值、配置常量、字典键 | 去重、黑白名单快速过滤、关系运算 |
总结而言:在日常 Python 编程中,需要频繁变动的有序序列首选列表;需要保护数据不被意外修改或作为只读记录与字典键时选用元组;而当首要目标是数据去重、求交并差集或实现极速成员查询时,毫不犹豫地选用集合。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









