

怎么实现Python嵌套字典的深度更新(递归合并)
深入讲解Python中嵌套字典深度更新与递归合并的实现原理与落地方法,剖析浅层合并导致子键丢失的问题,提供安全的原地修改与纯函数实现代码,并探讨列表合并策略与引用隔离技巧。
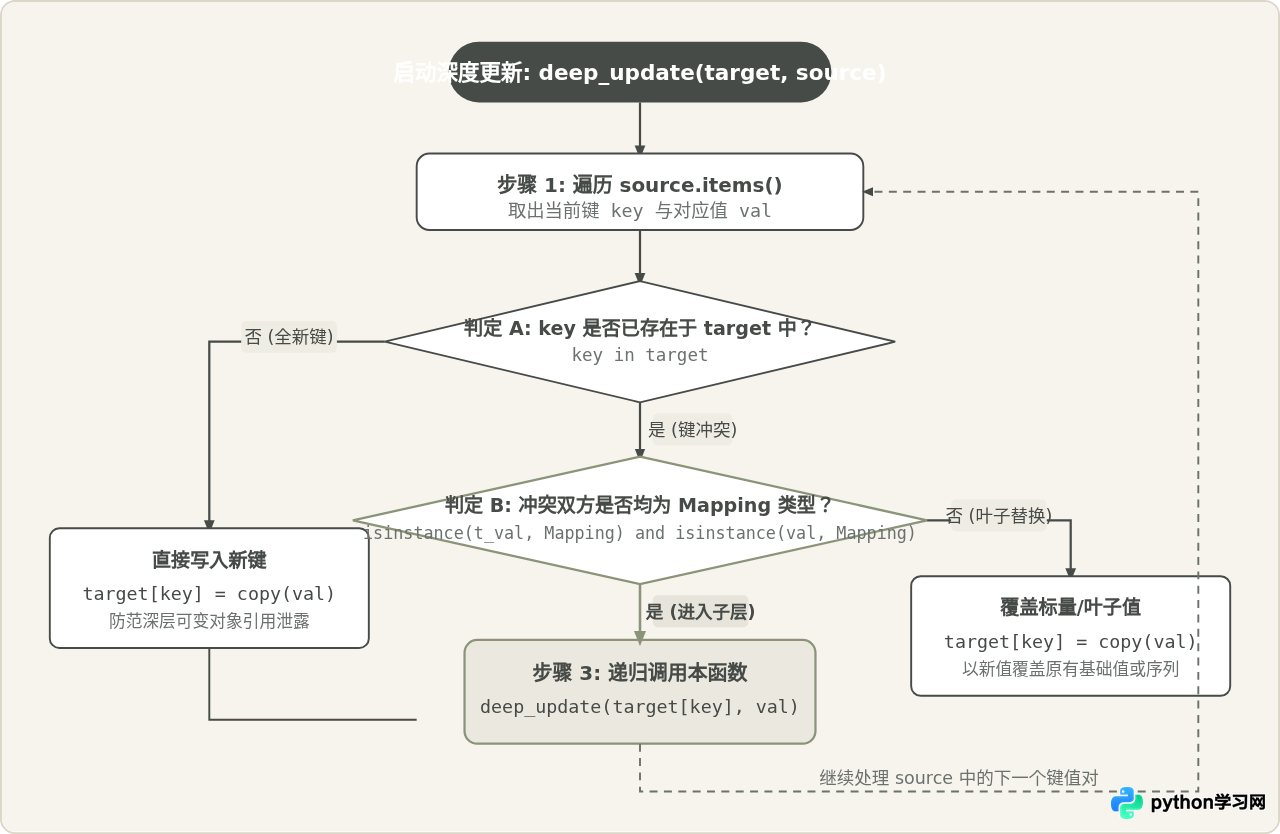
collections.abc.Mapping)。如果双方均为字典或映射,则对该子节点递归调用合并函数;如果只有一方是映射或属于标量数据,则执行赋值覆盖。借助这一递归判定链,可以避免内置 dict.update() 简单粗暴替换整块子字典所造成的同级键丢失问题。
一、浅层合并的局限与问题重现
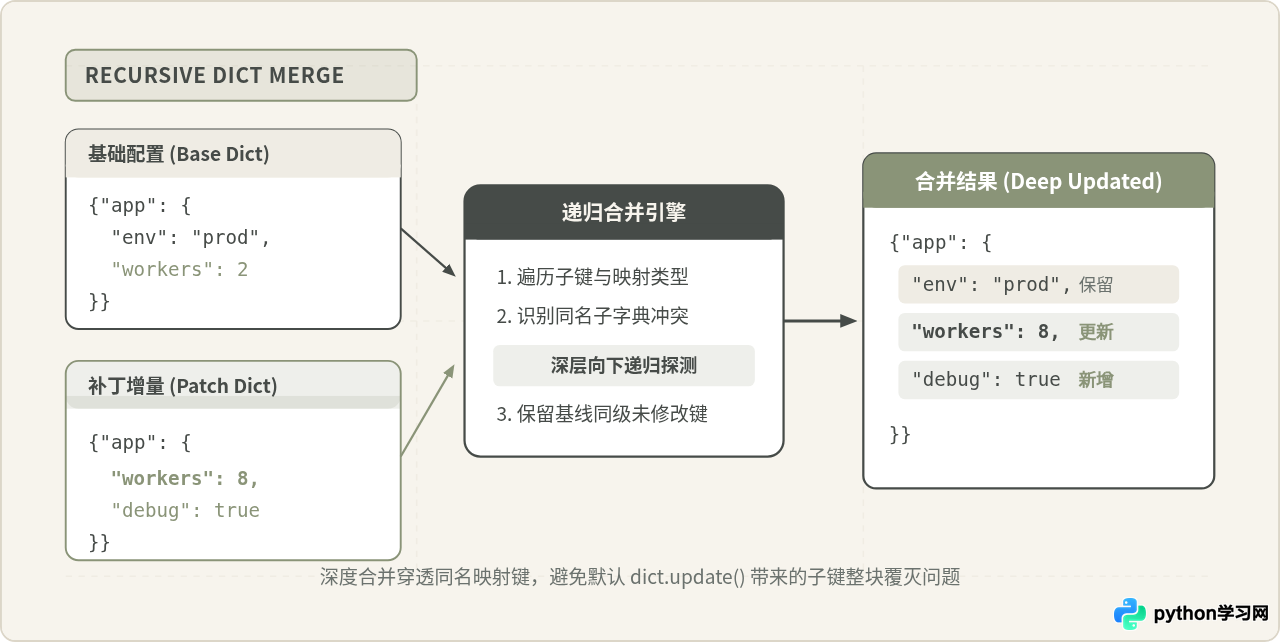
Python内置提供了多种字典合并手段,包括字典实例方法 d1.update(d2)、解构语法 {**d1, **d2},以及在Python 3.9中引入的联合运算符 d1 | d2。然而,这些原生方式本质上都属于浅层合并(Shallow Merge)。
浅层合并的工作机制只聚焦于字典的第一层键。一旦两个字典在顶层出现了同名键,右侧(新传入)字典的值就会彻底替代左侧原有的值。如果该键对应的值本身是一个嵌套子字典,那么原字典在该子字典内部沉淀的所有其他配置项,都会在瞬间被整块抹去。
# 浅层更新导致嵌套子键丢失的典型场景
base_config = {
    "database": {
        "host": "127.0.0.1",
        "port": 3306,
        "user": "root"
    },
    "timeout": 30
}

override = {
    "database": {
        "port": 5432  # 期望仅更新端口号为 PostgreSQL 端口
    }
}

base_config.update(override)
print(base_config)
# 运行结果:
# {'database': {'port': 5432}, 'timeout': 30}
# ⚠️ 问题所在:原有的 "host" 与 "user" 字段被整块冲掉了!
在实际生产场景中,例如微服务的分层配置(默认配置、环境变量覆写、命令行参数传入)、复杂任务的参数补丁更新等,开发者预期的通常是“仅改动具体声明的叶子字段,保留原有结构中的其余字段”。这正是深度更新(Deep Update)要解决的根本问题。
二、标准递归合并的核心算法实现
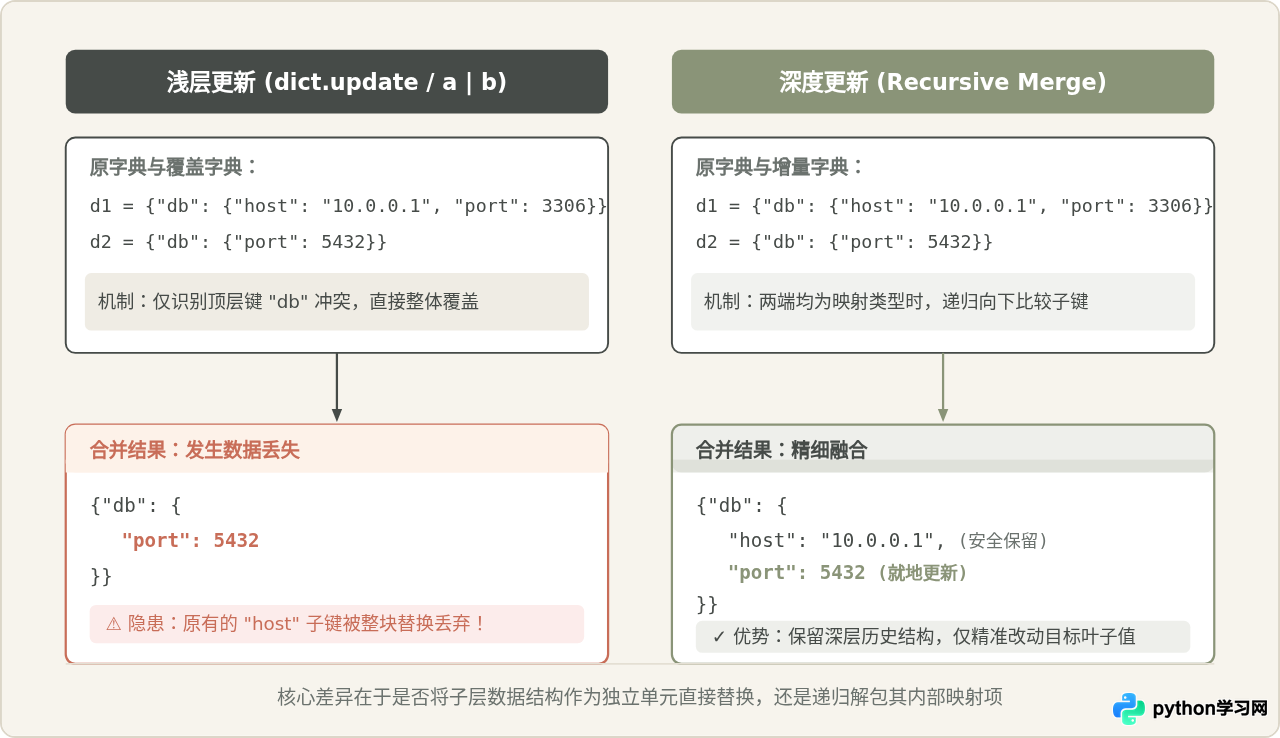
实现深度更新的核心思想是结构解包与递归深入。在遍历覆盖源(source)中的每个键时,如果目标字典(target)中已存在同名键,且双方取出的值都是映射对象,就必须将控制权交由下一次调用,深入到子字典中继续合并;直到遇到非映射类型的标量值或全新键时,才进行最终的值赋予。
在编写该算法时,推荐导入 collections.abc.Mapping 进行类型断言,而不是仅检查 isinstance(v, dict)。这样能够自动兼容 defaultdict、OrderedDict 以及用户自定义的只读或受限映射类型。
1. 原地修改模式(In-Place Deep Update)
如果希望维持与原生 dict.update() 相同的操作手感(直接改变传入的目标字典并返回自身),可以使用以下紧凑的高性能实现:
from collections.abc import Mapping

def deep_update_inplace(target: dict, source: Mapping) -> dict:
    # 对 target 执行原地深度合并,直接修改 target 并返回其引用
    for key, val in source.items():
        target_val = target.get(key)
        # 当双方同名键下的值都是映射类型时,递归深入
        if isinstance(val, Mapping) and isinstance(target_val, Mapping):
            deep_update_inplace(target_val, val)
        else:
            target[key] = val
    return target
2. 纯函数/无副作用深拷贝模式(Immutable Deep Merge)
在许多配置加载与并发处理环节,原地修改可能会造成隐蔽的副作用。如果入参字典可能被其他模块持有,或者 source 中包含多层嵌套字典,直接赋值会导致 target 与 source 共享底层子字典的内存引用。后续对 source 的改动,会悄然穿透并污染 target。
为了杜绝引用别名(Aliasing),应当采用深拷贝构建全新字典,保证两个输入字典完全保持只读:
import copy
from collections.abc import Mapping

def deep_merge(base: Mapping, override: Mapping) -> dict:
    # 纯函数式深度合并:返回全新生成的独立字典,绝不修改 base 与 override
    result = copy.deepcopy(base)
    for key, val in override.items():
        if key in result:
            if isinstance(result[key], Mapping) and isinstance(val, Mapping):
                result[key] = deep_merge(result[key], val)
            else:
                result[key] = copy.deepcopy(val)
        else:
            result[key] = copy.deepcopy(val)
    return result
三、容易混淆的常见说法与方案辨析
在解决嵌套字典合并时,社区中常常出现一些看似合理但实际存在适用边界的误区。理解这些误区有助于在工程中做出正确的技术决策。
为什么看似合理:ChainMap 能够将多个字典逻辑上串联在一起,查找时按照从前到后的顺序搜索键,无需拷贝整个字典,性能极高。
现实局限:ChainMap 的合并仅在顶层生效。当读取 chain_map["database"] 时,它一旦在第一个字典中找到了 "database",就会直接返回该字典的整个值对象,而完全不会去搜索更底层字典中同名的 "database" 键。因此,对于嵌套字典,ChainMap 依然属于浅层遮蔽,无法做到跨深度的叶子键互补。
事实真相:PEP 584 引入的 dict1 | dict2 和 dict1 |= dict2 仅仅是为 dict.update() 提供了运算符层面的语法支持,其底层 CPython 实现调用的依然是相同的浅层覆盖逻辑。遇到嵌套字典冲突时,结果与 update() 完全一致,右侧对象依然会整块覆盖左侧子字典。
事实真相:很多人初写合并函数时,习惯加上 elif isinstance(val, list): target[k].extend(val)。但在绝大多数系统配置中,列表往往代表一组有序的整体选项(例如日志输出格式列表、服务器集群白名单)。如果隐式执行 extend,配置覆盖时原有的默认值将无法被剔除,还会导致重复项堆积。因此,通用深度更新通常应将列表作为原子值直接替换;只有在具有明确业务语义(如事件监听器追加、规则堆叠)时,才显式定制列表策略。
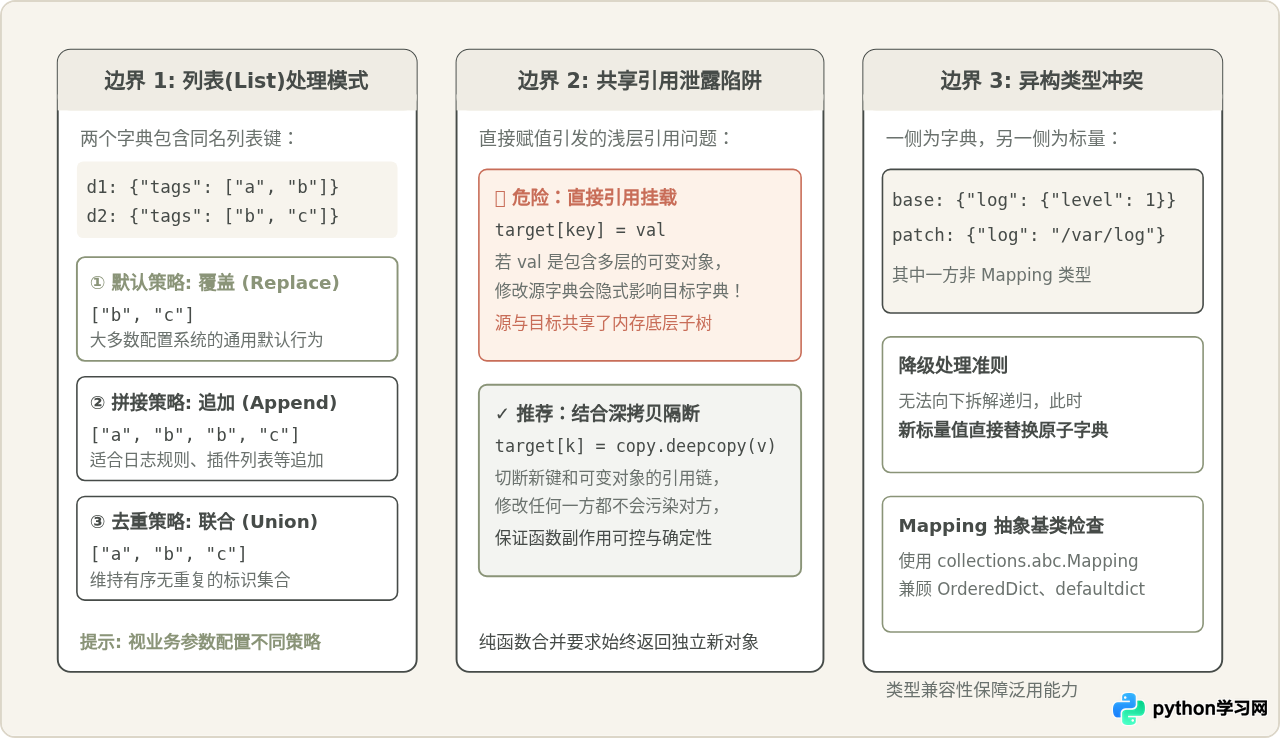
四、生产级实现:支持列表合并策略与多字典批处理
在实际项目封装中,我们往往需要更具弹性的深度合并工具,包括:
- 灵活的列表合并策略:支持选择直接覆盖(
replace)、拼接(append)或去重并集(union)。 - 多字典连续合并:能够像函数式管道一样,按从左到右的优先级一次性合并多个增量字典。
import copy
from collections.abc import Mapping
from typing import Any, Literal

ListStrategy = Literal["replace", "append", "union"]

def flexible_deep_merge(
    base: Mapping[str, Any],
    override: Mapping[str, Any],
    list_strategy: ListStrategy = "replace"
) -> dict[str, Any]:
    # 可配置列表合并策略的深度合并函数
    result = copy.deepcopy(base)

    for key, val in override.items():
        if key in result:
            target_val = result[key]
            # 分支 1:双方均为映射类型,递归深入
            if isinstance(target_val, Mapping) and isinstance(val, Mapping):
                result[key] = flexible_deep_merge(target_val, val, list_strategy)

            # 分支 2:双方均为列表且设置了非替换策略
            elif isinstance(target_val, list) and isinstance(val, list):
                if list_strategy == "append":
                    result[key] = target_val + copy.deepcopy(val)
                elif list_strategy == "union":
                    # 维持原始出现顺序的去重合并
                    merged_list = target_val.copy()
                    for item in val:
                        if item not in merged_list:
                            merged_list.append(copy.deepcopy(item))
                    result[key] = merged_list
                else:  # replace
                    result[key] = copy.deepcopy(val)

            # 分支 3:标量值或异构类型,直接覆盖
            else:
                result[key] = copy.deepcopy(val)
        else:
            result[key] = copy.deepcopy(val)

    return result

def deep_merge_multiple(*dicts: Mapping[str, Any], list_strategy: ListStrategy = "replace") -> dict[str, Any]:
    # 按从左往右的顺序依次深度合并多个字典
    if not dicts:
        return {}
    merged: dict[str, Any] = {}
    for d in dicts:
        merged = flexible_deep_merge(merged, d, list_strategy=list_strategy)
    return merged
五、工程选型与最佳实践总结
在 Python 生态中,根据项目体量与架构约束的不同,实现嵌套字典深度合并主要有三种选型路线:
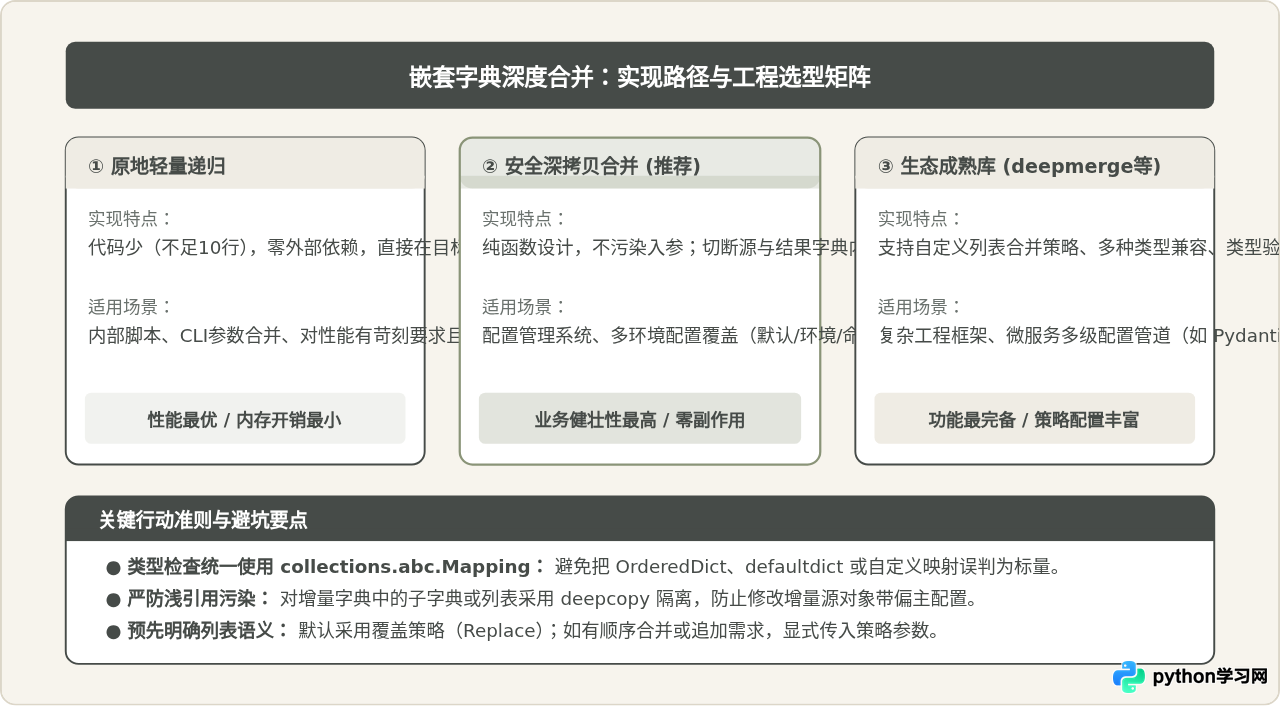
深度合并落地检查清单
- 类型判定严谨性:一律使用
from collections.abc import Mapping代替dict,防止特殊映射类型无法向下递归。 - 避免内存引用污染:在构建纯函数合并时,对新增键值务必通过
copy.deepcopy进行深度解绑,避免源数据与输出数据共享内存对象。 - 递归深度与环形引用防护:常规业务配置层级通常在 10 层以内;若处理未知用户输入的深层树或存在相互引用的图结构,需提防 Python 默认的递归深度上限(
RecursionError),必要时可维护已访问对象集合(visited memo)。 - 第三方成熟生态:在复杂生产应用中,如需更为精细的策略注入,可选用专门的开源库
deepmerge;若用于后端配置建模,推荐采用pydantic-settings或OmegaConf,它们在深度合并的同时还能提供严谨的数据类型校验与转换。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









