

怎么高效学习Python?避开“教程地狱”的实战建议
针对Python初学者频繁遭遇的“教程地狱”陷阱,提供从最小必要语法(MVS)界定、原子化项目拆解、Traceback错误排查到自驱学习闭环的完整实战建议。
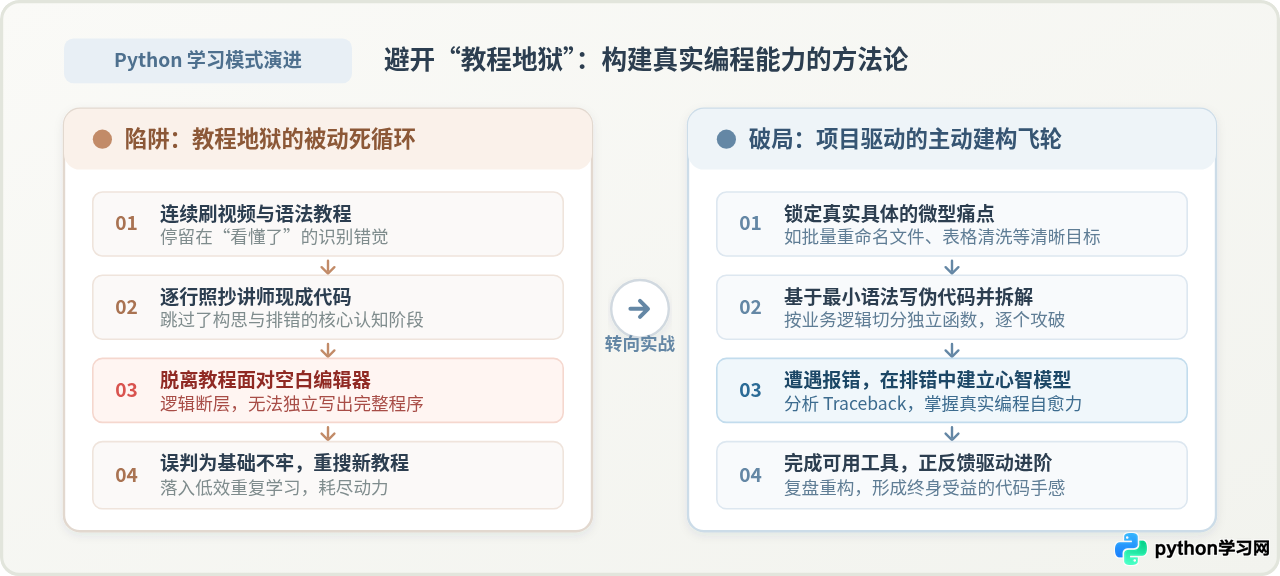
高效掌握 Python 的关键并不是把厚重的语法手册从头到尾背诵一遍,而是尽快将学习状态从“被动跟随教程”切换到“基于最小必要语法(MVS)的问题驱动构建”。所谓“教程地狱”(Tutorial Hell),是指学习者不断观看教学视频、逐行照抄示例代码,看似完全理解,但一旦脱离教程面对空白的代码编辑器,却无法独立写出完整程序的认知停滞状态。避开这一陷阱的核心路径在于:确立最小必要语法边界、以半天内能跑通的微型真实需求为抓手、用自然语言伪代码拆解执行逻辑、并将调试报错作为建立心智模型的关键契机。
一、解构“教程地狱”:为什么看了很多课依然不会写代码?
很多初学者在经历两三个月的学习后,会产生强烈的挫败感:视频里的概念都能听懂,跟着讲师敲每一行代码也能正常运行,甚至做完了整门课程的课后练习。然而,一旦关闭教程,试图写一个简单的脚本时,屏幕前的大脑却一片空白,连第一行该写什么都无法确定。这种现象往往被误判为“自己记忆力不好”或“基础不够扎实”,于是初学者又去寻找另一门评分更高的入门课,从变量、循环再次学起。
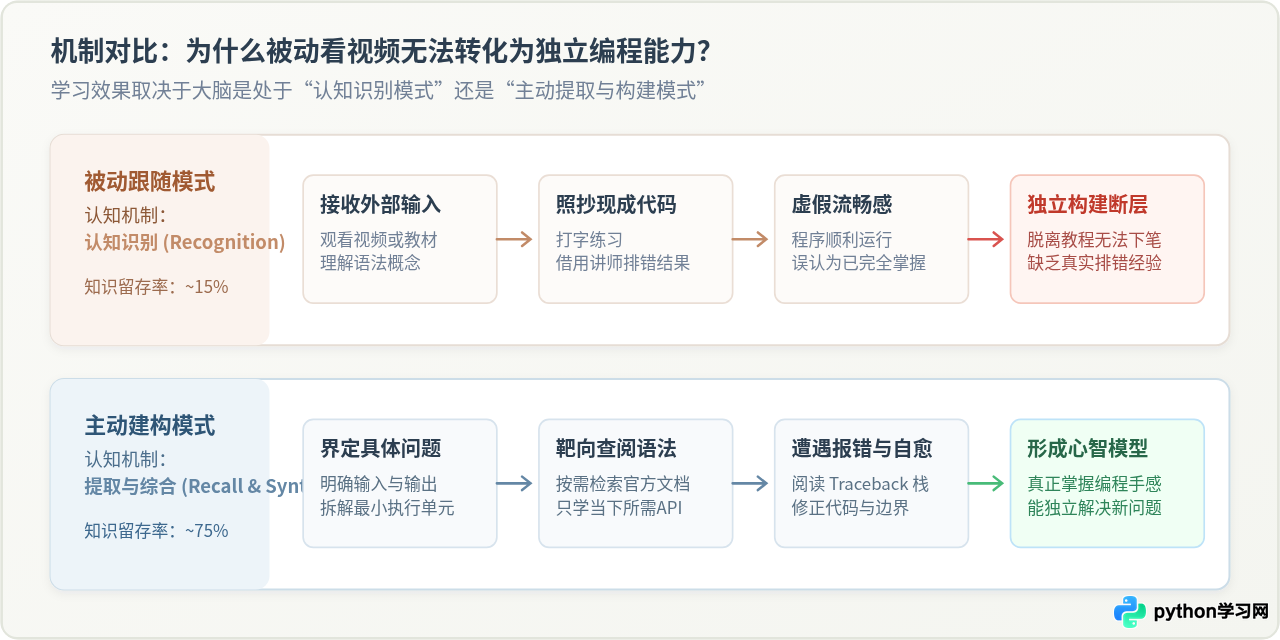
这种陷入死循环的根本原因,在于人类大脑在“认知识别(Recognition)”与“记忆提取及综合应用(Recall & Synthesis)”之间存在巨大的认知鸿沟。
- 认知识别模式(低认知负荷):在观看教学视频或阅读教材时,讲师已经完成了最艰难的工作——确定程序边界、清洗脏数据、预判异常并拆分好了函数逻辑。读者的神经系统仅处于“辨识”状态,只要逻辑讲得通,大脑就会产生“我已经掌握”的即时奖励与虚假流畅感。
- 主动构建模式(高认知负荷):独立编写代码要求程序员在无外部提示的情况下,将一个模糊的现实需求拆解为结构化逻辑,并从长时记忆中主动提取变量、分支、控制流与库函数进行组装。如果平时所有练习都是对照现成代码打字,这种主动提取与逻辑构思的神经回路就从未得到过真实训练。
要打破这种被动模式,就必须主动放弃“等我把所有知识点都学完再开始做项目”的执念。编程是一门高度依赖操作反馈的手艺,真实的学习过程必然伴随着不确定性、查阅手册和排查报错。
二、确立“最小必要语法(MVS)”边界:初学阶段学什么与暂缓什么
Python 语法极为丰富,标准库和生态系统庞大,但解决 80% 日常自动化与脚本需求所需的语法核心,其实只有很小的一部分。初学者掉进教程地狱的一个常见原因,是在起步阶段试图一次性吞下所有高级特性。
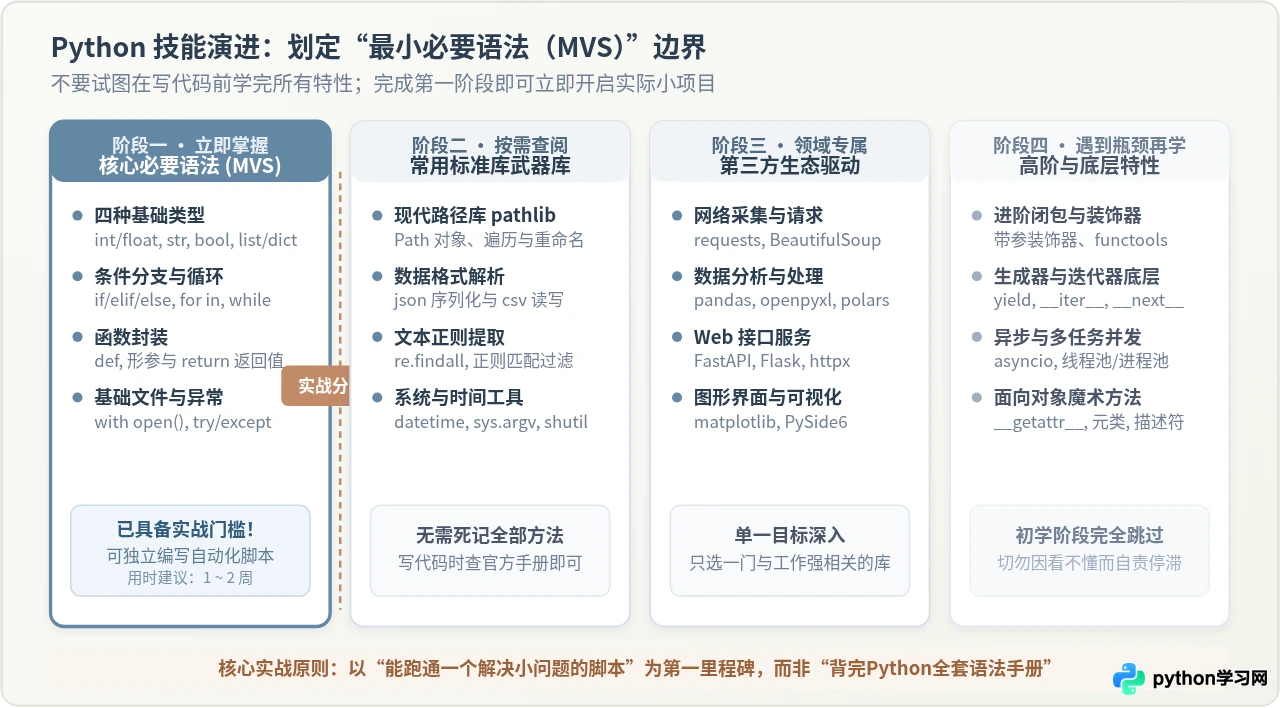
建立高效学习路径的第一步,是划分“最小必要语法(Minimal Viable Syntax, 简称 MVS)”边界。在起步的 1~2 周内,只需掌握以下四个核心模块,即可直接进入微项目实战:
| 知识模块 | 必须立即掌握的 MVS 核心 | 必须主动后置的进阶内容 |
|---|---|---|
| 数据类型与变量 | 整数与浮点数运算、字符串基础切片与格式化(f-string)、布尔值、列表增删改查、字典键值映射。 | 自定义集合协议、复杂嵌套推导式、内存视图与底层指针语义。 |
| 流程与控制结构 | if/elif/else 条件分支、for...in 序列遍历、while 条件循环、break/continue 中断。 |
for...else 语法糖、复杂的模式匹配(match-case)高阶匹配模式。 |
| 函数与模块化 | 使用 def 定义函数、位置参数与默认关键字参数、return 返回结果、import 引入模块。 |
可变参数 *args/**kwargs 进阶黑魔法、带参闭包、类装饰器、高阶函数柯里化。 |
| IO 与异常处理 | 上下文管理器 with open(...) 读写纯文本文件、基础的 try...except Exception as e 错误捕获。 |
自定义上下文管理器协议(__enter__/__exit__)、自定义复杂异常继承树、协程异步 IO。 |
三、从空白文件到可用脚本:项目“原子化拆解”四步法
当脱离了教程,很多人面对空白的代码编辑器依然会感到手足无措。克服这种阻力的有效策略是“原子化拆解法”——将一个看似复杂的目标,降维成若干个可以在 10 分钟内独立求证的微型单元。
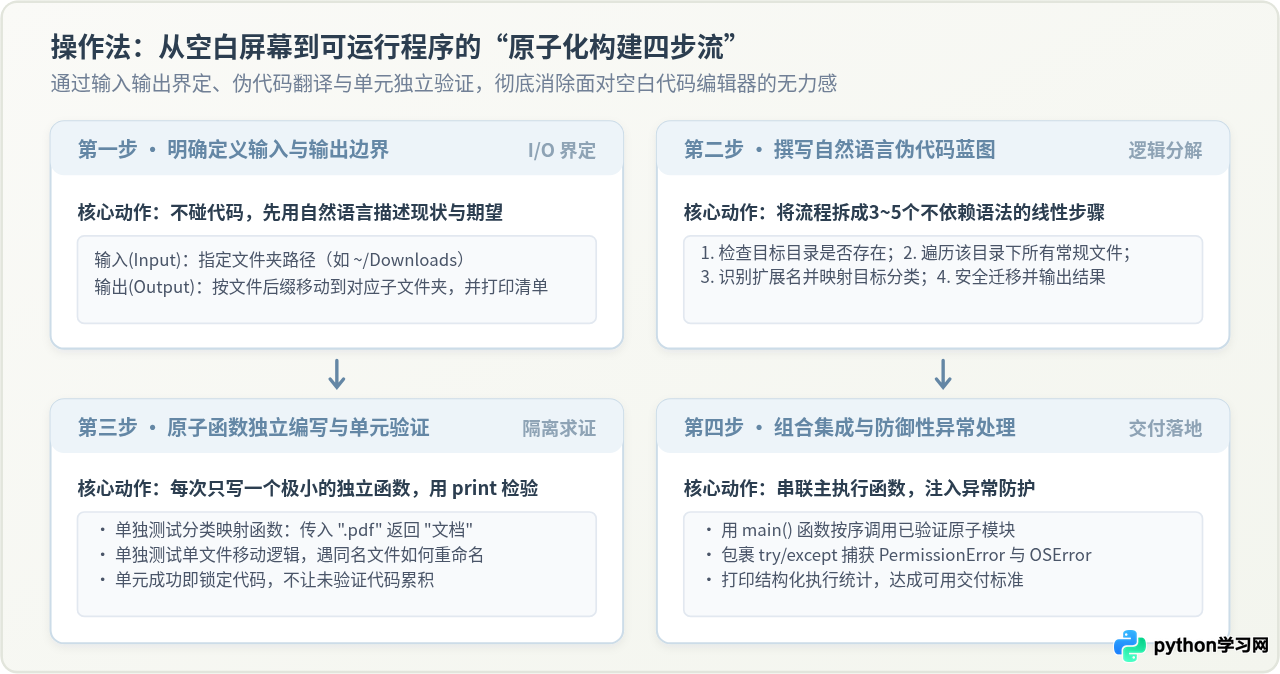
第一步:明确定义输入与输出边界(I/O 界定)
在写代码之前,先拿出一张白纸或打开记事本,严谨地写下当前程序唯一的输入是什么,预期的输出又是什么。例如:
- 输入:一个杂乱无章的目录路径(如电脑中的
Downloads文件夹)。 - 输出:该目录下的文件按类型(图片、文档、音频、压缩包)归类移动到对应的子文件夹中,并在终端打印出移动的文件统计数量。
第二步:撰写自然语言伪代码
用母语将执行逻辑按照时间顺序写出 3 到 5 个线性步骤。在这一步中,完全不要考虑 Python 的具体函数名或语法规则:
- 检查用户指定的目录是否存在,若不存在则提示并退出。
- 获取该目录下的每一个项目,过滤掉已经是文件夹的项,只处理纯文件。
- 查看文件的扩展名(如
.jpg,.pdf),根据预设的字典映射确定它所属的分类。 - 如果对应的分类子文件夹不存在,则在当前目录下新建该文件夹。
- 将文件安全移动进去;如果遇到同名文件,记录跳过或重命名。
- 输出操作汇总日志。
第三步:编写原子函数并逐个在终端求证
不要试图一口气从头写到尾。每次只写一个极小的独立函数,并立即使用 print() 传入测试数据进行验证。当这个函数的输入输出完全符合预期后,再写下一个。这种步步为营的确定性能够迅速消除焦虑。
第四步:组合集成与注入防御性异常处理
当所有原子功能函数都测试通过后,再编写一个 main() 函数将其串联起来,并针对文件权限问题(PermissionError)或路径错误包裹合理的 try...except 代码块。
四、完整实战示例:编写一个“自动化文件智能整理与归类器”
下面我们通过一个真实、高频使用的办公自动化场景,展示如何运用上述原则,仅使用 Python 基础语法和标准库中的 pathlib 与 shutil,编写出具备工业级稳健性的独立实用工具。
1. 完整可执行源码
以下代码无需安装任何外部第三方依赖,在标准的 Python 3.8+ 环境中即可直接运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
自动化文件智能整理工具
功能:扫描指定目录中的所有顶层文件,按照后缀自动归档至对应分类子目录中。
"""

import sys
import shutil
from pathlib import Path

# 1. 扩展名映射字典:将后缀映射到目标文件夹名称
CATEGORY_RULES = {
    "图片": [".jpg", ".jpeg", ".png", ".gif", ".webp", ".svg"],
    "文档": [".pdf", ".docx", ".doc", ".txt", ".md", ".xlsx", ".pptx"],
    "压缩包": [".zip", ".tar", ".gz", ".rar", ".7z"],
    "音频视频": [".mp3", ".wav", ".mp4", ".mkv", ".mov"],
    "代码脚本": [".py", ".json", ".html", ".css", ".js", ".sh"]
}

def get_category_for_file(file_path: Path) -> str:
    """
    原子函数:根据文件扩展名,返回对应的大类名称。
    若未在规则表中定义,则统一归入 '其他文件'。
    """
    suffix = file_path.suffix.lower()
    if not suffix:
        return "无后缀文件"

    for category, extensions in CATEGORY_RULES.items():
        if suffix in extensions:
            return category
    return "其他文件"

def safe_move_file(source_path: Path, target_dir: Path) -> bool:
    """
    原子函数:安全移动文件至目标目录。
    如果目标目录下存在同名文件,自动追加数字后缀避免覆盖。
    """
    target_dir.mkdir(parents=True, exist_ok=True)
    dest_path = target_dir / source_path.name

    # 防御处理:处理同名文件冲突
    counter = 1
    while dest_path.exists():
        new_name = f"{source_path.stem}_{counter}{source_path.suffix}"
        dest_path = target_dir / new_name
        counter += 1

    try:
        shutil.move(str(source_path), str(dest_path))
        return True
    except PermissionError:
        print(f"  [警告] 权限受限,无法移动文件: {source_path.name}")
        return False
    except Exception as e:
        print(f"  [错误] 移动 {source_path.name} 失败: {e}")
        return False

def organize_folder(folder_path_str: str) -> dict:
    """
    流程串联主函数:执行文件夹扫描与整理任务。
    """
    target_path = Path(folder_path_str).resolve()

    # 边界验证:目标目录必须存在且为有效目录
    if not target_path.exists():
        print(f"[错误] 指定路径不存在: {target_path}")
        return {}
    if not target_path.is_dir():
        print(f"[错误] 指定路径不是一个目录: {target_path}")
        return {}

    print(f"开始整理目录: {target_path}")
    stats = {}

    # 仅遍历当前目录下的直属项(不递归处理已经建好的子文件夹)
    for item in target_path.iterdir():
        if item.is_file():
            category = get_category_for_file(item)
            dest_folder = target_path / category

            if safe_move_file(item, dest_folder):
                stats[category] = stats.get(category, 0) + 1

    return stats

if __name__ == "__main__":
    # 支持从命令行参数接收目录,默认整理当前工作目录下的 test_box 目录
    run_dir = sys.argv[1] if len(sys.argv) > 1 else "./test_box"
    summary = organize_folder(run_dir)

    print("
=== 整理完成报告 ===")
    if summary:
        for cat, count in summary.items():
            print(f"· {cat}: {count} 个文件已归档")
    else:
        print("没有需要处理的文件。")
2. 运行方法与结果示例
在终端中创建一个临时的测试目录并放入几个测试文件,随后运行脚本:
mkdir -p test_box && touch test_box/report.docx test_box/photo.png test_box/notes.txt
# 2. 执行整理脚本
python3 organize.py ./test_box
# 3. 示例输出结果
开始整理目录: /Users/username/Desktop/test_box
=== 整理完成报告 ===
· 文档: 2 个文件已归档
· 图片: 1 个文件已归档
3. 代码中值得初学者注意的设计细节
- 使用现代
pathlib.Path替代旧式os.path:pathlib采用面向对象方式组织路径,用item.suffix就能直接取出文件扩展名,用/运算符就能跨平台拼装路径,大幅减少了字符串拼接引入的斜杠错误。 - 同名文件碰撞防护:在移动文件时,使用
while dest_path.exists():检查目标文件是否已存在。如果直接无脑覆盖,可能会造成不可挽回的数据丢失。这种边缘情况的处理正是成熟代码与初学者练习代码的分野。 - 字典统计的
dict.get(key, default)技巧:stats[category] = stats.get(category, 0) + 1简洁地解决了统计字典中首次遇到新 Key 时抛出KeyError的问题。
五、建立脱离教程的自愈能力:如何读懂并解决 Python 报错
在脱离教程独立编码后,初学者最常遇到的心理障碍就是面对满屏红色字体的报错信息产生恐惧。必须明确一个认知:报错并不是失败,而是解释器在手把手告诉你当前代码与预期假设不一致的具体位置。
倒序精读 Traceback(调用栈)
Python 的 Traceback 机制非常清晰,它的阅读逻辑应当是“自底向上”:
- 看最后一行:确认具体的错误类型和描述(例如
IndexError: list index out of range)。这行直接给出了“出了什么事”。 - 看倒数第二行:确认引发该错误的具体文件名和行号(例如
File "main.py", line 42, in process_data)。这行指明了“事发第一现场”。 - 向上追溯调用链路:如果代码较长,往上看是哪个外部函数在第几行调用了该函数,从而排查传递了什么异常参数进来。
TypeError: can only concatenate str (not "int") to str
原因:试图直接使用+拼接字符串和数字。解决建议:统一使用f"当前序号为:{num}"进行格式化。- 可变对象作为默认参数陷阱(Mutable Default Argument)
写出类似def append_task(task, task_list=[]):时,所有调用会共享同一个列表实例。正确做法是将默认参数设为None,在函数体内用if task_list is None: task_list = []进行初始化。 FileNotFoundError: [Errno 2] No such file or directory
原因:使用了相对路径,而运行脚本时的当前工作目录(CWD)并非脚本所在的物理目录。解决建议:使用Path(__file__).resolve().parent锚定当前脚本所在目录。
排错求助法则:构造最小可复现示例(MRE)
当遇到自己经过 15 分钟调试依然无法解决的 Bug 时,不要直接把几百行整个程序截图贴到社区或向同事请教。正确的提问方式是提取出“最小可复现示例(Minimal Reproducible Example)”:
- 将出错的代码段剥离到一个单独的
test_bug.py文件中; - 用硬编码的假数据替代外部文件读取或数据库连接;
- 确保别人仅用这 5~10 行代码和标准环境就能重现完全相同的报错。在提炼这个最小示例的过程中,通常有 70% 的概率你会自己发现 Bug 的成因。
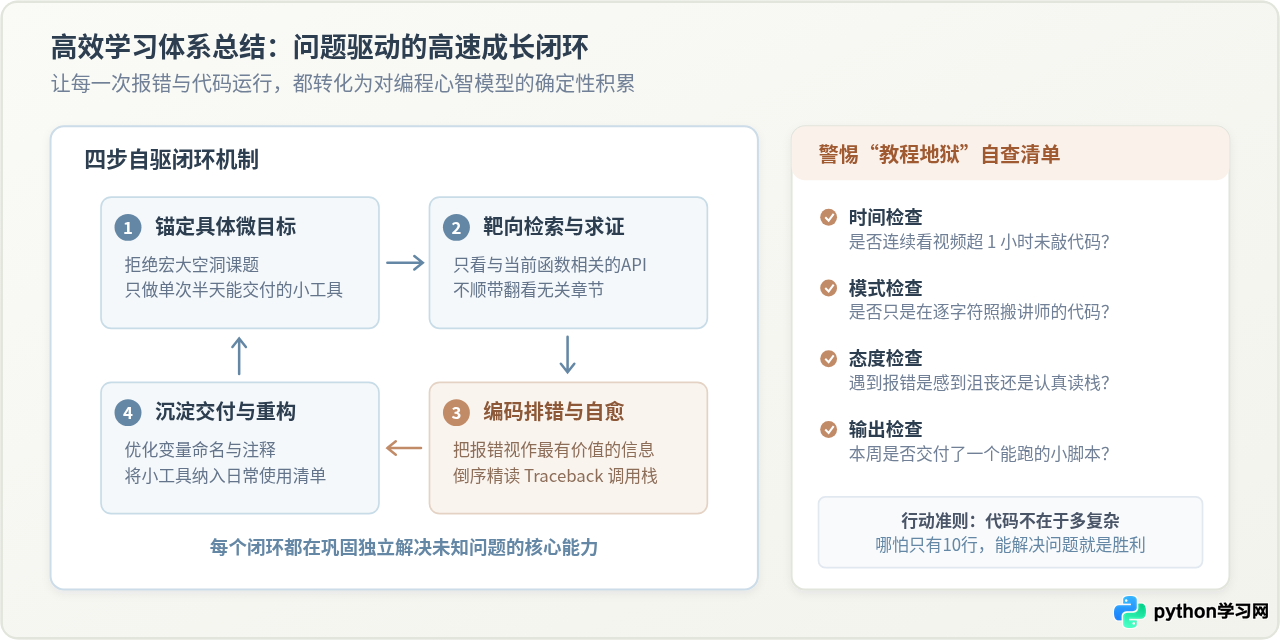
六、体系总结:问题驱动的高效学习闭环
摆脱“教程地狱”的过程,本质上就是从“知识消费者”转变为“问题解决者”的心智跃迁。高效的学习模式永远不是线性的,而是一个不断迭代、螺旋上升的增强回路。
给初学者的 3 个半天可交付入门实战课题推荐
为了让你今天就能彻底迈出教程地狱,请从以下三个微型任务中挑选一个,今晚就开启你的第一个独立构建之旅:
- 课题一:Markdown 文档外链有效性检测器(网络与文本处理)
目标:读取指定.md文件,用正则表达式匹配出所有的 HTTP/HTTPS 链接,使用标准库urllib.request发起HEAD请求,输出哪些链接已经失效(404)。用时约 2~3 小时。 - 课题二:CSV 考勤/账单数据清洗与聚合脚本(数据流与字典)
目标:读取一个包含“日期、姓名、金额、消费类型”的 CSV 文件,自动过滤掉金额为空的脏数据行,按消费类型汇总总金额,并输出到一个新的排版干净的 TXT 统计小票中。用时约 2 小时。 - 课题三:自动下载壁纸并按日期命名的定时小工具(文件与系统交互)
目标:通过调用公开的必应每日壁纸 API,抓取当天的 4K 图片并以YYYY-MM-DD_bing.jpg保存到个人相册目录。用时约 2 小时。
记住:编写代码的信心不来自于你完整背过了多少本教材,而来自于你曾亲手战胜过多少个真实的报错,并最终看到自己写的工具在终端中顺畅运转的那一瞬间。立刻关掉教程视频,打开空白的代码编辑器,写下你的第一行伪代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









