

什么是Python编程?核心特点与应用场景解析
深入解析Python编程的本质、代码执行原理、核心语言特点以及在生产环境中的典型应用场景与工程选型边界。
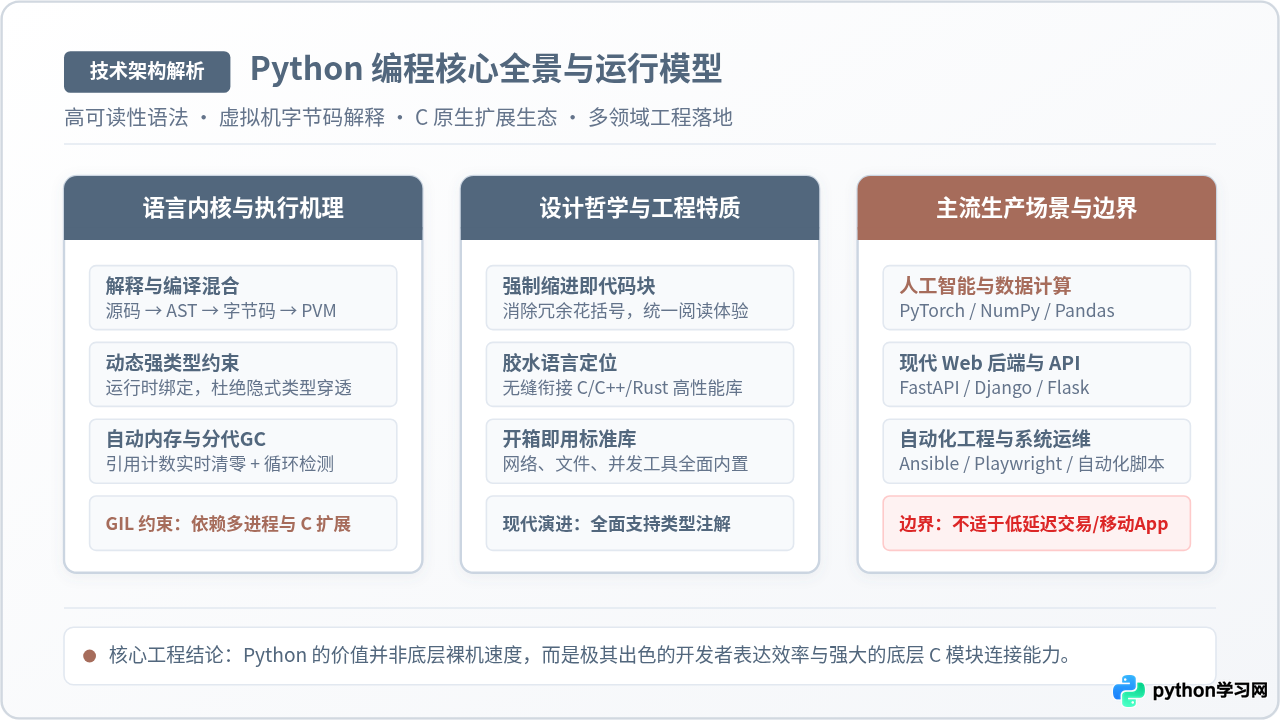
一、Python 的本质与代码执行机理
很多第一次接触 Python 的人,最直观的困惑在于:为什么屏幕上写下的几行极简文本,既不需要手动声明变量类型,也不需要繁琐的编译打包过程,在终端输入回车就能立即输出结果?这种“直接运行”的表象,经常让初学者误以为 Python 是一行行直接读文本执行的原始解释器。
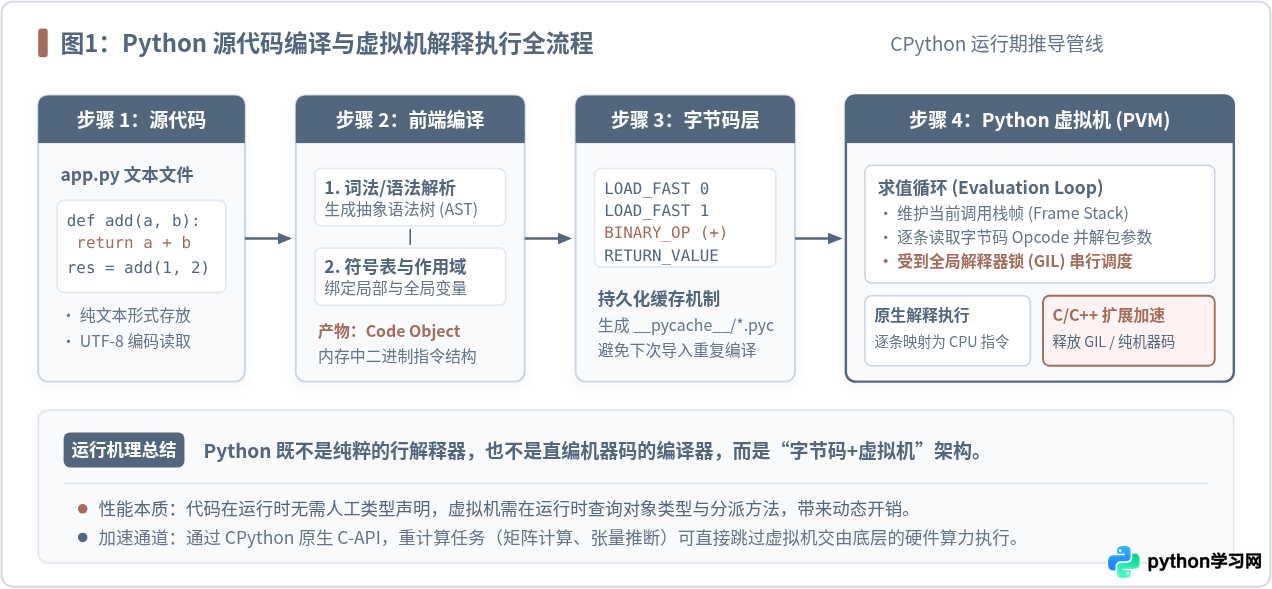
实际上,Python 标准实现(CPython)在底层运行着一个精密的两阶段管线:前端编译阶段与虚拟机执行阶段。当你执行 python main.py 时,程序并没有跳过编译,而是把编译过程自动化并隐匿到了运行时之中。
1. 两阶段编译与解释执行全流程
在图1所示的执行链路中,CPython 解释器首先调用词法分析器(Tokenizer)将代码切分为标记流,随后语法分析器建立抽象语法树(AST),并对变量作用域进行符号表绑定。编译器的代码生成器将 AST 转化为紧凑的二进制指令——即 Code Object(字节码对象)。
为了避免模块在每次被导入时重复经历语法解析与编译,Python 会把这些编译好的字节码写入磁盘的 __pycache__ 目录中,后缀为 .pyc。当源文件的修改时间戳与 .pyc 记录一致时,解释器直接读取字节码载入内存,省去前端编译开销。
随后,Python 虚拟机(Python Virtual Machine, 简称 PVM)接管控制权。PVM 本质上是一个用 C 语言编写的巨大死循环(在 CPython 源码中对应 ceval.c 的 _PyEval_EvalFrameDefault 函数)。它在单线程内部维护着调用栈帧(Frame Stack),依次读取字节码操作符(Opcode)和操作数(Oparg),并调用底层的 C 函数完成内存分配、对象计算与指令分派。
2. 字节码反汇编实证
我们可以通过 Python 标准库自带的 dis 模块,直观透视一段看似简单的加法函数在虚拟机内部究竟转化成了怎样的指令序列:
# 文件名:inspect_bytecode.py
# 执行环境:Python 3.10+ 标准终端
import dis

def compute_sum(a: int, b: int) -> int:
    result = a + b
    return result

# 打印函数对象的字节码指令
dis.dis(compute_sum)
  5           0 LOAD_FAST                0 (a)
              2 LOAD_FAST                1 (b)
              4 BINARY_OP                0 (+)
              8 STORE_FAST               2 (result)

  6          10 LOAD_FAST                2 (result)
             12 RETURN_VALUE
从上面的反汇编输出可以看到:即使给参数标注了 int 类型,生成的字节码依然是通用的 LOAD_FAST 与 BINARY_OP。这也直接揭示了 Python 的运行本质——类型标注在纯原生 Python 运行时中仅仅充当元数据提示,虚拟机在执行 BINARY_OP 时仍然需要检查操作数 a 和 b 的类型指针,动态分派到底层的加法实现。这种运行时动态检查,正是 Python 开发灵活但原生纯计算偏慢的根本原因。
二、核心特点深度解析:优势、权衡与隐性成本
任何编程语言的设计都是一系列工程权衡(Trade-offs)的结果。Python 放弃了对硬件裸机寄存器和物理指针的底层细粒度控制,换来了极高的人类自然可读性。理解 Python 的核心特点,不仅要知道它能带来什么好处,更要清醒地掌握其背后的技术代价。
1. 动态类型与“强类型”本质
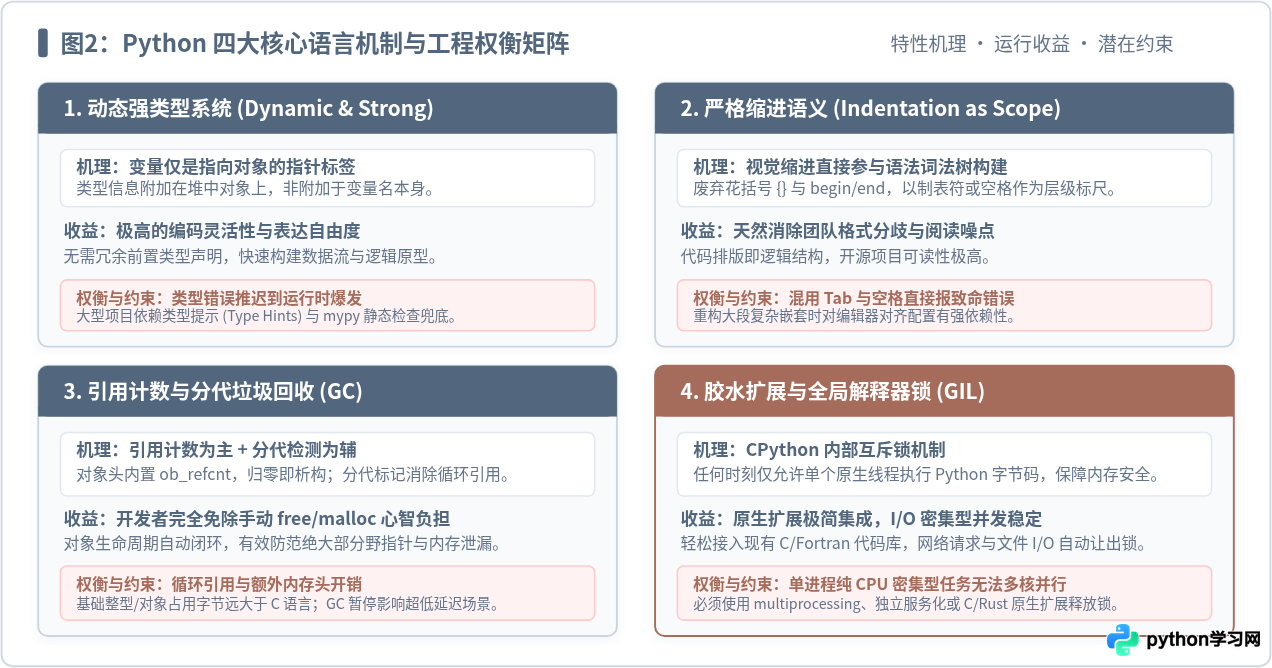
在编程语言分类中,很多初学者极易将“动态类型”与“弱类型”混为一谈。Python 是彻底的动态强类型语言。所谓“动态”,指的是变量本身只是一个贴在堆内存对象上的引用标签,变量名没有固定类型,可以随时绑定到不同类型的对象;而所谓“强类型”,指的是语言绝不进行危险隐式的跨类型运算。
# 动态强类型行为验证
x = "42"       # x 当前引用字符串对象
x = 100        # 合法:重新指向整数对象,展现动态特性

# 强类型安全防护
try:
    invalid_op = x + "5"  # 整数与字符串相加
except TypeError as err:
    print(f"拦截错误: " + str(err))
拦截错误: unsupported operand type(s) for +: 'int' and 'str'对比 JavaScript 会将 100 + "5" 自动隐式拼接为字符串 "1005",Python 直接抛出 TypeError。这种强类型约束在动态语言中构建了极其关键的安全屏障,避免了隐式类型转换在复杂业务逻辑中引发不可控的连锁灾难。
2. 语法强制缩进:视觉结构即语义树
Python 彻底剔除了大多数 C 系语言中充斥的 {}、begin/end 等块界定符,改用制表符或空格构成的缩进深度来决定代码块层级。在 Python 的词法解析器中,每当行首缩进增加时,解析器便生成一个 INDENT 标记;当缩进减少时,便生成 DEDENT 标记。
TabError: inconsistent use of tabs and spaces in indentation,导致程序无法启动。
3. 自动化内存管理与分代垃圾回收
Python 采用以引用计数(Reference Counting)为主、分代收集(Generational Garbage Collection)为辅的复合内存回收策略:
- 引用计数:每个 Python 对象头部都包含一个计数器
ob_refcnt。当一个对象被变量赋值、传入列表或作为函数实参时,计数加 1;当变量离开作用域、被显式del或被重新赋值时,计数减 1。一旦计数器降为 0,底层内存立即被系统释放回收。这一机制响应迅速且极其平稳。 - 分代循环检测:引用计数无法解决两个对象相互引用的死锁问题(例如
nodeA.next = nodeB且nodeB.prev = nodeA)。CPython 引入了分为 3 代(第 0 代、第 1 代、第 2 代)的循环检测器,根据对象的存活时间分批扫描并清理孤立的循环引用链。
4. 胶水语言特质与全局解释器锁(GIL)
在所有关于 Python 性能的讨论中,全局解释器锁(Global Interpreter Lock, 简称 GIL)始终是绕不开的工程焦点。在标准 CPython 解释器中,GIL 是一把互斥锁(Mutex),其根本目的是保护 Python 内部的 C 对象内存免受多线程竞争破坏。
GIL 带来的直接工程影响是:在单进程内,哪怕宿主机拥有 64 核 CPU,纯 Python 多线程代码在任何单一瞬间也只有 1 个线程能够真正占有 CPU 执行字节码。这是否意味着 Python 无法利用多核?绝非如此。在真实架构中,工程师通过两种标准模式解决该问题:
- I/O 密集型并发:网络请求、数据库查询、磁盘读写等场景,线程在等待 I/O 时会自动释放 GIL,因此基于
asyncio协程或多线程可获得极佳的高吞吐表现; - 计算密集型并发:使用多进程架构(如
multiprocessing库或多容器 Pod 部署),每个进程拥有独立的解释器实例与独立内存空间;或者调用底层由 C/C++/Fortran 编译的外部库(如 NumPy),在底层 C 代码执行耗时矩阵运算时显式调用Py_BEGIN_ALLOW_THREADS释放 GIL,实现真正的全核心并行加速。
三、核心应用场景与工程适用边界解析
没有任何一门编程语言能够在所有维度上保持全能。Python 能够成为当今全球工业界最主流的语言之一,根本原因在于它找准了自身的战略定位——做生态聚合的“连接者与胶水”,并在特定优势领域构筑了极深的技术护城河。
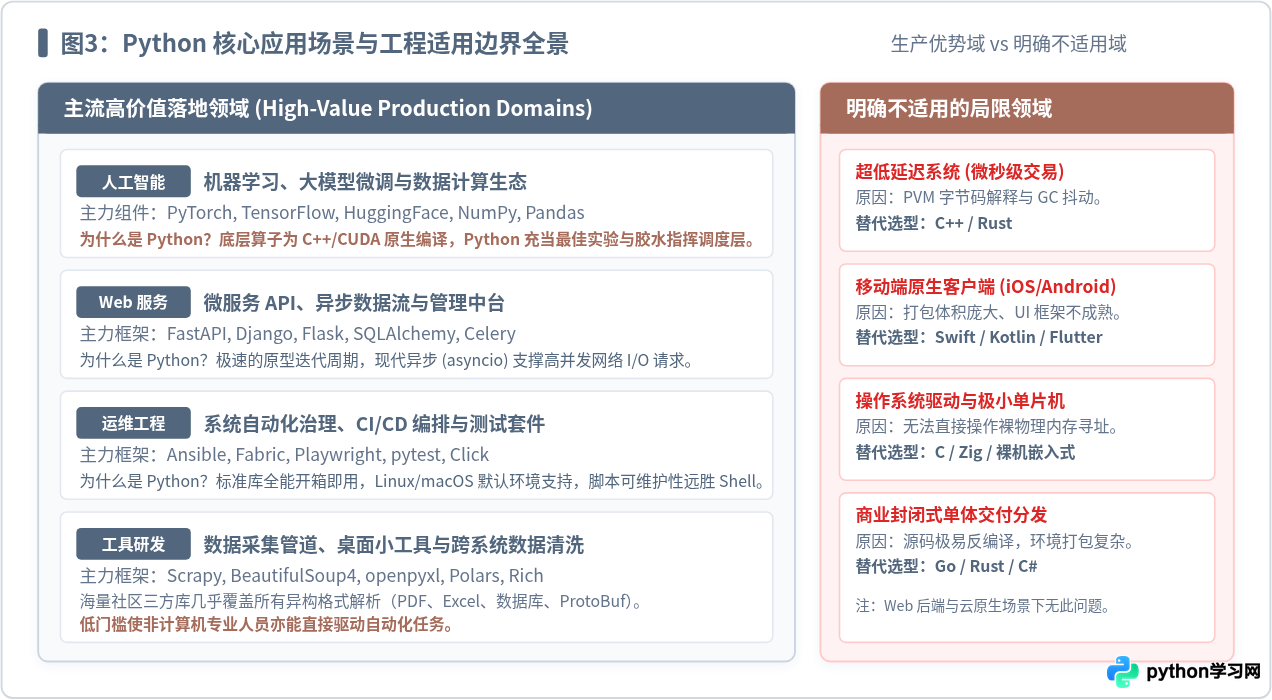
1. 人工智能与现代数据科学(主力主场)
在机器学习与大模型开发领域,Python 占据着近乎垄断的地位。但必须澄清一个认知误区:AI 模型训练速度极快,靠的并不是 Python 本身的运算速度,而是 Python 极其优雅的粘合能力。
深度学习框架(如 PyTorch、TensorFlow)的核心算子、反向传播引擎和 CUDA 显存管理全部使用 C++ 与 CUDA 编写。算法工程师使用 Python 编写的其实是调度控制流和网络拓扑结构。Python 使得科研人员与工程师无需与复杂的指针算术与编译环境打交道,即可把极其庞大的浮点运算推向底层的 GPU 芯片。
2. 现代 Web 后端与高性能 API 构建
在早期的 Django、Flask 时代,Python 常被诟病单机 QPS 不如 Go 或 Java。然而随着 Python 3.5 引入原生的 async/await 语法,以及 ASGI 规范和现代框架 FastAPI 的兴起,这一局面彻底改写:
# 文件名:api_service.py
# 依赖环境:pip install fastapi uvicorn pydantic
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI(title="订单处理微服务")

class OrderPayload(BaseModel):
    order_id: str
    amount: float
    items_count: int

@app.post("/orders/validate")
async def validate_order(payload: OrderPayload):
    # 自动类型验证与异步 I/O 处理
    is_valid = payload.amount > 0 and payload.items_count >= 1
    return {"order_id": payload.order_id, "approved": is_valid}
# 启动命令:uvicorn api_service:app --host 127.0.0.1 --port 8000
INFO:     Started server process [42109]
INFO:     Waiting for application startup.
INFO:     Application startup complete.
INFO:     Uvicorn running on http://127.0.0.1:8000 (Press CTRL+C to quit)
FastAPI 基于 Pydantic 实现了静态类型驱动的自动序列化、入参校验与 OpenAPI 文档生成,单机在网络 I/O 密集型场景下可承载数万级吞吐并发,大幅缩减了企业 API 的交付周期。
3. 系统自动化、DevOps 与工程测试
在云计算与基础设施运维中,Python 是事实上的行业通用语言。著名的自动化运维工具 Ansible 即基于 Python 构建。相比于 Bash 脚本在复杂逻辑、异常捕获和跨平台路径处理上的脆弱,Python 提供了完整的面向对象模块封装、严谨的异常处理机制以及几乎涵盖所有协议的标准库(http.client、ssl、subprocess、sqlite3)。
4. 明确的适用边界:什么时候不应该选用 Python?
技术选型中最致命的错误就是盲目迷信单一语言。工程负责人必须对 Python 的技术局限保持绝对清醒:
| 业务与系统场景 | 为何不推荐使用 Python? | 行业更优替代选型 |
|---|---|---|
| 纳秒/微秒级低延迟交易 | 虚拟机的动态分派开销以及不可控的垃圾回收暂停,会导致尾部延迟(Tail Latency)严重抖动。 | C++ / Rust |
| 操作系统内核与硬件驱动 | Python 运行在操作系统之上,无法直接映射物理内存地址与控制底层硬件中断。 | C / 嵌入式汇编 |
| 原生移动端 App (iOS/Android) | 打包体积动辄几十兆,Python 虚拟机对电池功耗与移动端原生 UI 渲染管线支持极不成熟。 | Swift / Kotlin / Flutter |
| 高安全性单文件封闭商业交付 | Python 字节码极易被 uncompyle6 等逆向工具完全还原源码,单文件静态打包分发困难。 |
Go / Rust / C# |
四、技术选型与工程化落地闭环流程
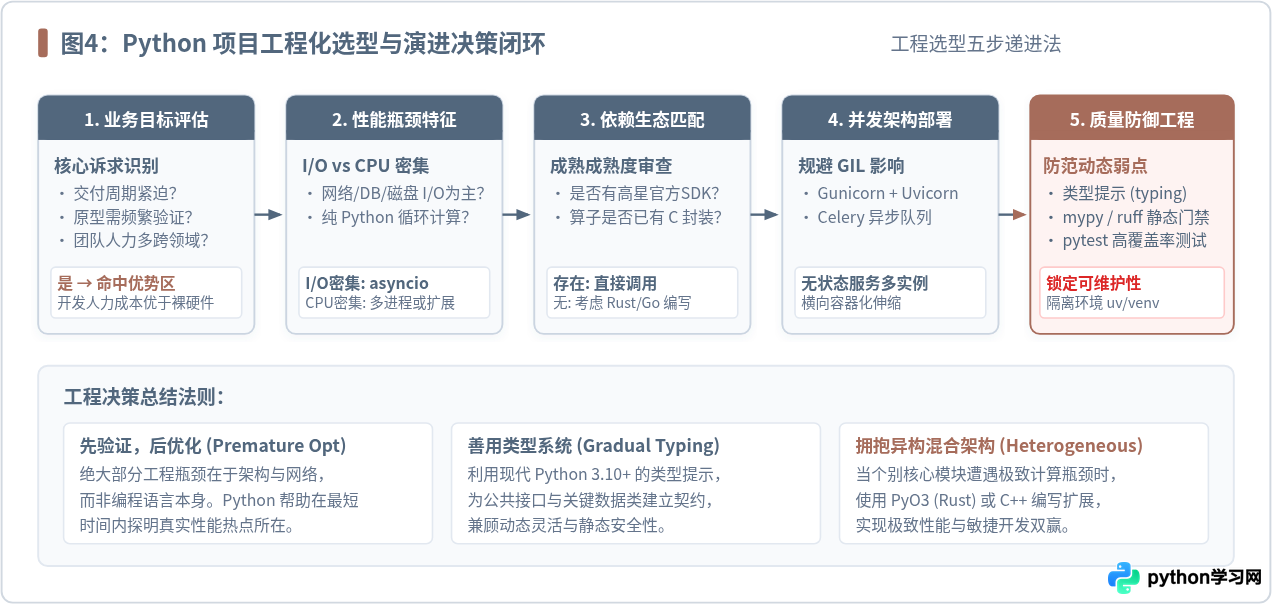
在实际团队中,如何科学地判断一个全新项目是否应该启动 Python 技术栈?可以遵循图4所示的五步递进决策漏斗:
1. 选型决策五步落地法
- 步骤一:评估核心交付矛盾。项目最缺的是团队交付速度还是极端硬件利用率?如果是探索型产品、中台服务或原型系统,选择 Python 能抢占宝贵的市场验证周期。
- 步骤二:解构计算模式。剖析系统的算力负载模型。若是高并发网络 I/O,可放心地采用 FastAPI 异步栈;若是纯数学密集型运算,先检索是否存在成熟的 C/Fortran 底层封装包(如 SciPy、NumPy)。
- 步骤三:生态依赖审查。确认业务所需的外部组件、第三方云厂商或 AI 模型,是否均提供了高质量的 Python SDK。
- 步骤四:并发架构解耦。制定防范 GIL 影响的部署拓扑——在容器层面采用多进程 Worker 架构(如 Gunicorn / Celery),将有状态计算和无状态调度剥离开来。
- 步骤五:工程质量静态防御。在团队协作中全面引入现代工程守则,抵消动态类型的潜在维护隐患。
2. 现代 Python 项目的规范工程化防御
许多团队抱怨 Python“代码超过一万行就无法维护”,本质上是因为他们依然在用十年前脚本时期的粗放模式写 Python。现代工业级 Python 开发必须建立起严格的代码防御体系:
- 严格的虚拟环境隔离:使用
venv或新一代极速包管理工具uv锁定项目依赖,杜绝全局环境污染与版本漂移; - 强制接口类型注解:公共方法与关键数据结构全面采用 Python 3.10+ 类型标注,并通过
mypy静态分析工具在 CI 流水线中进行前置拦截; - 代码风格与静态审查自动化:引入极速静态检查器
ruff统一代码排版与命名约束,通过pytest保持关键业务的高测试覆盖率。
通过这套现代工程体系,团队不仅能够享受 Python 带来的极高初期开发速度,还能确保项目在演进为复杂微服务集群后依然具备坚实的可维护性与架构鲁棒性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









