

图生视频和文生视频有什么区别?常用AI工具功能解析
本文通过Runway与Adobe Firefly的网页界面,解析图生视频与文生视频在输入条件、提示词侧重及结果检查上的核心差异,帮助用户根据现有素材选择正确的生成模式。
区分图生视频与文生视频,关键在于观察生成界面中是否存在作为画面依据的图片。文生视频主要依赖文字描述构建镜头逻辑;图生视频则是在已有图像的基础上赋予其运动属性。对于初学者而言,理清这两个输入区域的功能边界,比记忆复杂的模型名称更为实用。以下结合Runway与Adobe Firefly的网页版视频生成功能,说明两类模式的操作逻辑与注意事项。
概述:同一个生成区,输入条件不同
目前的AI视频生成界面通常围绕模型选择、内容输入、参数设置和结果预览四个板块组织。虽然不同平台的具体布局会有所调整,但核心逻辑保持一致。进入工具后,首先应确认当前选用的视频模型支持哪些输入方式,再观察文字输入框与图片上传区是如何配合工作的。
以Runway的Gen-4.5模型为例,官方明确支持Text to Video(文生视频)与Image to Video(图生视频)两种模式。Adobe Firefly的视频生成功能同样提供了从纯文本或基于图像启动的选项。需要注意的是,并非所有平台的所有模型都具备相同的能力,具体可用功能需以账户权限和当前页面显示为准。
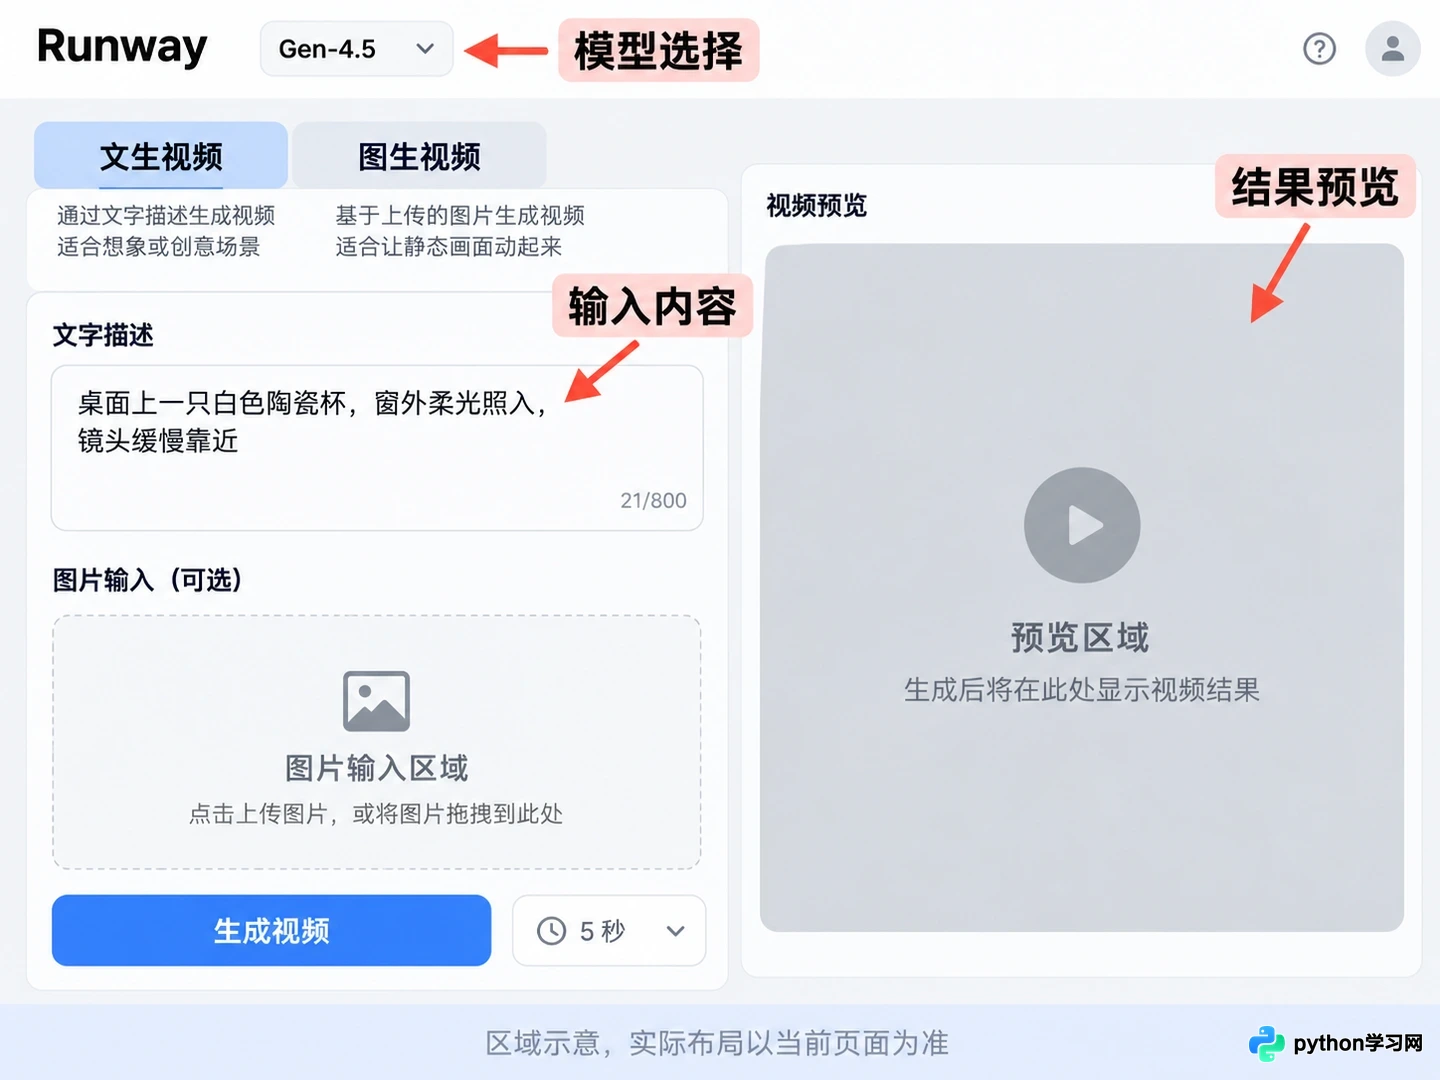
AI视频生成界面通常包含模型选择、输入区和预览区
关于文字输入区:描述画面,也描述变化
在文生视频模式下,由于没有预设的起始画面,用户需要在提示词中完整交代主体特征、环境氛围以及镜头的运动方式。例如,“桌面上一只白色陶瓷杯,窗外柔光照入,镜头缓慢靠近”。这类描述旨在让模型理解静态元素与动态变化的关系。
仅使用“高级”、“电影感”等抽象形容词,往往无法准确传达镜头内的具体行为。将可见的对象、具体的动作轨迹以及拍摄视角的变化写入提示词,能显著提高生成的可控性。同时,避免在一次描述中堆砌过多互不相关的场景,这会导致模型难以聚焦核心意图。文字输入区的任务是表达创作意图,它并非精确控制每一帧时间轴的专业编辑器。
在图生视频模式中,文字的作用发生了转移。由于图片已经提供了主体的外观、光影和构图信息,此时的提示词应侧重于补充“如何运动”。例如,指定主体是向左移动还是旋转,镜头是推近还是拉远。此时若反复描述图片中已存在的静态细节,而忽略了动作指令,反而可能干扰模型对运动逻辑的判断。
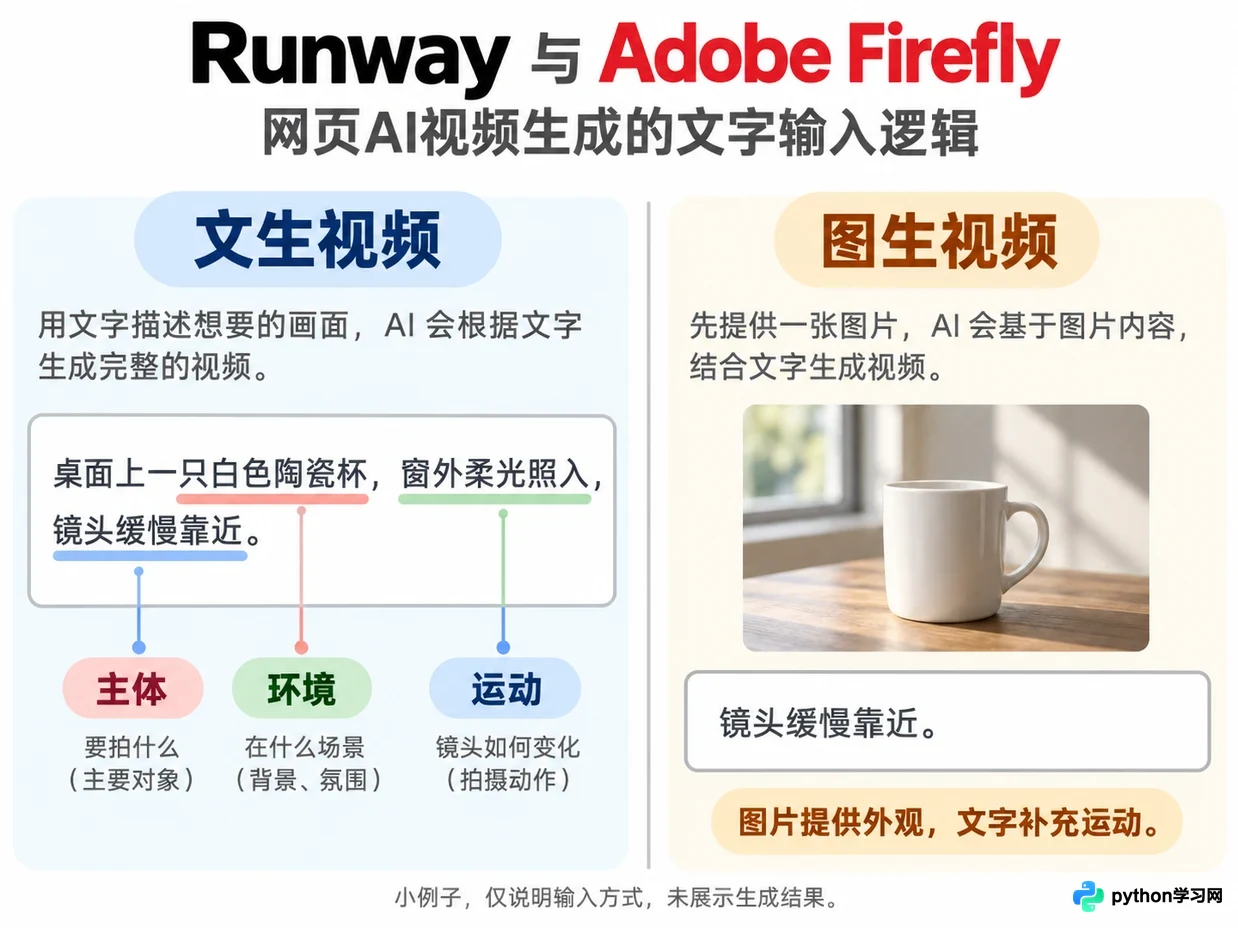
关于文字输入区:描述画面,也描述变化
关于图片与帧区域:先看图片扮演什么角色
上传图片前,需明确该图片在生成过程中扮演的角色:是起始帧、结束帧,还是仅作为风格参考。在Adobe Firefly的视频生成界面中,Frame区域的First选项允许用户上传一张图片作为视频的第一帧。这意味着后续生成的画面将严格遵循这张图的构图和主体特征进行延展。
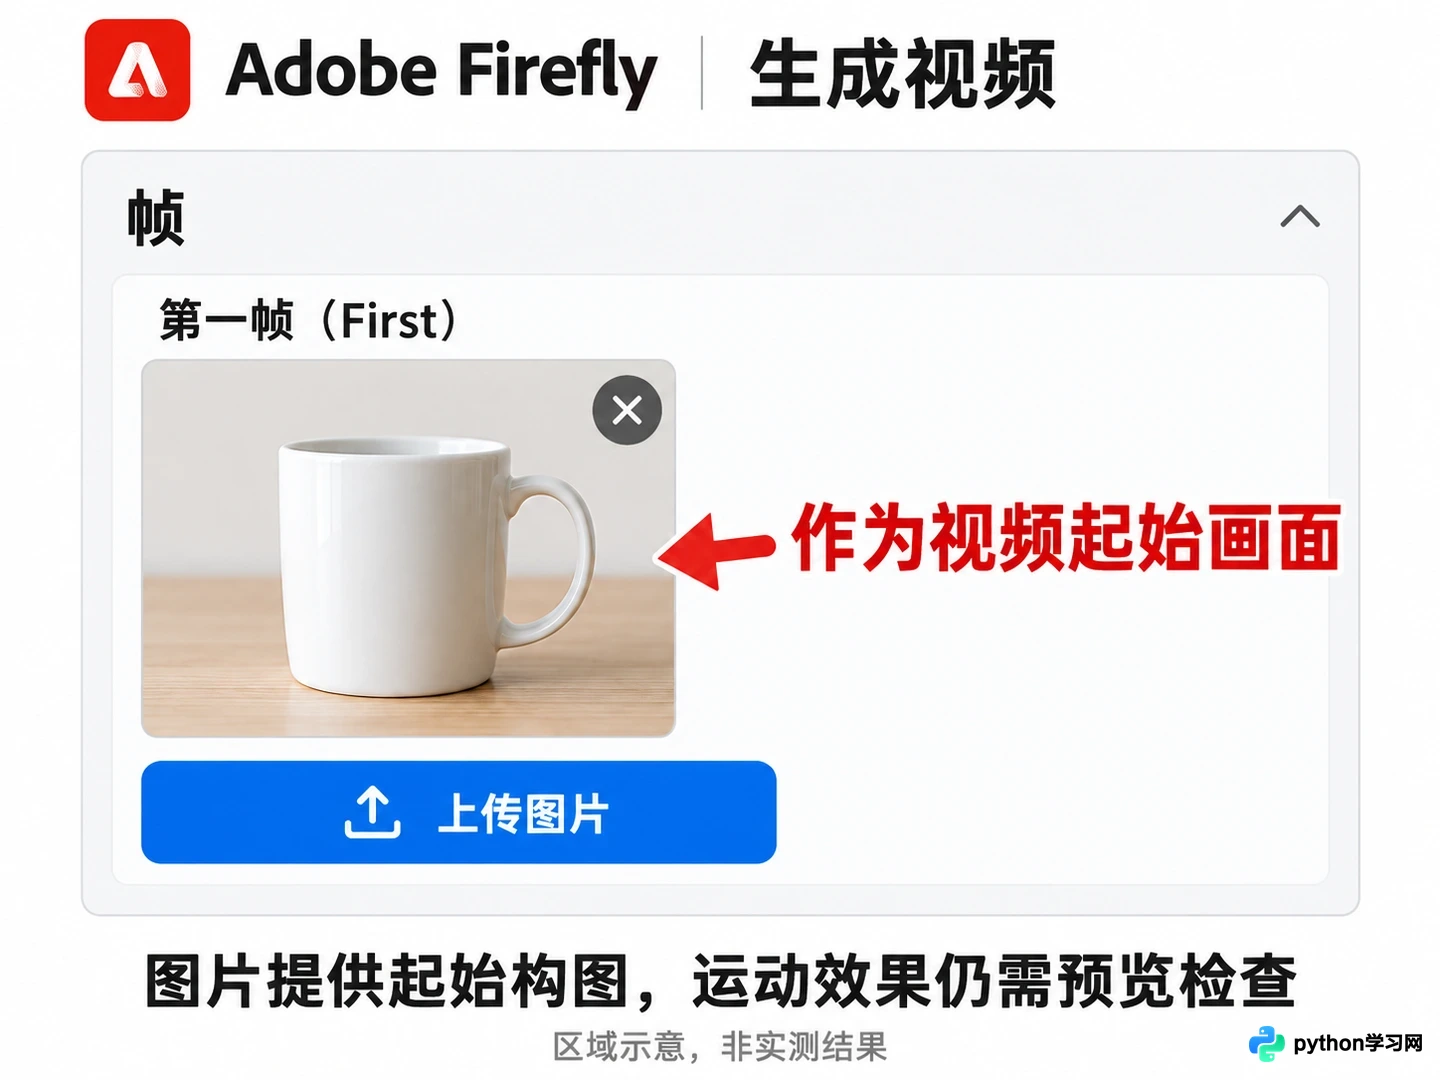
在Frame区域设置First Frame作为起始帧
当拥有明确的产品图、人物设定或固定构图需求时,从图片开始生成能最大程度保留视觉一致性。但这并不保证商标文字、复杂的手部结构或微小物体在运动中始终完美无损。如果画面要求极高的严谨性,必须在结果预览中逐段检查,不能仅凭封面图与原图相似就判定整段视频合格。
此外,上传前需检查图片的边缘裁剪和画幅比例。如果在静态图中主体已经被裁切,模型很难通过提示词准确恢复被遮挡的部分。选择参考图时,应确保主体位于合理范围内,减少因构图过满导致的运动冲突,并确认拥有该图像的使用权。
关于结果预览:比较的是镜头是否兑现
预览区域不仅是查看成果的地方,更是调整下一次生成条件的依据。对于文生视频,重点检查生成的主体、环境与动作是否与文字描述相符;对于图生视频,则需额外关注起始构图是否得到延续,主体细节是否在运动中发生扭曲。
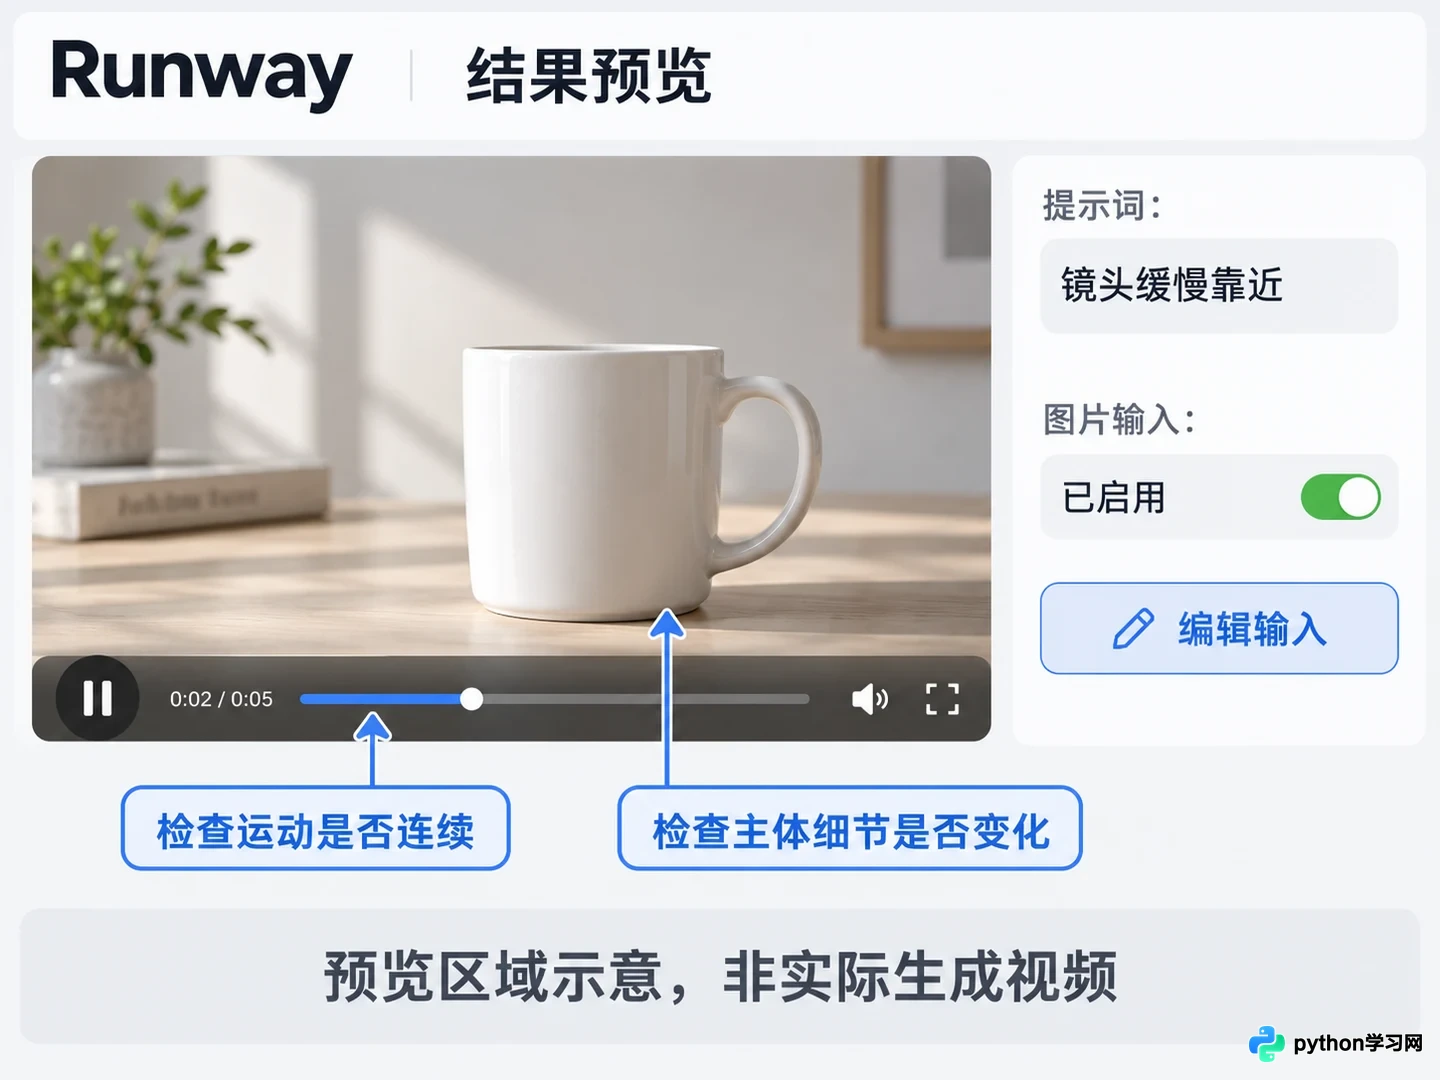
在预览区检查镜头运动与画面一致性
两者都应注意观察运动过程是否出现突然的跳变,以及画面中是否凭空出现了原本不需要的新对象。当需要优化结果时,建议保留原始输入,每次只修改一个关键变量。例如,将“镜头环绕”改为“镜头缓慢靠近”,通过对比不同版本的输出,找到最接近预期的参数组合。
需要注意的是,这种调整方法旨在提高可控性,并不承诺必然得到完美结果。视频生成的算力消耗与导出权益通常受账户规则限制,在使用前应查看当前平台的具体计费或积分政策,避免误以为功能存在即代表免费无限使用。
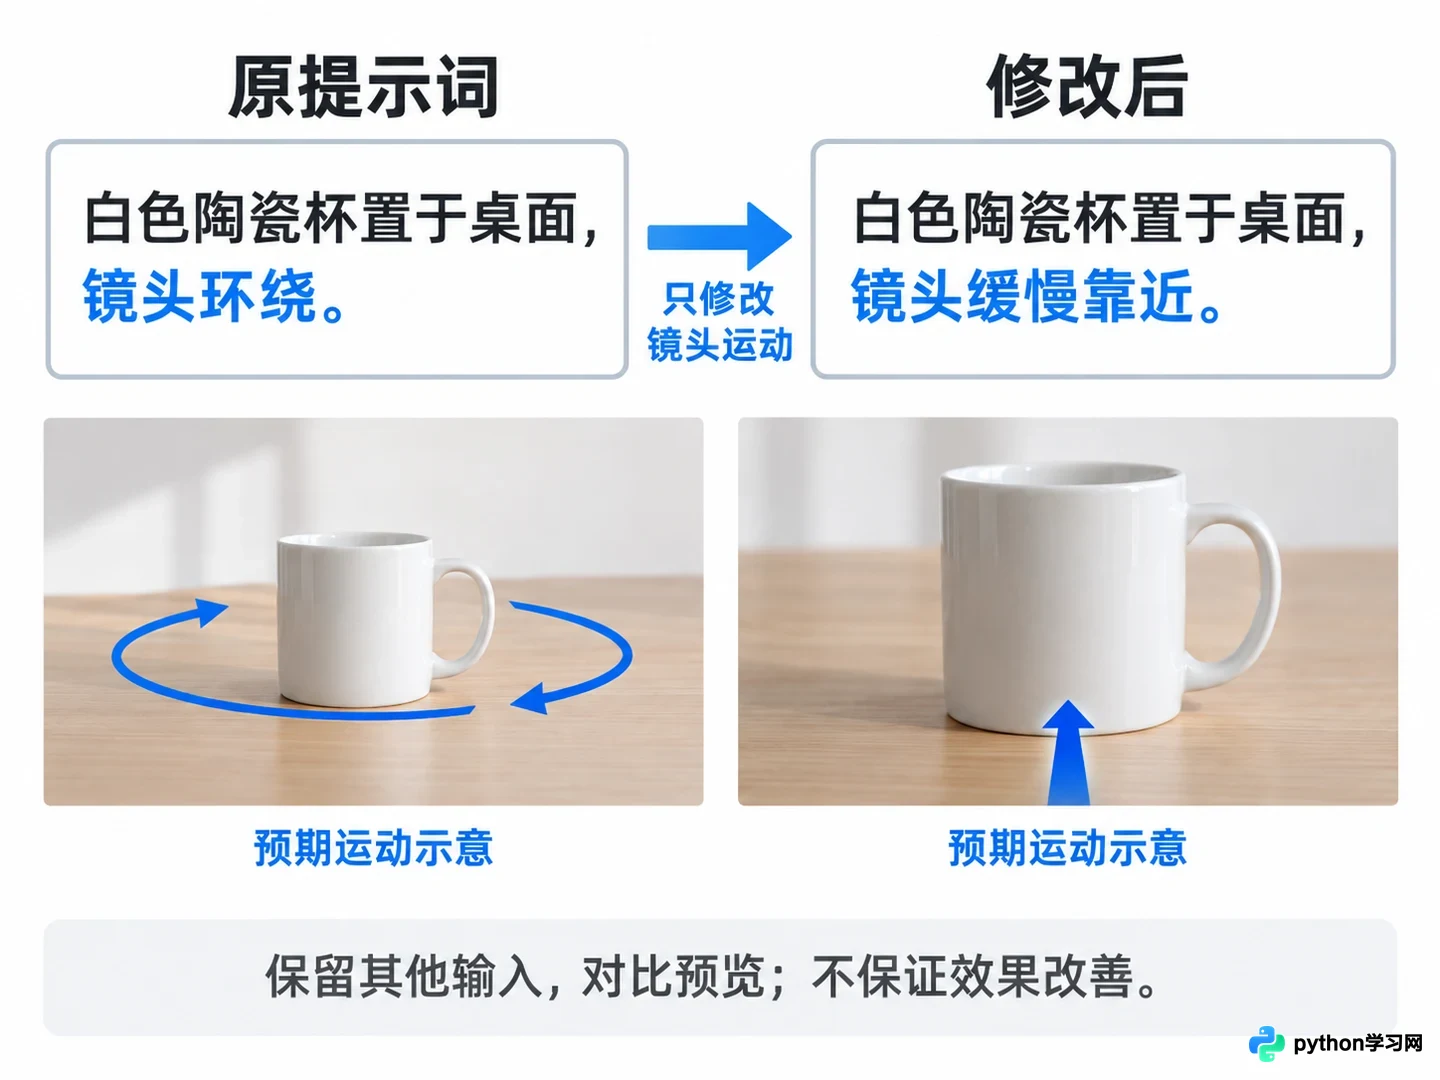
通过修改单一变量优化生成结果
Runway有助于理解同一模型下不同输入模式的差异,而Firefly的帧区域设置则清晰地展示了图像在时间轴上的具体用途。理清输入端与预览端的逻辑关系后,用户可根据手头持有的是抽象的文字构想,还是具象的明确画面,灵活选择对应的生成路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









