

零基础学Python能做什么?办公自动化与数据分析入门场景
针对零基础学习者的实际应用场景,系统拆解Python在办公自动化(批量文件整理、多表合并汇总)与轻量数据分析(数据清洗、多维透视与统计出图)中的核心落地场景、实操代码与认知边界。
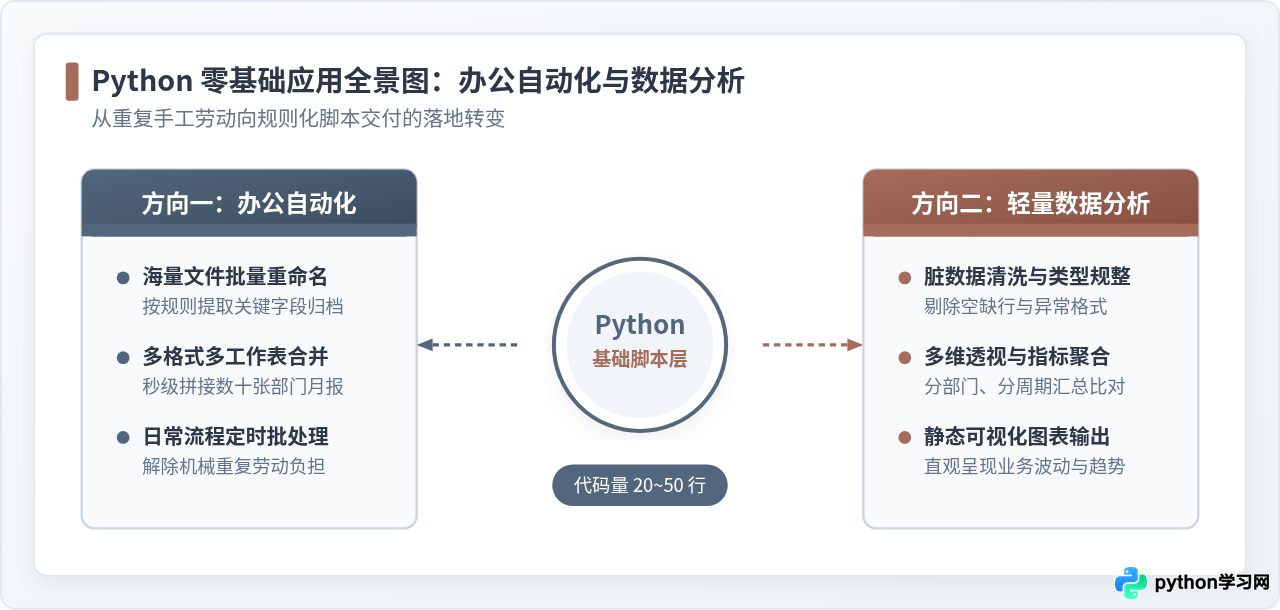
零基础学习 Python,最快见效且无需深厚计算机背景的落地点不是开发大型网站或训练深度学习算法,而是“办公自动化”与“轻量数据分析”。对于非技术岗位的职场人而言,掌握 30 到 50 行基础 Python 脚本,就足以将原本需要花费数小时的手工复制粘贴、跨表汇总与数据统计压缩至数秒内自动执行。
初学者往往容易陷入两个极端:要么以为必须背完厚厚的语法书才能动手,要么误以为学完几节课就能立刻独立开发商业级软件。理解零基础学 Python 的关键,在于准确建立能力与工具的边界认知,明确哪些繁杂的机械任务适合用基础脚本代劳,并沿着可验证的最小操作链路逐步展开。
一、认知基准:零基础写 Python 的实际能力边界
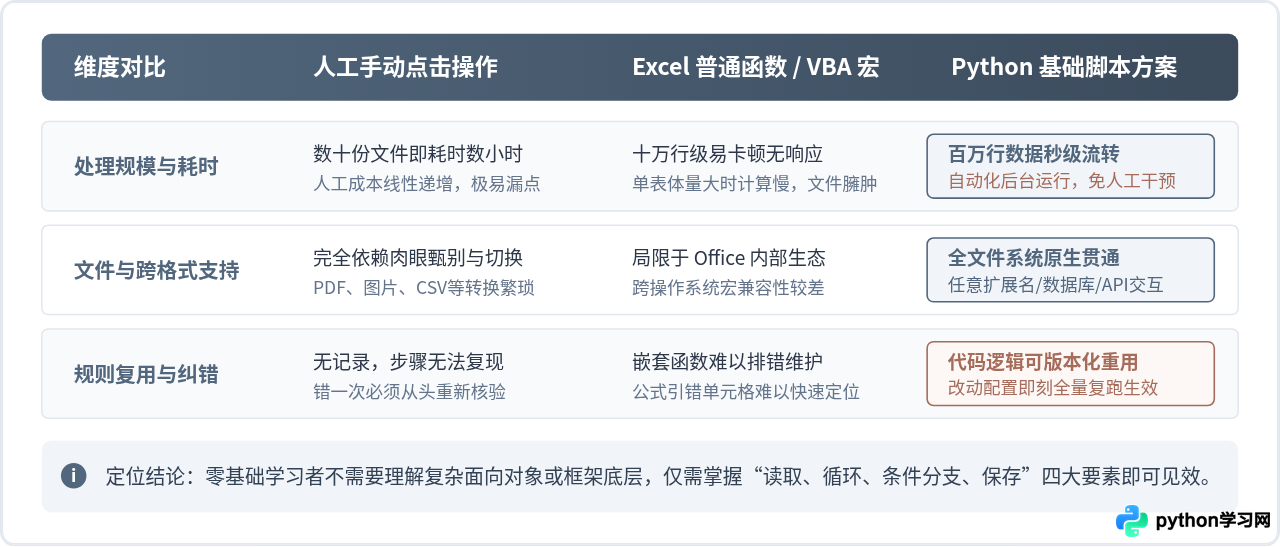
在传统办公环境中,绝大多数人在面对几百个文件的重命名、跨月表格的核对以及格式清洗时,采用的是最原始的“鼠标点击+复制粘贴”方式。这种方式不仅极易疲劳出错,而且一旦原始数据格式稍作变更,所有操作必须重新来过。
Excel 自身的内置函数和 VBA 虽然能处理一部分需求,但面对非结构化文件(如跨文件夹遍历大量 TXT、CSV 或 PDF)或者跨越十万行以上的数据时,往往会出现界面卡死、语法晦涩或难以跨软件协同等瓶颈。Python 凭借直观的语法结构以及成熟的第三方库(如 pathlib、openpyxl、pandas),为初学者提供了一条门槛更平缓的自动化解决路径。
二、核心场景一:办公自动化(文件整理与表格批量处理)
办公自动化的核心本质,是将“有固定规则的机械劳动”转化为结构化代码。零基础学习者在这一方向最先落地的通常是两类需求:一是操作系统层面的文件遍历与整理,二是多源 Excel/CSV 报表的自动化合并与字段过滤。
1. 批量文件扫描与按规则归档
假设你的工作目录下混杂了数百个以“日期_部门_报表名.xlsx”命名的文件,若手工逐一新建文件夹并剪切归类,耗时且易遗漏。通过 Python 内置的 pathlib 模块,用十几行代码即可按部门名称自动建立子文件夹并完成迁移。
from pathlib import Path
import shutil

# 定义源文件目录与目标归档根目录
source_dir = Path("./monthly_reports")
archive_base = Path("./archived_by_dept")

# 确保归档根目录存在
archive_base.mkdir(exist_ok=True)

# 遍历源目录下所有的 xlsx 文件
for file_path in source_dir.glob("*.xlsx"):
    parts = file_path.stem.split("_")
    if len(parts) >= 2:
        dept_name = parts[1]  # 提取部门标识,如 "市场部"
        target_dept_dir = archive_base / dept_name
        target_dept_dir.mkdir(exist_ok=True)

        # 移动文件至对应部门目录下
        shutil.move(str(file_path), str(target_dept_dir / file_path.name))
print(f"已归档: {file_path.name} -> {target_dept_dir}")执行前:
monthly_reports/202610_研发部_支出.xlsx, 202610_市场部_预算.xlsx 杂乱平铺。执行后:自动生成
archived_by_dept/研发部/ 与 archived_by_dept/市场部/,各文件准确归类到位,总耗时小于 0.2 秒。
2. 多张 Excel 工作表(Sheet)与独立文件批量合并
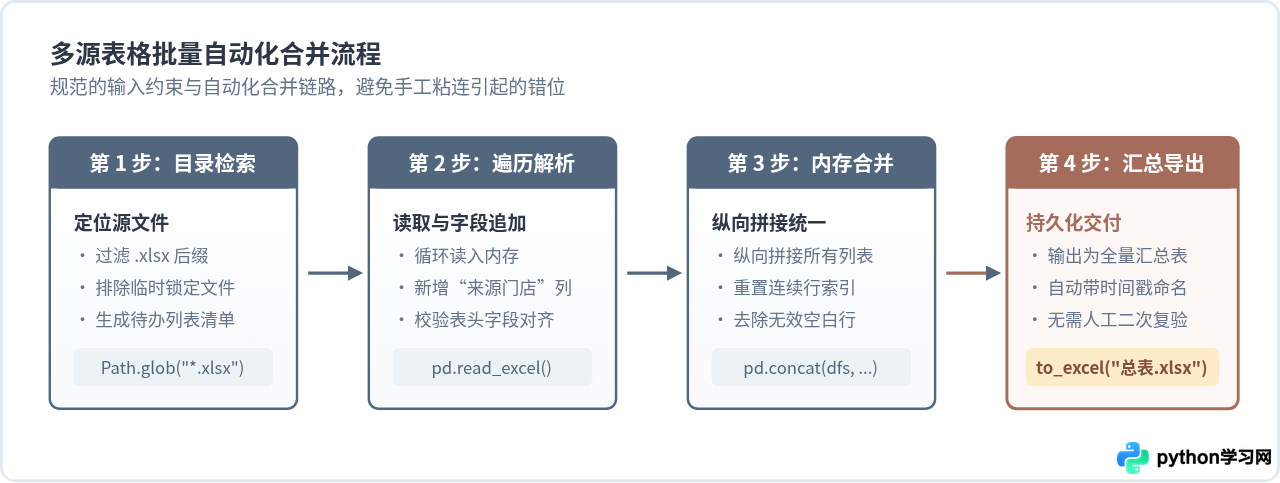
每个月末从各个分公司或门店收集上来的销售表格,结构完全相同(如列名均为“日期”、“产品”、“销售额”),但分散在几十个工作簿中。过去需要逐个打开、全选复制、切换主表粘贴。在 Python 中,结合 pandas 库只需读取并串联列表即可完成。
import pandas as pd
from pathlib import Path

data_folder = Path("./branch_sales")
all_records = []

# 遍历所有门店的数据表
for file_path in data_folder.glob("*.xlsx"):
    # 忽略临时文件(如以 ~$ 开头的缓存文件)
    if file_path.name.startswith("~$"):
        continue

    # 读取单表
    df = pd.read_excel(file_path)
    # 为数据追加一列“来源文件”,便于后续追溯责任门店
    df["门店名称"] = file_path.stem
    all_records.append(df)

# 将内存中的所有数据框垂直合并为一个整体
if all_records:
    final_report = pd.concat(all_records, ignore_index=True)
    final_report.to_excel("./全国销售总表_自动合并.xlsx", index=False)
    print(f"合并完成!共汇总 {len(final_report)} 条销售记录。")
else:
    print("未在目标文件夹内找到符合条件的 Excel 文件。")
这段代码仅约 20 行,却能直接接管以往需要反复开启数十次 Excel 软件的高负荷操作。无论文件从 5 个增至 50 个,执行时间仅在几秒内波动,且规避了手动复制时容易发生的跳行或错列风险。
三、核心场景二:轻量数据分析(从脏数据到业务透视)
在完成数据搜集后,零基础学习者的第二个关键落地场景是业务指标统计与轻量分析。很多人容易将“数据分析”与复杂的回归方程、机器学习算法混淆,但企业日常业务中最核心的需求,往往是搞清楚“哪类商品贡献了最高利润”、“哪个区域上周环比下跌”、“异常缺失数据分布在哪里”。
以下是一个完整的轻量级数据分析入门示例。代码模拟对一份包含缺失值、未规范日期与多品类的订单记录进行快速汇总与指标提炼:
import pandas as pd

# 1. 模拟读取原始销售数据
raw_data = {
    "订单日期": ["2026-10-01", "2026-10-01", "2026-10-02", "2026-10-03", None],
    "产品大类": ["办公设备", "数码耗材", "办公设备", "数码耗材", "办公设备"],
    "销售单价": [1200, 85, 2400, 120, 950],
    "销售数量": [3, 20, 2, 15, None],
}
df = pd.DataFrame(raw_data)

# 2. 数据清洗阶段:剔除关键信息缺失的无效记录
df_clean = df.dropna(subset=["订单日期", "销售数量"]).copy()

# 格式转化与衍生计算
df_clean["销售数量"] = df_clean["销售数量"].astype(int)
df_clean["总销售额"] = df_clean["销售单价"] * df_clean["销售数量"]

# 3. 聚合分析:计算各产品大类的总销售额与平均单价
category_summary = df_clean.groupby("产品大类").agg(
    总成交额=("总销售额", "sum"),
    总销售量=("销售数量", "sum"),
    平均单价=("销售单价", "mean")
).reset_index()

# 4. 计算大类销售额占比
total_revenue = category_summary["总成交额"].sum()
category_summary["销售占比(%)"] = (
    category_summary["总成交额"] / total_revenue * 100
).round(2)

print("=== 业务汇总结果 ===")
print(category_summary)=== 业务汇总结果 ===
产品大类 总成交额 总销售量 平均单价 销售占比(%)
0 办公设备 8400 5 1800.0 81.55
1 数码耗材 1900 35 102.5 18.45四、零基础起步的最小知识集与避坑路径
很多初学者在入门阶段半途而废,最常见的原因是“学得过多、用得太晚”。在尚未写出一个真正解决手头问题的脚本之前,就被深奥的高级特性(如装饰器、类继承、元编程)劝退。事实上,支撑办公自动化与入门数据分析所需的语法知识非常有限。
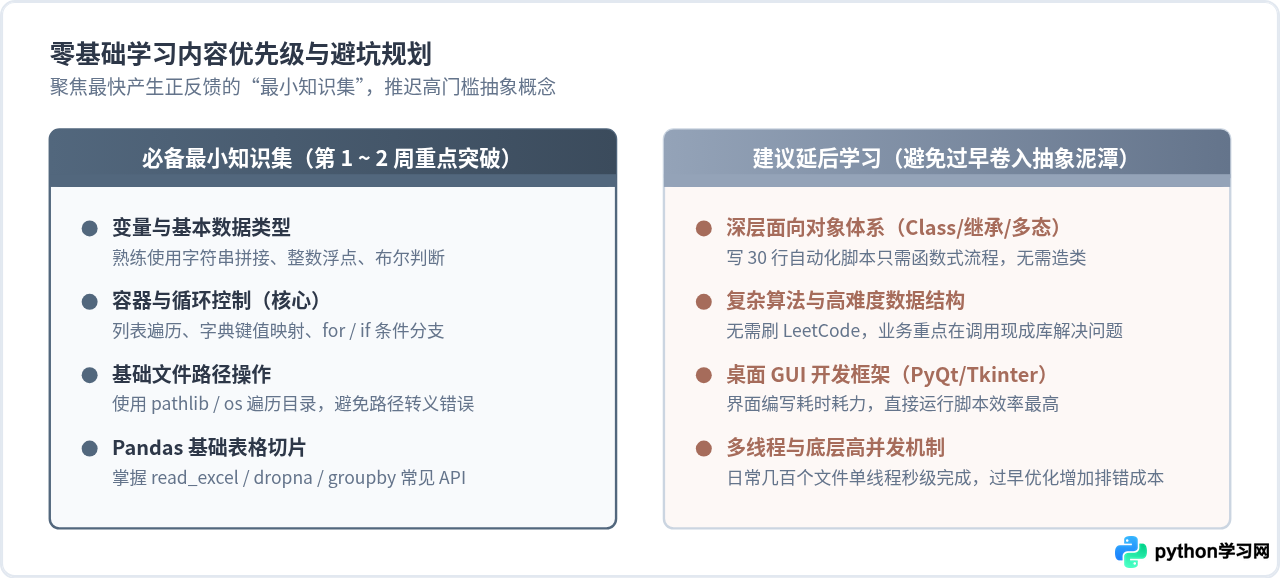
- 文件路径斜杠问题: Windows 系统默认使用反斜杠
\,在 Python 字符串中容易触发转义报错(如Path("C:/data/files")或在字符串前加原始标识r"C:\datailes"。 - 文件编码不匹配: 读取 CSV 或文本时,若遇到
UnicodeDecodeError,先检查文件是否为 Windows 常见的gbk编码,指定encoding="utf-8"或encoding="gbk"即可快速解决。
结语:让代码服务于具体工作
对于零基础学习者而言,Python 最核心的价值不在于“成为一名全职软件工程师”,而在于为你增加一把高效率的数字扳手。
当你遇到机械重复、枯燥易错的工作环节时,先不要急着点开鼠标一页页翻阅,试着用 for 循环将规则写下来,让计算机替你完成剩下的 99% 繁重劳动。以具体场景为导向,写出能跑通的小脚本,才是零基础掌握 Python 最稳固、最快获得回报的学习路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









