

Python for循环怎么设置步长或实现逆序遍历
全面讲解Python中for循环设置步长与实现逆序遍历的实用教程。涵盖range()函数三参数机制、负步长边界推导、reversed()与切片逆序对比及常见陷阱。
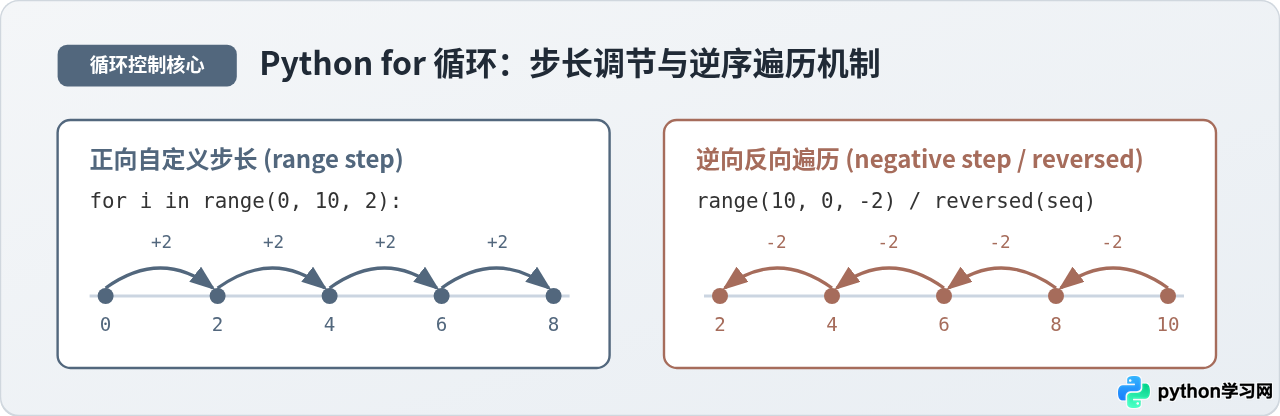
在 Python 中,for 循环本质上是一个迭代器驱动的遍历结构,它并不像 C 或 Java 等传统语言那样直接在循环头中暴露 i++ 或 i += step 计数器变量。如果你需要按特定步长跳跃循环(例如每隔 2 项执行一次),或者将遍历次序完全倒转过来,通常只需要根据场景使用两个核心工具:其一是内置的 range(start, stop, step) 函数,通过明确指定第三个参数控制递增或递减;其二是针对已有列表、元组或字符串等序列,直接调用反转迭代器 reversed() 或采用切片语法 seq[::-1]。本文将详细拆解这些语法的参数传递规则、边界推导方法、底层内存机制以及极易被忽视的边界陷阱。
一、使用 range() 设置正向自定义步长
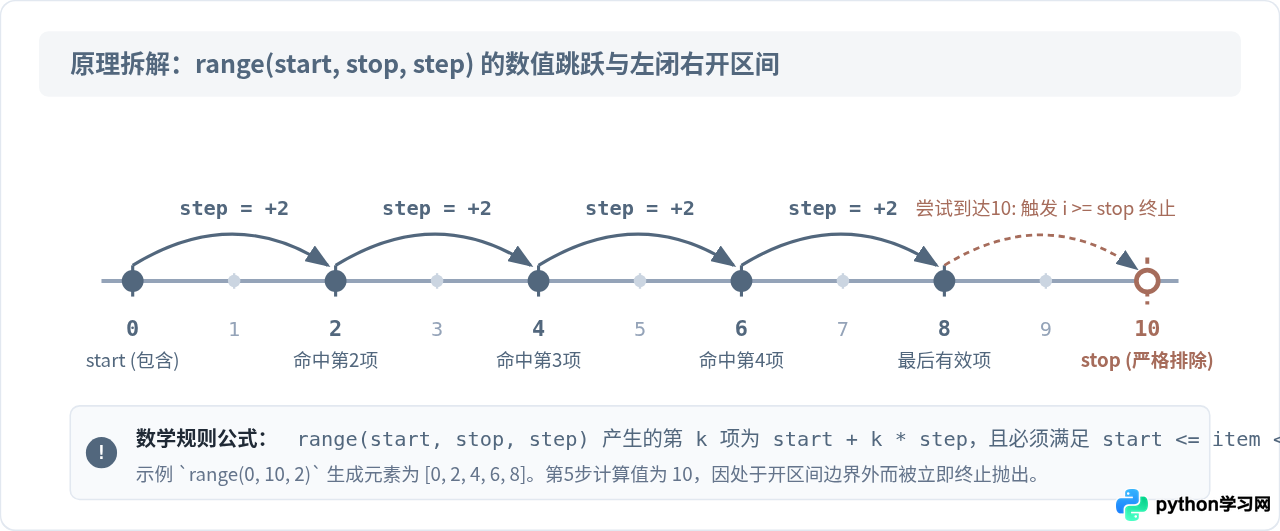
当需要按固定跨度生成数值序列时,最标准且高效的做法是使用内置的 range() 函数。range() 支持接收一到三个整数参数,当传入三个参数时,其签名格式为:
range(start, stop, step)这三个参数的定义如下:
- start(起始值):序列生成的第一个数值,该位置包含在结果中(闭区间)。若省略默认为
0。 - stop(终止界限):循环判断的边界数值,该位置绝不会被包含在结果中(开区间)。
- step(步长):每次递增或递减的差值。若省略默认为
1。
例如,我们需要遍历打印 0 到 10 之间的所有偶数(步长为 2):
# 示例代码:正向步长设置
for i in range(0, 10, 2):
    print(i, end=" ")

# 示例输出:
# 0 2 4 6 8
这段代码中,循环从 0 开始,每次将当前值递增 2,依次生成 0, 2, 4, 6, 8。当计算到 10 时,由于已经触及右开区间上限 stop,迭代直接终止,因此数值 10 并不会输出。
1. step 不能为 0:调用 range(0, 10, 0) 会立刻抛出 ValueError: range() arg 3 must not be zero 异常。
2. 只支持整数:range() 不接受浮点数(如 0.5)。如需生成小数步长,请使用生成器函数或第三方科学计算库 numpy.arange()。
二、设置负数步长实现逆序倒数
要让 range() 实现逆序遍历,只需将 step 设置为负整数(如 -1 或 -2)。但在设置负步长时,必须同时满足一个前提条件:起始值 start 必须严格大于终止值 stop。如果方向矛盾(例如 range(0, 10, -1)),Python 不会报错,但会直接返回一个空序列,导致循环体一次都不执行。
1. 倒数到指定数值与终点边界推导
许多初学者在编写倒数循环时容易出现“边界少算一位”的失误。由于 range 始终遵循左闭右开原则,最终生成的最后一个元素是 stop - step,而不是 stop 本身。
# 场景:从 5 倒数到 1
for i in range(5, 0, -1):
    print(i, end=" ")

# 示例输出:
# 5 4 3 2 1

# 常见陷阱:如果想从 5 倒数到 0,很多初学者会写 range(5, 0, -1),导致漏掉 0!
# 正确写法必须将 stop 设为 -1:
for i in range(5, -1, -1):
    print(i, end=" ")

# 示例输出:
# 5 4 3 2 1 0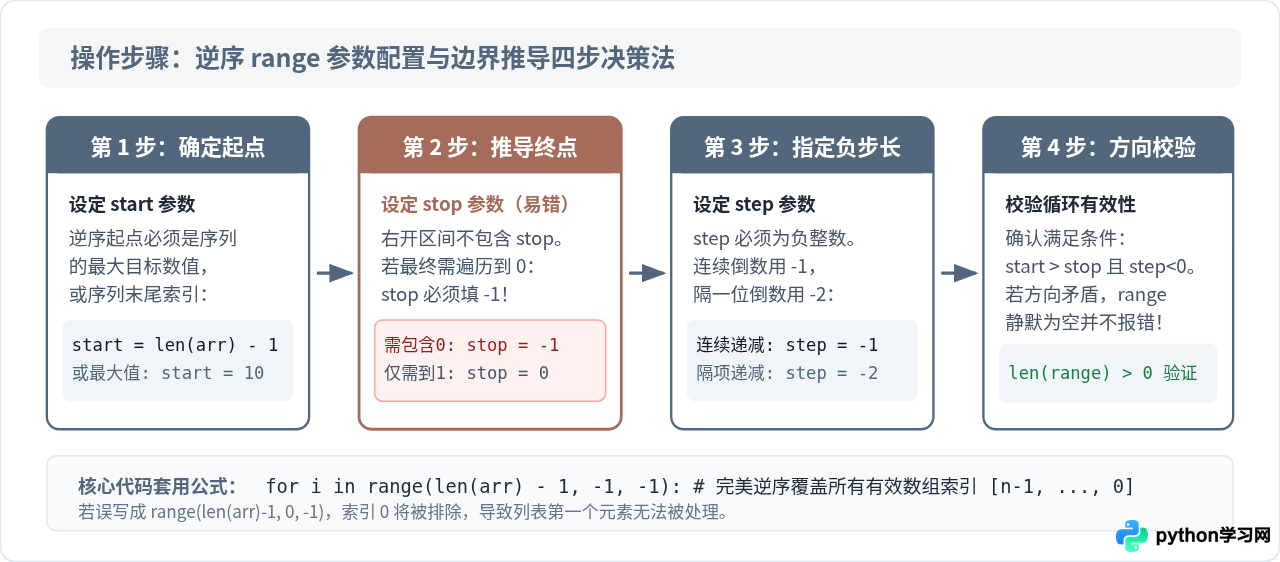
2. 结合索引对列表做逆序遍历
当需要通过下标逆序访问或修改列表中的元素时,可以通过列表长度 len(arr) 构造边界参数:
fruits = ["苹果", "香蕉", "橙子", "草莓"]

# 末尾元素的下标是 len(fruits) - 1
# 欲包含首个元素下标 0,stop 必须设置为 -1
for i in range(len(fruits) - 1, -1, -1):
    print(f"索引 {i} -> {fruits[i]}")

# 示例输出:
# 索引 3 -> 草莓
# 索引 2 -> 橙子
# 索引 1 -> 香蕉
# 索引 0 -> 苹果
三、已有序列的逆序遍历:reversed() 与切片对比
在日常开发中,更多时候我们面对的是一个已经填充好数据的序列(如 list、tuple、str),仅仅是希望从后向前逐项消费其中的内容。针对这种场景,手动计算 range 索引不仅繁琐,而且容易出错。Python 提供了更地道(Pythonic)的解法。
1. 首选方案:内置函数 reversed()
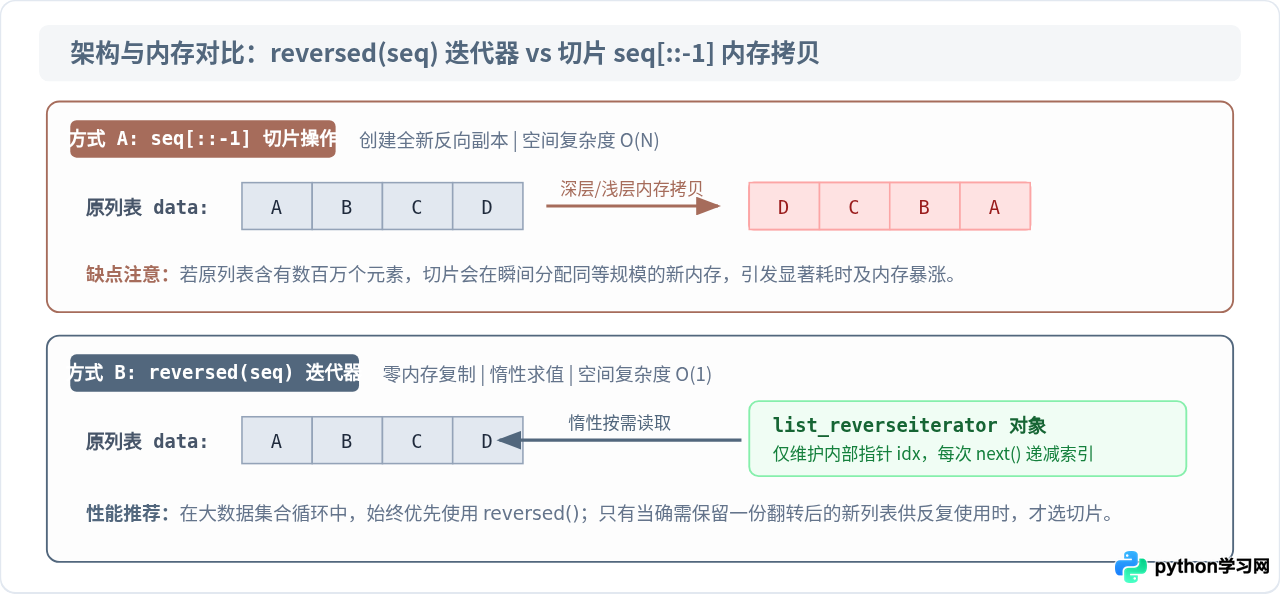
reversed() 接收一个具有固定长度且支持序列协议的对象(实现了 __reversed__() 或同时具备 __len__() 与 __getitem__()),返回一个反向迭代器。它不会在内存中生成新的列表拷贝,时间复杂度为 $O(1)$,内存空间占用几乎可以忽略。
letters = ["A", "B", "C", "D"]

for item in reversed(letters):
    print(item, end=" ")

# 示例输出:
# D C B A如果使用 reversed() 的同时需要序号,可以搭配 enumerate():for idx, item in enumerate(reversed(letters)):。此时 idx 代表迭代的步数(从 0 开始),item 代表倒序取出的元素。
2. 切片反转:seq[::-1]
切片是 Python 序列的独有语法,其三参数结构与 range 类似:sequence[start:stop:step]。当步长设为 -1 且省略首尾时,[::-1] 表示从序列末尾一直步进到序列开头:
# 使用切片逆序遍历
for item in letters[::-1]:
    print(item, end=" ")

# 示例输出:
# D C B A切片语法的优势在于极其简洁,且可以直接生成一个新的反转列表供后续多处复用。然而,切片的本质是在堆内存中完整拷贝出一份全新序列。如果原列表中存放着几十万甚至数百万条记录,一次切片就会瞬间占用翻倍的内存空间,并带来不必要的垃圾回收开销。
四、常见问题排查与高级用法
1. 需要浮点数(小数值)步长怎么办?
由于 range() 只接受整数,如果需要遍历浮点数区间(例如从 0.0 到 1.0,步长为 0.2),直接调用 range(0, 1, 0.2) 会抛出 TypeError: 'float' object cannot be interpreted as an integer。
对此常见有两种解决方案:
方案 A:整数换算(无需外部依赖)
# 需求:0.0 到 1.0,步长 0.2。共 5 步,放大 10 倍换算
for i in range(0, 11, 2):
    val = i / 10.0
    print(val, end=" ")

# 示例输出:
# 0.0 0.2 0.4 0.6 0.8 1.0
方案 B:编写轻量级浮点生成器
def float_range(start, stop, step):
    curr = start
    while (curr < stop if step > 0 else curr > stop):
        yield round(curr, 8)
        curr += step

for x in float_range(0.0, 1.0, 0.2):
    print(x, end=" ")
# 示例输出:
# 0.0 0.2 0.4 0.6 0.8
2. 在逆序遍历中删除原列表元素的陷阱
在正向 for item in list: 循环中,如果直接使用 list.remove() 删除当前元素,会导致底层索引位移,从而悄然跳过紧挨着的下一个元素。许多开发者会改用逆序遍历来避免这一现象,因为从后往前删除不会影响前面尚未处理的元素下标:
nums = [10, 20, 25, 30, 45, 50]

# 从后往前根据索引安全删除大于 20 的数值
for i in range(len(nums) - 1, -1, -1):
    if nums[i] > 20:
        del nums[i]

print(nums)
# 示例输出:
# [10, 20]
需要注意:使用 reversed(nums) 进行此操作依然不可行,因为迭代器在底层仍依赖列表下标,变动原列表结构同样可能导致逻辑异常。就地剔除元素的最佳途径依然是倒序索引遍历,或者更推荐的做法是采用列表推导式直接构建过滤后的新列表:nums = [x for x in nums if x <= 20]。
五、选型全景与使用建议
为了在实际编码中快速选择最合理的遍历语法,下表汇总了各种方案的核心特征:
| 遍历方式 | 适用场景 | 内存开销 | 是否包含右边界 | 推荐指数 |
|---|---|---|---|---|
range(start, stop, step) |
纯数值等差递增/递减、需要精准下标 | $O(1)$ 惰性求值 | 否(严格开区间) | ⭐⭐⭐⭐⭐ |
reversed(seq) |
已有序列直接逆序遍历、大数据量 | $O(1)$ 惰性迭代器 | 是(从最后一个元素到首项) | ⭐⭐⭐⭐⭐ |
seq[::-1] |
需要持久化一份逆向副本、小型序列快速切片 | $O(N)$ 产生新拷贝 | 是(完整序列反转) | ⭐⭐⭐ |
range(len(seq)-1, -1, -1) |
需要逆序下标同时就地修改原列表 | $O(1)$ 索引控制 | 包含首项索引 0 | ⭐⭐⭐⭐ |
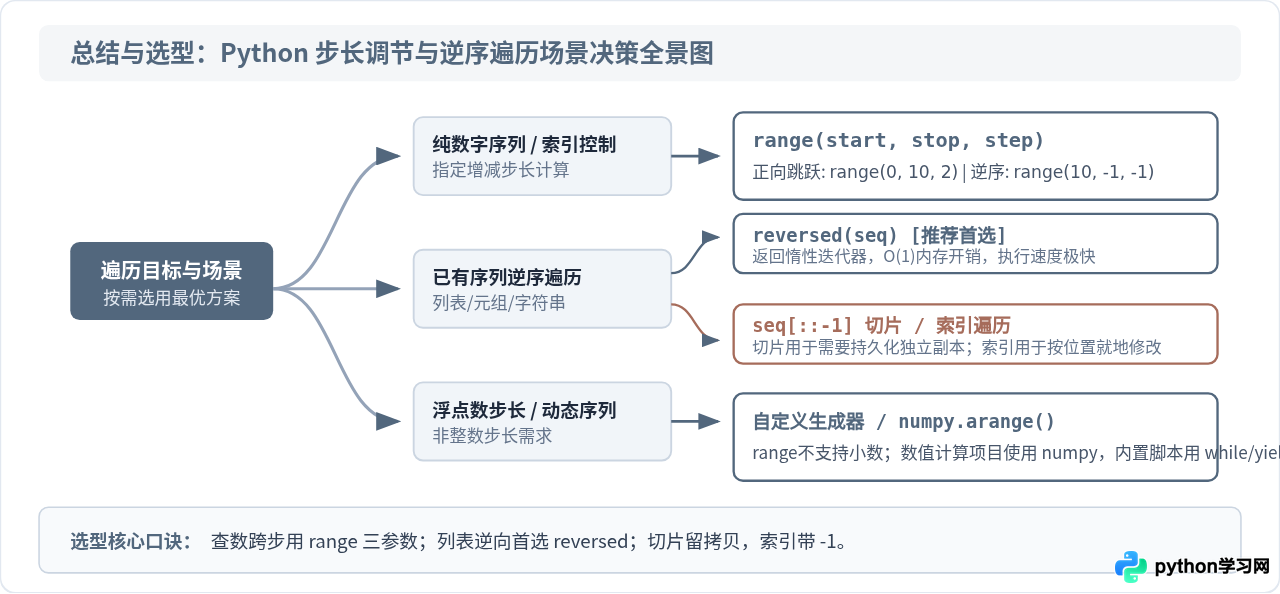
总结而言,在 Python 中处理循环步长或逆序,核心在于掌握 range() 的三参数规则和左闭右开逻辑。生成数列或索引优先依赖 range(start, stop, step);处理已有列表的逆序消费,坚决优先选用轻量无内存压力的 reversed()。只要牢记 stop 边界不包含在结果中,就能彻底规避绝大多数迭代偏移与边界越界错误。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









