

Python NumPy读取数据时怎么跳过指定行或列?
详细讲解在 Python 中使用 NumPy 读取文件数据时跳过指定表头、表尾、注释行以及排除特定列的方法。深入对比 np.loadtxt 与 np.genfromtxt 的参数差异与实战技巧。
在 Python 中使用 NumPy 加载纯文本、CSV 或 TSV 数据时,数据源经常包含不需要的元数据,例如顶部的标题行、末尾的统计签名、包含说明的注释行,或者中间某些冗余的数据列。跳过这些无用行列的核心方法是:跳过行使用 skiprows(跳过顶部行)、skip_footer(跳过底部行)或 comments(跳过注释行);跳过列则通过 usecols 参数指定只保留所需的有效列索引。针对不同结构的数据,通常选择 np.loadtxt 或容错性更强的 np.genfromtxt 完成读取。
一、函数选择:np.loadtxt 与 np.genfromtxt 的差异
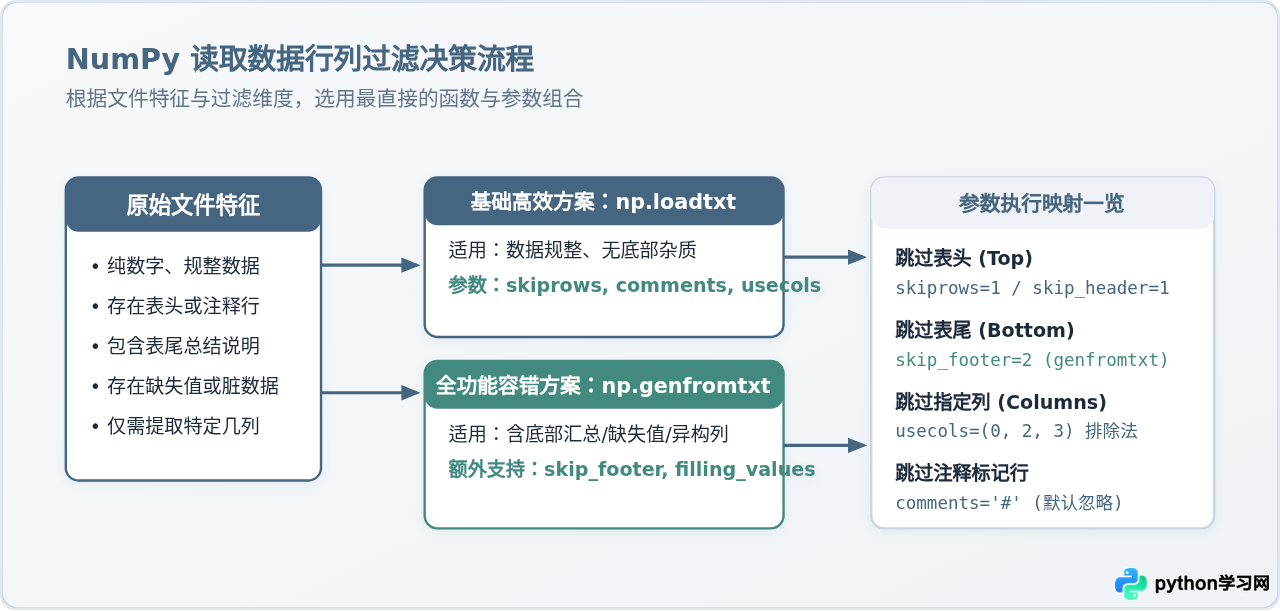
NumPy 提供了两个常用于加载平面文本(如 CSV、TXT)的函数:np.loadtxt 和 np.genfromtxt。在决定如何跳过行列前,需要根据文件特征挑选正确的函数:
| 功能特性 | np.loadtxt |
np.genfromtxt |
|---|---|---|
| 执行速度 | 更快,轻量级底层解析 | 稍慢,需两轮解析并构建掩码 |
| 跳过表头行 | 支持 skiprows=N |
支持 skip_header=N 或 skiprows=N |
| 跳过表尾行 | 不支持原生参数 | 支持 skip_footer=M |
| 指定/排除列 | 支持 usecols |
支持 usecols |
| 缺失值处理 | 遇到缺失直接报错抛出异常 | 自动转为 nan 或填充预设值 |
结论依据:若输入文件格式规范、仅需跳过前几行且文件较大,优先使用 np.loadtxt;若文件末尾带有统计信息、汇总文字或数据行中存在缺失值,必须使用 np.genfromtxt。
二、跳过指定“行”的实现方式
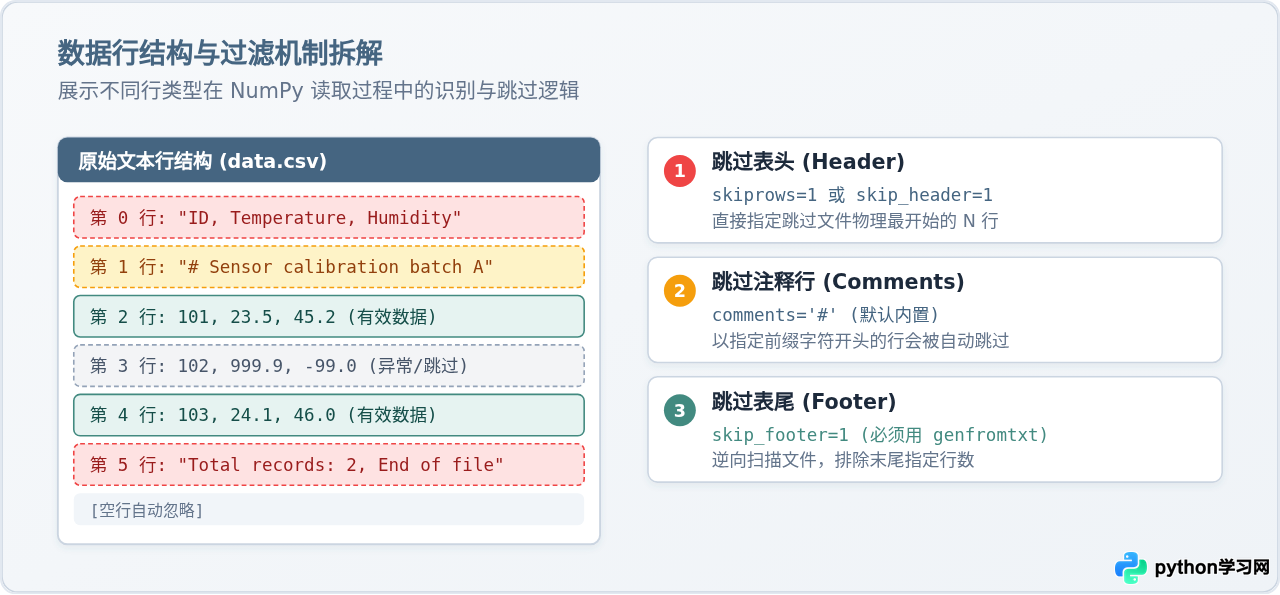
在日常数据清洗中,跳过行一般分为三种情况:跳过开头标题、跳过结尾备注、跳过带特殊符号的注释行,以及跳过中间任意非连续行。
1. 跳过前 N 行(表头列名)
如果文本第一行是列名(如 time,val1,val2),直接用 np.loadtxt 读取会导致字符串无法转为浮点数的类型错误(ValueError: could not convert string to float)。传入 skiprows=1 即可跳过第 1 行:
import numpy as np

# 跳过前 1 行(表头)
data = np.loadtxt('data.csv', delimiter=',', skiprows=1)
print("读取成功,数据形状:", data.shape)
在 np.genfromtxt 中,既可以使用 skiprows=1,也可以使用更明确的语义参数 skip_header=1:
# genfromtxt 中使用 skip_header
data = np.genfromtxt('data.csv', delimiter=',', skip_header=1)
2. 跳过末尾 M 行(表尾说明与统计)
如果文件尾部包含额外说明(例如由导出软件自动生成的汇总信息),np.loadtxt 原生并不提供直接忽略尾部的参数。此时必须切换至 np.genfromtxt,并设置 skip_footer:
# 跳过首行表头 (1行) 和末尾统计说明 (2行)
data = np.genfromtxt(
    'data.csv',
    delimiter=',',
    skip_header=1,
    skip_footer=2
)
当设置 skip_footer 时,NumPy 必须先通读整个文件确定总行数,无法在流式读取时提前截断。因此对于数 GB 级别的超大文本文件,解析时间会有所增加。
3. 跳过注释标记行与空行
默认情况下,np.loadtxt 与 np.genfromtxt 都会自动忽略以 # 开头的行以及纯空白行。如果文件采用其他字符作为注释标记(如 // 或 %),只需设置 comments 参数:
# 忽略以百分号开头的行
data = np.loadtxt('sensor.txt', delimiter=',', comments='%')
4. 跳过中间任意指定行(如第 3 行、第 7 行)
当需要跳过的数据位于文件中间、且没有注释符号标识时,NumPy 参数本身不支持传入非连续的行号列表。此时有两个实用方案:
方案 A(内存开销最低):使用 Python 生成器预先过滤
# 定义要跳过的物理行号(0-indexed)
skip_indices = {2, 5}

def filter_rows(filepath, skip_set):
    with open(filepath, 'r', encoding='utf-8') as f:
        for idx, line in enumerate(f):
            if idx not in skip_set:
                yield line

# 将生成器直接作为数据源传入 np.loadtxt
data = np.loadtxt(filter_rows('data.csv', skip_indices), delimiter=',')
方案 B:先完整读取,随后使用 np.delete 剔除行
# 适合文件不大且所有行均可被转换为统一数值类型时
raw_data = np.loadtxt('data.csv', delimiter=',', skiprows=1)

# 删除数组中的第 2 行和第 4 行 (axis=0 代表行维度)
clean_data = np.delete(raw_data, [2, 4], axis=0)
三、跳过指定“列”的实现方式
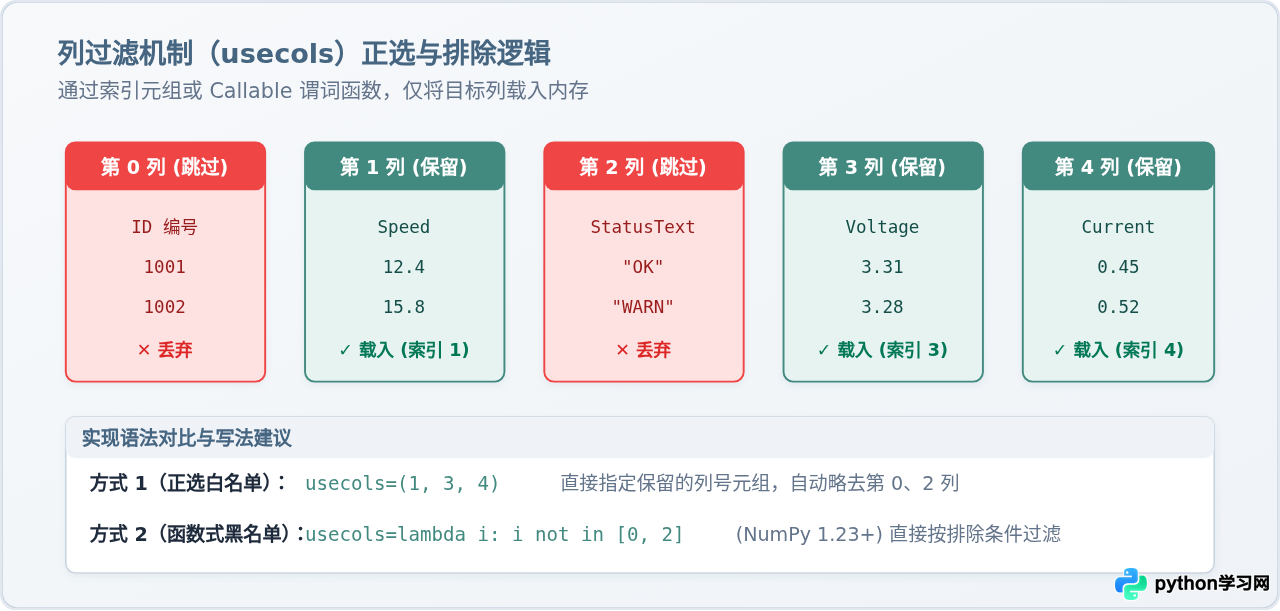
跳过列在数据处理中尤为普遍,例如去除自增 ID 列、时间字符串列或不参与计算的状态列。NumPy 采用的是通过 usecols 参数指定“需要保留哪些列”的正向选择逻辑(白名单模式)。
1. 静态白名单法:传入需要保留的列索引元组
假设文件中共有 5 列(索引为 0, 1, 2, 3, 4),若想跳过第 0 列和第 2 列,只需在 usecols 中填入 (1, 3, 4):
import numpy as np

# 仅保留第 1、3、4 列,自动跳过第 0、2 列
data = np.loadtxt('data.csv', delimiter=',', skiprows=1, usecols=(1, 3, 4))
print("加载后的数据列数:", data.shape[1])  # 输出 3 列
2. 动态黑名单法:已知总列数,反向剔除指定列
如果文件的列数较多(如 50 列),手动写出所有保留列十分繁琐。可以结合 Python 的列表推导式或集合操作动态生成保留列表:
total_columns = 10          # 假设总共有 10 列
drop_columns = {0, 4, 7}     # 需要跳过的列

# 动态计算需要保留的列索引列表
keep_columns = [i for i in range(total_columns) if i not in drop_columns]

data = np.loadtxt('data.csv', delimiter=',', skiprows=1, usecols=keep_columns)
3. NumPy 1.23+ 新特性:使用 Callable(可调用对象)直接排除
在较新的 NumPy 版本中,usecols 允许传入一个接受列索引(整数)并返回布尔值的函数。返回 True 表示保留,False 表示跳过:
# 利用 lambda 表达式直接定义“黑名单”
data = np.loadtxt(
    'data.csv',
    delimiter=',',
    skiprows=1,
    usecols=lambda col_idx: col_idx not in {0, 2}
)
当 usecols=(2,) 仅指定一列时,NumPy 默认会将结果降维成一维数组 (N,) 而非二维矩阵 (N, 1)。如果后续矩阵运算要求保持二维,请加上参数 ndmin=2。
四、综合实战示例:同时跳过指定行与列
我们以一个实际场景为例:假设存在一个名为 sensor_report.csv 的文件,其内容如下:
# 设备运行监测日志 (2026-10-31)
Timestamp,DeviceID,Voltage,Temperature,StatusNote,Current
160001,101,3.31,24.5,Normal,0.45
160002,101,3.29,24.8,Normal,0.46
160003,101,3.30,25.1,Normal,0.44
# 记录结束,操作员:SystemAdmin
End of transmission, Total: 3 records
需求分析:
- 跳过第 0 行标题说明(
# 设备运行监测日志会被自动按注释跳过,但需防范)。 - 跳过第 1 行 CSV 表头列名(
skip_header=1)。 - 跳过末尾 2 行结束统计说明(
skip_footer=2)。 - 排除第 0 列时间戳(无需进入特征)、第 1 列设备 ID、第 4 列状态文本字符串(避免触发类型转换报错)。
- 最终只保留第 2 列(电压)、第 3 列(温度)、第 5 列(电流)。
由于需要同时处理表尾文字与排除非数值字符串列,选择 np.genfromtxt:
import numpy as np

# 同时跳过表头、表尾与指定列
clean_matrix = np.genfromtxt(
    'sensor_report.csv',
    delimiter=',',
    skip_header=1,          # 跳过第 1 行字段名
    skip_footer=2,          # 跳过底部两行统计文字
    comments='#',           # 忽略 # 符号开头的行
    usecols=(2, 3, 5)       # 仅保留电压、温度、电流三列
)

print("处理后的纯净数值矩阵:")
print(clean_matrix)
print("矩阵形状 (行, 列):", clean_matrix.shape)
示例输出:
处理后的纯净数值矩阵:
[[ 3.31 24.5   0.45]
 [ 3.29 24.8   0.46]
 [ 3.3  25.1   0.44]]
矩阵形状 (行, 列): (3, 3)
五、常见问题排查与注意事项
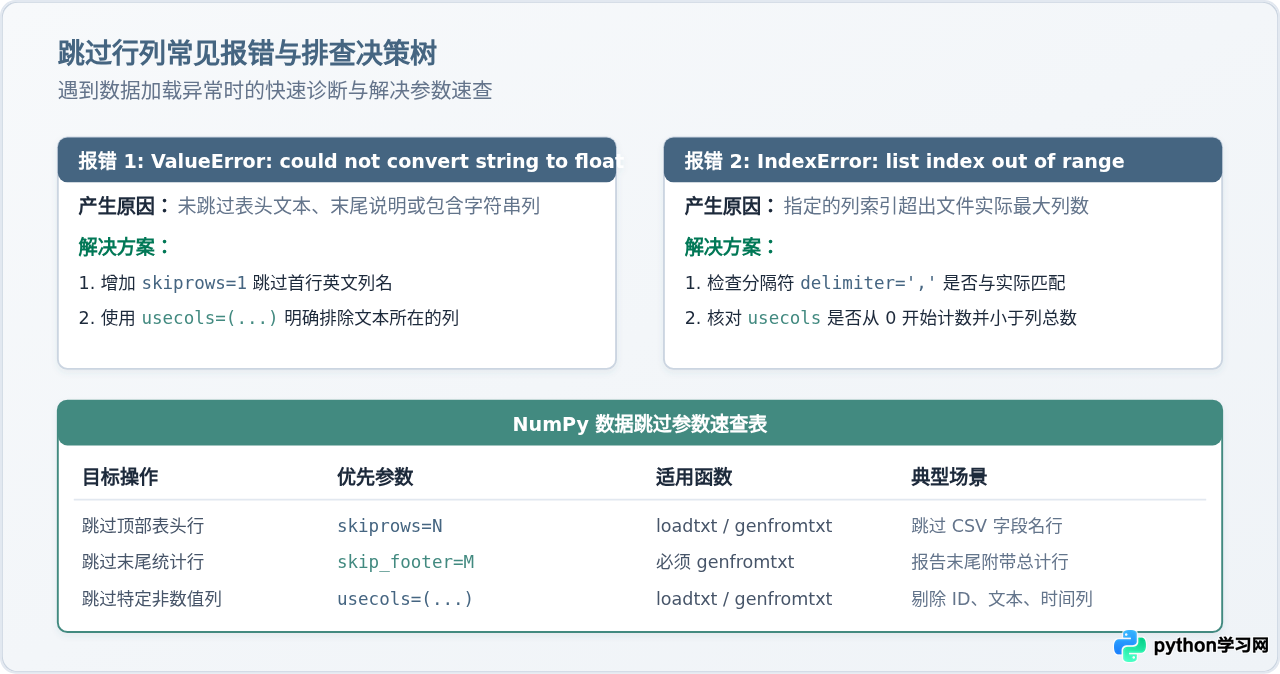
在实际运用上述参数时,有几个关键细节容易被忽略:
skiprows与comments的执行顺序:skiprows计数的是文件的物理绝对行号(从文件第 1 行算起)。而comments是在解析过程中动态过滤。如果文件前 2 行包含 1 行注释和 1 行字段名,设置skiprows=2会先跳过物理前 2 行,再对其后的行执行注释过滤。- 分隔符
delimiter的设置:默认情况下np.loadtxt以空白字符(空格或制表符)分割。如果是逗号分隔的 CSV,务必显式指定delimiter=','。若未指定分隔符,整行会被当成单列解析,导致usecols索引越界。 - 编码与特殊字符:如果被跳过的行中包含非 UTF-8 字符(如 Windows 导出的 GBK 编码),请显式加上
encoding='gbk'或encoding='utf-8',防止在跳过行之前就因底层解码失败而崩溃。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









