

Python递归与动态规划经典编程题精讲
深入浅出讲解Python递归与动态规划的演进过程。通过爬楼梯、零钱兑换、最长递增子序列及0-1背包等经典编程题,解析重叠子问题、最优子结构推导、四步解题法及空间优化技巧。
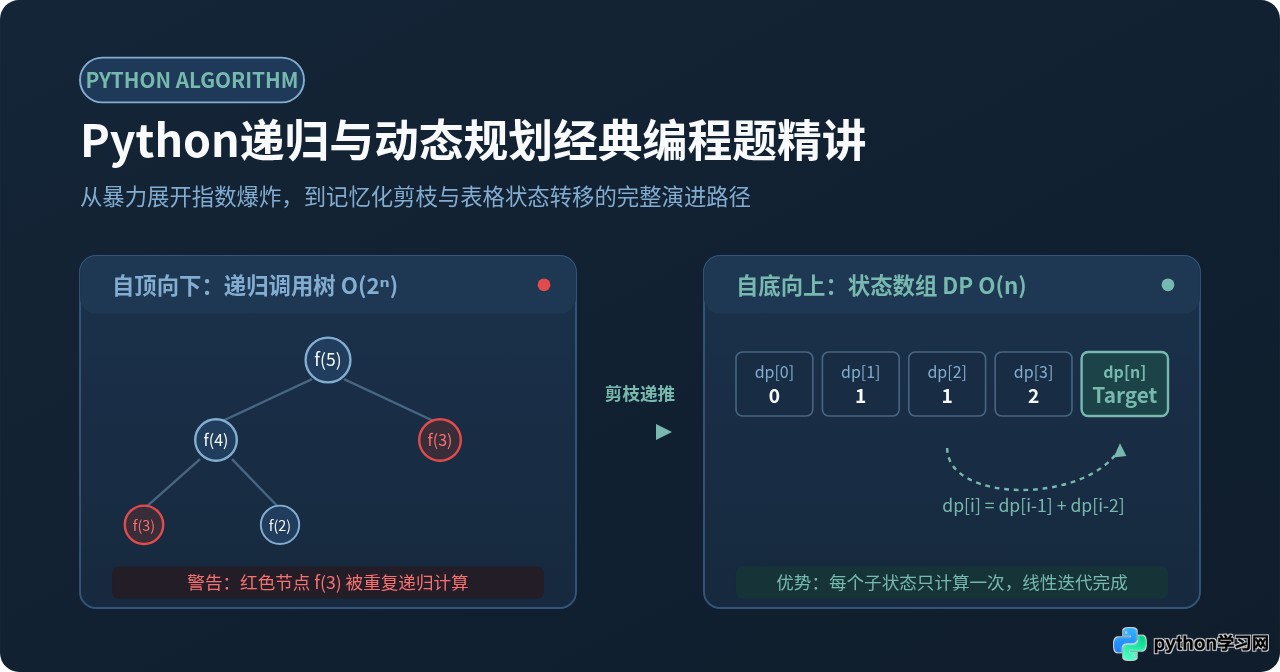
图示:Python算法解题中从指数级暴力递归到线性动态规划的演进全貌
假设你正在编写一段计算阶梯走法或斐波那契数列的程序:当输入数值为 20 时,纯递归函数只需几毫秒;但当输入增加到 45 时,程序窗口便陷入漫长的卡顿假死状态,CPU 占用率拉满却迟迟输出不了结果。这种现象的根源在于纯递归执行中产生了大量的重复子问题计算,函数调用树呈指数级膨胀。解决这一瓶颈的核心路径,就是通过记忆化搜索暂存中间成果,进而推演为动态规划(Dynamic Programming, DP)自底向上迭代递推。本文将结合经典编程题目,具体剖析从递归到动态规划的推导步骤、代码实现与时空优化技巧。
一、为什么递归会卡死:调用栈与重叠子问题剖析
递归本质上是将一个复杂的大问题拆解为形式相同的子问题,并通过函数自身调用自身来推进计算,最终在触达递归边界(Base Case)时逐层返回结果。递归代码直观优雅,符合人类的数学直觉,但当子问题之间存在重叠交集时,纯递归就会付出惨痛的性能代价。
以最基础的斐波那契数列定义 f(n) = f(n-1) + f(n-2) 为例,我们先观察未经任何优化的纯递归代码:
# 示例:未经优化的纯递归实现
def fib_naive(n: int) -> int:
    if n <= 0:
        return 0
    if n == 1:
        return 1
    return fib_naive(n - 1) + fib_naive(n - 2)

# 当 n = 40 时,函数调用次数将突破 3 亿次,耗时极长
当调用 fib_naive(5) 时,其内部函数调用展开过程如图 1 所示。我们可以清晰地看到计算冗余的发生过程:
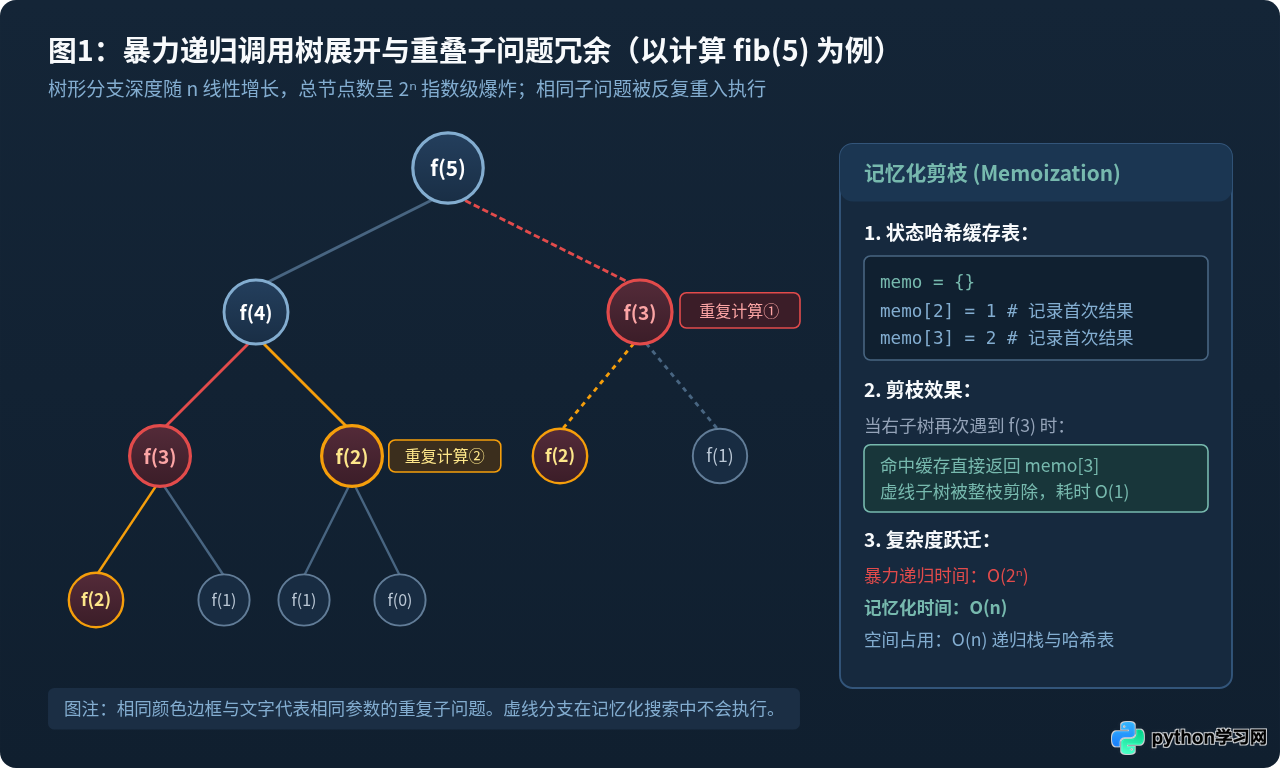
图1:暴力递归调用树展开与重叠子问题冗余(以计算 fib(5) 为例)
在图 1 的调用树中,左子树计算 fib(4) 时已经完整求解了 fib(3) 和 fib(2) 的值;但右子树在计算 fib(3) 时,由于程序没有记忆历史结果,不得不把 fib(2) 和 fib(1) 重新计算一遍。对于整个深度为 n 的完全二叉树,其总节点数规模达到 O(2ⁿ)。这种“重叠子问题(Overlapping Subproblems)”在递归树中呈几何级数蔓延,导致程序遭遇指数爆炸。
二、记忆化搜索:自顶向下的剪枝跨越
消除冗余最直接的想法是:给计算过程增加一个备忘录(Cache)。当首次求得某个子问题的解时,将其记录在哈希表或数组中;后续调用时先查表,若结果已存在则直接返回 O(1) 缓存值,避免重复深挖递归分支。这就是自顶向下的记忆化搜索(Memoization)。
在 Python 中,我们可以手动使用字典维护缓存,也可以利用标准库 functools.lru_cache 装饰器优雅实现:
from functools import lru_cache

# 方案 A:手动维护备忘录字典
def fib_memo(n: int, memo: dict = None) -> int:
    if memo is None:
        memo = {}
    if n <= 0:
        return 0
    if n == 1:
        return 1
    if n in memo:
        return memo[n]  # 命中缓存,O(1) 立即返回

    # 未命中时计算并记录
    memo[n] = fib_memo(n - 1, memo) + fib_memo(n - 2, memo)
    return memo[n]

# 方案 B:使用 Python 内置 lru_cache 自动缓存
@lru_cache(maxsize=None)
def fib_cached(n: int) -> int:
    if n <= 0:
        return 0
    if n == 1:
        return 1
    return fib_cached(n - 1) + fib_cached(n - 2)
效果对比:通过记忆化剪枝,原本需要 3 亿多次调用的 n = 40 场景,被骤降至仅需计算 40 个独立子问题。时间复杂度从 O(2ⁿ) 跃升为线性的 O(n)。
三、解题方法论:动态规划推导四步体系
记忆化搜索虽然解决了时间效率问题,但其底层仍然依赖递归调用。在 Python 中,默认最大调用栈深度通常为 1000 左右(由 sys.getrecursionlimit() 决定)。当数据规模达到数千或数万时,程序会直接抛出 RecursionError: maximum recursion depth exceeded。此时,我们需要脱离递归栈,转为自底向上的动态规划(Dynamic Programming)。
面对动态规划题目,切忌不假思索直接写两重循环,必须严格遵循以下四步推导逻辑闭环:
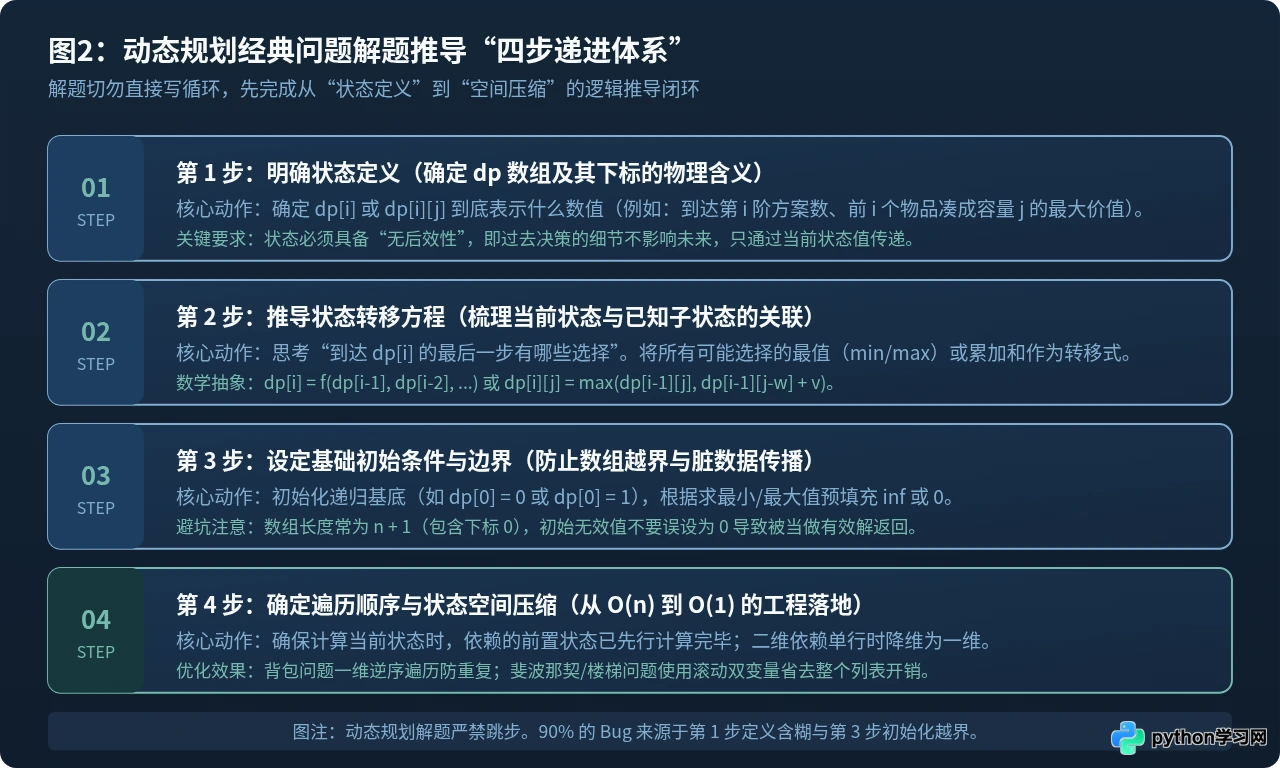
图2:动态规划经典问题解题推导“四步递进体系”
- 明确状态定义:用清晰的数学语言描述
dp[i]或dp[i][j]存储的具体物理量。例如:“dp[i]表示凑齐金额i所需的最少硬币枚数”。如果状态定义模糊,后续所有的转移推导都将失去基准。 - 建立状态转移方程:分析达到当前状态
dp[i]的最后一步决策来源,根据问题性质对前置子状态取极值(min/max)或求和。 - 确立边界与初始化:界定最基础情况(如
dp[0]的取值),防止数组越界。若求最小值,其余位置应预填充正无穷大float('inf');若求最大值,则填充 0 或负无穷。 - 确定遍历方向与空间压缩:观察状态转移依赖的前置状态位置(例如仅依赖相邻前一项或上一行数据),通过滚动变量将
O(n)空间压缩至O(1),或将O(n×W)二维表格压缩至O(W)一维数组。
四、经典编程题精讲与代码演进
1. 爬楼梯问题(一维线性递推与状态压缩)
题目描述:假设你正在爬楼梯。需要 n 阶你才能到达楼顶。每次你可以爬 1 个或 2 个台阶。你有多少种不同的方法可以爬到楼顶?
推导过程:
- 状态定义:设
dp[i]为到达第i阶楼梯的方法总数。 - 转移方程:到达第
i阶只有两种可能:从第i-1阶跨 1 步上来,或者从第i-2阶跨 2 步上来。故dp[i] = dp[i-1] + dp[i-2]。 - 边界条件:
dp[1] = 1(1阶只有1种走法),dp[2] = 2(2阶有1+1或直接走2阶共2种走法)。 - 空间压缩:计算
dp[i]仅需前两项的值,无需开辟长度为n+1的列表,维护两个局部滚动变量即可将辅助空间降为O(1)。
def climb_stairs(n: int) -> int:
    if n <= 2:
        return n

    # 空间优化版本:滚动变量代替数组
    prev2, prev1 = 1, 2
    for _ in range(3, n + 1):
        curr = prev1 + prev2
        prev2 = prev1
        prev1 = curr

    return prev1

# 示例验证:
# 输入: n = 5
# 输出: 8 (走法:1+1+1+1+1, 1+1+1+2, 1+1+2+1, 1+2+1+1, 2+1+1+1, 1+2+2, 2+1+2, 2+2+1)
2. 零钱兑换(Coin Change:最值型转移与有效性判定)
题目描述:给你一个整数数组 coins 表示不同面额的硬币,以及一个整数 amount 表示总金额。请计算并返回凑成总金额所需的最少硬币数。如果无法凑出,则返回 -1。每种硬币数量无限。
推导过程:
- 状态定义:设
dp[i]表示凑成金额i所需的最少硬币数量。 - 转移方程:考虑最后一枚放入的硬币面值为
coin,则之前需凑齐的金额为i - coin。我们枚举所有硬币:
dp[i] = min(dp[i - coin] + 1),其中需满足i >= coin。 - 初始化:金额 0 需 0 枚硬币,即
dp[0] = 0。由于求最小值,其余dp[1...amount]初始化为一个不可能达到的极大值(如float('inf')或amount + 1)。
from typing import List

def coin_change(coins: List[int], amount: int) -> int:
    # dp 数组长度为 amount + 1,初始化为正无穷
    dp = [float('inf')] * (amount + 1)
    dp[0] = 0  # 凑成金额 0 需 0 枚硬币

    for i in range(1, amount + 1):
        for coin in coins:
            if i - coin >= 0:
                dp[i] = min(dp[i], dp[i - coin] + 1)

    # 若依然为初始无穷大,说明无法凑成,按题意返回 -1
    return dp[amount] if dp[amount] != float('inf') else -1

# 示例验证:
# coins = [1, 2, 5], amount = 11
# dp 逐步计算: dp[1]=1, dp[2]=1, dp[5]=1, dp[10]=2, dp[11]=dp[6]+1=dp[10]+1=3 (5+5+1)
3. 最长递增子序列(LIS:单序列状态依赖与双层循环)
题目描述:给你一个整数数组 nums,找到其中最长严格递增子序列的长度(子序列不要求在原数组中连续)。
推导过程:
- 状态定义:设
dp[i]表示以第i个元素nums[i]结尾的最长递增子序列长度。 - 转移方程:遍历
i之前的所有位置j (0 <= j < i),若nums[i] > nums[j],说明nums[i]可以接在nums[j]的子序列之后形成更长的递增序列:
dp[i] = max(dp[i], dp[j] + 1)。 - 初始化:每个元素自身单独构成一个长度为 1 的子序列,故
dp数组所有元素初始化为 1。 - 最终结果:最长递增子序列的结尾不一定在末尾,需取全数组的最大值
max(dp)。
def length_of_lis(nums: List[int]) -> int:
    if not nums:
        return 0

    n = len(nums)
    dp = [1] * n

    for i in range(1, n):
        for j in range(i):
            if nums[i] > nums[j]:
                dp[i] = max(dp[i], dp[j] + 1)

    return max(dp)

# 示例验证:
# nums = [10, 9, 2, 5, 3, 7, 101, 18]
# 最长递增子序列为 [2, 3, 7, 101] 或 [2, 5, 7, 101],长度返回 4
4. 0-1 背包问题(二维状态网格与逆序一维优化)
题目描述:有 N 件物品和一个容量为 W 的背包。第 i 件物品的重量是 wt[i],价值是 val[i]。每件物品只能使用一次。求解将哪些物品装入背包可使这些物品的重量总和不超过背包容量,且价值总和最大。
推导过程:
- 状态定义:设
dp[i][w]表示前i件物品在面对背包容量w时的最大总价值。 - 转移方程:对于第
i件物品,存在选或不选两种抉择:- 不放入:背包容量不变,价值继承自上一行,即
dp[i-1][w]; - 放入(前提 w >= wt[i-1]):消耗背包容量
wt[i-1],获得价值val[i-1],对应价值为dp[i-1][w - wt[i-1]] + val[i-1]。
dp[i][w] = max(dp[i-1][w], dp[i-1][w - wt[i-1]] + val[i-1])。 - 不放入:背包容量不变,价值继承自上一行,即
二维填表推导过程与单元格依赖关系如图 3 所示:
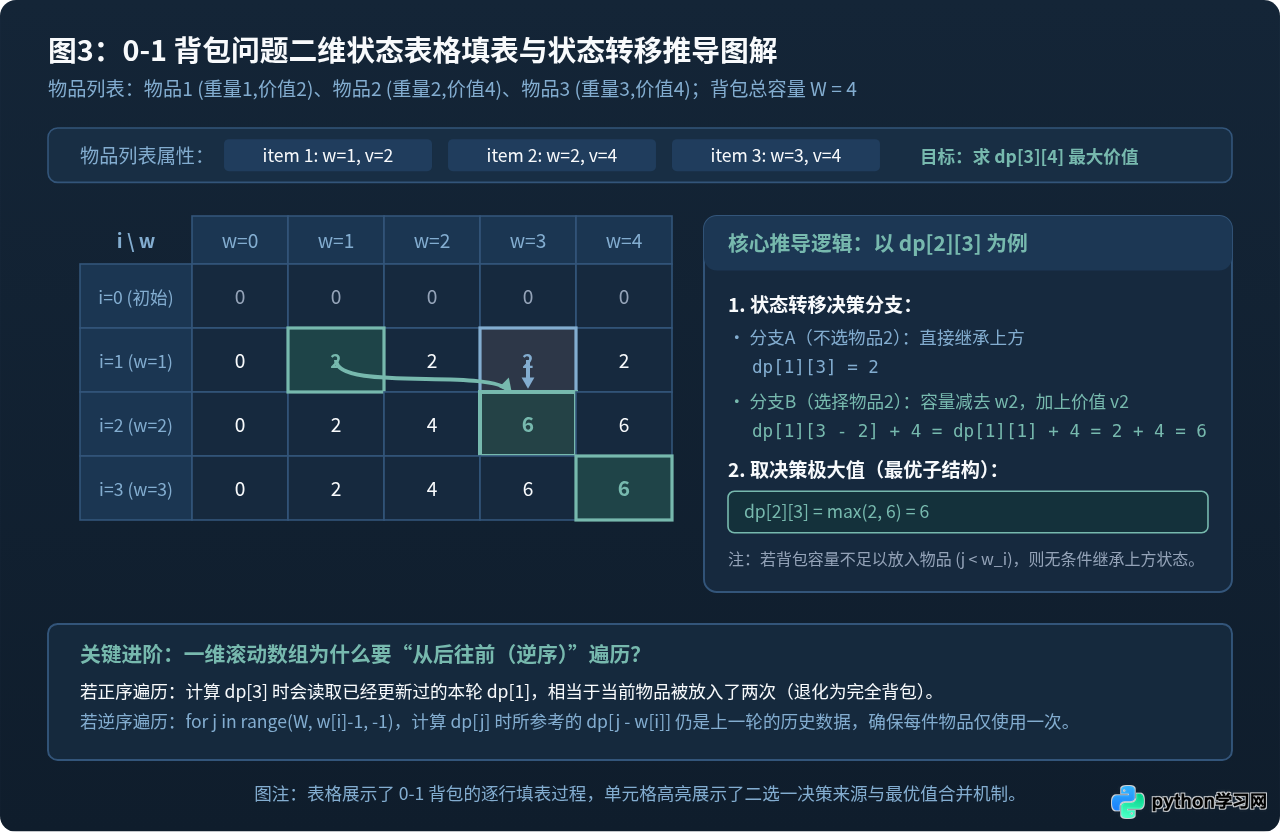
图3:0-1 背包问题二维状态表格填表与状态转移推导图解
观察图 3 可发现,计算第 i 行状态时,只需要参考上一行(第 i-1 行)的正上方单元格和左上方单元格。因此我们可以将二维表格压缩为一个一维数组 dp[w]。特别注意:在更新一维数组时,内层循环必须采用逆序(从 W 到 wt[i-1])遍历,以防止当前物品被重复计算多次。
def knapsack_01_optimized(weights: List[int], values: List[int], capacity: int) -> int:
    # 状态压缩:仅保留长度为 capacity + 1 的一维数组
    dp = [0] * (capacity + 1)
    n = len(weights)

    for i in range(n):
        w_cur = weights[i]
        v_cur = values[i]
        # 逆序遍历容量:确保读取的是上一件物品留下的历史值
        for w in range(capacity, w_cur - 1, -1):
            dp[w] = max(dp[w], dp[w - w_cur] + v_cur)

    return dp[capacity]

# 示例验证:
# weights = [1, 2, 3], values = [2, 4, 4], capacity = 4
# 返回值:6(选取重量为 1 和 2 的物品,总价值 2 + 4 = 6)
五、常见错误排查与编码防御要点
在实际编码中,很多同学虽然掌握了状态转移方程,但提交时往往遭遇各类型报错。以下是必须牢记的四类高频避坑清单:
避坑清单 1:数组大小开辟为 n 导致下标越界
由于动态规划需要表示“容量 0”或“第 0 阶”的初始状态,dp 数组的长度通常应开辟为 n + 1 而非 n。访问 dp[n] 时如果只开辟了 n 大小,必然触发 IndexError: list index out of range。
避坑清单 2:最值问题初始化误设为 0
求最小值(如零钱兑换)时,若将数组默认初始化为 0,在执行 min(dp[i], dp[i - c] + 1) 时,初始值 0 会直接吞没所有合法的正整数解,导致最终结果永远输出 0。初始化必须使用 float('inf'),并在最终返回时检查有效性。
避坑清单 3:背包一维化误用正序循环
0-1 背包如果写成 for w in range(w_cur, capacity + 1) 正序循环,那么在更新前面的 dp[1] 后,同一轮更新 dp[2] 时引用的就是刚被当前物品更新过的值,导致每件物品可以被无限次拾取(误写成了完全背包)。牢记:0-1背包用逆序,完全背包用正序。
防御建议 4:面对长递归链调整 Python 栈限制
若业务必须采用自顶向下的递归写法,且深度超过 1000 层,需在脚本开头显式提高调用栈限制:
import sys; sys.setrecursionlimit(200000)。但最稳健的做法依然是将代码改写为自底向上的迭代循环 DP。
六、算法演进全景与选型决策指南
为了让大家在算法面试与工程开发中快速做出最合理的架构选型,我们对纯递归、记忆化搜索、迭代 DP 以及空间压缩 DP 四种形态进行横向对照:
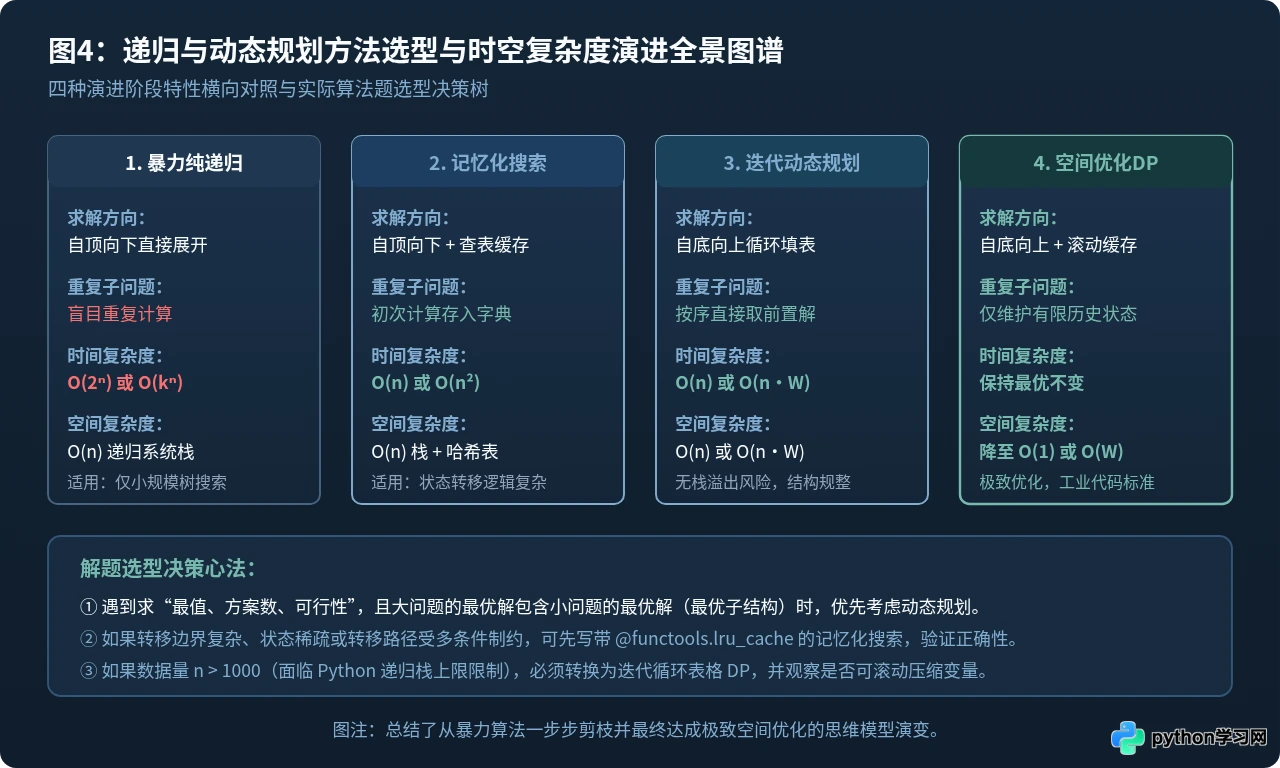
图4:递归与动态规划方法选型与时空复杂度演进全景图谱
| 算法阶段 | 执行逻辑 | 时间复杂度 | 空间复杂度 | 主要缺陷与适用场景 |
|---|---|---|---|---|
| 纯递归 | 自顶向下树状展开 | O(2ⁿ) 指数级 | O(n) 递归栈 | 存在严重重叠子问题冗余,仅适合小规模分治或无重叠场景。 |
| 记忆化搜索 | 自顶向下 + 备忘录缓存 | O(n) 线性 | O(n) 递归栈 + 哈希表 | 代码改动小,适合状态稀疏、分支复杂的场景;受限于递归栈深度。 |
| 迭代动态规划 | 自底向上表格递推 | O(n) 线性 | O(n) 数组分配 | 无递归栈溢出风险,逻辑严密,适合绝大多数中大型工程场景。 |
| 空间压缩 DP | 自底向上 + 滚动变量 | O(n) 保持最优 | 降至 O(1) 或 O(W) | 内存利用率最高,要求状态依赖关系具备局部性(如仅依赖前若干项)。 |
掌握动态规划的关键不在于死记硬背具体的模板代码,而在于建立严谨的状态抽象与递推拆解思维。只要按照“定义状态 → 建立方程 → 边界初始化 → 空间压缩”这套推导路径,由浅入深层层递进,即使面对形态各异的高难度算法题,也能抽丝剥茧、游刃有余地写出高效、健壮的 Python 解法。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









