

Python查找列表重复值的5种常用方法
详细解析Python中查找列表重复值的5种常用方法:collections.Counter计数、辅助双集合追踪、集合推导式结合count()、原生字典统计以及排序后相邻比对。包含代码实现、复杂度分析、保序与非哈希场景处理及选型决策指南。
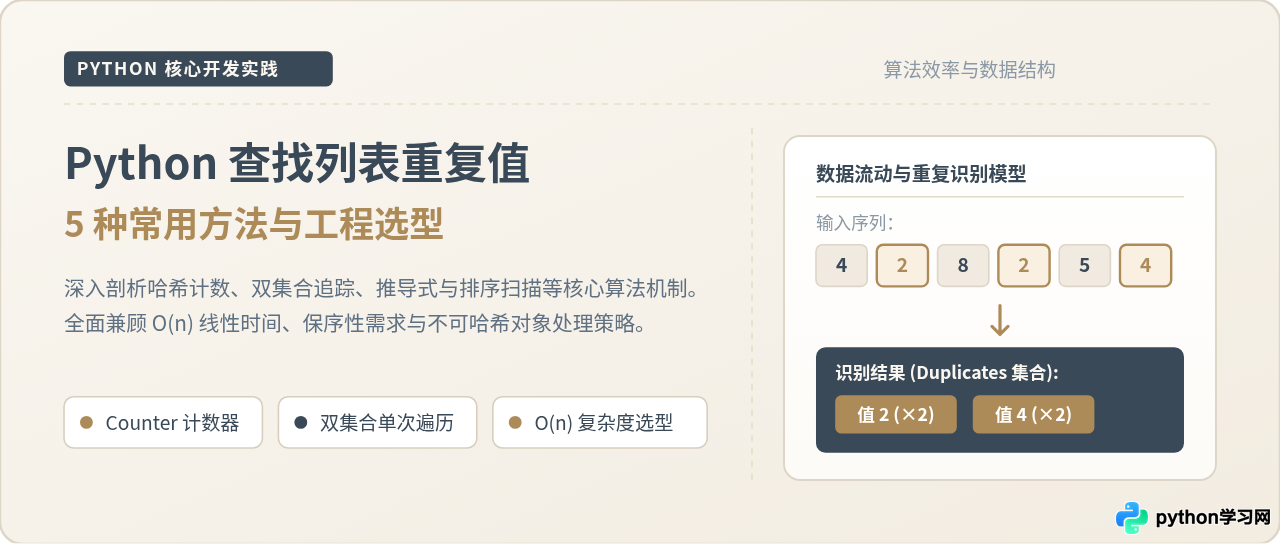
在 Python 开发与数据清洗流程中,查找列表中重复出现的元素是最高频的基础任务之一。解决该问题的关键并不在于写出一段能跑通的代码,而在于根据具体的工程约束——例如是否需要统计出现频次、是否需要严格保持元素初次出现的相对顺序,以及数据规模与复杂度上限——做出恰当的算法选型。本文直接介绍 5 种最实用的查找方法,拆解其实现代码、内部运行机理与边界特性,帮助你在实际项目中准确落地。
方法一:使用 collections.Counter 统计频次(标准库首选)
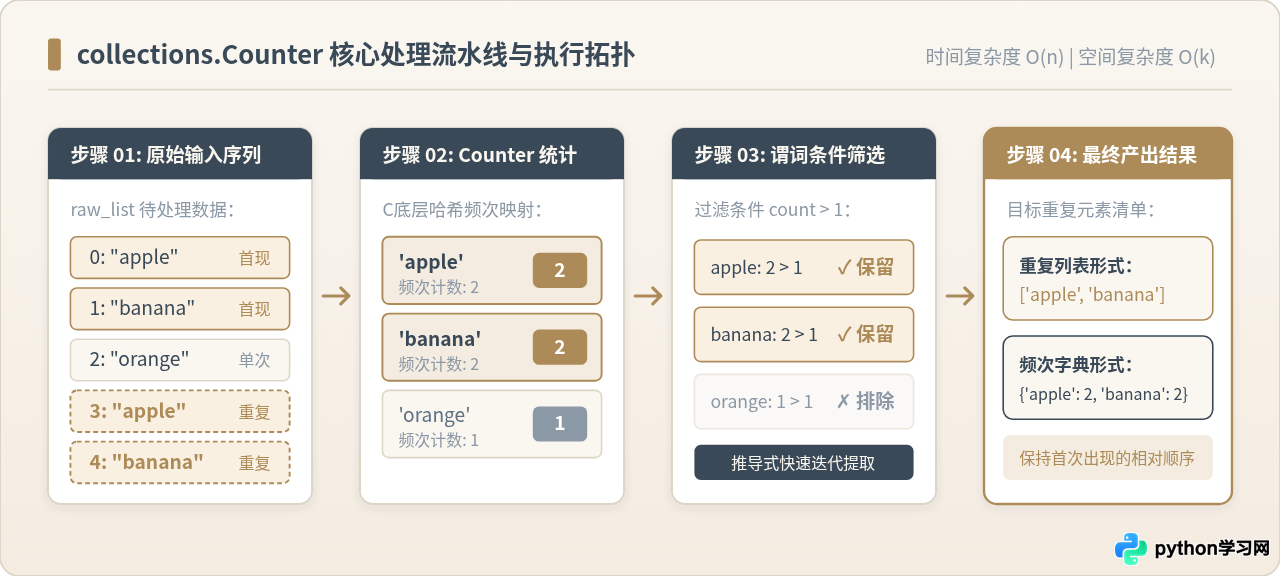
在标准库中,collections.Counter 是处理频次统计最自然、最地道的工具。Counter 是 dict 的子类,底层由 C 语言针对序列计数场景进行了深度优化。解决思路分为两步:首先将列表传入 Counter 完成全量哈希频次映射,随后使用列表推导式提取所有计数值大于 1 的键。
from collections import Counter

def find_duplicates_counter(lst):
    # 步骤1:基于哈希表构建频次分布
    counts = Counter(lst)
    # 步骤2:筛选频次大于1的键
    return [item for item, count in counts.items() if count > 1]

# 示例执行
sample_data = ['apple', 'banana', 'orange', 'apple', 'grape', 'banana', 'banana']
duplicates = find_duplicates_counter(sample_data)
print("检测到的重复元素列表:", duplicates)
如果业务场景不仅需要知道“哪些元素重复了”,还需要知道“分别重复了几次”,可以直接保留筛选后的键值对字典:
# 获取包含重复频次的字典信息
counts = Counter(sample_data)
duplicate_counts = {item: count for item, count in counts.items() if count > 1}
print("包含频次的统计结果:", duplicate_counts)
运行机理与复杂度分析:
该方法只需对输入序列扫描一次,构建哈希映射耗时 O(n);随后遍历容量为 k(唯一元素数,k ≤ n)的字典进行推导,耗时 O(k)。整体时间复杂度为严格的线性阶 O(n)。由于 Python 3.7+ 的字典机制天然保持插入顺序,因此 counts.items() 会精确保持元素在原列表中首次出现的相对顺序。
方法二:辅助双集合单次遍历法(高效且支持保序)
在追求极致吞吐或流式处理的场景下,若无需统计具体的出现次数,仅需提取出重复元素的集合或序列,双集合单次遍历法(Seen & Duplicates)是执行效率极高且占用空间非常紧凑的做法。
其核心思想是维护一个记录“已出现元素”的集合 seen,并在遍历原列表时进行哈希判定。如果当前元素已经在 seen 中,说明它是一个重复值,将其收录到重复容器中;如果不在,则加入 seen。
def find_duplicates_seen(lst, preserve_order=True):
    seen = set()
    if preserve_order:
        duplicates = []
        dup_recorded = set()
        for item in lst:
            if item in seen:
                if item not in dup_recorded:
                    duplicates.append(item)
                    dup_recorded.add(item)
            else:
                seen.add(item)
        return duplicates
    else:
        duplicates = set()
        for item in lst:
            if item in seen:
                duplicates.add(item)
            else:
                seen.add(item)
        return list(duplicates)

# 示例执行
sample_numbers = [10, 20, 30, 20, 40, 10, 50, 20]
ordered_dups = find_duplicates_seen(sample_numbers, preserve_order=True)
print("保序提取的重复元素:", ordered_dups)
关键转折与优势:
为什么需要 dup_recorded 集合?如果直接在判定为重复时向 duplicates 列表执行 append,那么当某个数字(如 20)出现 3 次时,duplicates 列表中就会记录两次 20。引入辅助集合 dup_recorded 可以在 O(1) 时间内过滤后续多余的重复记录,确保每个重复项在最终列表中仅保留一份,同时保持原列表中的先后出现顺序。
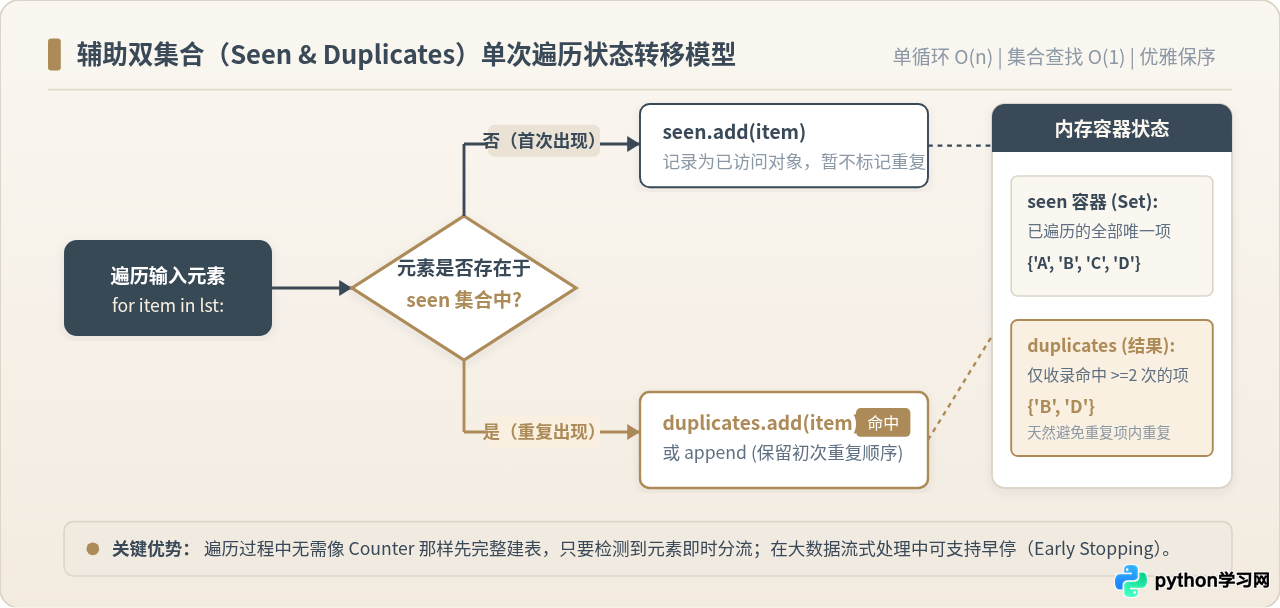
与 Counter 相比,双集合单次遍历支持提前中止(Early Exit)。例如当你仅需要判断“列表中是否存在任何重复值”时,一旦 item in seen 条件触发,即可直接 return True,无需像 Counter 那样等待全量数据完全统计完毕。
方法三:集合去重结合 list.count() 推导式(极简语法与性能陷阱)
在许多初学者编写的代码或快速调试脚本中,经常能看到利用 set(lst) 消除重复后,再配合列表推导式与 lst.count() 的单行实现。这种写法语法极度精炼:
def find_duplicates_count(lst):
    # 警告:仅适用于数据量极小的场景(如 n < 500)
    return [item for item in set(lst) if lst.count(item) > 1]

# 示例执行
chars = ['a', 'b', 'c', 'a', 'b', 'd']
print("推导式筛选结果:", find_duplicates_count(chars))
尽管这行代码非常简短,但在生产环境中处理中大型数据时严禁使用。
原因在于:lst.count(item) 本身是对原列表做一次全量线性遍历(耗时 O(n))。推导式外层由 set(lst) 驱动,假设列表有 k 个唯一元素,推导式内部就会触发 k 次完整的线性扫描,总时间复杂度为 O(k × n)。在最差情况下(重复项较少,k ≈ n),算法复杂度直接恶化为 O(n²)。
实测数据:在长度为 100,000 的列表中,方法一和方法二耗时通常在 5~15 毫秒 之间,而 list.count() 推导式耗时将飙升至 15~30 秒,性能差距高达上千倍。
方法四:原生字典手动计数法(灵活定制与无依赖)
在无法或不希望使用 from collections import Counter 的受限环境(例如特定脚本沙箱),或者在计数过程中需要附加复杂业务动作时,使用原生 dict 配合 dict.get() 进行循环计数是最基础、最直观的写法。
def find_duplicates_dict(lst):
    counts = {}
    for item in lst:
        counts[item] = counts.get(item, 0) + 1
    # 提取频次大于1的所有项
    return [item for item, count in counts.items() if count > 1]

# 示例执行
sample_ids = ['ID_101', 'ID_102', 'ID_103', 'ID_101', 'ID_104', 'ID_102']
print("原生字典提取的重复项:", find_duplicates_dict(sample_ids))
工程扩展场景: 原生字典方法的价值在于可塑性极高。例如你不仅需要记录重复值,还希望一并记录每个重复值在原始列表中出现的所有索引下标(Index Positions),只需将字典的值由数字改为列表:
def find_duplicates_with_indices(lst):
    indices_map = {}
    for idx, item in enumerate(lst):
        indices_map.setdefault(item, []).append(idx)
    # 仅保留出现多次的元素及其全部出现位置
    return {item: idx_list for item, idx_list in indices_map.items() if len(idx_list) > 1}

# 示例执行
data = ['X', 'Y', 'Z', 'X', 'W', 'X']
print("重复项及出现位置坐标:", find_duplicates_with_indices(data))
方法五:排序后相邻元素比对法(针对已排序数据或内存极限优化)
前述方法均依赖哈希表(Hash Table)。构建哈希表需要将对象哈希化并开辟额外连续内存桶,在极端内存受限环境或海量数据分批处理中,哈希表的内存开销可能成为瓶颈。
如果数据源本身已经是有序的(例如按时间戳排列的日志),或者允许对原列表进行原地排序(lst.sort()),我们可以通过比对相邻元素来识别重复值,无需额外的全量字典空间。
def find_duplicates_sorted(lst):
    if len(lst) < 2:
        return []

    # 产生排序副本(若允许修改输入源,可直接使用 lst.sort() 实现原地处理)
    sorted_lst = sorted(lst)
    duplicates = []

    for i in range(len(sorted_lst) - 1):
        if sorted_lst[i] == sorted_lst[i + 1]:
            # 避免对同一连续重复项进行多次收录
            if not duplicates or duplicates[-1] != sorted_lst[i]:
                duplicates.append(sorted_lst[i])
    return duplicates

# 示例执行
scores = [88, 92, 75, 88, 95, 92, 88]
print("排序后比对提取的重复值:", find_duplicates_sorted(scores))
复杂度与适用条件:
- 时间复杂度:由排序步骤主导,Python 的 Timsort 算法在通用情况下为 O(n log n)。但如果输入列表已经是有序数据,则直接跳过排序步骤,仅需一次相邻扫描,时间复杂度仅为 O(n)。
- 空间复杂度:若采用原地排序
lst.sort(),额外辅助空间为 O(1)(不计输出结果容器)。 - 限制条件:列表中所有元素必须支持大小比较操作(实现
<操作符),且排序后原有的相对顺序被彻底打乱。
特殊场景补充:不可哈希元素(字典、子列表)的处理
当列表中存放的元素是 dict 或 list 等可变对象时,直接运行 set() 或 Counter() 会直接触发运行时异常:TypeError: unhashable type: 'dict'。
针对不可哈希对象的重复查找,工程上通常有两种标准解决方案:
-
转为不可变元组(适用于子列表):
若元素为列表,可在遍历前通过
tuple(x)转换为元组后再存入seen。 - 规范化 JSON 序列化(适用于字典): 将字典序列化为指定按键排序的 JSON 字符串,作为哈希键进行比对。
import json

def find_duplicate_dicts(dict_list):
    seen = set()
    duplicates = []
    for d in dict_list:
        # sort_keys=True 保证键序不同但内容相同的字典序列化结果一致
        serialized = json.dumps(d, sort_keys=True)
        if serialized in seen:
            if d not in duplicates:
                duplicates.append(d)
        else:
            seen.add(serialized)
    return duplicates

# 示例执行
users = [
    {"id": 1, "name": "Alice"},
    {"name": "Bob", "id": 2},
    {"id": 1, "name": "Alice"}  # 重复项
]
print("重复字典记录:", find_duplicate_dicts(users))
5种方法技术特性横向对比
为了更直观地把握各方法的优缺点与适用边界,下方全景矩阵将 5 种实现方式的核心技术指标汇总比对:
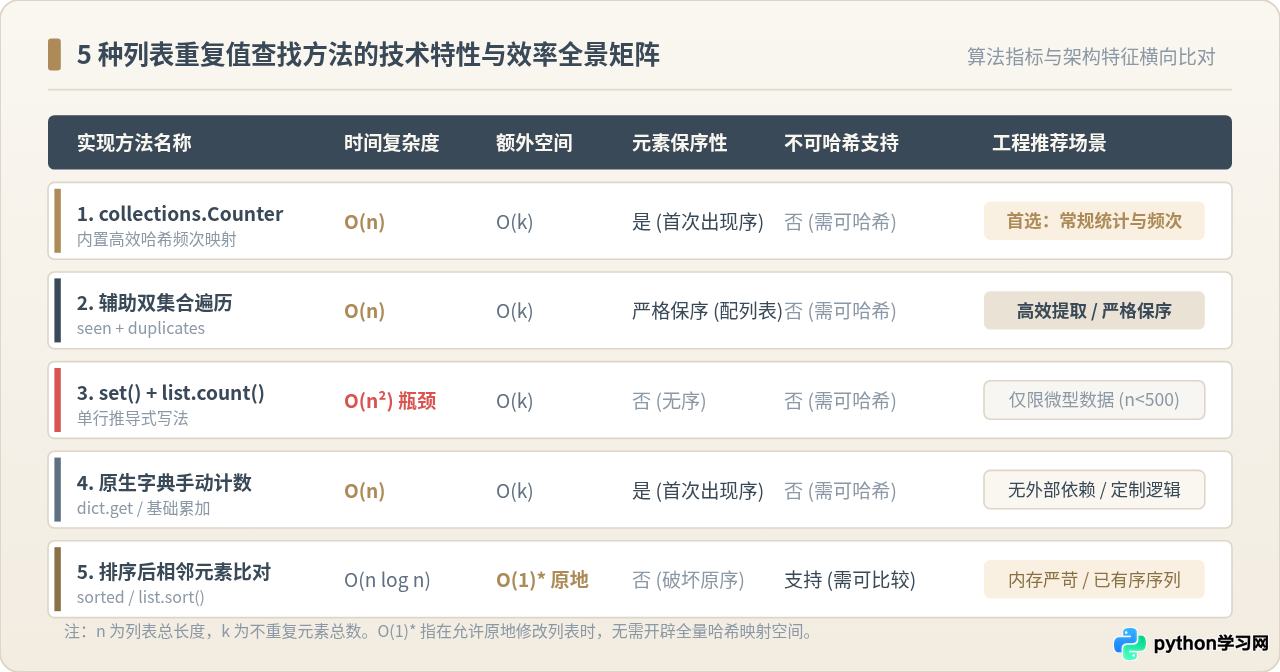
| 方法 | 时间复杂度 | 空间复杂度 | 是否保序 | 代码简洁度 | 核心限制 |
|---|---|---|---|---|---|
| 1. collections.Counter | O(n) | O(k) | 是(首次序) | 高(2行) | 元素需可哈希 |
| 2. 辅助双集合单次遍历 | O(n) | O(k) | 是(需配列表) | 中(需循环体) | 元素需可哈希 |
| 3. set() + count() 推导式 | O(n²) | O(k) | 否 | 极高(单行) | 大数据量严重超时 |
| 4. 原生字典手动统计 | O(n) | O(k) | 是(首次序) | 中 | 元素需可哈希 |
| 5. 排序后相邻比对 | O(n log n) | O(1) 原地 | 否 | 中 | 元素需支持大小比较 |
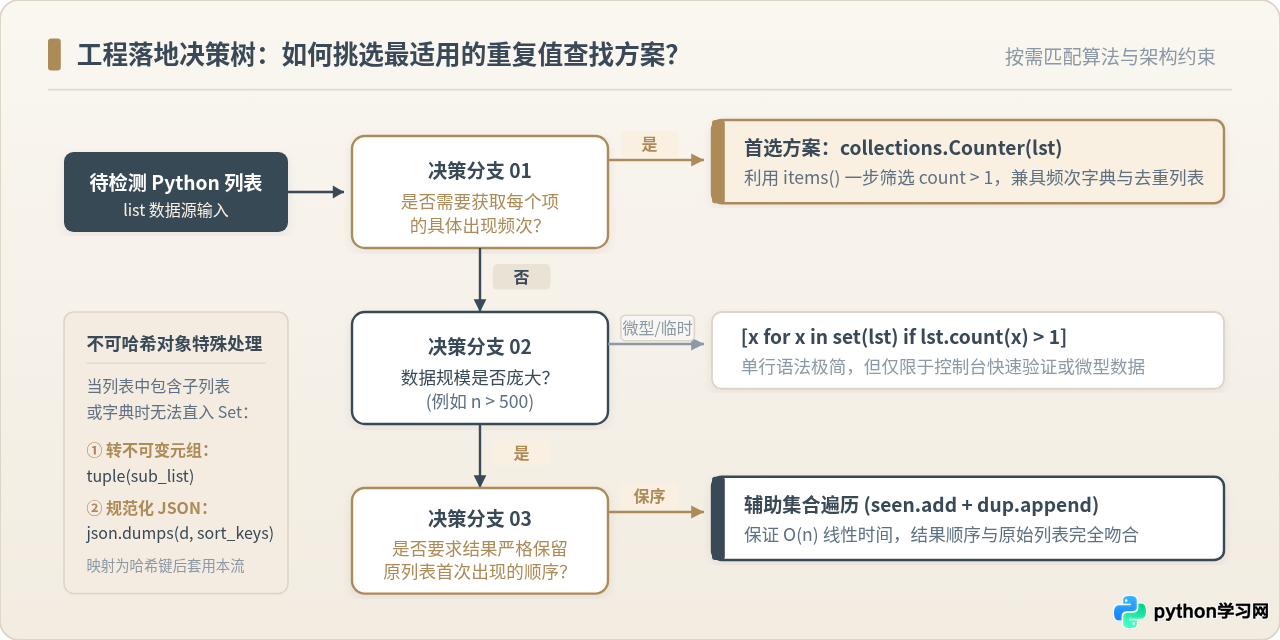
工程选型决策指南
在真实的业务代码评审与架构设计中,推荐遵循以下递进决策流程:
-
默认首选标准库:
如果无需特殊的保序自定义规则,直接使用
collections.Counter。它的意图最明确、代码可读性最高,并且兼具完整的频次元数据。 - 流式处理与提前退出: 如果数据量很大,或者处理的是一个生成器数据流,只要发现重复就需立即中断,选择辅助集合遍历法。
- 严格保序输出: 必须保证重复项在输出列表中按照其在原列表中出现的顺序输出时,优先使用辅助集合 + 结果列表追加。
- 数据已有序或内存极限: 当内存资源极度紧张,无法承受哈希表的开销,或者输入本身已经是时间戳排序序列时,采用相邻元素比对法。
-
杜绝使用推导式 count:
除非是在交互式终端(REPL)中临时检查几十个元素的小列表,否则切勿在生产代码中编写
[x for x in set(lst) if lst.count(x) > 1]。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









