

怎么提升Python课程设计报告质量?排版规范与查重避坑指南
针对高校Python课程设计报告常见的格式混乱、通篇硬塞代码、查重率爆表等痛点,提供从结构解耦、学术级三线表排版、等宽代码块规范到底层AST语法树防查重的全流程实战指南。
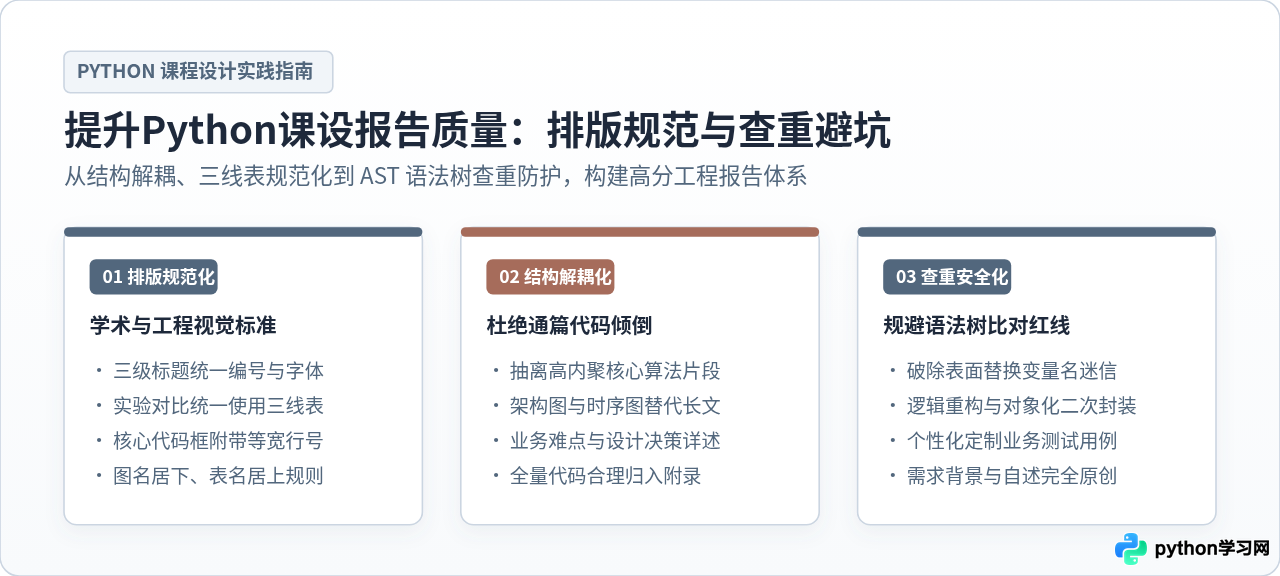
一、审查视角的转变:导师与评审系统如何评判一份报告?
在批阅几十甚至上百份课程设计报告时,评审老师首先看到的不是代码的具体逻辑,而是整篇文档的整体工程面貌。一份优秀的报告能够迅速传达三点信息:项目完成了什么业务目标、核心技术架构如何设计、关键功能与性能是否经过严谨测试。
常见的低分报告往往存在三个典型的“破坏性特征”:
- 代码喧宾夺主:直接将 400 行包含大量
import、界面绘制或控制台打印的原始脚本截图或复制到正文,占去大半篇幅,却缺乏设计思路与模块交互说明。 - 排版缺乏规制:字体中英混杂、标题编号缺少层级(如正文直接使用黑体大字代替标准分级)、表格使用 Word 默认网格或截取终端黑色文本框,视觉疲劳严重。
- 查重率触碰警戒线:为了凑字数,大段照搬网上现成的 Python 标准库介绍、框架安装教程或经典算法教科书解释,在知网、维普等系统检测下大面积标红。
提升质量的第一步,就是将“写说明书”的心态转变为“交付学术与工程技术总结报告”。
二、四阶段构建法:从杂乱脚本到规范技术报告
要摆脱流水账式的记录方式,应当把报告撰写梳理为一条标准化的处理流水线。下图展示了从源码整理、逻辑建模、排版编排到查重防护的完整四个实施阶段:
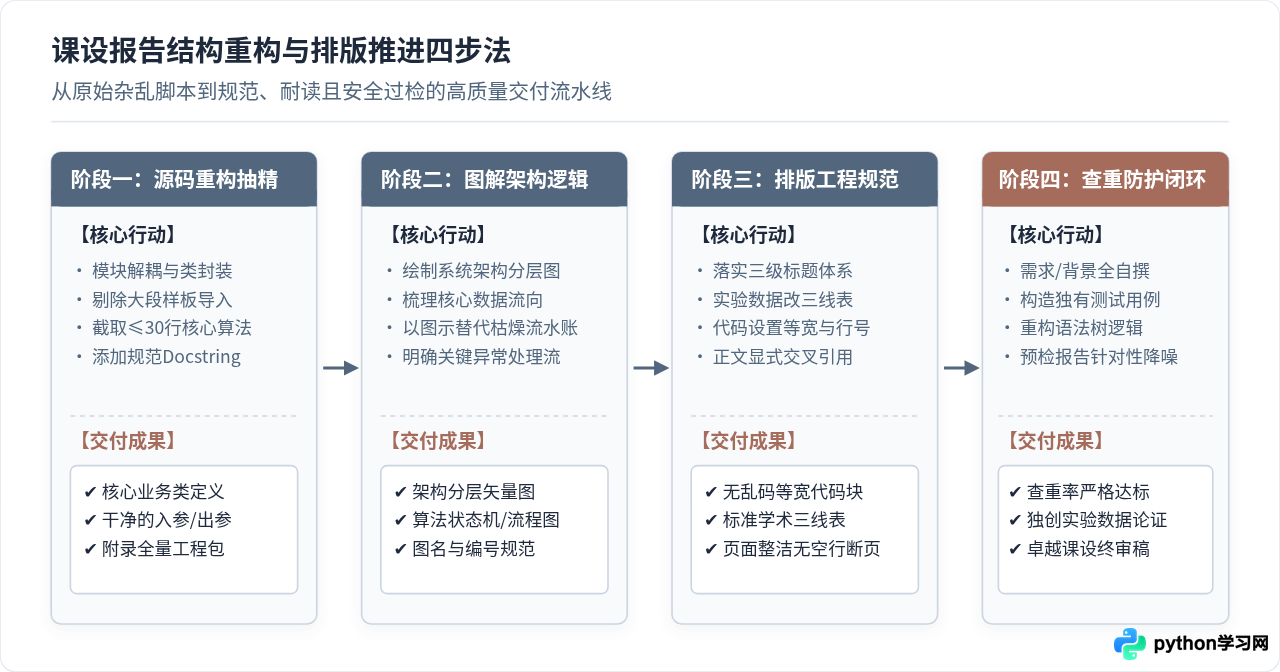
阶段一:源码重构与核心提炼
正文绝不是存放全量工程代码的仓库。在撰写具体实现章节前,首先要将代码按照高内聚、低耦合的原则进行模块划分(如数据接入层、业务计算层、输出展示层)。对于核心算法,提炼出 30 行以内的骨干函数,剥离掉界面布局配置、重复的异常捕获包装,只保留入参、核心计算拓扑与出参。其余数百行的支撑性代码,统一打包并在报告末尾以“附录”形式归档。
阶段二:逻辑图解与数据流建模
“一图胜千言”在工程报告中体现得尤为明显。如果一个模块由三个类协同完成,用文字平铺直叙往往枯燥晦涩。使用清晰的模块架构图或数据流向图展示数据进入系统后的清洗、转换与输出过程,既能展现深度的架构设计思维,又能天然压缩大段重复性的文字描述。
阶段三:学术级版面与要素编排
严格对齐学术与工科技术文档的排版标准。标题按照 1.、1.1、1.1.1 规范分级;测试数据一律使用三线表呈现;正文展示的代码块采用等宽字体并附带行号,正文中凡是涉及图表的地方,必须有文字主动引导(如“见图 1-1”、“见表 2-1”),杜绝出现“如下图所示”等非规范口语词。
阶段四:查重消歧与防护闭环
所有关于系统需求、功能设计、难点攻关的内容,均结合自己编写代码调试时的实际经历自撰。将测试用例差异化、个性化,避免采用教材上的通用测试数据,从根本上杜绝与往届或同届作业发生指纹特征重合。
三、页面级排版规范:工程与学术文档的标准呈现
许多同学往往在排版细节上失分。下方的页面元素布局图拆解了标准报告中各核心视觉元素的呈现规范:
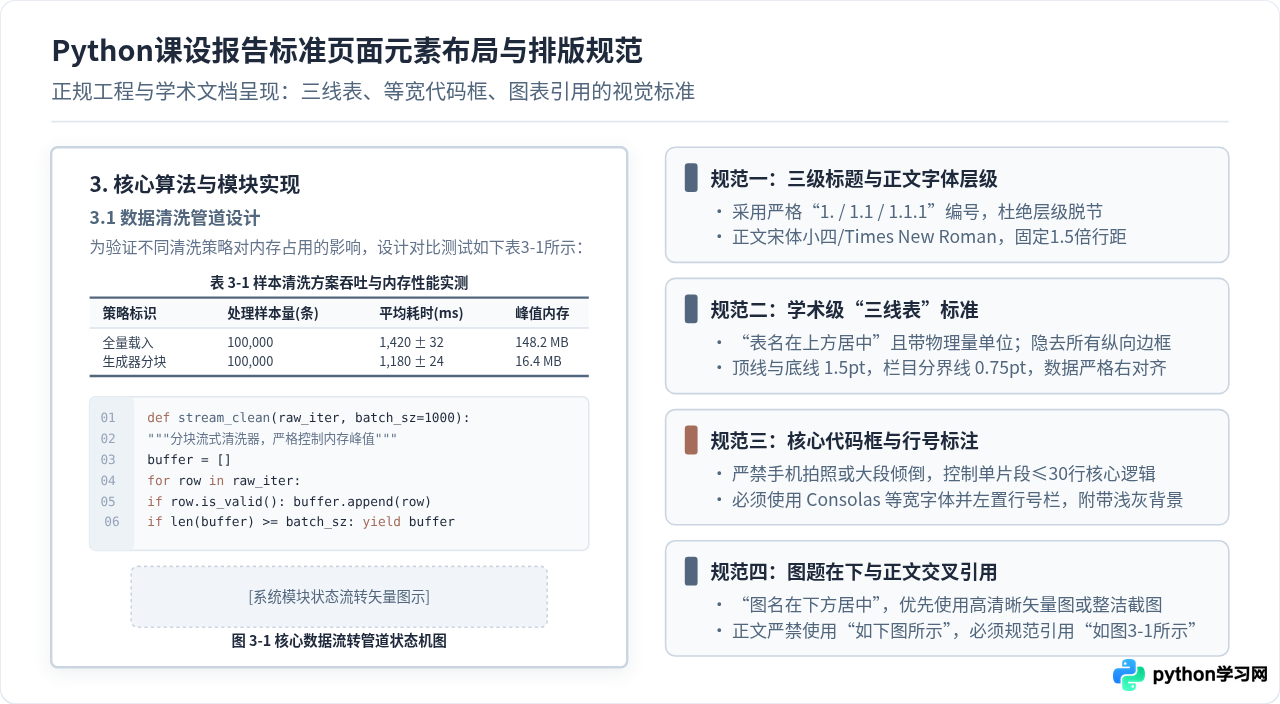
1. 标题层级与字体统一
正文建议采用中文宋体(小四号,12pt)、英文与数字统一采用 Times New Roman,行间距设置为固定值 20 磅或 1.5 倍行距,段前段后不留多余空行。标题遵循严格的三级编号体系:
- 一级标题(如“3. 核心算法与模块实现”):黑体或小三号加粗,段前 12 磅,段后 6 磅。
- 二级标题(如“3.1 数据清洗管道设计”):宋体加粗或四号,段前 6 磅,段后 3 磅。
- 三级标题(如“3.1.1 批量生成器流式处理”):小四号加粗,保持缩进整齐。
2. 学术“三线表”规范制作
在展示算法对比、测试集表现或运行参数配置时,切忌直接贴 Excel 网格或默认带粗黑纵向边框的表格。学术界通用规范是“三线表”:仅包含顶线、底线(通常粗 1.5pt)和表头底部的栏目线(粗 0.75pt),竖线全部隐去。同时务必记住关键原则:“表名置于表格上方居中,图名置于插图下方居中”,且表名后应明确物理单位。
| 处理模式 | 样本数据量 (条) | 平均吞吐率 (条/s) | 执行耗时 (ms) | 峰值内存开销 (MB) |
|---|---|---|---|---|
| 全量载入内存 (Eager) | 100,000 | 70,422 | 1,420 ± 32 | 148.2 |
| 分块生成器 (Chunk Generator) | 100,000 | 84,745 | 1,180 ± 24 | 16.4 |
| 并发异步流 (Async Pipeline) | 100,000 | 112,359 | 890 ± 18 | 28.6 |
3. 代码块的呈现规范
在正文中展示 Python 代码时,应避免直接使用手机屏幕拍照或无边框的代码粘贴。推荐使用浅灰色背景框(如 #F8FAFC),搭配深灰色边框(#E2E8F0),并采用等宽字体(Consolas、Courier New 或 Source Code Pro)。单段代码尽量控制在 25~30 行内,并附带清晰的注释:
# -*- coding: utf-8 -*-
"""
核心清洗管道实现示例:展示流式批处理与异常行隔离机制
"""
from typing import Iterator, List, Dict, Any

class DataCleanPipeline:
    def __init__(self, batch_size: int = 1000):
        self.batch_size = batch_size
        self.drop_count = 0

    def process_stream(self, records: Iterator[Dict[str, Any]]) -> Iterator[List[Dict[str, Any]]]:
        """按批次流式过滤无效字段,避免将全量数据载入内存"""
        chunk = []
        for item in records:
            if not self._is_valid(item):
                self.drop_count += 1
                continue
            chunk.append(item)
            if len(chunk) >= self.batch_size:
                yield chunk
                chunk = []
        if chunk:
            yield chunk

    def _is_valid(self, item: Dict[str, Any]) -> bool:
        """业务规则校验:过滤缺失关键 ID 或数值越界的脏数据"""
        return bool(item.get("user_id") and (0 <= item.get("score", 0) <= 100))
四、查重机制解构与避坑实战:科学破解高查重率
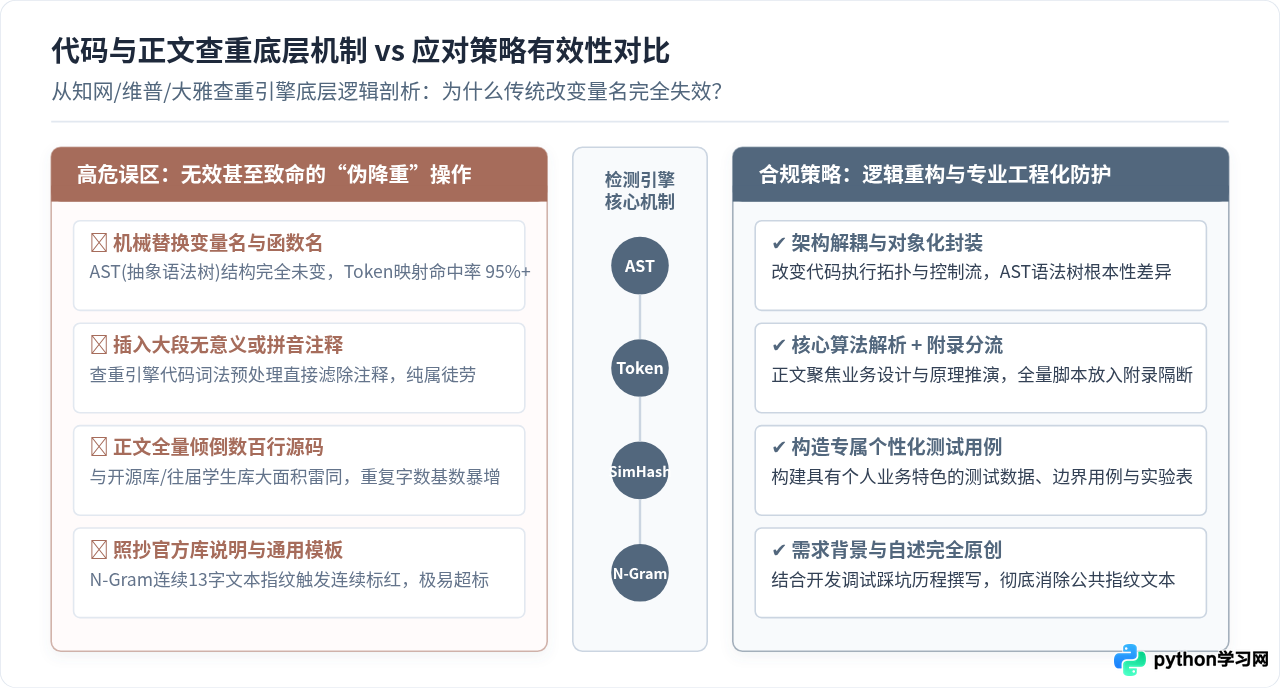
许多学生在提交课设前自查,发现查重率高达 35% 甚至 50%,于是慌忙采取“把变量 a 改成 user_val”、“把 for 循环改成 while 循环”、“每行加一句拼音注释”等偏方,结果再次检测查重率几乎没有变化,甚至代码还因为改错而报错崩溃。这源于对查重引擎底层逻辑的不了解。
1. 查重系统到底如何检测 Python 源码?
现代学术与代码查重引擎(如知网大学生作业系统、大雅、维普等)对待程序代码早已脱离了单纯的字符串完全匹配,其核心机制包括:
- 预处理与降噪:系统首先会剔除代码中的所有注释、空行、无意义缩进,并将变量名、局部函数名抽象为符号占位符。因此,添加再多口水注释也直接被过滤掉了。
- Token 流比对与 AST 抽象语法树分析:系统将 Python 源码解析为语法树。如果你只是把变量名从
student_list改成stu_arr,代码的语法树节点结构完全一致,系统仍判定为 100% 抄袭。 - SimHash 与 N-Gram 文本指纹:对于报告中的设计说明文本,系统会以连续 13 字左右提取指纹,只要与往届论文、开源仓库 README 或技术博客高度重叠,就会直接标红。
pandas、numpy、matplotlib、tkinter)的功能介绍。例如“Matplotlib 是一个 Python 的 2D 绘图库,它以各种硬拷贝格式和跨平台的交互式环境生成出版质量级别的图形……”这类标准定义在历年数据库中已存在数万次,必查重标红。直接改写为:“在本项目的数据可视化模块中,选择 Matplotlib 主要是为了利用其面向对象的 Figure-Axes 机制,针对 10 万条时序数据实现多子图联动渲染。”
2. 真正有效且合规的降重策略
科学降重必须从“结构与表述”层面入手,而不是在表面字句上打转:
- 控制流与面向对象重构:将网上的单文件长脚本改写为面向对象(OOP)结构,封装自定义的配置类与异常类。控制流拓扑发生实质性改变后,AST 语法树节点发生根本变化,查重系统自然判定为独立原创。
- 正文与源码物理隔离:将超过 50 行的非关键业务代码(如界面 UI 布局、参数解析、日志配置)全部移入附录。正文只保留核心算法逻辑,正文代码字数占比降低,重复率分子大幅缩减。
- 独创个性化业务测试场景:设计一套结合自身思考的具体测试数据集。例如如果题目是“图书管理系统”,不要使用“Book1, Book2, 1001, 1002”等教材标配数据,而是构造包含中文生僻字、超长书名、极端库存负数测试的特定用例。用例数据越具体,报告的原创性越牢不可破。
五、报告骨架参考与撰写标准
一份规范的工科 Python 课程设计报告,推荐按照以下六大部分展开组织:
- 课题背景与需求分析:说明具体解决的现实痛点,列出清晰的功能清单与非功能指标(如并发响应时间、最大内存开销)。
- 系统总体架构设计:给出系统分层架构图(数据层、业务逻辑层、表现层),清晰描述模块依赖与数据流转逻辑。
- 核心算法与关键技术实现:针对 1~2 个关键难点(如并发控制、数据过滤、图论算法优化),展示≤30 行核心精简代码,并深度解读其时间/空间复杂度与设计权衡。
- 系统测试与结果分析:以三线表列出测试用例矩阵(覆盖正常用例、边界用例与异常输入),并附带整洁紧凑的运行结果图。
- 总结与反思:客观陈述开发过程中遇到的具体 Bug(如内存泄漏、字符集编码冲突)及排查解决思路,指出系统当前尚未实现的局限性。
- 附录与参考文献:全量工程源码清单、
requirements.txt依赖说明及参考文献。
六、提交前全要素质量自查闭环
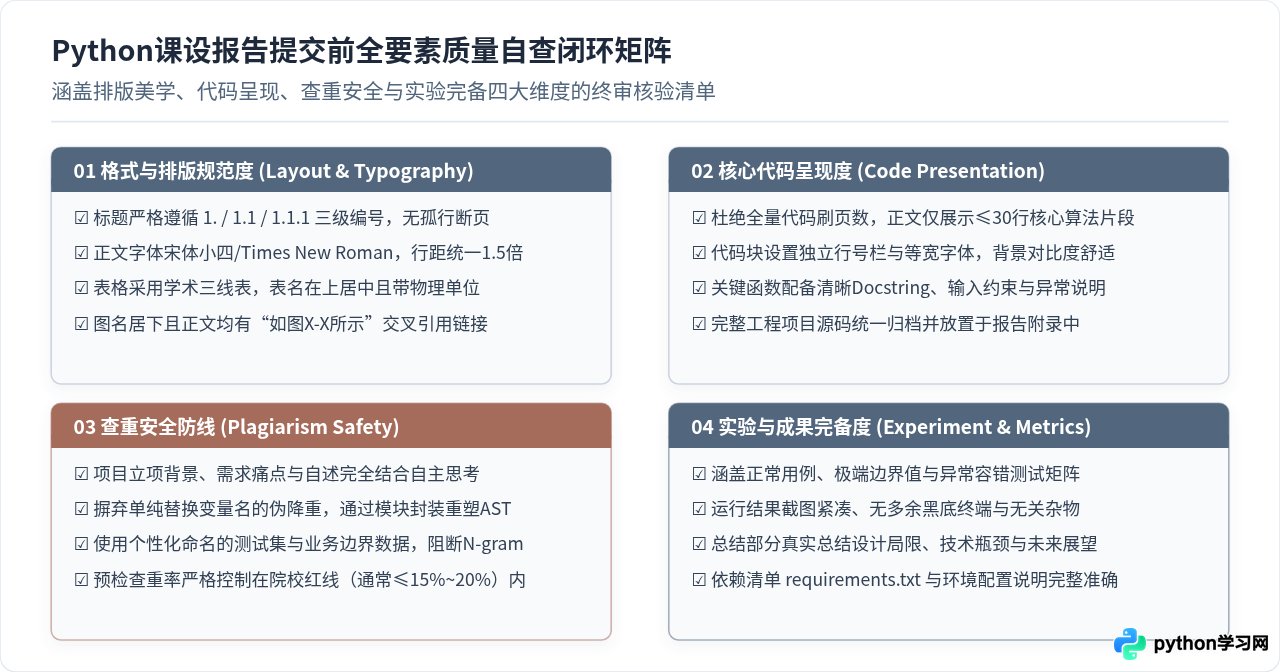
在导出 PDF 并正式向教学管理平台提交之前,利用下面的全要素自查矩阵进行最后核验,确保不遗漏任何细节:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









