

Python变量命名避坑:怎么检测保留字冲突
深入解析 Python 变量命名中的保留字冲突与内置标识符遮蔽机制,提供基于 keyword 和 builtins 的运行时检测方法、AST 语法树批量检测脚本以及 Ruff/Flake8 静态代码检查工程化方案。
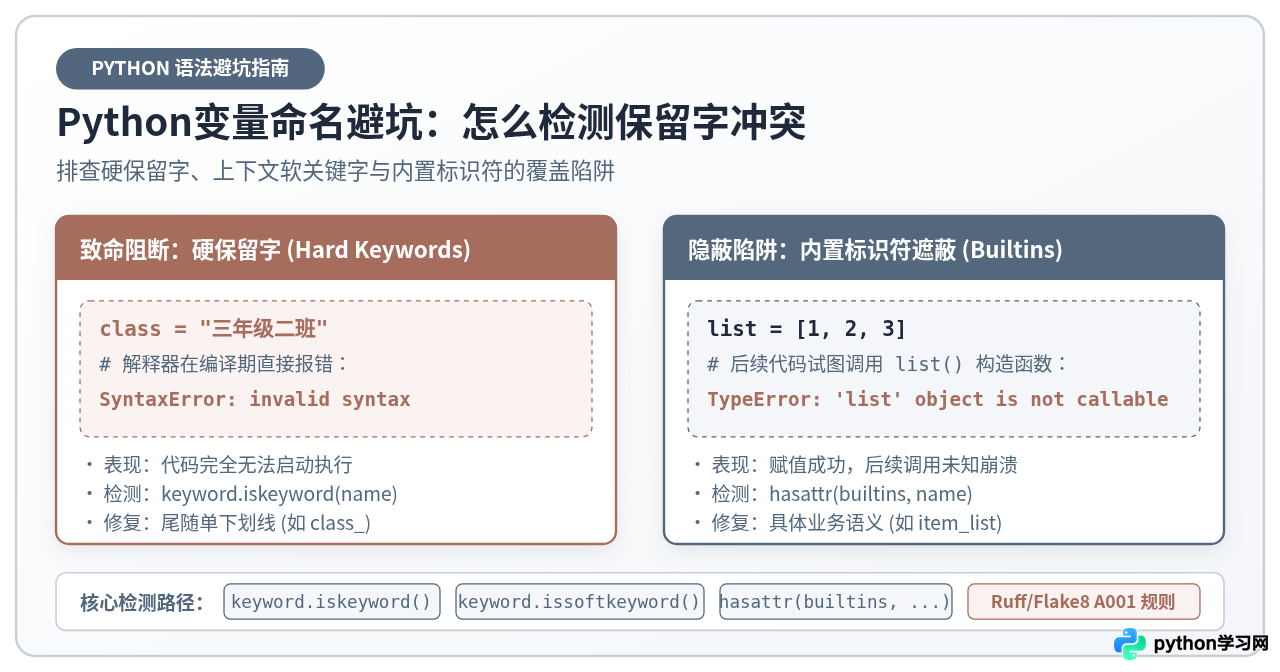
在 Python 中给变量命名时,如果直接使用 class、def 等保留关键字,解释器会在编译阶段直接抛出 SyntaxError;而如果使用了 id、type、list 等内置函数或类型名称,虽然不会立即报错,却会在当前作用域内静默覆盖内置定义,导致后续调用时抛出难以排查的 TypeError。本文将详细讲解如何通过 Python 标准库自带的检测模块、运行时检测脚本以及工程化的静态代码检查工具,准确识别并排查变量命名中的保留字与内置标识符冲突。
一、保留字冲突的两种截然不同的破坏方式
初学 Python 时,很多开发者会将“不能用作变量名的词”统称为“关键字”。但在实际的解释器执行链路中,变量冲突主要划分为两种性质截然不同的机制:词法级硬关键字阻断与作用域内置名遮蔽。
1. 硬关键字与编译期拦截
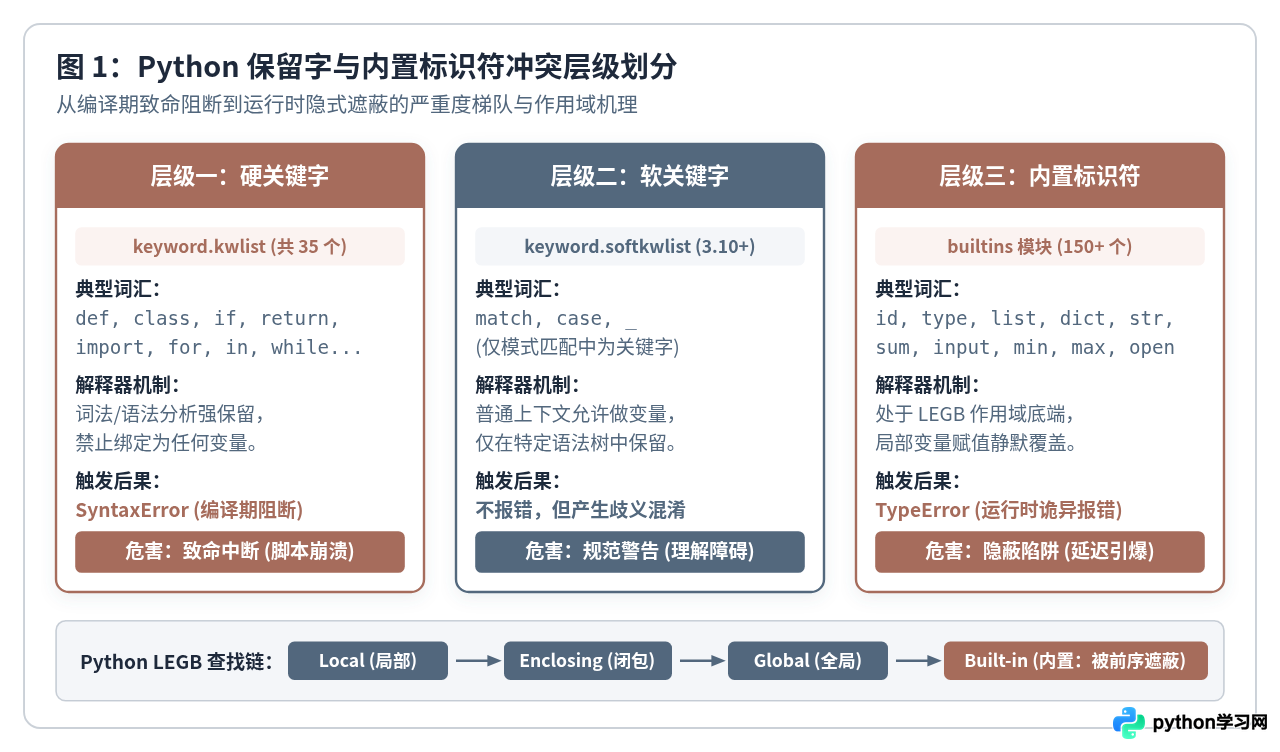
硬关键字(Hard Keywords)是 Python 语法规范的核心基石,例如 def、class、if、import、return 等。在 Python 源码被词法分析器(Tokenizer)扫描时,这些词汇会被转换为特定的终结符(Token)。解释器的语法分析树无法接受将这些终结符放在赋值语句的左侧(即作为 ast.Store 目标)。
# 示例:尝试给硬保留字赋值
class = "高三一班" File "<stdin>", line 1
class = "高三一班"
^
SyntaxError: invalid syntax
这种报错发生在代码运行之前。如果脚本中存在任何硬关键字作为变量名,整段脚本甚至连第一行代码都无法执行。这种破坏方式是显性的、立竿见影的,修复成本通常最低。
2. 内置标识符与隐式作用域遮蔽(Shadowing)
真正容易让团队陷入深夜排查泥潭的,是内置标识符(Built-in Identifiers)遮蔽。例如 id、type、list、dict、str、sum、input 等。它们并不是保留关键字,而是预先注入在 builtins 模块中的全局对象。
根据 Python 的 LEGB 查找规则(Local → Enclosing → Global → Built-in),当解释器查找一个变量名时,如果在局部作用域(Local)或全局作用域(Global)率先命中了同名变量,就会立即停止向下查找。这意味着:Python 允许你将变量命名为 list 或 id,赋值操作畅行无阻。
# 示例:局部遮蔽内置函数
def parse_records():
    # 错误命名:开发者误将变量命名为 list
    list = [10, 20, 30]
    print("获取数据:", list)

    # 后续业务逻辑需要将元组转为列表
    raw_data = ("apple", "banana")
    new_items = list(raw_data)  # 此时 list 指向上面的 [10, 20, 30],不再是内置类型
    return new_items

parse_records()获取数据: [10, 20, 30]
Traceback (most recent call last):
File "demo.py", line 10, in <module>
parse_records()
File "demo.py", line 8, in parse_records
new_items = list(raw_data)
TypeError: 'list' object is not callable
在大型复杂项目中,这种冲突常常发生在函数开头或者公共模块导入中,等到几百行之后其他同事调用 list()、str()、type() 时突然崩溃,报错信息往往让人摸不着头脑。
3. Python 3.10+ 的上下文软关键字
自 Python 3.10 引入结构化模式匹配(Structural Pattern Matching)以来,语言规范新增了软关键字(Soft Keywords):match、case 以及通配符 _。软关键字在普通赋值语句中完全可以作为普通变量名使用,解释器不会抛出语法错误;但在 match ... case 语句块内部,它们会获得特殊的语法语义。尽管语法允许,混用软关键字作为变量依然会大幅降低代码的可读性,引发团队成员的理解歧义。
二、使用标准库检测单变量冲突
在日常开发、封装底层框架、动态生成字段(例如读取动态 JSON、数据库表结构生成 ORM 模型)时,我们需要一种可靠的方式在程序运行时判断一个字符串是否会引发保留字冲突。Python 标准库内置了 keyword 和 builtins 两个专门用于此任务的模块。
1. keyword 模块:判断硬保留字与软保留字
keyword 模块是 Python 官方维护的关键字元数据字典,会随 Python 版本的演进自动同步。
keyword.kwlist:返回当前 Python 解释器所有硬关键字的字符串列表(在 Python 3.11 中共有 35 个)。keyword.iskeyword(s):高效判断字符串s是否属于硬关键字,返回布尔值。keyword.softkwlist(Python 3.10+):返回软关键字列表(['match', 'case', '_'])。keyword.issoftkeyword(s)(Python 3.10+):判断字符串是否属于软关键字。
2. builtins 模块:判断内置标识符遮蔽
builtins 模块包含了所有预先加载的内置函数、内置异常类、内置类型以及全局常数。可以通过 hasattr(builtins, s) 或 s in builtins.__dict__ 快速判定某个变量名是否会发生内置名称遮蔽。
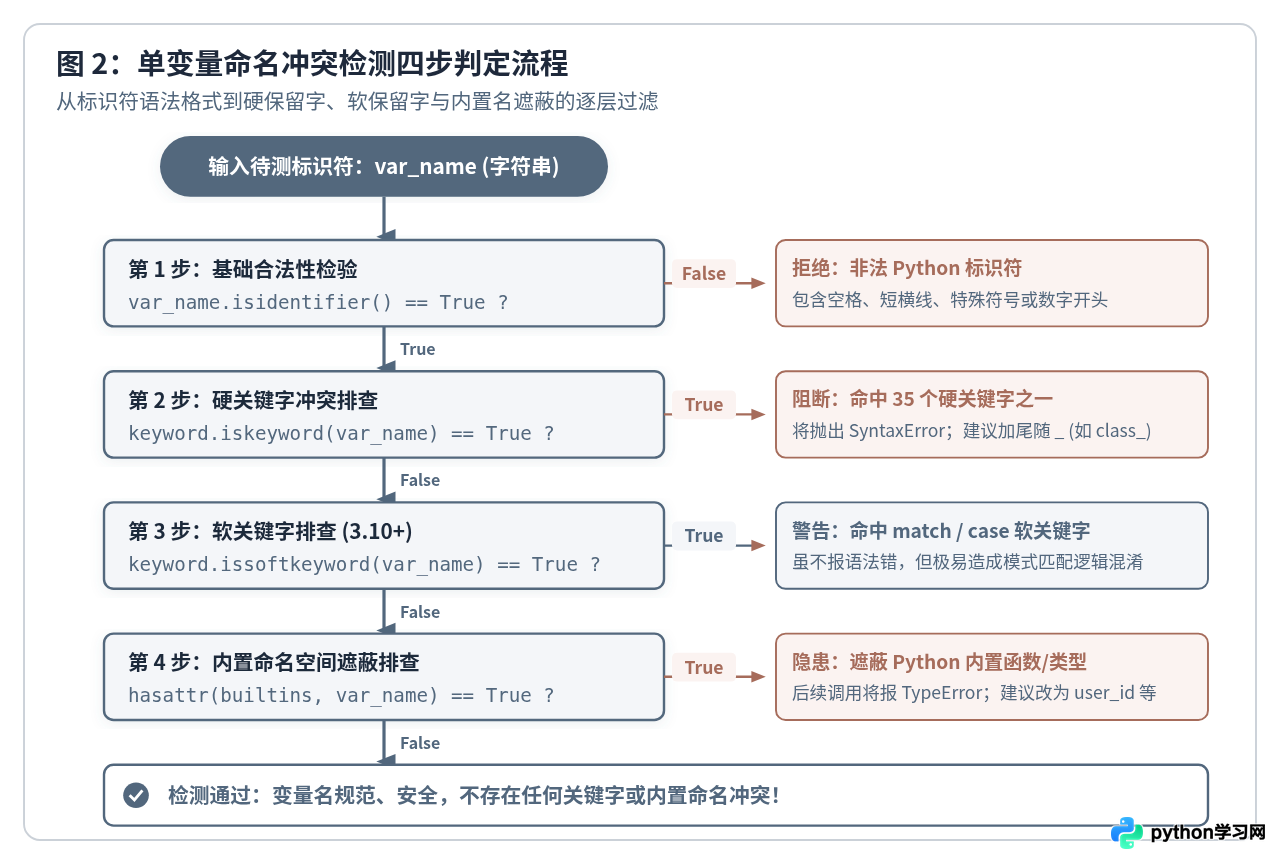
3. 编写严密的四步命名检测函数
综合标识符语法规则、硬关键字、软关键字以及内置对象,我们可以封装一个高可靠性的变量名检测工具函数:
import builtins
import keyword

def inspect_variable_name(name: str) -> dict:
    """
    检测候选变量名是否存在合法性缺陷或命名冲突
    """
    # 步骤 1:基础合法性(是否满足 Python 标识符语法规则)
    if not isinstance(name, str) or not name.isidentifier():
        return {
            "name": name,
            "status": "INVALID",
            "safe": False,
            "reason": "不是合法的 Python 标识符(包含非法字符、空格或数字开头)",
            "suggestion": "使用蛇形命名法(小写字母加下划线),且首字符不得为数字"
        }

    # 步骤 2:硬关键字排查(语法级硬冲突)
    if keyword.iskeyword(name):
        return {
            "name": name,
            "status": "HARD_KEYWORD",
            "safe": False,
            "reason": f"'{name}' 是 Python 语法硬关键字,会导致 SyntaxError",
            "suggestion": f"遵循 PEP 8 规范,可在末尾添加单下划线:'{name}_'"
        }

    # 步骤 3:软关键字排查(语法歧义风险)
    if hasattr(keyword, "issoftkeyword") and keyword.issoftkeyword(name):
        return {
            "name": name,
            "status": "SOFT_KEYWORD",
            "safe": True,
            "reason": f"'{name}' 是 Python 模式匹配软关键字,常规赋值虽合法但易引发语义混淆",
            "suggestion": f"建议替换为更具业务含义的变量名,如 'target_{name}'"
        }

    # 步骤 4:内置命名空间遮蔽排查(运行时逻辑陷阱)
    if hasattr(builtins, name):
        return {
            "name": name,
            "status": "BUILTIN_SHADOW",
            "safe": False,
            "reason": f"'{name}' 是内置标识符,赋值后会覆盖内置对象,后续调用将引发 TypeError",
            "suggestion": f"使用具体业务名词替代,例如将其重构为 '{name}_val' 或 'item_{name}'"
        }

    # 判定完全安全
    return {
        "name": name,
        "status": "SAFE",
        "safe": True,
        "reason": "命名合法且无保留字冲突",
        "suggestion": "安全可用"
    }

# 测试典型变量名
test_names = ["user_name", "class", "match", "id", "list", "2_order", "my-var"]
for item in test_names:
    res = inspect_variable_name(item)
print(f"[{res['status']:14}] {item:8} -> {res['reason']}")[SAFE ] user_name -> 命名合法且无保留字冲突 [HARD_KEYWORD ] class -> 'class' 是 Python 语法硬关键字,会导致 SyntaxError [SOFT_KEYWORD ] match -> 'match' 是 Python 模式匹配软关键字,常规赋值虽合法但易引发语义混淆 [BUILTIN_SHADOW] id -> 'id' 是内置标识符,赋值后会覆盖内置对象,后续调用将引发 TypeError [BUILTIN_SHADOW] list -> 'list' 是内置标识符,赋值后会覆盖内置对象,后续调用将引发 TypeError [INVALID ] 2_order -> 不是合法的 Python 标识符(包含非法字符、空格或数字开头) [INVALID ] my-var -> 不是合法的 Python 标识符(包含非法字符、空格或数字开头)
三、批量检测源码:基于 AST 语法树遍历
单变量检测适合动态输入校验,而在存量项目治理中,我们需要能够全自动扫描整份 .py 脚本或整个代码仓库。直接使用正则表达式匹配单词会产生大量的误报(例如在字符串字面量 "class"、注释 # id here、字典键 data['type'] 或对象属性 user.id 中的情况)。
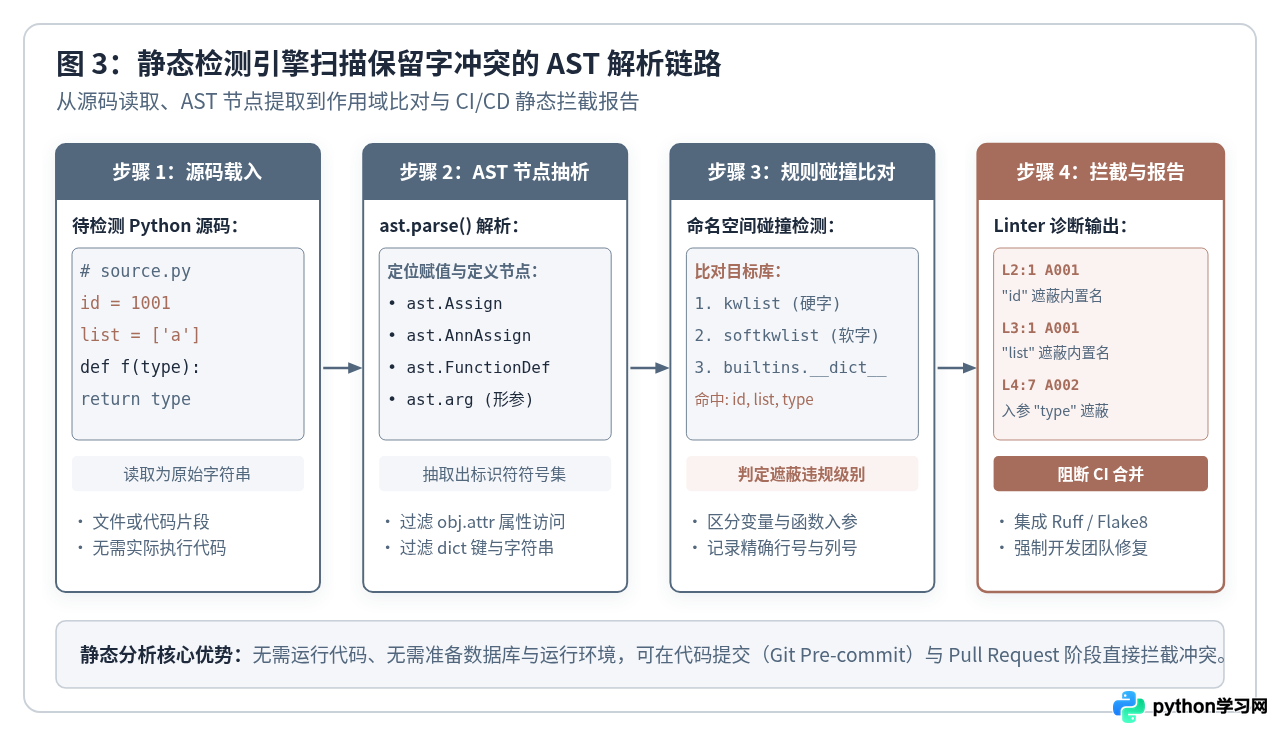
正确且工业级的方法是利用 Python 标准库的 ast(抽象语法树) 模块。通过继承 ast.NodeVisitor,我们可以精确捕获代码中所有真正的变量定义与形参声明节点,排除属性访问与字符串字面量。
import ast
import builtins
import keyword
from typing import List, Dict

class ConflictDetector(ast.NodeVisitor):
    def __init__(self):
        self.conflicts: List[Dict] = []
        self.builtins_set = set(dir(builtins))

    def _check_name(self, name: str, node: ast.AST, role: str):
        # 1. 检查硬关键字
        if keyword.iskeyword(name):
            self.conflicts.append({
                "line": getattr(node, "lineno", 0),
                "col": getattr(node, "col_offset", 0),
                "name": name,
                "role": role,
                "type": "HARD_KEYWORD",
                "message": f"{role} '{name}' 冲突:属于保留硬关键字"
            })
        # 2. 检查内置标识符遮蔽
        elif name in self.builtins_set:
            self.conflicts.append({
                "line": getattr(node, "lineno", 0),
                "col": getattr(node, "col_offset", 0),
                "name": name,
                "role": role,
                "type": "BUILTIN_SHADOW",
                "message": f"{role} '{name}' 冲突:遮蔽内置对象 (builtins.{name})"
            })

    # 场景 1:普通变量赋值 (例如: id = 10, a, type = 1, 2)
    def visit_Assign(self, node: ast.Assign):
        for target in node.targets:
            if isinstance(target, ast.Name):
                self._check_name(target.id, target, "变量赋值")
            elif isinstance(target, (ast.Tuple, ast.List)):
                for elt in target.elts:
                    if isinstance(elt, ast.Name):
                        self._check_name(elt.id, elt, "解包赋值")
        self.generic_visit(node)

    # 场景 2:带类型注解的赋值 (例如: count: int = 0)
    def visit_AnnAssign(self, node: ast.AnnAssign):
        if isinstance(node.target, ast.Name):
            self._check_name(node.target.id, node.target, "类型注解赋值")
        self.generic_visit(node)

    # 场景 3:函数定义名与形参 (例如: def process(type, list):)
    def visit_FunctionDef(self, node: ast.FunctionDef):
        self._check_name(node.name, node, "函数名称")
        for arg in node.args.args:
            self._check_name(arg.arg, arg, "函数入参")
        self.generic_visit(node)

def scan_python_code(code_str: str):
    tree = ast.parse(code_str)
    detector = ConflictDetector()
    detector.visit(tree)
    return detector.conflicts

# 待测试的模拟源码
sample_script = '''
id = 1001
list = ["alpha", "beta"]

def get_record(type, filter):
    result = dict()
    result["id"] = id
    return result
'''

issues = scan_python_code(sample_script)
for item in issues:
print(f"行 {item['line']:2d}, 列 {item['col']:2d} | [{item['type']:14}] {item['message']}")行 2, 列 0 | [BUILTIN_SHADOW] 变量赋值 'id' 冲突:遮蔽内置对象 (builtins.id) 行 3, 列 0 | [BUILTIN_SHADOW] 变量赋值 'list' 冲突:遮蔽内置对象 (builtins.list) 行 5, 列 15 | [BUILTIN_SHADOW] 函数入参 'type' 冲突:遮蔽内置对象 (builtins.type) 行 5, 列 21 | [BUILTIN_SHADOW] 函数入参 'filter' 冲突:遮蔽内置对象 (builtins.filter)
观察上述输出可以看到,AST 解析器准确捕获到了赋值变量 id、list 以及函数参数 type、filter 的遮蔽问题;与此同时,第 7 行代码中的字典键访问 result["id"] 并未被错误标记。这就是基于 AST 抽象语法树分析相对于纯文本正则匹配的本质优势。
四、工程化防护:在 IDE 与 CI 中自动化拦截
人工编写检查脚本适用于自定义扫描工具,但在多人协作的大型软件工程中,必须将冲突检测嵌入开发工具链,实现“代码未合入即拦截”。
1. 使用现代极速代码分析工具 Ruff
Ruff 是当前 Python 生态中广泛采用的极速静态检查器,原生集成了 flake8-builtins 规则集(代号 A)。在项目根目录的 pyproject.toml 或 ruff.toml 中加入如下配置即可全面开启检测:
# pyproject.toml 配置示例
[tool.ruff.lint]
select = [
    "E",    # pycodestyle 错误
    "F",    # pyflakes 错误
    "A",    # flake8-builtins 规则集:内置名称遮蔽防护
]

# 可选:如果特定遗留代码允许例外,可配置忽略
# ignore = ["A003"] # A003 为类属性遮蔽
开启 A 规则集后,Ruff 会自动细分三种冲突场景:
A001:常规变量赋值遮蔽内置名称(如id = 123)。A002:函数入参形参名遮蔽内置名称(如def func(format, type):)。A003:类属性或方法名遮蔽内置名称(如class User: id = 1)。
2. Pylint 与 Flake8 传统方案
如果团队现有流水线基于 Flake8 或 Pylint,亦可通过对应插件实现相同效果:
- Flake8:安装
pip install flake8-builtins插件,运行flake8即可自动检测内置标识符被覆写。 - Pylint:内置了
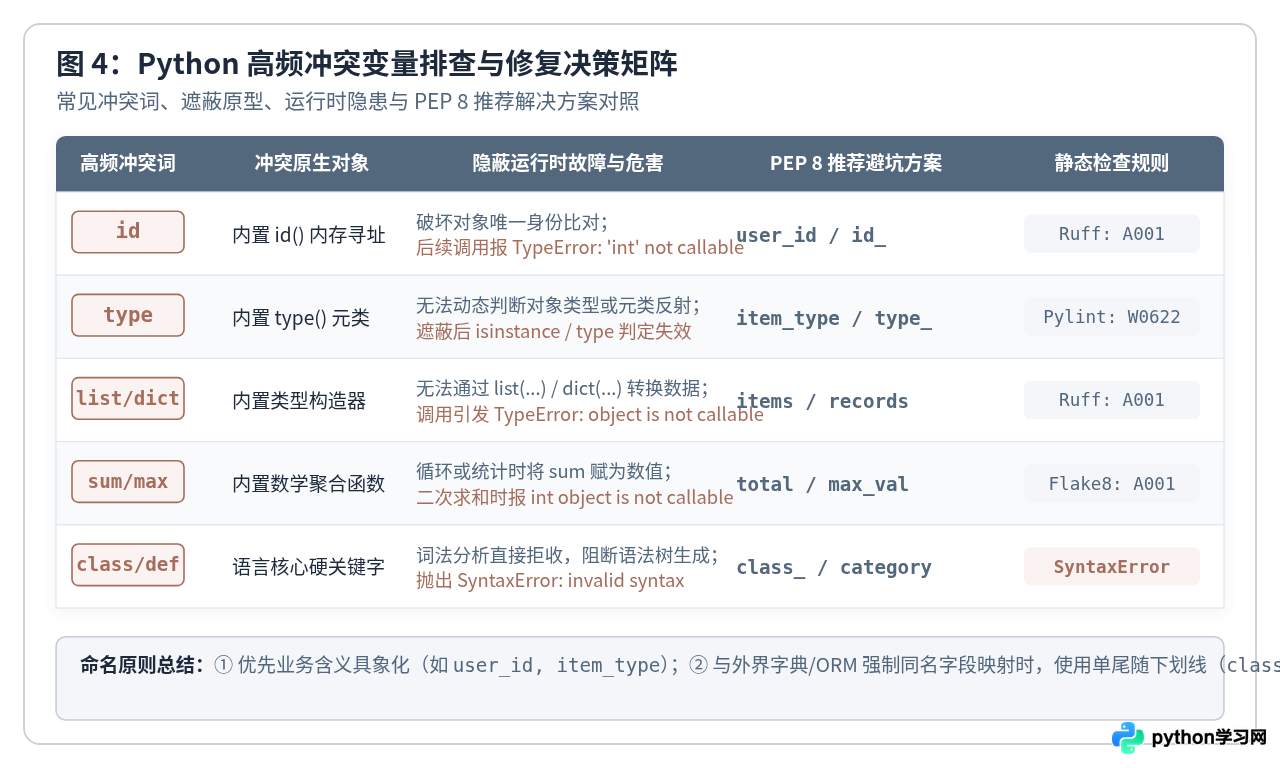
redefined-builtin (W0622)检查项,当发现本地变量重定义内置符号时直接输出警告。
五、常见高频冲突词与 PEP 8 避坑规范
发现保留字冲突后,应当如何规范重命名?很多开发者喜欢在变量前加单下划线(如 _id)或双下划线(如 __type),这在 Python 中属于严重反模式。在 Python 语言惯例中,前置下划线表示模块私有属性或保护成员,前置双下划线还会触发类的名称修饰(Name Mangling)。
1. 避坑原则一:首选业务具体化命名(推荐)
绝大部分保留字冲突之所以发生,是因为开发者在给变量起名时过于偷懒。例如在处理用户数据时直接用 id,在处理商品类型时直接用 type。只要根据上下文加入业务名词,冲突自然化解:
id→ 重构为user_id、order_id、account_idtype→ 重构为item_type、data_kind、categorylist/dict→ 重构为user_list、payload_dict、records、itemssum/max→ 重构为total_amount、max_score、peak_valinput/open→ 重构为user_input、target_file、raw_query
2. 避坑原则二:强制同名时使用单尾随下划线(PEP 8 标准)
在对接外部第三方 API、解析特定的 JSON 协议或编写 ORM 映射时,如果属性名或参数名必须与语言保留字完全同名(例如 HTML 标签属性 class、数据库字段 id),PEP 8 官方标准给出的唯一规范是:在末尾追加单个下划线。
# 遵循 PEP 8 的规范示例:
def build_tag(tag_name: str, class_: str = "", id_: str = None):
    attrs = []
    if class_:
        attrs.append(f'class="{class_}"')
    if id_:
        attrs.append(f'id="{id_}"')
    return f"<{tag_name} {' '.join(attrs)}></{tag_name}>"
使用 class_ 和 id_ 既能明确表达该变量代表外界的同名属性,又完全避免了与 Python 解释器硬保留字或内置函数的冲突,代码整洁且符合现代工程规范。
六、总结
防范 Python 变量命名中的保留字冲突,关键在于识别“硬关键字阻断”与“内置标识符遮蔽”的本质区别。在动态代码生成场景中,使用 keyword.iskeyword() 与 hasattr(builtins, ...) 即可完成毫秒级快速判定;在存量工程治理中,基于 ast 抽象语法树能够实现无漏报无误报的深度扫描;而在现代软件持续集成体系中,通过配置 Ruff 的 A 规则集,可将所有冲突杜绝在提交阶段。坚持“优先业务具象化命名、必要时使用尾随单下划线”的命名准则,便能从源头上编写出健壮、优雅的 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









