

编写Pythonic代码:PEP 8规范与常见反模式避坑
深入解析编写Pythonic代码的核心思想,系统梳理PEP 8编码规范、自动化工具链配置,并重点剖析可变默认参数、裸except、手动索引遍历等高频反模式的避坑指南与重构方案。
许多具备其他语言背景的开发者在转入 Python 时,往往能快速写出功能正常的业务代码,但这些代码常带有浓厚的 C 或 Java 语法习惯:充斥着下标索引循环、繁琐的判空检测、粗糙的异常捕获以及潜藏状态污染的可变默认参数。所谓编写“Pythonic”代码,本质上是充分利用 Python 语言原生的语法特性与数据模型,以直观、精简且具防御性的方式表达业务逻辑。本文从 PEP 8 核心规范的实操落地切入,剖析工程中最易踩坑的典型反模式,并提供系统化的工具链与重构路径。
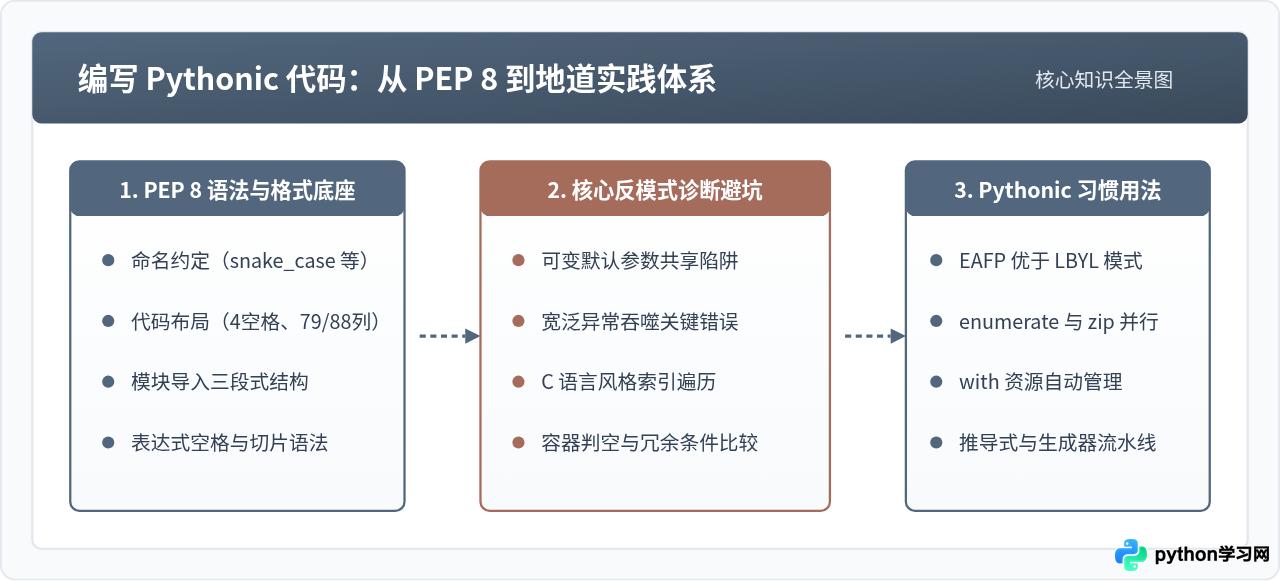
一、深入理解 PEP 8:不只是“好看”,更是降低心智负担
PEP 8(Python Enhancement Proposal 8)是 Python 官方制定的样式指南。很多初学者误以为 PEP 8 仅仅关乎空格与换行,然而统一的代码样式能让团队成员在阅读任意模块时迅速抓住逻辑主干,规避隐蔽的语法混淆。
1. 命名规范与语义一致性
Python 依靠命名约定区分对象性质,而不是依靠严格的关键字限制访问级别。保持命名的一致性是消除歧义的第一道屏障:
- 变量与函数名:采用全小写加下划线命名法(
snake_case),如parse_response_payload()、user_count。动词引导函数,名词指代变量。 - 类名:采用大驼峰命名法(
PascalCase),如HTTPConnectionManager、DataPipeline。内部异常类应以Error结尾。 - 常量声明:模块级常量统一使用大写加下划线(
UPPER_SNAKE_CASE),如DEFAULT_TIMEOUT_SECONDS = 30。 - 内部私有标识:使用单下划线前缀(
_single_leading_underscore)标记非公有属性或方法,防止from module import *时被导出,同时向协作者传达“内部实现”的语义。 - 规避单字母命名:绝对避免使用容易与数字混淆的单字母作为变量名,尤其是小写
l、大写O和I。
2. 代码布局与空格约束
排版应当严守统一节奏。PEP 8 明确要求每一级缩进严格使用 4 个空格,禁止混用制表符(Tab)。在现代工程中,代码单行长度建议控制在 88 个字符(遵循 Black 默认标准)或 79 个字符(标准 PEP 8 限制),这能确保在终端并排比对代码差异(Diff)时不发生错乱折行。
关于空格的摆放,常见的易错点包括:
- 小括号、方括号或花括号内部不要紧贴添加空格,例如写
data[index]而不是data[ index ]。 - 逗号、冒号、分号紧跟前一个字符,空格放在其后:写
items[1:3]或point = (x, y)。在切片语法中,冒号两侧的空格应保持对称,例如items[lower + offset : upper + offset]。 - 为函数参数指定默认值,或在调用时传递关键字参数时,等号两边不要加空格,如
def connect(host, port=8080):。仅当结合类型注解时保留空格:def connect(host: str, port: int = 8080) -> bool:。
3. 模块导入的三段式结构
所有的 import 语句应置于文件顶部,位于模块文档字符串与全局变量之间。导入应当按照特定顺序分为明确的三组,组与组之间保留一个空行:
# 1. Python 原生标准库
import os
import sys
from typing import Optional, List

# 2. 第三方依赖库
import requests
from pydantic import BaseModel

# 3. 本地应用及模块内部导入
from myproject.utils import format_timestamp
from myproject.models import UserProfile
坚决禁止在生产代码中使用通配符导入 from module import *。这种写法会污染当前全局命名空间,造成名字遮蔽(Name Shadowing),并在后期重构时使人无法追踪某个函数的来源。
二、高频反模式剖析:原理机制与 Pythonic 避坑方案
反模式(Anti-Pattern)指的是表面上似乎能够达成目的,但伴随巨大维护风险、逻辑缺陷或性能损耗的实现方式。以下五大反模式是实际代码审查中最常发现的薄弱环节。
1. 陷阱一:可变对象充当函数默认参数
这是 Python 初学者最普遍踩入的语言特性陷阱。在 Python 中,def 语句是可执行语句:当包含 def 的模块被加载解析时,函数对象被创建,其默认参数值就已经被评估并绑定在函数对象的 __defaults__ 属性中,而不是在每次调用函数时重新求值。
反模式代码:
# 危险:空列表 [] 在函数定义时只生成一次
def append_event(event_name: str, logs: list = []) -> list:
    logs.append(event_name)
    return logs

# 运行表现:多次调用互相污染
print(append_event("login"))   # 输出 ['login']
print(append_event("click"))   # 输出 ['login', 'click'],非预期的独立列表!
当传入可变对象(如 list、dict 或自定义类实例)作为默认值时,任何对该参数的原地修改都会永久保留在函数对象的属性中,导致后续调用发生交叉污染。
Pythonic 解决方案:使用不可变单例 None 作为哨兵值(Sentinel),在函数体内部按需初始化全新容器。
from typing import Optional, List

def append_event(event_name: str, logs: Optional[List[str]] = None) -> List[str]:
    """安全地追加事件,确保每次调用上下文隔离"""
    if logs is None:
        logs = []
    logs.append(event_name)
    return logs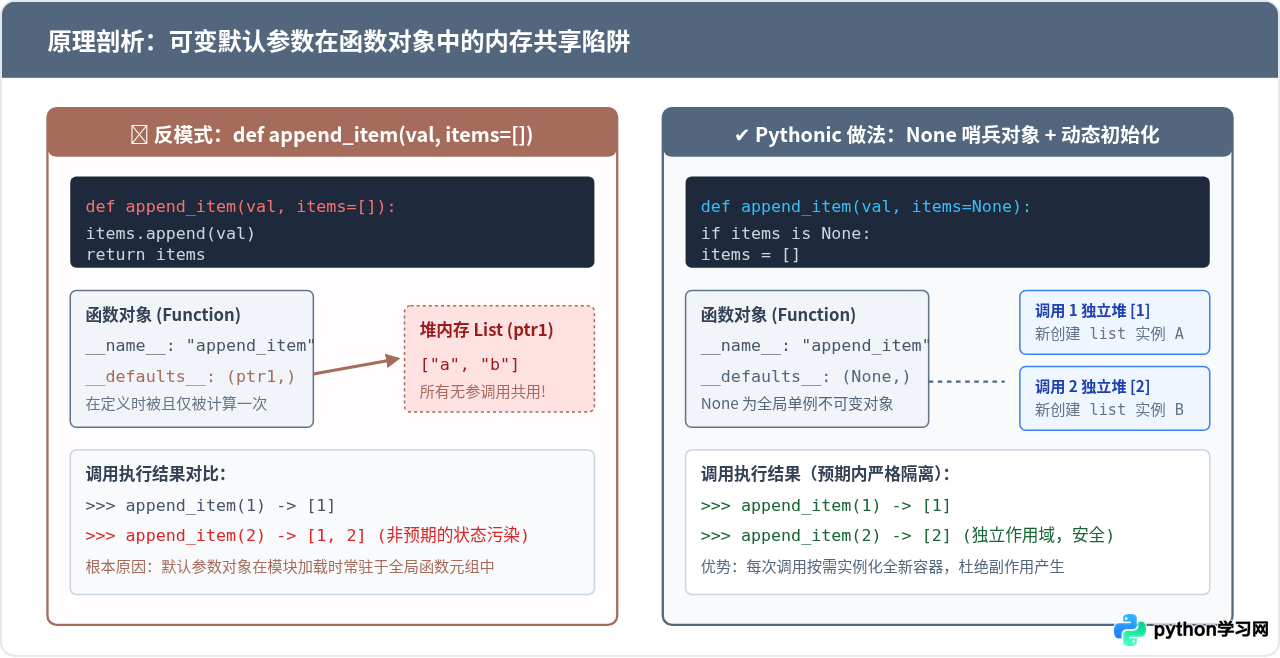
2. 陷阱二:过度宽泛的“裸”异常捕获
代码中使用 except: 或未经甄别的 except Exception: 会无差别地吸收所有错误。这不仅会吞掉预期的业务异常,还会捕获开发者输入的终止信号 KeyboardInterrupt、程序退出命令 SystemExit,甚至掩盖诸如变量名拼写错误(NameError)或参数不匹配(TypeError)。
反模式代码:
try:
    val = int(raw_input_text)
    result = compute_risk(val)
except:
    # 彻底失明:无法得知到底是输入格式错误、Ctrl+C 中断还是函数内部逻辑崩溃
    result = 0
Pythonic 解决方案:防御性编程要求精准捕获预期的具体异常。若需要向上抛出业务异常,应使用 raise ... from err 保持异常回溯链条完整:
try:
    val = int(raw_input_text)
    result = compute_risk(val)
except ValueError as err:
    # 精确捕获类型转换失败,记录上下文并赋予兜底值
    logger.warning("无效的输入数值: %s, 详情: %s", raw_input_text, err)
    result = 0
except RiskCalculationError as err:
    # 链式重新抛出,保留原始调用栈
    raise ProcessingPipelineError("风险评估阶段计算失败") from err
3. 陷阱三:类 C 风格的序列索引遍历
很多来自 C/C++ 或 Java 的工程师习惯通过 for i in range(len(items)): 先获取下标,再通过 items[i] 访问元素。在 Python 中,所有序列和集合都原生实现了迭代协议(Iteration Protocol),直接迭代对象比手动维护下标更加高效且不易越界。
反模式代码:
names = ["Alice", "Bob", "Charlie"]
scores = [85, 92, 78]

# 笨重且易错的手动索引遍历
for i in range(len(names)):
    print(f"Index: {i}, Name: {names[i]}, Score: {scores[i]}")
Pythonic 解决方案:使用内置函数 enumerate() 优雅解构下标与元素;多序列并行遍历时,使用 zip()(在 Python 3.10+ 中建议添加 strict=True 以防长度不一致静默截断):
# 场景 1:既需要元素又需要索引
for idx, name in enumerate(names, start=1):
    print(f"第 {idx} 名: {name}")

# 场景 2:多个关联序列并行遍历
for name, score in zip(names, scores, strict=True):
    print(f"学生 {name} 得分: {score}")
4. 陷阱四:冗余的类型与真值校验
Python 拥有简洁明了的“真值测试(Truthy/Falsy)”规则。空列表、空字典、空字符串、数值 0、None 和 False 在布尔上下文中都被视为假(False)。写出形如 if len(items) == 0: 或 if flag == True: 属于多余的冗余操作,违背了简洁哲理。
反模式与重构对照:
# 反模式写法
if len(user_list) > 0:       # 冗余的长度测量
    send_notifications()

if is_authenticated == True:  # 冗余的等值比较
    grant_access()

if result == None:            # 错误的对象身份比较
    fallback()

# Pythonic 写法
if user_list:                 # 利用原生真值测试
    send_notifications()

if is_authenticated:          # 直截了当表达命题
    grant_access()

if result is None:            # 严格使用 is 进行单例标识符比较
    fallback()
需要注意:比较对象身份(是否指向同一个内存地址)必须使用 is 或 is not,例如与 None 的比对;而比较对象数值相等性才使用 ==。
5. 陷阱五:非受管资源操作与低效字符串累加
打开文件、数据库事务或互斥锁时,如果依赖于手动调用 f.close(),一旦前序逻辑抛出未捕获异常,后续关闭指令将无法执行,最终耗尽系统的文件句柄或连接池资源。此外,在循环中反复使用 += 拼接字符串会导致不可变对象(str)不断在内存中重新分配和复制。
# 反模式:手动关闭与低效拼接
f = open("data.txt", "r", encoding="utf-8")
content = ""
for line in f:
    content += line.strip() + ","
f.close()

# Pythonic:利用上下文管理器与 join 原语
with open("data.txt", "r", encoding="utf-8") as f:
    # 使用生成器表达式配合 str.join 一次性分配内存完成组装
    content = ",".join(line.strip() for line in f)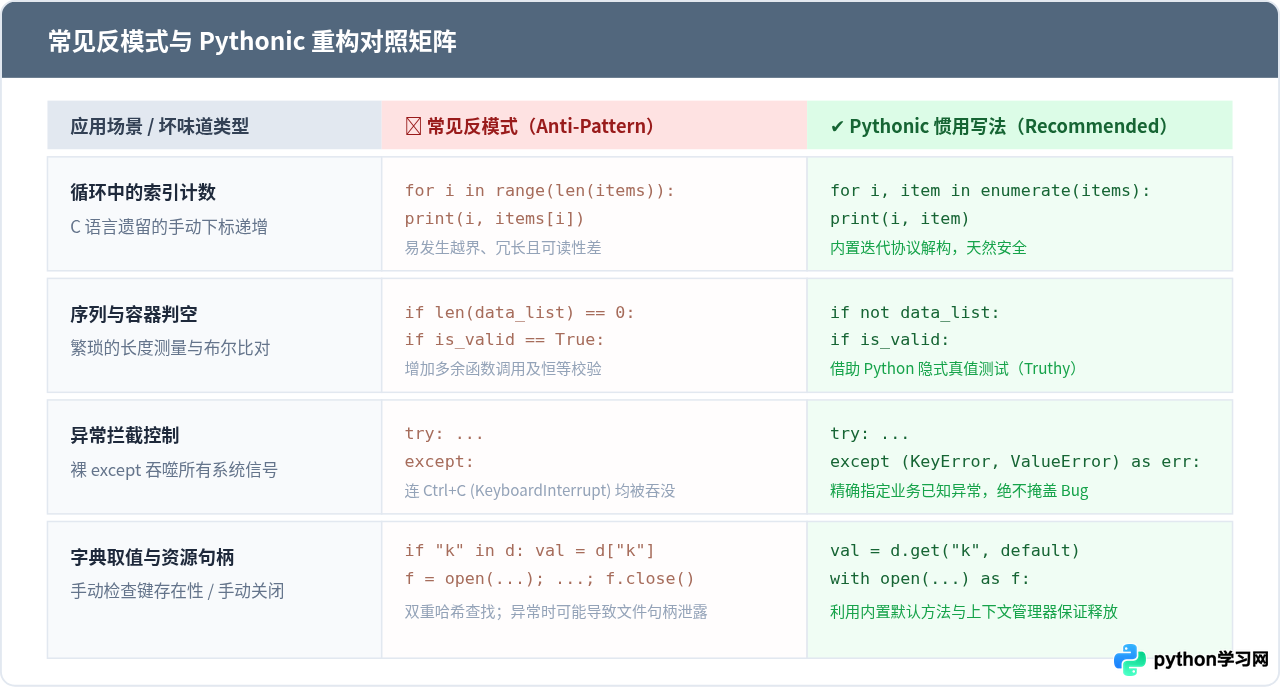
三、进阶习惯用法:写出地道的 Python 代码
在掌握基础排错之后,要使代码真正具备地道的 Pythonic 风格,还需要在思维层面习惯以下两种核心范式:
1. EAFP 优于 LBYL 哲学
在传统静态语言中,开发者通常遵循 LBYL(Look Before You Leap,三思而后行),即在操作前进行多层前置判断:
# LBYL 模式:两次哈希查询,且在并发场景下存在竞争冒险(Time-of-Check to Time-of-Use)
if "user_id" in session_data:
    user_id = session_data["user_id"]
else:
    user_id = "guest"
而 Python 倡导 EAFP(Easier to Ask for Forgiveness than Permission,求原谅比求许可容易)。对于字典安全读取,可以直接调用 session_data.get("user_id", "guest");对于复杂的对象访问,直接执行并在失败时捕获处理:
# EAFP 模式:直接执行预期操作,针对特定失败分支清晰处理
try:
    processor = plugin_registry[plugin_name]
    processor.execute(payload)
except KeyError:
    logger.error("未注册的插件: %s", plugin_name)
    raise InvalidPluginError(plugin_name)
2. 恰当运用推导式与生成器表达式
列表推导式(List Comprehension)是构建新序列的高效手段,其字节码执行速度显著快于显式的 for 循环与 append() 调用。但必须把握度:推导式中不要嵌套超过两层循环,也不要包含复杂的副作用逻辑。若仅用于单次流式消费,应优先使用小括号包裹的生成器表达式(Generator Expression),以最小化内存占用:
# 内存高效:直接向内置聚合函数传入生成器表达式,无须在内存中构造完整中间列表
total_revenue = sum(order.price * order.quantity for order in orders if order.is_paid)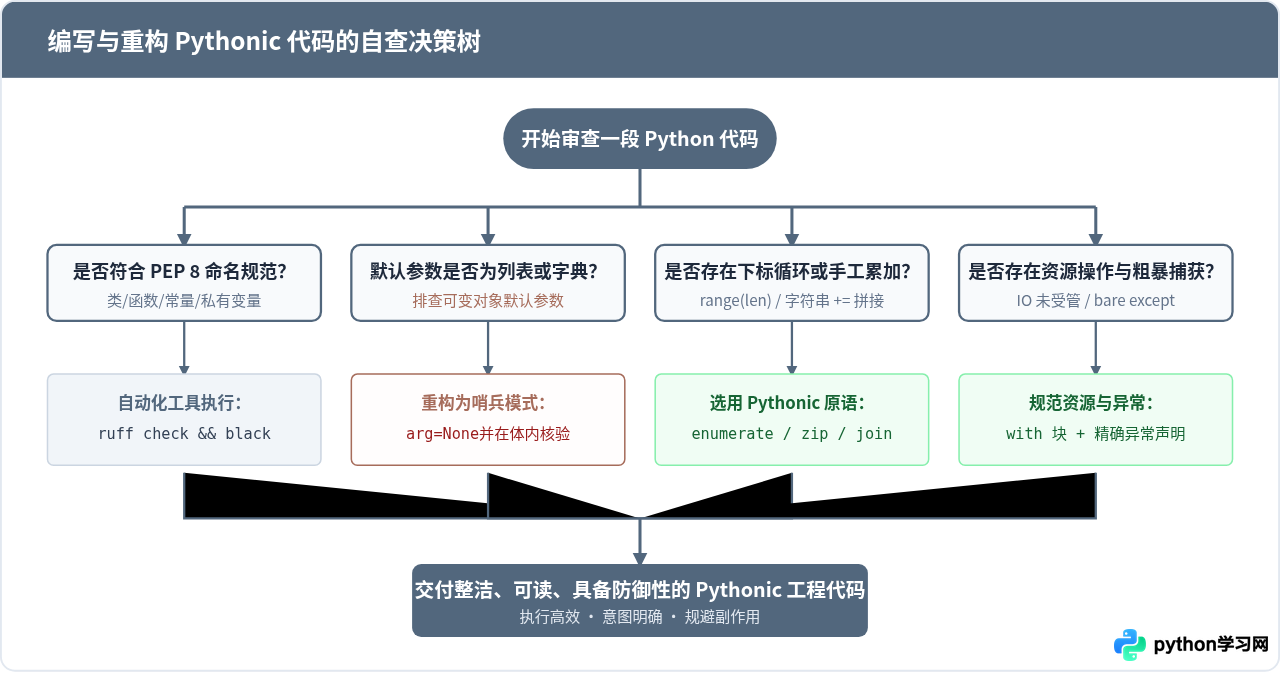
四、工程化避坑:如何将规范固化到团队日常流程
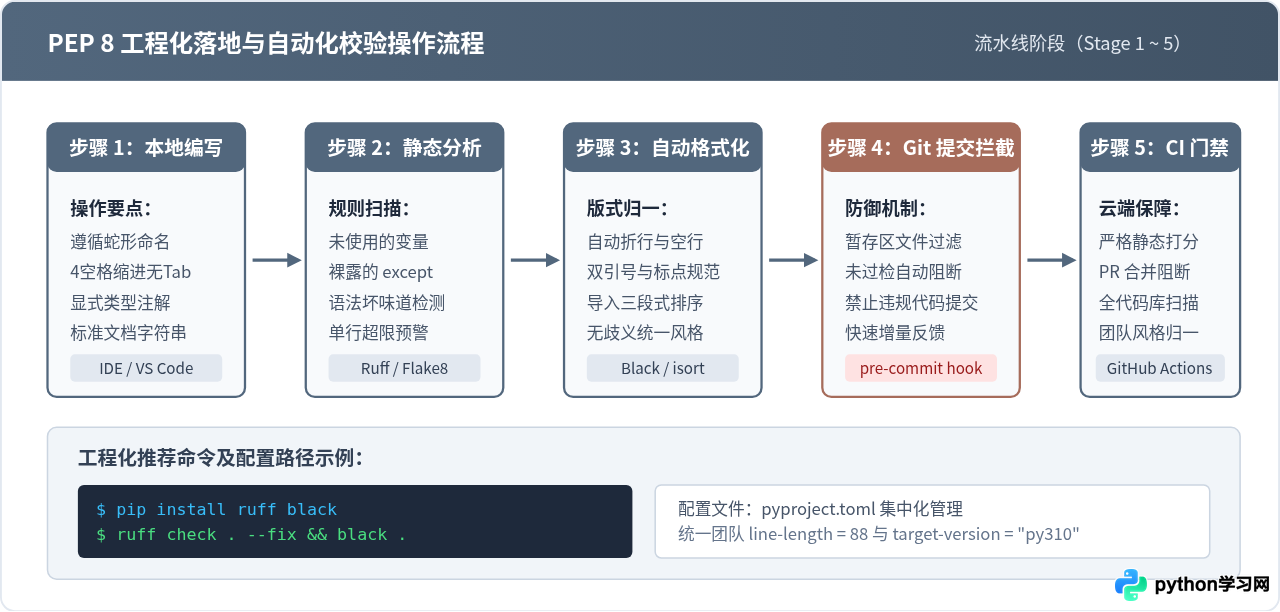
依靠人脑记忆和人工 Code Review 难以杜绝低级格式偏差与反模式。现代 Python 项目应当将规范固化在自动化流水线中:
- 统一使用 pyproject.toml 集中配置:避免在根目录下分散
.flake8、setup.cfg等过时配置文件。统一声明 Python 目标版本与单行宽度约束。 - 拥抱极速静态工具 Ruff:Ruff 基于 Rust 重写,能在数毫秒内扫描整个代码仓库,同时替代 Flake8、isort、pydocstyle 等十余个传统工具,并支持
--fix一键安全重构。 - 配置 pre-commit 钩子:在团队成员执行
git commit时拦截不符合规范的代码,确保进入代码仓库的每一行变更都具备统一排版。
# pyproject.toml 推荐工程配置示例
[tool.ruff]
line-length = 88
target-version = "py310"

[tool.ruff.lint]
select = [
    "E",   # pycodestyle 错误
    "W",   # pycodestyle 警告
    "F",   # Pyflakes 逻辑错误
    "I",   # isort 导入排序规范
    "B",   # flake8-bugbear 常见反模式拦截(如可变默认参数)
    "C4",  # flake8-comprehensions 推导式优化
    "UP",  # pyupgrade 现代 Python 语法升级建议
]
ignore = ["E501"]  # 格式化器 Black 已经控制换行,可忽略长行警告

[tool.black]
line-length = 88
target-version = ['py310']总结:编写 Pythonic 代码并不是单纯追求语法糖或炫技,而是秉持“明了胜于晦涩,简洁胜于复杂”的核心准则。当代码遵循 PEP 8 命名布局、规避共享状态与裸异常等隐式陷阱、善用原生的迭代与上下文管理原语时,不仅代码的执行效率得到保障,系统的鲁棒性与团队的协作效能也将获得显著提升。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









