

除了Pandas,Python还有哪些高级数据分析模块:SciPy与Statsmodels应用
深入探讨除了Pandas之外Python进阶数据分析的两大核心工具:SciPy与Statsmodels,提供详细的推断统计与计量建模应用指南。
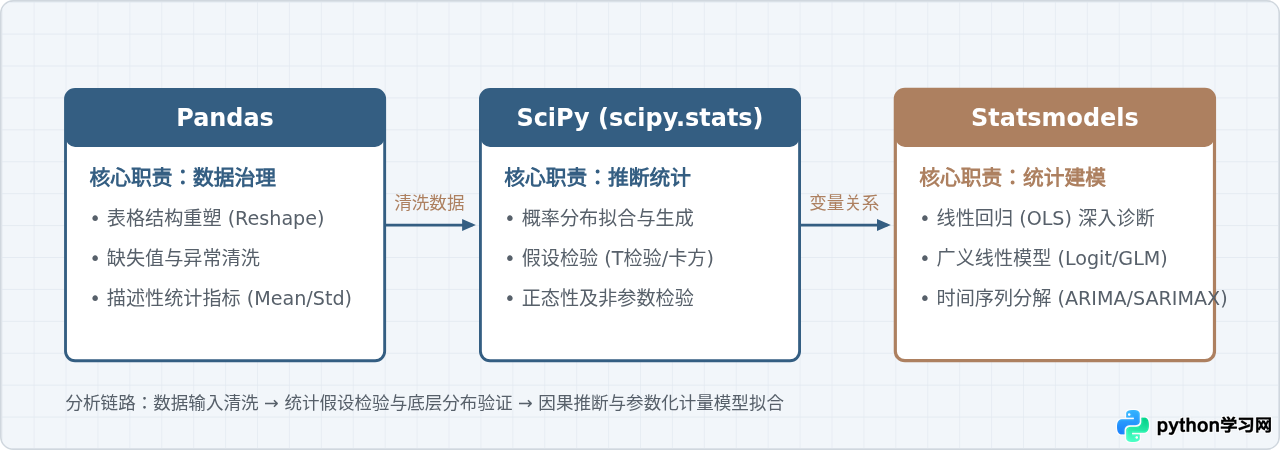
在Python数据分析流程中,Pandas擅长执行数据清洗、结构整理与聚合计算,但它主要聚焦于描述性分析。当业务问题需要从“样本数据表现如何”进一步深入到“变量差异是否由偶然导致”、“自变量对因变量的具体边际影响是多少”时,分析人员就需要推断统计与计量建模工具。SciPy与Statsmodels正是补足这一能力梯次的核心模块:SciPy提供数值计算与科学统计检验底层支持,Statsmodels则提供完整的计量统计模型与模型诊断输出。
工具边界与适用场景对比
在实际选择工具前,清晰识别各模块的边界是避免重构代码的前提。下表列举了三个库在实际数据分析任务中的关键分工:
| 功能维度 | Pandas | SciPy (stats) | Statsmodels |
|---|---|---|---|
| 核心对象 | Series, DataFrame | NumPy 数组, 连续/离散分布对象 | 公式接口 (Patsy), 模型拟合结果类 |
| 典型问题 | “两组用户的次日留存均值是多少?” | “两组留存差异是否具备统计显著性?” | “控制渠道后,版本更新对留存的净效应多大?” |
| 输出形式 | 清洗后表格、基本描述数值 | 检验统计量标量、p 值、自由度 | 详尽的统计学摘要表、置信区间、诊断残差 |
SciPy 在推断统计中的应用
SciPy 的子模块 scipy.stats 汇集了大量统计分布和假设检验方法。进行高级数据分析时,最常见的两个需求是:验证业务数据是否符合特定分布假设(如正态分布),以及在 A/B 测试或分组对照中进行均值差异检验。
1. 分布检验(Shapiro-Wilk 检验)
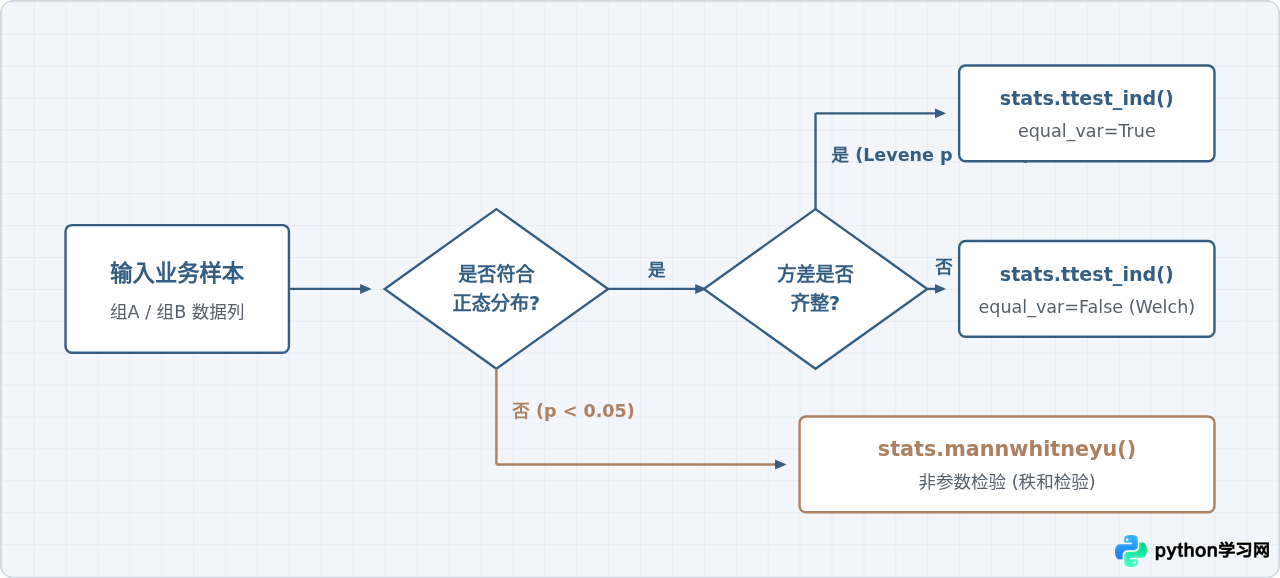
许多参数检验(如学生 t 检验)要求样本来自正态总体。盲目套用检验方法容易导致结论偏差。通过 stats.shapiro 可以快速验证小到中等样本量(N < 5000)的正态性:
import numpy as np
from scipy import stats

# 准备模拟数据:一组符合正态分布,另一组为偏态分布
np.random.seed(42)
normal_data = np.random.normal(loc=50, scale=10, size=100)
skewed_data = np.random.exponential(scale=10, size=100)

# 执行正态性检验
stat_norm, p_norm = stats.shapiro(normal_data)
stat_skew, p_skew = stats.shapiro(skewed_data)

print(f"正态数据检验统计量: {stat_norm:.4f}, p值: {p_norm:.4f}")
print(f"偏态数据检验统计量: {stat_skew:.4f}, p值: {p_skew:.4e}")
示例输出:
正态数据检验统计量: 0.9882, p值: 0.5283
偏态数据检验统计量: 0.8143, p值: 1.0927e-09判断规则:当显著性水平设定为 0.05 时,第一组数据的 p 值为 0.5283,大于 0.05,无法拒绝原假设,表明样本符合正态分布特征;第二组数据的 p 值远小于 0.05,拒绝原假设,属于非正态数据。
2. 两独立样本假设检验(Welch's t-test 与 Mann-Whitney U)
判断两组样本均值差异时,必须根据两组数据的方差齐性和分布状态选用合适算法。如果两组数据满足正态性但方差不齐,应采用 Welch's t-test(设置 equal_var=False);若数据严重偏态,则应退回到非参数检验 mannwhitneyu。
# 模拟对照组 (A) 与 实验组 (B)
group_a = np.random.normal(loc=12.0, scale=2.5, size=80)
group_b = np.random.normal(loc=13.2, scale=3.1, size=75)

# 方差齐性检验 (Levene 检验)
levene_stat, levene_p = stats.levene(group_a, group_b)

# 执行双样本 t 检验 (默认推荐使用 Welch's t 检验,防止方差不齐造成第一类错误膨胀)
t_stat, p_val = stats.ttest_ind(group_a, group_b, equal_var=(levene_p > 0.05))

print(f"方差齐性 p 值: {levene_p:.4f}")
print(f"均值检验统计量: {t_stat:.4f}, p 值: {p_val:.4f}")
示例输出:
方差齐性 p 值: 0.1135
均值检验统计量: -2.6341, p 值: 0.0093Statsmodels 在计量建模与回归诊断中的应用
SciPy 的 stats 模块解决了单变量或双变量的检验问题,但如果需要分析多个因素对目标指标的综合影响,Statsmodels 是首选。它支持基于类 R 语言语法(Patsy 公式)定义模型,并提供统计推断所需的系数标准误、t 值、F 检验以及多重共线性等全套诊断指标。
1. 普通最小二乘法(OLS 回归)与完整诊断
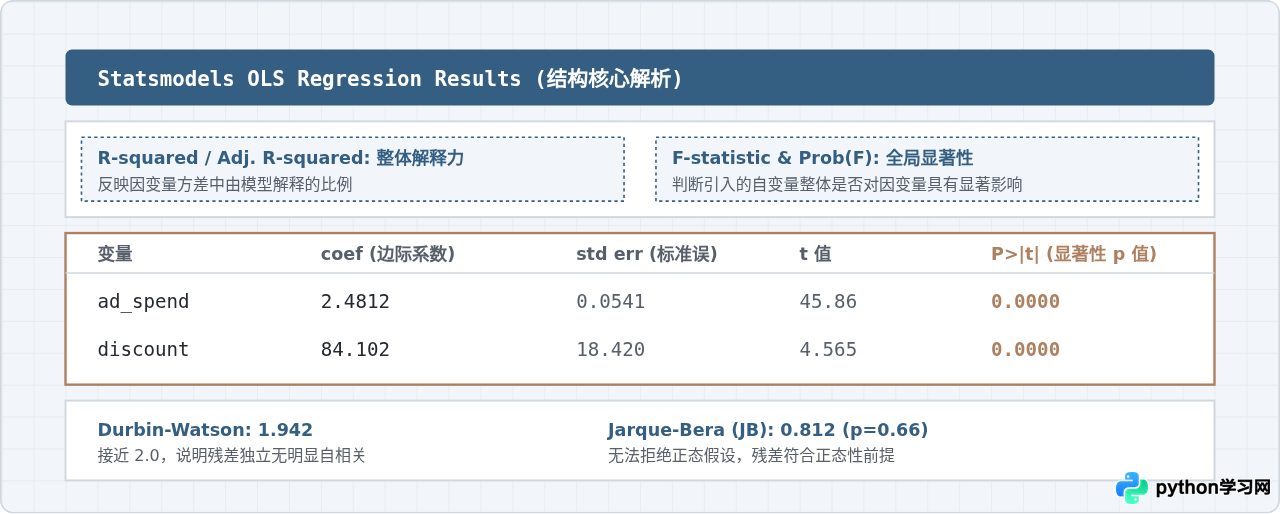
下面演示如何使用 statsmodels.formula.api 建立多元线性回归,并对结果摘要中的核心参数进行判读。
import pandas as pd
import statsmodels.formula.api as smf

# 构造具有线性关系的业务模拟数据
np.random.seed(101)
n = 120
ad_spend = np.random.uniform(10, 100, n)
discount = np.random.uniform(0.05, 0.30, n)
# 销售额 = 50 + 2.5 * 广告费用 + 80 * 折扣力度 + 噪声
sales = 50 + 2.5 * ad_spend + 80 * discount + np.random.normal(0, 15, n)

df = pd.DataFrame({
    'sales': sales,
    'ad_spend': ad_spend,
    'discount': discount
})

# 拟合 OLS 模型
model = smf.ols(formula='sales ~ ad_spend + discount', data=df).fit()
print(model.summary())
关键摘要指标解读表:
| 诊断指标 | 观察目标 | 标准参考值与含义 |
|---|---|---|
| R-squared / Adj. R-squared | 拟合优度 | 通常在 0 到 1 之间,越接近 1 说明模型解释的自变量方差比例越大。多变量时优先关注调整后 R²。 |
| P>|t| (变量 p 值) | 自变量显著性 | 如果小于 0.05,说明在控制其他变量后,该特征与因变量存在统计学上的线性相关关系。 |
| Durbin-Watson | 残差自相关性 | 数值接近 2.0 表明残差不存在一阶自相关;远低于 1.5 说明存在正自相关,时间序列分析中需格外警惕。 |
| Prob (F-statistic) | 整体模型有效性 | 若小于显著性水平(如 0.01),拒绝“所有自变量系数均为0”的联合假设。 |
2. 多重共线性诊断(方差膨胀因子 VIF)
在多元回归中,如果特征之间存在较强的线性相关,会导致系数估计的方差增大、符号反常。此时可以借助 statsmodels.stats.outliers_influence 计算方差膨胀因子(VIF):
from statsmodels.stats.outliers_influence import variance_inflation_factor

# 提取设计矩阵(包含常数项)
X = model.model.exog
feature_names = model.model.exog_names

vif_data = pd.DataFrame()
vif_data["Feature"] = feature_names
vif_data["VIF"] = [variance_inflation_factor(X, i) for i in range(X.shape[1])]
print(vif_data)判断原则:一般而言,VIF 大于 10(严格场景下大于 5)提示存在严重多重共线性,需要考虑剔除变量、主成分降维或更换为岭回归。
模块选型与落地路径
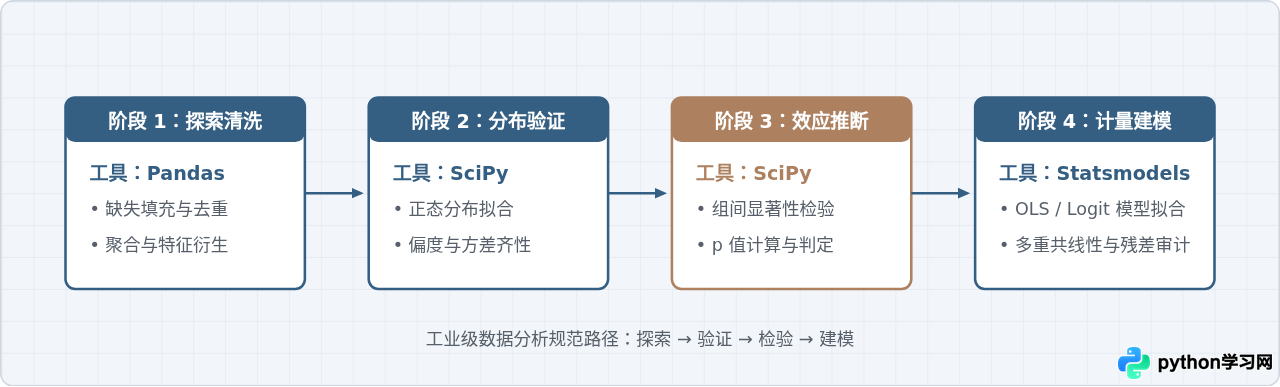
将上述模块组合使用,可以形成一套闭环的数据分析与建模流程:先用 Pandas 完成数据抽取、清洗与基本描述,然后利用 SciPy 进行统计学前提检验与组间差异确认,最后借助 Statsmodels 构建包含多变量控制的推断模型与因果解释。
总结
在数据分析从“汇总报表”向“深度归因”进阶的过程中:
- Pandas 是操作台,负责把杂乱的数据整理成标准二维表。
- SciPy 是检验尺,负责以最小的代码成本完成分布判断、单因素与双因素的假设检验。
- Statsmodels 是分析仪,负责控制混杂因素、输出详尽的统计推断报告与残差诊断。
掌握 SciPy 与 Statsmodels 的协同使用,能够让分析师在处理实际业务时,从单纯的“看图说话”过渡到“具备统计学严谨性的因果论证与参数量化”。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









