

Python基础怎么学才高效?新手必须掌握的5个核心概念
本文针对Python新手容易陷入的语法琐碎陷阱,提炼出高效学习路径与5个核心底层概念:对象引用、容器选型、分支循环、函数作用域及模块拆分,帮助初学者建立扎实的编程心智模型。
从“语法背诵”转向“模型理解”的学习路线
初学者在学习 Python 时,往往会花大量时间去通读厚重的语法手册。然而真正写代码时,最容易出现的问题通常不是“忘记了 print 怎么拼”,而是“不明白列表赋值后为什么改一个全变了”、“为什么在函数里给全局变量赋值会抛出 UnboundLocalError”,或者“面对一堆数据不知道该放进字典还是列表”。
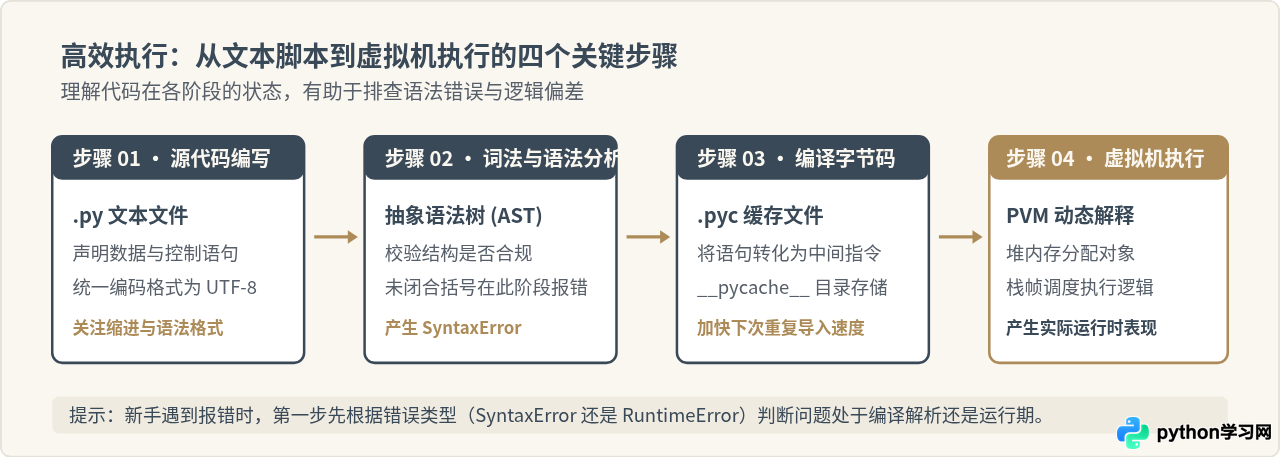
高效学习的核心原则是以模型带语法,以验证代记忆。执行一个 Python 文件的完整流程中,解释器首先将文本编译为字节码,并在 Python 虚拟机(PVM)中为各类数据动态分配内存地址与引用标签。只有先看清这个运转链条,你在写循环、写函数时才能准确预判代码的行为。
核心概念 1:变量、对象与引用机制
很多其他编程语言将变量比作一个“存放数据的盒子”,但在 Python 中,这种比喻会导致严重的心智偏差。在 Python 里,变量是一张贴在对象上的“便利贴标签”,而实际的数据(对象)存放在堆内存中。
理解“引用”最直接的方法,是区分可变对象(如 list、dict、set)与不可变对象(如 int、float、str、tuple)。不可变对象一旦在内存中创建,其内容就不可更改;对变量的重新计算或赋值,本质上是将标签撕下,贴到了新创建的对象上。
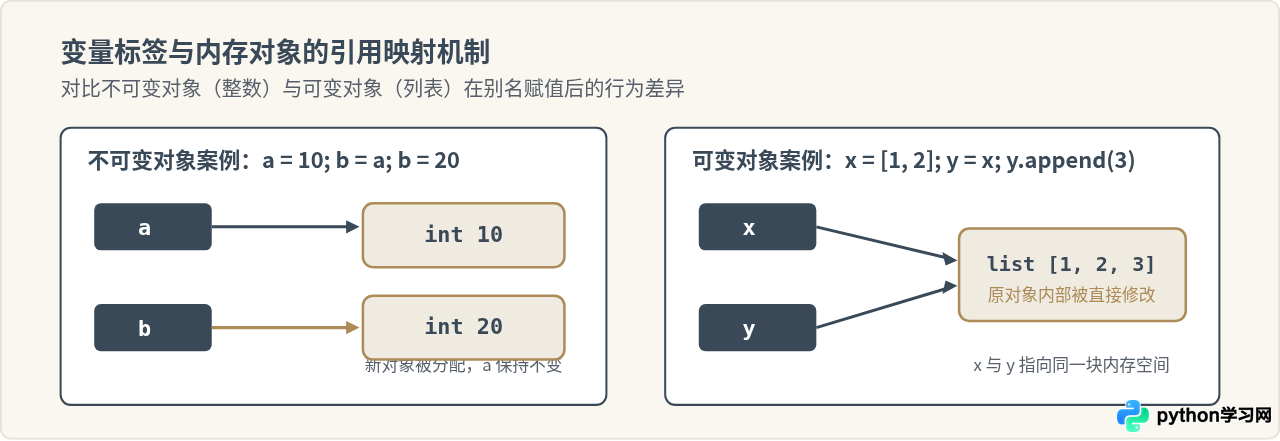
下面这段代码直观展示了由于没有意识到“引用传递”而引发的常见误区:
# 示例 1:误以为赋值会产生独立副本
source_list = [10, 20, 30]
target_list = source_list  # 只是多贴了一个标签,内存对象并未克隆

target_list.append(40)
print("source_list 结果:", source_list)
print("target_list 结果:", target_list)

# 示例 2:使用切片或 .copy() 建立独立副本
safe_copy = source_list.copy()
safe_copy.append(999)
print("修改安全副本后 source_list:", source_list)
print("安全副本 safe_copy:", safe_copy)
终端运行输出:
source_list 结果: [10, 20, 30, 40]
target_list 结果: [10, 20, 30, 40]
修改安全副本后 source_list: [10, 20, 30, 40]
安全副本 safe_copy: [10, 20, 30, 40, 999]id(variable) 内置函数可以随时查看变量指向的内存地址编号。如果在日常调试中发现某个数据被“意外改变”,优先检查是否将可变对象当成参数传递给了某个函数,并在其内部发生了原地(in-place)修改。
核心概念 2:容器类型及其选型标准
Python 提供了四种最常用的内置集合类型:列表(list)、字典(dict)、元组(tuple)和集合(set)。很多新手只使用列表处理所有数据,但面对几万条记录的高频查找时,代码运行效率会发生断崖式下跌。
选择数据结构的决定性标准是操作目标与时间复杂度:
- 列表 (List):有序、可变,通过整数索引(index)访问极快。但在无序列表中判断某个元素是否存在,需要从头遍历到尾。
- 字典 (Dictionary):键值对结构(Key-Value),底层基于哈希表(Hash Table)实现。查找、插入与删除指定 Key 的时间接近常量,无需逐个对比。
- 集合 (Set):本质是没有值(Value)的字典,天然去重,同样具备哈希查找的高性能。
- 元组 (Tuple):有序、不可变。用于存放固定不变的配置、坐标或者只读数据,防止代码逻辑在后续环节误改。
| 容器类型 | 核心特征 | 典型操作 | 最佳适用场景 |
|---|---|---|---|
list |
有序、可变、允许重复 | append(), pop(), [i] |
按顺序保存的待办清单、时间线记录、批量序列 |
dict |
键值映射、无序/保序、键唯一 | d[key], get(), keys() |
用户信息表、参数配置、需要通过唯一标识查找具体实体的场景 |
set |
无序、不可重复、基于哈希 | add(), & (交集), - (差集) |
用户标签快速去重、大规模白名单/黑名单的存在性检测 |
tuple |
有序、不可变、允许重复 | t[i], 解包 x, y = pos |
经纬度坐标、数据库连接只读配置、作为字典的复合键 |
# 示例:在大规模数据检索场景下对比 list 与 set
user_ids_list = list(range(100000))
user_ids_set = set(user_ids_list)

target_id = 99999

# set 查找基于 Hash,不需要逐一对比 10 万次
is_present = target_id in user_ids_set
print("检索目标存在:", is_present)
核心概念 3:控制流与数据遍历逻辑
掌握了数据存储后,下一步就是通过条件分支(if / elif / else)和循环(for / while)控制执行路径。Python 循环最核心的哲学是直接遍历可迭代对象本身,而非通过索引递增访问。
在其他语言中,你可能会习惯写出 for i in range(len(items)): print(items[i])。而在 Python 中,推荐直接使用 for item in items:,或者在必须使用下标时使用 enumerate()。
tasks = ["环境配置", "核心概念梳理", "独立项目实践"]

# 规范做法:同时获取序号与内容
for index, task in enumerate(tasks, start=1):
    if "环境" in task:
        print(f"优先级高:任务 {index} - {task}")
    else:
        print(f"标准推进:任务 {index} - {task}")
终端运行输出:
优先级高:任务 1 - 环境配置
标准推进:任务 2 - 核心概念梳理
标准推进:任务 3 - 独立项目实践
核心概念 4:函数封装与变量作用域(LEGB 规则)
随着代码逻辑扩充,将重复代码提取为函数是编写整洁程序的第一步。函数不仅接收参数并返回值,更重要的是在执行时会开辟属于它自己的局部命名空间(Local Namespace)。
初学者最常遇到的困惑之一,是在函数内部无法修改外部变量。Python 解析变量名遵循严格的 LEGB 规则:
- L (Local):函数或方法内部定义的局部变量。
- E (Enclosing):嵌套函数中外层(闭包)函数的局部命名空间。
- G (Global):当前
.py脚本模块顶层声明的全局变量。 - B (Built-in):Python 内置名字空间(如
len、range、print等)。
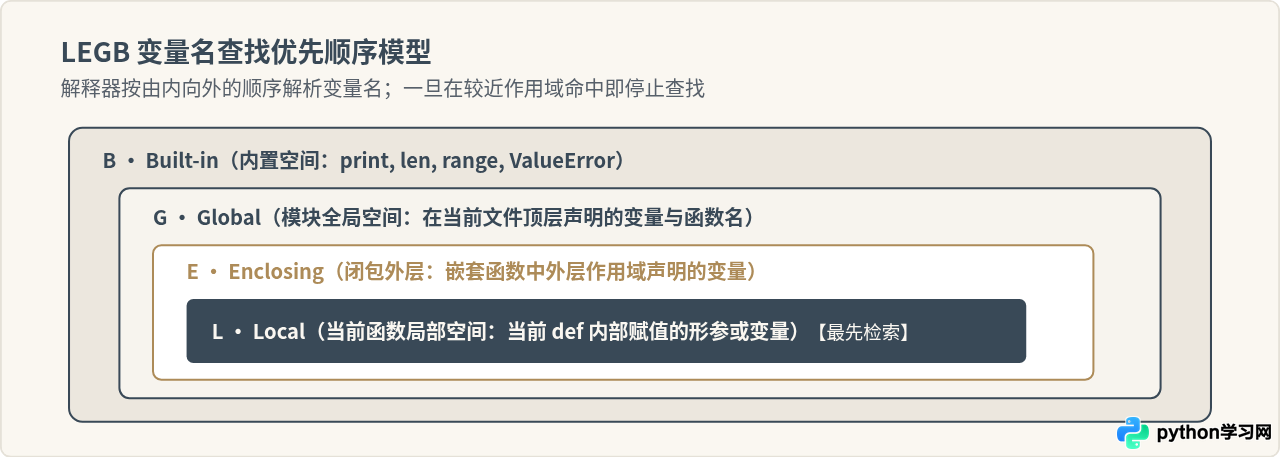
看清这个查找链条后,就能立刻理解下面这个经典报错的原因:
# 常见报错示例:混淆读取与重新绑定
total_count = 100

def increment():
    # 错误分析:解释器扫描到内部有 total_count += 1(包含赋值语句),
    # 便会将 total_count 标记为局部变量。
    # 但在执行等号右侧读取时,局部变量尚未完成赋值,从而抛出 UnboundLocalError。
    # 正确的做法应是通过参数传入并返回,或显式声明 global(尽量少用全局变量)。
    global total_count
    total_count += 1

increment()
print("全局计数值更新为:", total_count)
核心概念 5:模块拆分与工程复用机制
单个脚本代码超过 200 行后,如果不做拆分,调试和维护成本会迅速攀升。Python 的模块(Module)就是单个 .py 文件,而包(Package)就是包含 __init__.py 的文件夹。
要让不同模块之间顺利导入(import),关键在于理解 Python 是如何定位文件的:解释器会按顺序检索 sys.path 列表中的路径。当前脚本所在的目录默认排在第一位,随后是系统库目录及第三方包安装目录(site-packages)。
if __name__ == "__main__": 保护执行逻辑。这样即使该文件后续被其他模块作为工具包 import 引入,其顶层的测试代码或启动语句也不会被动重复执行。
# utils.py 内容示例
def format_data(raw_text):
    return raw_text.strip().lower()

# 保护块:只有直接运行 python utils.py 时才会执行下列代码
if __name__ == "__main__":
    test_result = format_data("  Hello World  ")
    print("工具函数独立测试结果:", test_result)
总结:5个核心概念的联动逻辑与学习建议
掌握这 5 个核心概念并不是孤立的过程,它们在实际工程中形成了一个严密互锁的心智模型:由变量与引用决定数据如何安全流转,通过容器选型决定数据高效归类,依靠控制流程驱动业务走向,借助函数作用域实现功能隔离,最终通过模块化拆分组合出结构清晰的完整项目。
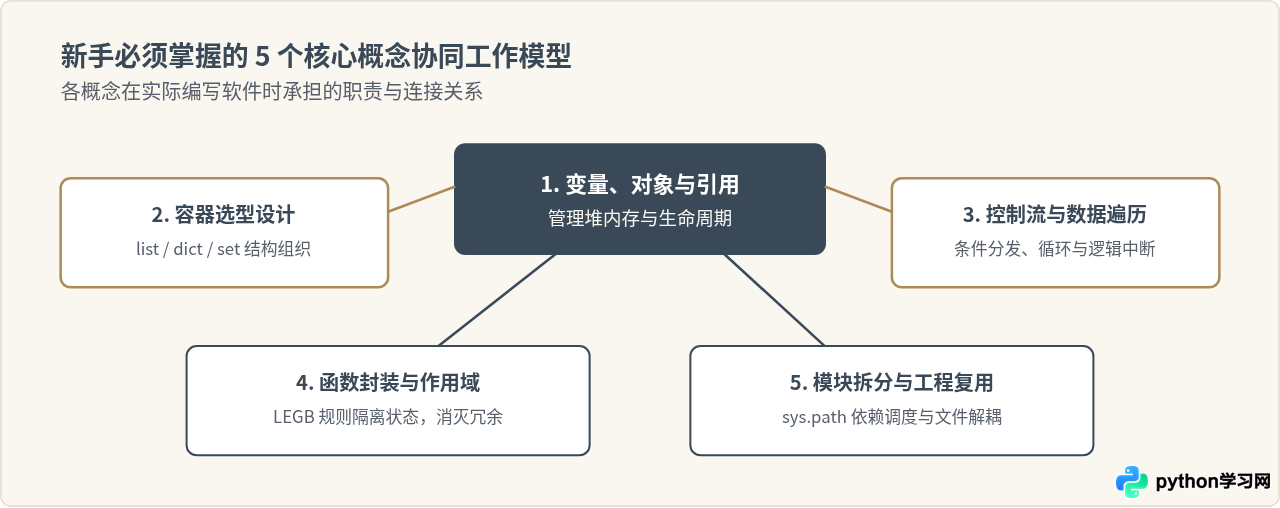
在接下来的练习中,建议停止无目的地翻看语法书,而是围绕这 5 个点进行“小而完整”的场景编码:写一个文件去重脚本、一个基于字典的学生成绩查询器,或者一个多文件组织的小型爬虫。遇到任何语法现象时,多用 print(type(x)) 和 print(id(x)) 观察对象的真实状态。这样积累的知识,才能在后续走向数据处理、自动化脚本或 Web 开发时随时调动、稳定发挥。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









