

Python二分查找算法的迭代与递归实现代码
详解Python二分查找算法的迭代与递归实现代码,包含基础查找、重复元素左边界定位、时间与空间复杂度对比以及标准库bisect的实用选型建议。
在已排序的序列中定位特定元素时,二分查找(Binary Search)通过每次将搜索范围缩小一半,把时间复杂度从线性查找的 O(n) 降低到 O(log n)。在 Python 中,二分查找既可以通过 while 循环维护左右边界指针的迭代方式实现,也可以通过函数自我调用传递子区间边界的递归方式实现。本文将直接给出这两种写法的完整可执行代码,拆解区间边界与中点索引的控制细节,并结合 Python 语言运行机制说明两者的取舍依据及重复元素场景下的扩展写法。
一、二分查找的适用前提与折半推导过程
编写二分查找代码前,必须确认目标序列同时满足两个前提条件:第一,序列中的元素已经按照单调顺序(升序或降序)排列;第二,数据结构支持通过下标进行O(1) 时间复杂度的随机访问(例如 Python 的 list 或 tuple,而链表即便有序也不适合直接进行二分查找)。
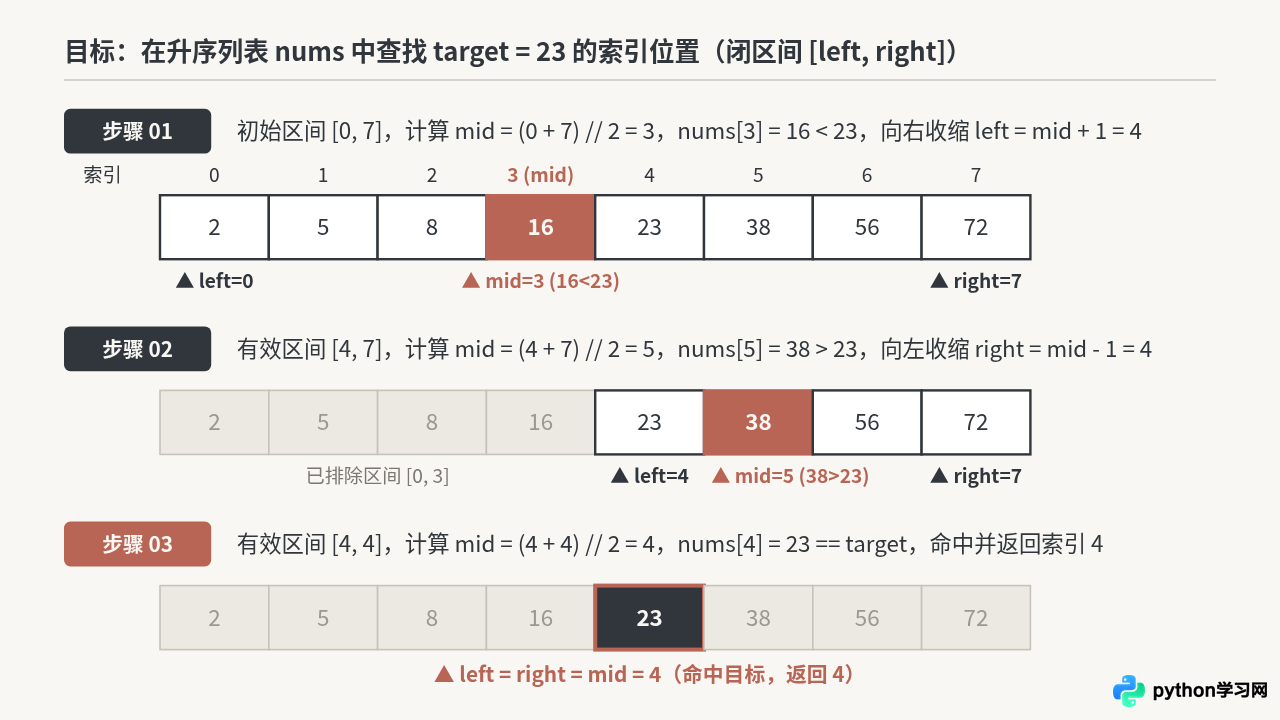
以升序列表为例,算法的核心逻辑是在闭区间 [left, right] 内不断取中点索引 mid,并将 nums[mid] 与目标值 target 比较:若相等则直接返回 mid;若 nums[mid] < target,说明中点及其左侧元素全部小于目标值,下一轮只需在右半区间 [mid + 1, right] 内查找;反之则在左半区间 [left, mid - 1] 内查找。当 left > right 时,搜索区间为空,判定目标值不存在并返回 -1。
二、二分查找的迭代实现代码(推荐首选)
在日常开发与算法工程中,迭代法是实现二分查找的首选方案。它仅通过两个整型变量 left 和 right 在单个函数栈帧内循环更新区间边界,空间复杂度严格保持为 O(1),不会产生额外的函数调用开销。
1. 完整可执行代码
以下脚本兼容 Python 3.8 及以上版本。你可以将其保存为当前工作目录下的 binary_search_iterative.py 文件并在终端直接执行:
# 文件名: binary_search_iterative.py
# 运行环境: Python 3.8+

from typing import Sequence


def binary_search_iterative(nums: Sequence[int], target: int) -> int:
    """
    使用迭代法在升序序列 nums 中查找 target。
    找到则返回对应索引,未找到则返回 -1。
    """
    left: int = 0
    right: int = len(nums) - 1

    # 在闭区间 [left, right] 内循环查找
    while left <= right:
        # 计算中间位置索引,整除符号 // 向下取整
        mid: int = left + (right - left) // 2
        mid_val: int = nums[mid]

        if mid_val == target:
            return mid
        elif mid_val < target:
            # 目标在右半区间 [mid + 1, right]
            left = mid + 1
        else:
            # 目标在左半区间 [left, mid - 1]
            right = mid - 1

    return -1


if __name__ == "__main__":
    sample_nums = [2, 5, 8, 16, 23, 38, 56, 72]
    print("查找存在的元素 23,返回索引:", binary_search_iterative(sample_nums, 23))
    print("查找首部元素 2,返回索引:", binary_search_iterative(sample_nums, 2))
    print("查找不存在的元素 19,返回索引:", binary_search_iterative(sample_nums, 19))
在终端或命令行窗口中进入脚本所在目录,执行以下命令:
python3 binary_search_iterative.py示例输出结果如下:
# 示例输出
查找存在的元素 23,返回索引: 4
查找首部元素 2,返回索引: 0
查找不存在的元素 19,返回索引: -1
2. 关键实现细节说明
- 循环条件为什么是
left <= right而不是left < right?因为初始化时right = len(nums) - 1,查找区间是左闭右闭的[left, right]。当left == right时,区间[left, left]内仍然包含一个尚未检查的元素(如上图中第 3 步的[4, 4])。如果写成left < right,就会漏掉这最后一个元素的比对。 - 更新边界时为什么必须加减 1?当确认
nums[mid] != target后,索引mid已经明确不是答案。如果不排除mid而直接写left = mid或right = mid,在left == right时会陷入无限循环。 - 关于
left + (right - left) // 2与整数溢出:在 C、C++ 或 Java 等固定位宽整数语言中,left + right可能超过 32 位整型上限导致溢出变成负数。而在 Python 3 中,int类型原生支持任意精度大整数,不会发生整型溢出,直接写(left + right) // 2在结果上完全等价且略快一点;保留left + (right - left) // 2主要是为了跨语言代码习惯的一致性。
// 计算中点索引。如果误用单斜杠 /,计算结果会变成浮点数(例如 3.5 或 4.0),传入 nums[mid] 时会立刻抛出 TypeError: list indices must be integers or slices, not float 异常。
三、二分查找的递归实现代码
递归实现将“在整个列表中查找目标值”拆解为结构完全相同的子问题:“在左半子区间或右半子区间中查找目标值”。理解递归写法有助于后续掌握二叉搜索树(BST)、归并排序和分治算法。
1. 完整可执行代码
将以下代码保存为同一目录下的 binary_search_recursive.py。为了避免调用方每次都手动传入起止下标,这里使用默认参数 left=0 和 right=None 封装统一的外部接口:
# 文件名: binary_search_recursive.py
# 运行环境: Python 3.8+

from typing import Optional, Sequence


def binary_search_recursive(
    nums: Sequence[int],
    target: int,
    left: int = 0,
    right: Optional[int] = None,
) -> int:
    """
    使用递归法在升序序列 nums 的闭区间 [left, right] 内查找 target。
    找到则返回对应索引,未找到则返回 -1。
    """
    if right is None:
        right = len(nums) - 1

    # 递归终止条件 1:区间为空,未找到目标值
    if left > right:
        return -1

    mid: int = (left + right) // 2
    mid_val: int = nums[mid]

    # 递归终止条件 2:命中目标值
    if mid_val == target:
        return mid
    elif mid_val < target:
        # 递归查找右半区间 [mid + 1, right]
        return binary_search_recursive(nums, target, mid + 1, right)
    else:
        # 递归查找左半区间 [left, mid - 1]
        return binary_search_recursive(nums, target, left, mid - 1)


if __name__ == "__main__":
    sample_nums = [2, 5, 8, 16, 23, 38, 56, 72]
    print("递归查找 23,返回索引:", binary_search_recursive(sample_nums, 23))
    print("递归查找 72,返回索引:", binary_search_recursive(sample_nums, 72))
    print("递归查找 99,返回索引:", binary_search_recursive(sample_nums, 99))
在终端运行该脚本:
python3 binary_search_recursive.py示例输出结果如下:
# 示例输出
递归查找 23,返回索引: 4
递归查找 72,返回索引: 7
递归查找 99,返回索引: -1
2. 为什么递归时传递下标而不是列表切片?
不少初学者在写递归版二分查找时,喜欢写成 binary_search_recursive(nums[:mid], target)。这种切片写法是错误的工程习惯,原因有两点:
- 破坏时间与空间复杂度:Python 列表切片
nums[:mid]会分配新内存并复制一半的元素,单次切片耗时 O(k)。这会导致二分查找的整体时间复杂度从 O(log n) 退化为 O(n),空间复杂度也退化为 O(n)。 - 丢失原始下标:切分右半部分
nums[mid+1:]后,新列表的下标从 0 重新开始,返回时还必须手动加上偏移量mid + 1,极易在未找到返回-1时把偏移量错加进去变成正数。因此,始终传入原列表引用配合left、right游标才是正确做法。
四、迭代与递归的运行机制对比及取舍判断
虽然迭代版和递归版的时间复杂度同为 O(log n),但在 Python 解释器(CPython)中,两者的底层执行效率与内存开销存在明显差异。
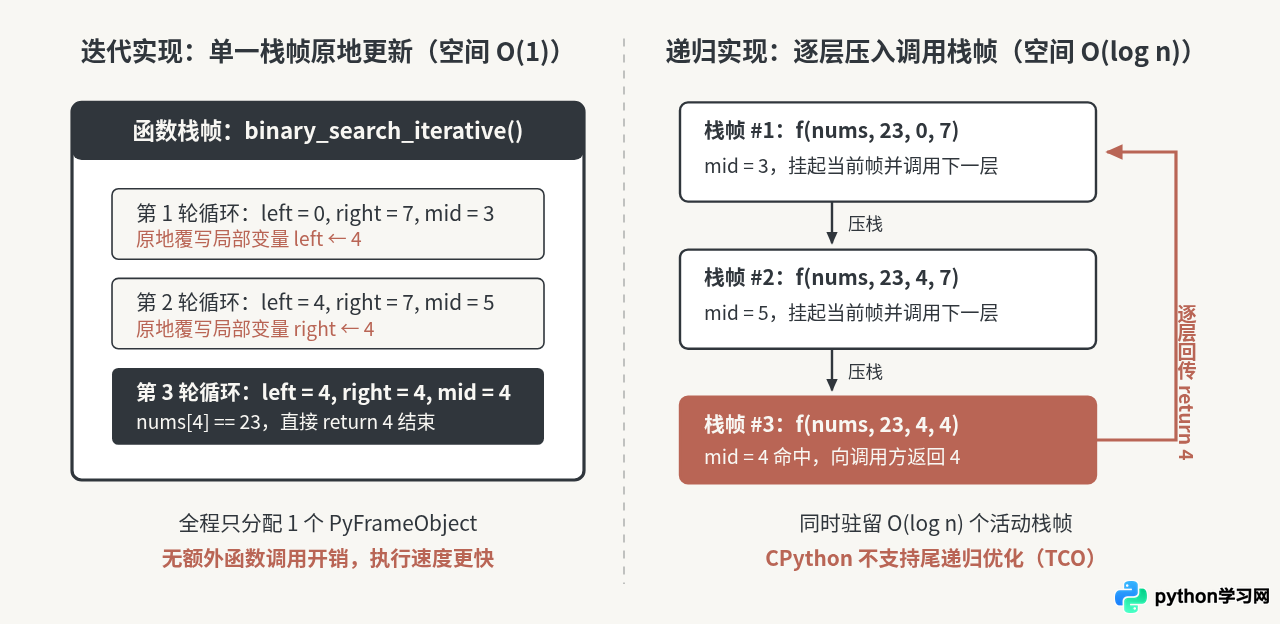
有人会认为上面递归代码中的 return binary_search_recursive(...) 属于尾递归(Tail Recursion),编译器或解释器会自动将其优化为循环。这一判断在 Python 中并不成立。Python 官方解释器 CPython 为了保留完整的异常回溯堆栈(Traceback)以及支持动态作用域特性,没有实现尾递归消除优化。每次递归调用都会真实创建一个新的栈帧对象。
不过,也需要客观评估递归深度的实际风险:Python 默认的最大递归深度通常为 1000(可通过 import sys; sys.getrecursionlimit() 查看)。由于二分查找的递归深度为 $\lfloor\log_2 n\rfloor + 1$,哪怕列表包含 10 亿($10^9$)个元素,最大递归层数也只有约 30 层,远低于 1000 层的限制。因此,正确编写的二分查找递归代码在常规内存规模下不会触发 RecursionError,它慢于迭代法的主要原因是 Python 函数调用本身的字节码调度开销。
| 对比维度 | 迭代实现(while 循环) | 递归实现(函数自调用) |
|---|---|---|
| 时间复杂度 | O(log n),常数因子小,无函数调用开销 | O(log n),每次折半伴随一次 Python 函数调用开销 |
| 空间复杂度 | O(1),仅占用固定数量的局部变量 | O(log n),需在调用栈中保存每一层的参数与返回地址 |
| 尾递归优化 | 无需优化,本身即为循环结构 | CPython 不支持尾递归优化,无法自动转为循环 |
| 适用场景 | 生产环境代码、高频查询、算法竞赛与面试标准写法 | 算法教学演示、分治思想推导、与树形递归保持统一风格时 |
五、进阶场景:包含重复元素时的左边界查找与 bisect 模块
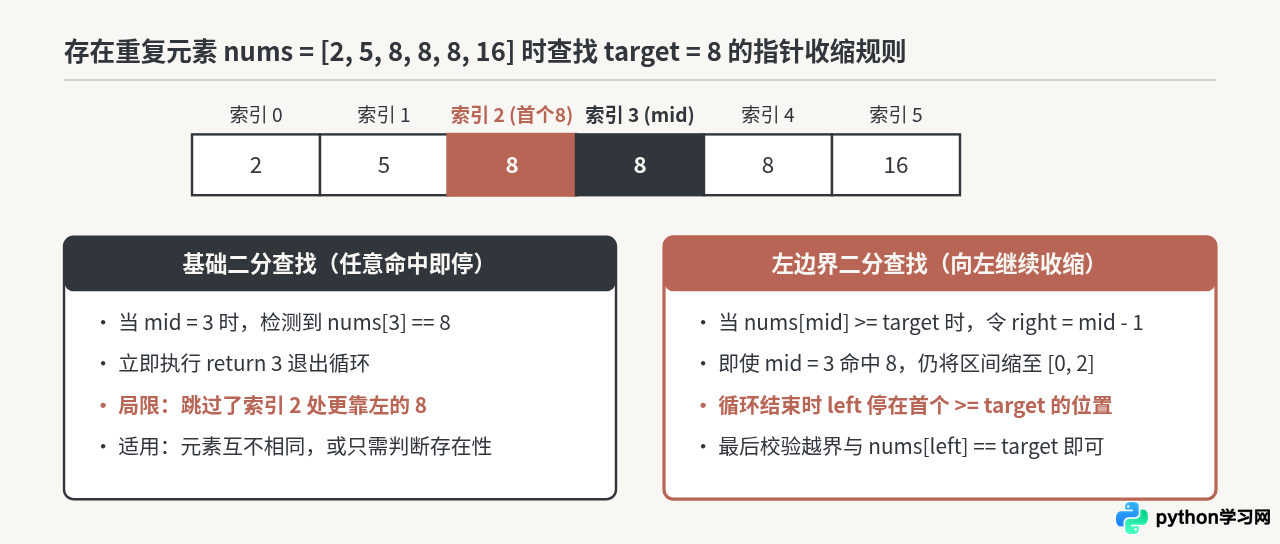
前面给出的基础迭代与递归代码有一个重要的适用边界:当列表中存在多个相同的目标值(例如 [2, 5, 8, 8, 8, 16] 中查找 8)时,基础二分查找一旦在中间某个 8 处命中就会立即返回,无法保证返回的是第一个 8(左边界)还是最后一个 8(右边界)。
1. 查找重复元素首次出现的位置(左边界)
如果业务要求“定位目标值第一次出现的索引”,就不能在 nums[mid] == target 时直接返回,而应当记录当前位置(或继续压缩右边界 right = mid - 1),继续向左半区间探索是否还有更靠前的相同元素。
2. 手写左边界查找与标准库 bisect 对照代码
在实际项目开发中,除非是面试考核手写算法,否则无需重复造轮子,应当直接使用 Python 标准库内置的 bisect 模块。bisect 底层使用 C 语言实现了二分查找,不仅边界处理经过严格验证,而且运行速度远快于纯 Python 循环。以下代码同时展示了手写左边界查找与 bisect_left 的等价封装,可保存为 binary_search_bounds.py 运行:
# 文件名: binary_search_bounds.py
# 运行环境: Python 3.8+

import bisect
from typing import Sequence


def find_first_occurrence(nums: Sequence[int], target: int) -> int:
    """手写迭代法:查找 target 在升序列表 nums 中第一次出现的索引。"""
    left: int = 0
    right: int = len(nums) - 1

    while left <= right:
        mid: int = (left + right) // 2
        if nums[mid] >= target:
            # 命中或偏大时,继续向左半区间 [left, mid - 1] 挤压
            right = mid - 1
        else:
            left = mid + 1

    # 循环结束时 left 指向第一个 >= target 的位置,需检查是否越界及是否相等
    if left < len(nums) and nums[left] == target:
        return left
    return -1


def bisect_search(nums: Sequence[int], target: int) -> int:
    """使用标准库 bisect.bisect_left 查找 target 首次出现的索引。"""
    idx: int = bisect.bisect_left(nums, target)
    if idx < len(nums) and nums[idx] == target:
        return idx
    return -1


if __name__ == "__main__":
    dup_nums = [2, 5, 8, 8, 8, 16, 23]
    print("手写左边界查找 8:", find_first_occurrence(dup_nums, 8))
    print("标准库 bisect 查找 8:", bisect_search(dup_nums, 8))
    print("标准库 bisect 查找不存在的 10:", bisect_search(dup_nums, 10))
执行命令:
python3 binary_search_bounds.py示例输出结果:
# 示例输出
手写左边界查找 8: 2
标准库 bisect 查找 8: 2
标准库 bisect 查找不存在的 10: -1bisect.bisect_left(nums, target) 返回的是“将 target 插入原有序序列且维持升序的最左插入点”,而不是直接返回查找结果。当 target 大于列表中所有元素时,bisect_left 会返回 len(nums)。因此在读取 nums[idx] 之前,必须先判断 idx < len(nums),否则会触发 IndexError: list index out of range。
六、实现方案选型与核心要点总结
为了在实际编码时快速选定合适的二分查找实现方式,并避免出现死循环或越界错误,可以参考下图的决策路径与检查清单:
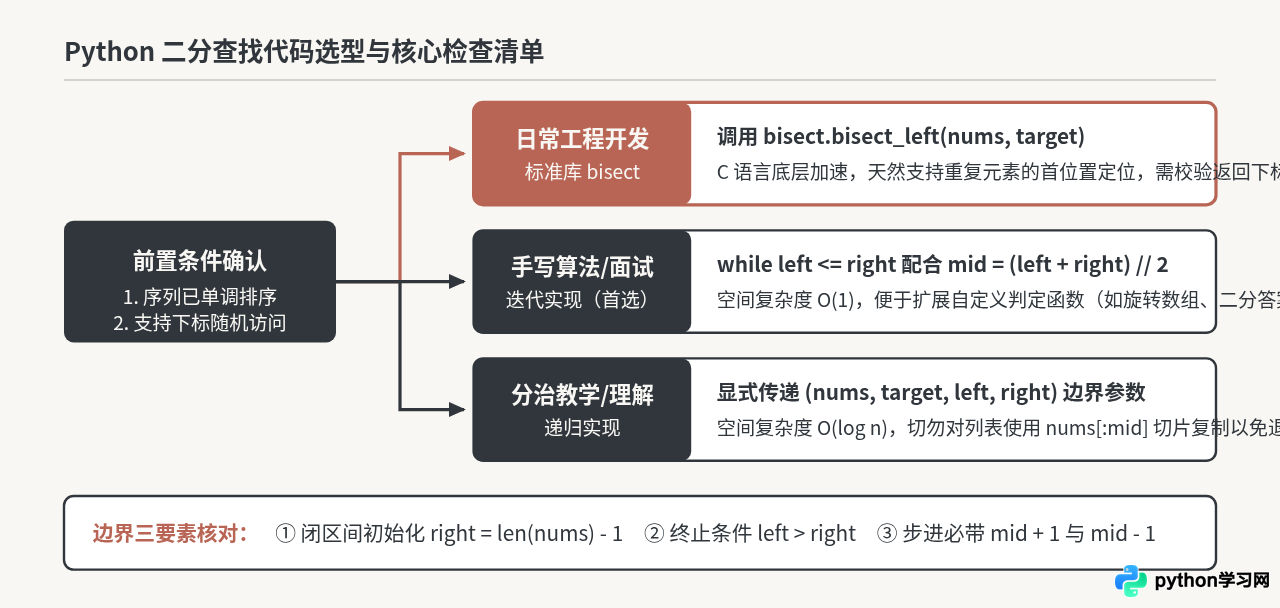
综合来看,编写 Python 二分查找代码时只需把握三条准则:在业务项目里优先调用标准库 bisect.bisect_left;在需要手写算法或自定义折半条件时采用闭区间 while left <= right 的迭代实现;如果采用递归写法,务必通过传递 left 与 right 索引参数来缩小范围,避免使用列表切片复制数据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









