

为什么有人一周学会Python却找不到工作?速成学习的局限与真相
深入剖析一周速成Python与企业实际用人需求之间的本质差距,从语法掌握到工程落地的技能鸿沟,提供真正面向就业的Python学习路径与能力检验标准。
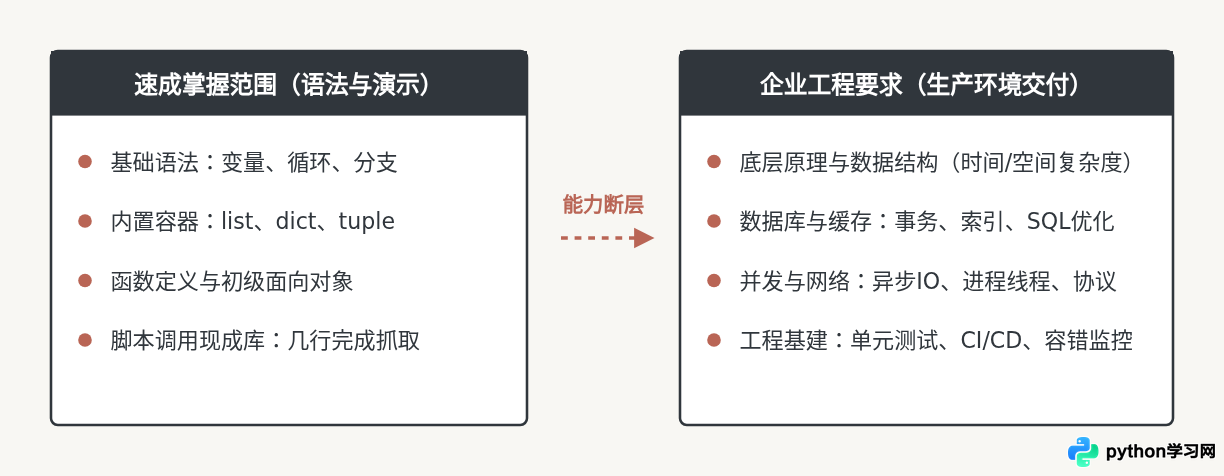
“一周学会 Python”所掌握的通常只是基本语法与简单脚本编写,而企业招聘考察的是在复杂业务约束下交付可靠软件的工程能力,二者在知识密度、排错经验与工程规范上存在根本性断层,导致速成学习者无法直接跨入专业开发岗位。
一、速成的“学会”与就业的“合格”并非同一件事
很多零基础学习者在一周内跟着教程完成了环境安装,跑通了 print("Hello World"),能默写列表推导式、定义函数,甚至用第三方库几行代码抓取了一个静态网页。在这个节点上,学习者往往会产生“我已经掌握了 Python”的确定感。这种掌握是真实的,但它仅限于对编程语言符号规则的理解。
商业软件开发的核心并不是默写语法规则,而是处理不确定性。一个职业研发岗位要求开发者面对的是模糊的需求、庞大的历史代码库、不稳定的网络环境、并发读写冲突以及安全漏洞防御。掌握语言语法只是获得了一把刻刀,而企业付薪水购买的是雕刻精细构件的能力。
二、具体代码示例:脚本思维与生产代码的差异
为了直观说明这种差距,我们来看一个具体的业务场景:从第三方接口抓取一批用户数据,并将其入库更新。
1. 速成阶段的典型实现(脚本思维)
速成学习者写出来的代码通常关注“单次正常跑通”:
import requests
import sqlite3

def sync_users():
    conn = sqlite3.connect("app.db")
    cursor = conn.cursor()
    # 假设获取前 10 页数据
    for page in range(1, 11):
        res = requests.get(f"https://api.example.com/users?page={page}")
        data = res.json()
        for item in data["items"]:
            cursor.execute(
                f"INSERT INTO users VALUES ('{item['id']}', '{item['name']}')"
            )
    conn.commit()
    conn.close()

sync_users()
这段代码在本地运行一次大概率没有报错,但如果直接放到生产环境,会存在严重隐患:
- 安全性漏洞:使用字符串拼接 SQL(
f"INSERT INTO..."),存在 SQL 注入风险。 - 容错与健壮性缺失:网络抖动、对方返回 500、连接超时或 JSON 格式异常未做任何捕获。一旦第 5 页报错,程序立刻崩溃,已执行的数据处于未受保护的断续状态。
- 效率与连接管理缺陷:频繁发起裸 HTTP 请求而没有连接复用;单条循环执行
INSERT缺乏批处理与事务边界控制。
2. 工程级交付的代码结构(生产思维)
在专业岗位上,即便是处理相同逻辑,开发者需要考虑资源释放、超时控制、参数化防注入、重试机制以及日志追踪:
import logging
import sqlite3
from typing import List, Dict, Any
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

logger = logging.getLogger(__name__)

class UserSyncService:
    def __init__(self, db_path: str, timeout: int = 5):
        self.db_path = db_path
        self.timeout = timeout
        self.session = self._init_session()

    def _init_session(self) -> requests.Session:
        session = requests.Session()
        retries = Retry(total=3, backoff_factor=0.5, status_forcelist=[500, 502, 503, 504])
        session.mount("https://", HTTPAdapter(max_retries=retries))
        return session

    def fetch_page(self, page: int) -> List[Dict[str, Any]]:
        url = "https://api.example.com/users"
        try:
            resp = self.session.get(url, params={"page": page}, timeout=self.timeout)
            resp.raise_for_status()
            payload = resp.json()
            return payload.get("items", [])
        except (requests.RequestException, ValueError) as err:
            logger.error("Failed to fetch page %d: %s", page, err)
            raise

    def batch_save_users(self, users: List[Dict[str, Any]]) -> None:
        if not users:
            return
        records = [(u["id"], u["name"]) for u in users if "id" in u and "name" in u]
        # 使用上下文管理器确保事务正确提交与连接释放
        with sqlite3.connect(self.db_path) as conn:
            cursor = conn.cursor()
            # 使用参数化查询防注入,executemany 提高写入吞吐
            cursor.executemany(
                "INSERT OR REPLACE INTO users (id, name) VALUES (?, ?)",
                records
)两者的根本区别不在于掌握的英文保留字多少,而在于是否具备防卫性设计、异常处理、性能评估以及系统维护意识。这些经验无法单凭背诵语法速成,必须在真实排错与调试中积累。
三、从初学到就业的能力进阶模型
求职市场对“会 Python”的定义通常对应着不同层级的技术积累。我们可以把技能成长分为四个阶梯:
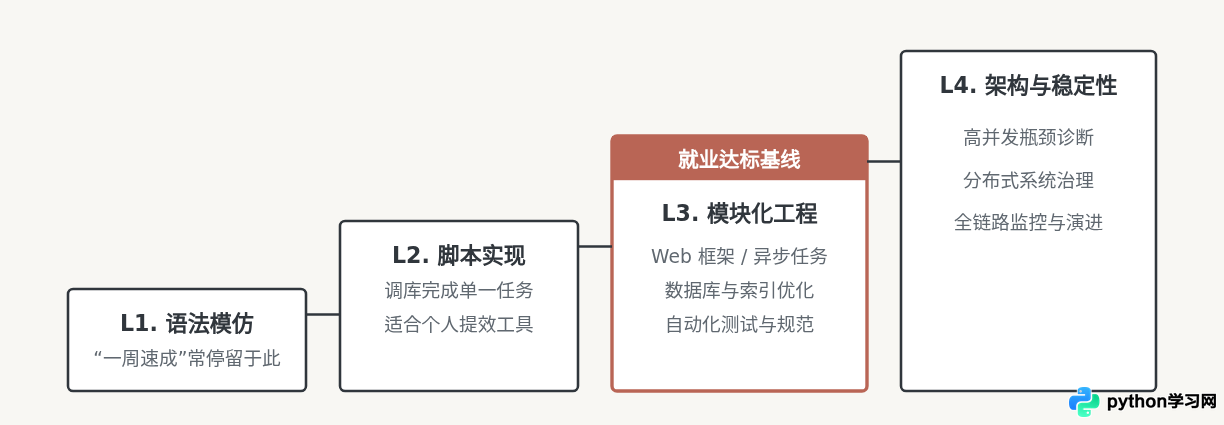
速成课程受限于时长,普遍止步于 L1 至 L2 阶段。在这个阶段,学习者能按照教程做简单的计算器、简单的爬虫,但在面对 L3 阶段要求的环境隔离、数据库事务、鉴权中间件编写、单元测试覆盖率等要求时,往往无从下手。
四、弥补差距的针对性操作路径
如果已经掌握了基础语法,摆脱“速成虚胖”的关键在于进行系统性的工程补强。可以按照以下五个明确步骤推进:
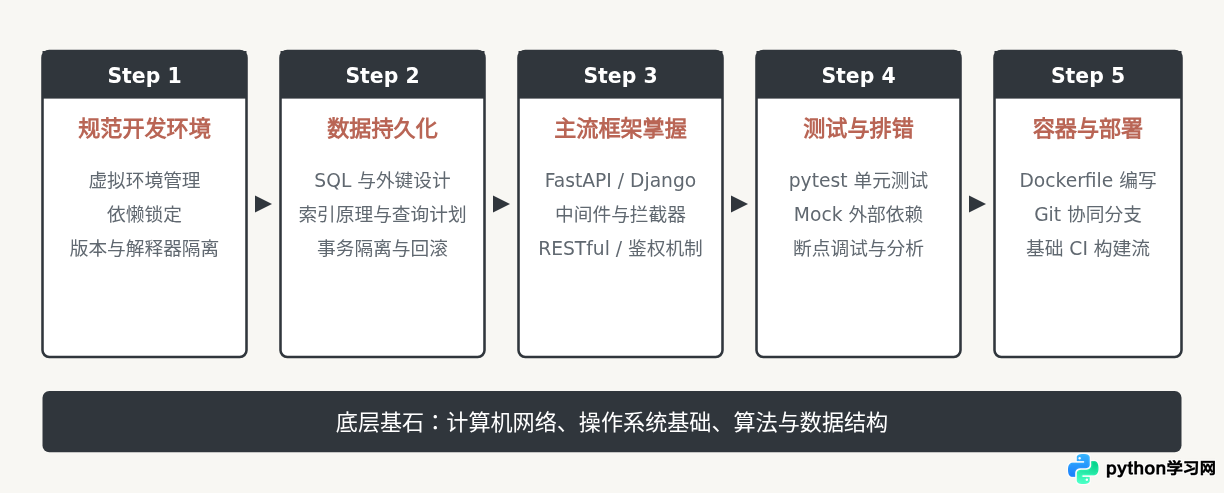
步骤一:规范工程隔离与依赖锁定
生产环境不应将包安装到全局系统。学习使用 venv 或现代包管理工具(如 poetry、uv)。
# 创建隔离虚拟环境
python3 -m venv .venv

# 激活环境(Linux/macOS)
source .venv/bin/activate

# 激活环境(Windows PowerShell)
# .venv\Scripts\Activate.ps1

# 安装所需包并生成精确锁文件
pip install fastapi uvicorn requests
pip freeze > requirements.txt
步骤二:理解关系型数据库与连接池
掌握 SQL 语法与索引工作原理。不要把数据库当成单纯的“数据存储箱”,需要理解事务一致性(ACID)。了解在多并发请求下,数据库连接池(如 SQLAlchemy 连接池)是如何避免资源耗尽的。
步骤三:编写具备测试保障的代码
专业团队要求代码可测试。熟练使用 pytest 编写单元测试,并学会使用 unittest.mock 对外部网络调用或慢查询进行模拟隔离:
# test_user_service.py 示例
from unittest.mock import patch, MagicMock
from my_service import UserSyncService

@patch("my_service.requests.Session.get")
def test_fetch_page_success(mock_get):
    # 模拟 API 预期返回
    mock_response = MagicMock()
    mock_response.json.return_value = {"items": [{"id": 1, "name": "Alice"}]}
    mock_response.raise_for_status.return_value = None
    mock_get.return_value = mock_response

    service = UserSyncService(db_path=":memory:")
    items = service.fetch_page(1)

    assert len(items) == 1
    assert items[0]["name"] == "Alice"
五、如何客观检验自己是否具备就业竞争力
为了脱离“自以为学会”的盲目状态,读者可以通过以下对照清单来检验自己的知识完整度:
| 考核维度 | 速成学习者普遍状态 | 岗位合格者必备表现 |
|---|---|---|
| 代码组织 | 单个 .py 脚本写到底,逻辑、配置、数据访问混杂。 |
采用清晰的架构分层(控制器、服务层、仓储层),配置文件解耦。 |
| 错误处理 | 依赖空 except: pass 忽略报错,或程序直接跳出异常崩溃。 |
精细捕获特定异常,合理记录日志并提供优雅降级或事务回滚。 |
| 数据读写 | 直接在代码里拼接 SQL 字符串,缺乏索引与连接管理意识。 | 防 SQL 注入,根据查询模式设计联合索引,利用连接池复用资源。 |
| 调试排查 | 全靠 print() 打印变量,遇到未见过的报错只会搜索复制。 |
使用 IDE 断点调试,读懂调用栈日志,会利用排查工具分析慢请求。 |
| 协作交付 | 代码只在个人电脑运行,没有版本控制或测试用例。 | 规范使用 Git 分支模型,编写单元测试,提供 Dockerfile 容器定义。 |
六、总结:重新定义“学会”的价值
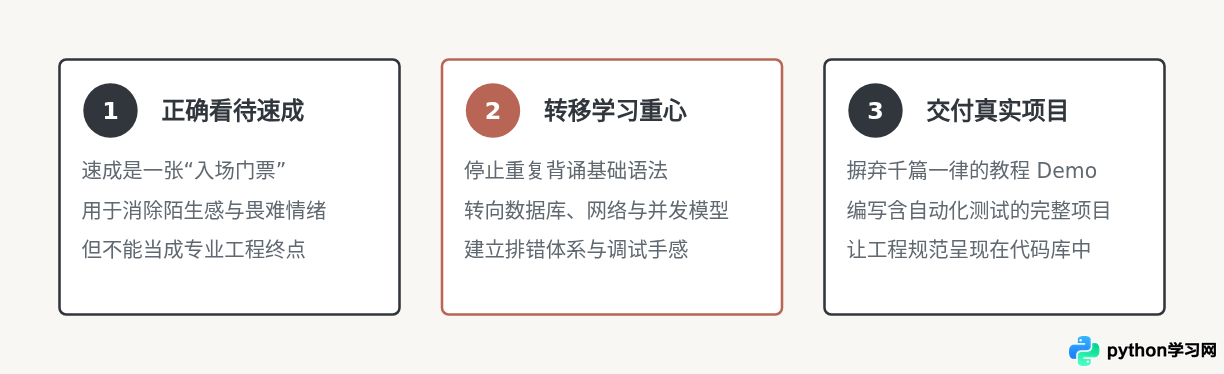
“一周学会 Python”并不是虚假命题,如果你的目标是编写脚本批量重命名本地文件、处理一份 Excel 报表,那么一周时间完全足以带来显著的工作提效。这种工具性质的掌握具有很高的个人实用价值。
但如果你希望以此获得一份全职软件工程师的职位,就必须认清商业软件开发对工程严谨性的严苛要求。跨越鸿沟的方法不是去寻找更快、更轻松的“捷径”,而是从现在开始,写规范的代码、配置真正的数据库、编写自动化测试用例,并在反复的排错与调试中建立对计算机底层运作的真实理解。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









