

Python怎么提取字符串的前N个或后N个字符
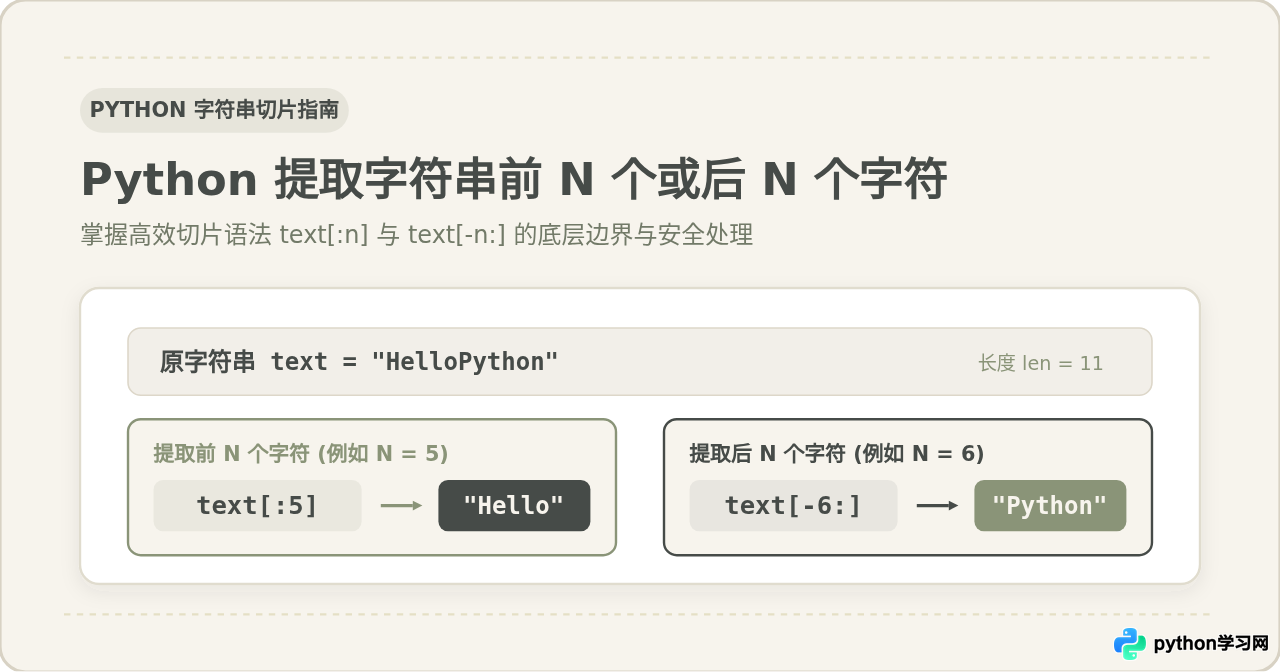
详细介绍在Python中如何使用切片语法提取字符串的前N个字符(text[:n])与后N个字符(text[-n:]),深入解析切片索引边界模型、左闭右开区间与越界自动容错特性,并指出N为0时的特殊负索引陷阱与防范技巧。
text[:n],提取后 N 个字符使用 text[-n:]。切片属于 Python C 底层优化的原生操作,执行迅速且具备天然的安全边界机制——即便指定的 N 超过了字符串本身的实际长度,也不会引发 IndexError 异常,而是会安全地截取到字符串的物理边界。
一、核心操作:使用切片语法快速提取
Python 字符串属于不可变序列(immutable sequence),对字符串进行任何截取操作,都会生成并返回一个新的字符串对象,原字符串不会发生任何改变。切片的基本语法结构为 string[start:stop:step],在日常提取前 N 个或后 N 个字符时,步长(step)默认为 1,通常省略不写。
1. 提取前 N 个字符:text[:n]
当需要截取字符串开头的 N 个字符时,起始索引 start 缺省不填,默认从字符串第 0 个位置开始;终止索引 stop 填入目标数量 n。因为切片遵循“左闭右开”规则,区间包含索引 0 但不包含索引 n,因此刚好截取 n 个字符。
# 示例代码:提取字符串的前 5 个字符
text = "HelloWorld"
n = 5

prefix = text[:n]
print("前 N 个字符:", prefix)2. 提取后 N 个字符:text[-n:]
提取字符串末尾的 N 个字符时,使用负数索引。将起始索引设为 -n,表示从倒数第 n 个字符的位置开始;将终止索引留空,表示一路截取到字符串的最末端。
# 示例代码:提取字符串的后 5 个字符
text = "HelloWorld"
n = 5

suffix = text[-n:]
print("后 N 个字符:", suffix)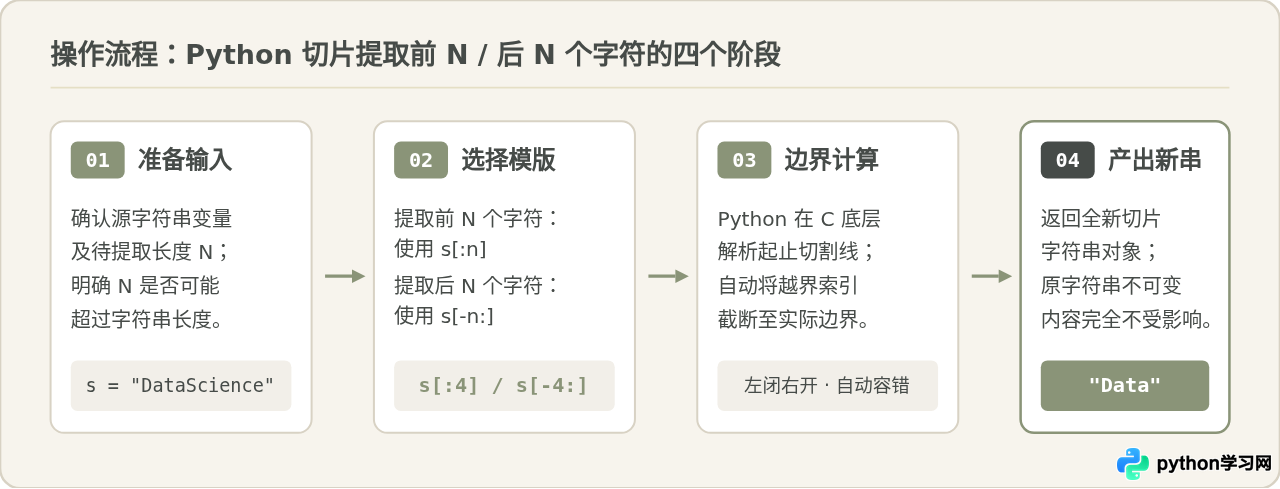
二、深入原理:字符切割线与左闭右开模型
很多刚接触 Python 的读者常常会产生困惑:为什么 text[:3] 的终止下标写的是 3,取出来的字符却只有索引为 0、1、2 的前 3 个字符?为什么 text[-3:] 中不写结束下标就能刚好拿到末尾 3 个?
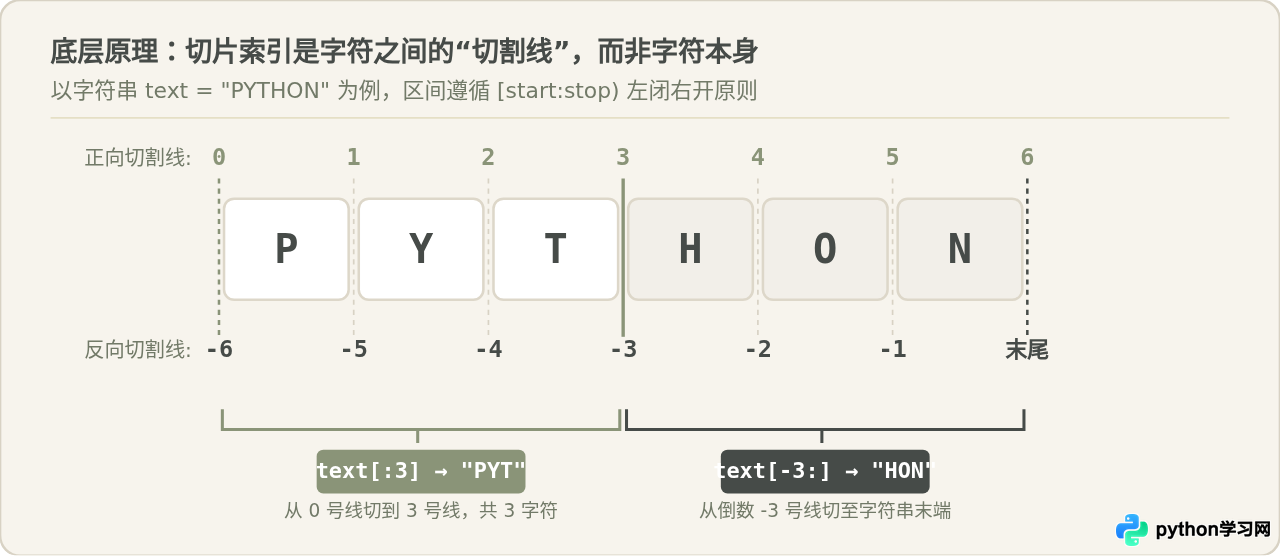
理解切片最清晰的思维模型,是把索引看作字符之间的“物理切割线(Boundaries)”,而不是单个字符的容器格子:
- 0 号切割线:位于字符串最开头的左边界,即第 1 个字符的左侧。
- k 号切割线:位于第 k 个字符的右侧、第 k+1 个字符的左侧。
- 正向切片
text[:n]:刀刃沿着 0 号切割线切入,再沿着 n 号切割线切断,取出的正是介于 0 与 n 之间的全部字符,其数量正好是n - 0 = n个。 - 反向切片
text[-n:]:-n对应倒数第 n 个字符左侧的切割线。右侧不指定数值表示刀刃一直延伸到字符串的最右边界,因此能够完整取出末尾的 n 个字符。
三、边界情况与易混淆点辨析
在实际编写生产代码或处理动态用户输入时,传入的 N 值可能存在未知数,例如 N 超长、N 为 0 甚至 N 为负数。针对这些边界情况,需要准确识别切片的固有规则与潜在陷阱。
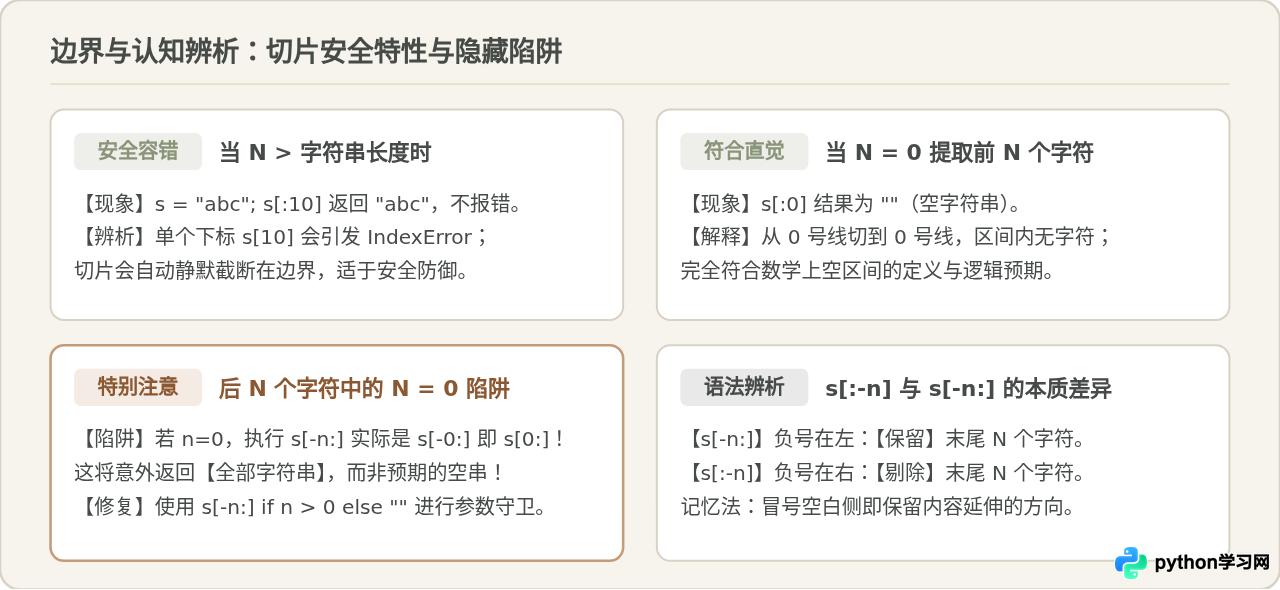
1. 常见疑问:当 N 大于字符串长度时会报错吗?
结论:不会报错。
在 Python 中,通过单下标访问单个元素(如 text[100])如果超出范围,会立即抛出 IndexError: string index out of range。但切片机制的设计哲学是“尽可能获取范围内的全部可用元素”。
当执行 text[:100] 而字符串仅有 5 个字符时,Python 内部会自动将终止索引调整为字符串的最大长度 len(text),从而安全返回整个字符串。同样地,当执行 text[-100:] 时,起始位置会被截断至字符串开头,依然返回全部字符,绝不会中断程序运行。
# 示例代码:N 超过字符串长度时的容错表现
short_text = "abc"

print("前 10 个字符:", repr(short_text[:10]))
print("后 10 个字符:", repr(short_text[-10:]))后 10 个字符: 'abc'
2. 隐蔽陷阱:当 N 等于 0 时负索引会发生什么?
提取前 N 个字符时,如果 n = 0,执行 text[:0] 会安全地得到空字符串 "",符合预期。
但是,在提取后 N 个字符时,直接写 text[-n:] 存在严重隐患!
在 Python 数学计算中,-0 等价于 0。因此,当 n = 0 时,表达式 text[-0:] 实际上会被 Python 当作 text[0:] 执行。而 text[0:] 表示从开头一直截取到末尾,结果是返回原字符串的完整拷贝,而不是预期的空字符串 ""。
# 隐蔽漏洞示例:当动态变量 n 为 0 时
title = "PythonSlice"
n = 0

wrong_result = title[-n:]  # 等价于 title[0:]
print("错误写法得到的结果:", repr(wrong_result))  # 意外返回完整串

# 正确防守写法:加入条件判断
safe_result = title[-n:] if n > 0 else ""
print("安全写法得到的结果:", repr(safe_result)) # 返回预期空串安全写法得到的结果: ''
3. 辨析:text[:-n] 与 text[-n:] 的关键区别
这两个表达式形态极为相似,初学者容易混淆负号放置的位置:
text[-n:]:负号在冒号左边,表示以倒数第 n 个位置为起点,保留后面的字符,即“保留最后 N 个字符”。text[:-n]:负号在冒号右边,表示以倒数第 n 个位置为终点截断,丢弃后面的字符,即“剔除最后 N 个字符”。
四、工程实践:封装健壮的通用提取函数
在实际项目中,如果字符串截取逻辑需要复用于多种数据源(如清洗外部日志、裁剪用户输入、提取文件后缀标识等),建议封装一层轻量函数,规避非正数参数带来的逻辑漏洞:
# 示例代码:稳健的字符串前后截取函数
def get_first_n_chars(text: str, n: int) -> str:
    """安全提取字符串的前 N 个字符"""
    if not isinstance(text, str):
        return ""
    if n <= 0:
        return ""
    return text[:n]

def get_last_n_chars(text: str, n: int) -> str:
    """安全提取字符串的后 N 个字符"""
    if not isinstance(text, str):
        return ""
    if n <= 0:
        return ""
    return text[-n:]

# 验证测试
raw = "Hello, Python!"
print("前 5 个:", get_first_n_chars(raw, 5))
print("后 7 个:", get_last_n_chars(raw, 7))
print("传入 0:", repr(get_last_n_chars(raw, 0)))
print("传入负数:", repr(get_last_n_chars(raw, -2)))
print("超长提取:", get_first_n_chars(raw, 99))后 7 个: Python!
传入 0: ''
传入负数: ''
超长提取: Hello, Python!
五、总结与常用切片速查表
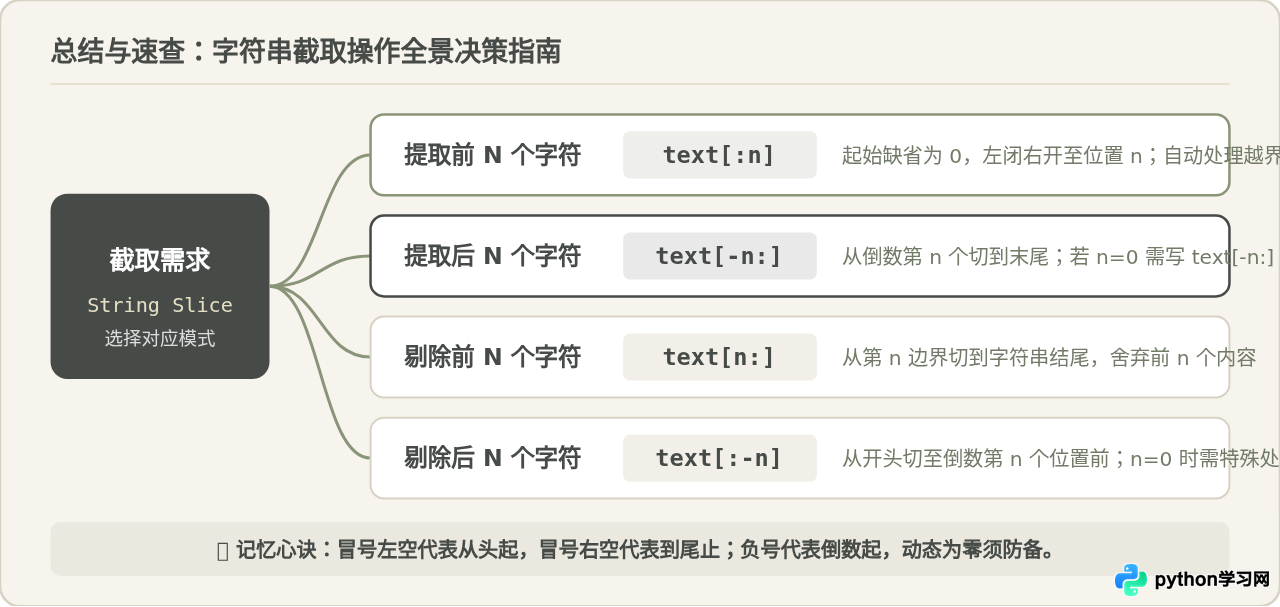
提取字符串前 N 个或后 N 个字符是 Python 日常编程中最高频的操作之一。掌握以下核心规则即可在所有场景中从容应对:
| 操作目标 | 标准切片语法 | 示例(s = "ABCDEF", n = 2) | 边界特性与注意事项 |
|---|---|---|---|
| 提取前 N 个字符 | s[:n] |
s[:2] → "AB" |
自动截断,即便 n 大于长度也不会报错;n≤0 时返回 ""。 |
| 提取后 N 个字符 | s[-n:] if n > 0 else "" |
s[-2:] → "EF" |
注意 n=0 时 s[-0:] 会误返回整串,需做非零防护。 |
| 剔除前 N 个字符 | s[n:] |
s[2:] → "CDEF" |
从第 n 个位置保留至结尾;n≥len 时返回 ""。 |
| 剔除后 N 个字符 | s[:-n] if n > 0 else s |
s[:-2] → "ABCD" |
截断掉末尾 n 个字符;n=0 时若直接写 s[:-0] 会返回 ""。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









