

Python 3核心语法详解:变量、数据类型与控制流基础
深入解析Python 3的核心语法基础,系统阐述变量的对象引用机制与内存模型、常用内置数据类型的可变性边界,以及条件分支与循环控制流的执行逻辑和工程避坑指南。
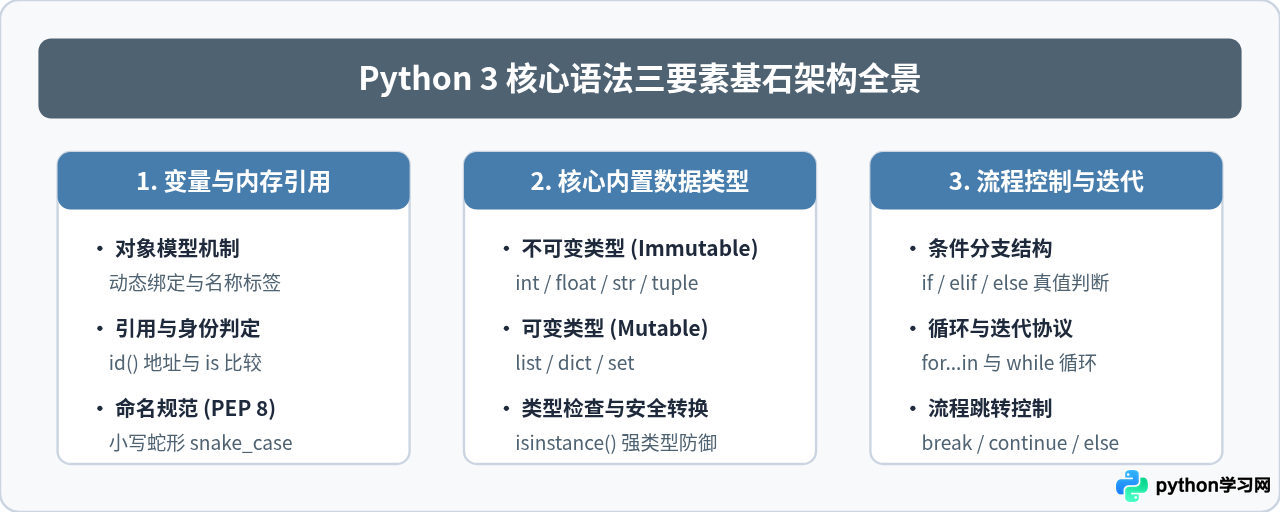
Python 3 是一门强类型、动态绑定的多范式编程语言。要写出运行高效、逻辑健壮的 Python 程序,核心在于掌握其三大基石:变量的对象引用机制、内置数据类型的可变性边界,以及分支与循环控制流的执行契约。本文将系统拆解这三大部分的运行原理与实践规范,配合代码实例与直观流程图,帮助读者建立清晰底层的 Pythonic 编程认知。
一、变量的本质与内存引用机制
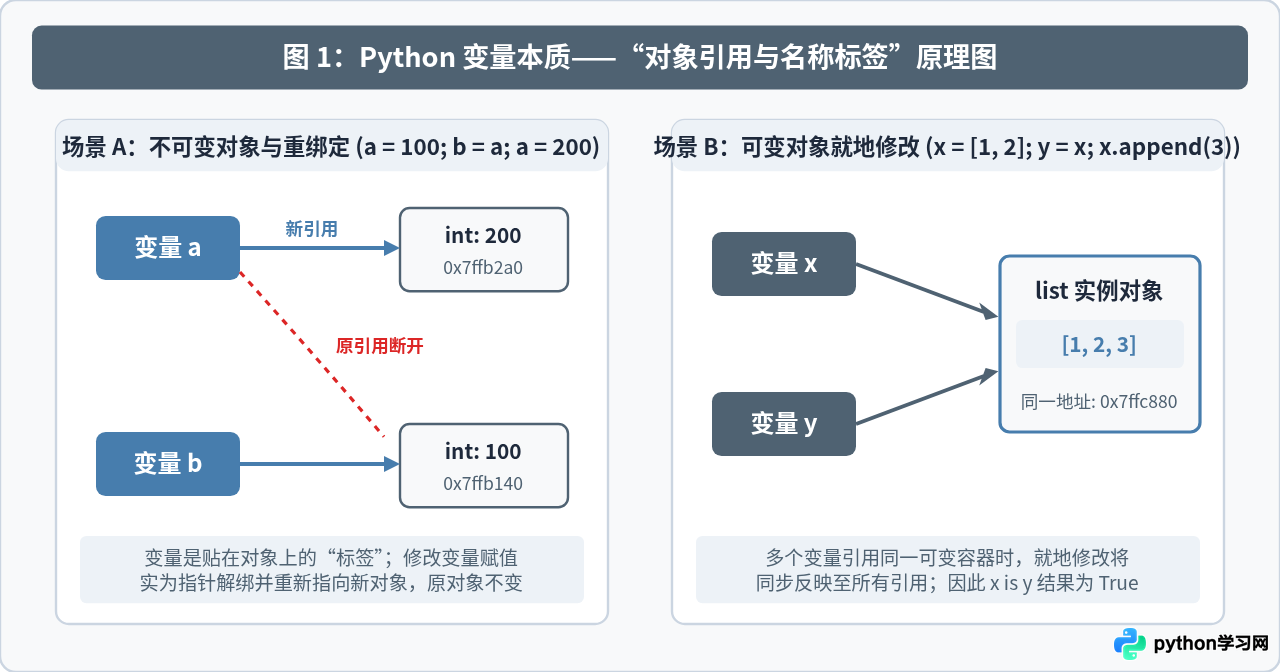
在许多静态类型语言(如 C 或 C++)中,变量通常被视作一个“内存盒子”,声明变量时系统在内存栈区划出固定尺寸的空间,给变量赋值意味着把具体数据放进这个盒子里。而 Python 采取了截然不同的“对象引用与名称标签”模型。
在 Python 中,所有数据(无论是整数、字符串还是自定义类)都作为独立的对象存储在堆内存(Heap)中。变量本身并不存储数据,它仅仅是一个被贴在对象上的“名称标签”,内部保存着指向目标对象的内存指针。
1. 赋值与重绑定的真实过程
当执行 a = 100 时,Python 解释器首先在内存中分配一个 int 对象并设置值为 100,随后把名称 a 绑定(Bind)到该对象的内存地址。如果紧接着执行 b = a,解释器并不会复制 100 这个数值,而是让名称 b 同样指向现有的 100 对象。
当再次执行 a = 200 时,由于整数是不可变对象,解释器并不是将 100 所在内存修改为 200,而是创建全新的 200 对象,并将标签 a 重新绑定到新对象上,而标签 b 依旧稳固指向原先的 100。
2. 身份比较(is)与值比较(==)的边界
理解了引用机制后,就能准确区分 Python 中的两个比较操作符:
==(值相等性):调用对象的__eq__()方法,用于比较两个对象承载的数据内容是否一致。is(身份同一性):比对两个变量是否引用内存中的同一个对象(即比对id(x) == id(y))。
# 身份与数值比较示例
list_a = [1, 2, 3]
list_b = [1, 2, 3]
list_c = list_a

# 内容比对
print(list_a == list_b)  # 示例输出:True(两列表所含元素相同)

# 内存身份比对
print(list_a is list_b)  # 示例输出:False(各自开辟独立堆内存)
print(list_a is list_c)  # 示例输出:True(list_c 直接指向 list_a 的对象)

# 单例判断规范
flag = None
print(flag is None) # 示例输出:True(PEP 8 规定判断 None 必须使用 is)snake_case,例如 user_score、is_active),常数采用全大写(如 MAX_RETRIES)。避免使用单个字符 l、O、I 作为变量名,以防与数字 1 和 0 混淆。
二、核心内置数据类型体系与可变性
Python 3 是强类型语言,这意味着类型属于对象本身而非变量名,解释器不会在未显式定义的情况下隐式跨类型混淆计算(例如 "10" + 5 会抛出 TypeError)。理解各类内置类型的基础行为与可变性(Mutability)是写出无 Bug 代码的前提。
1. 不可变数据类型(Immutable Types)
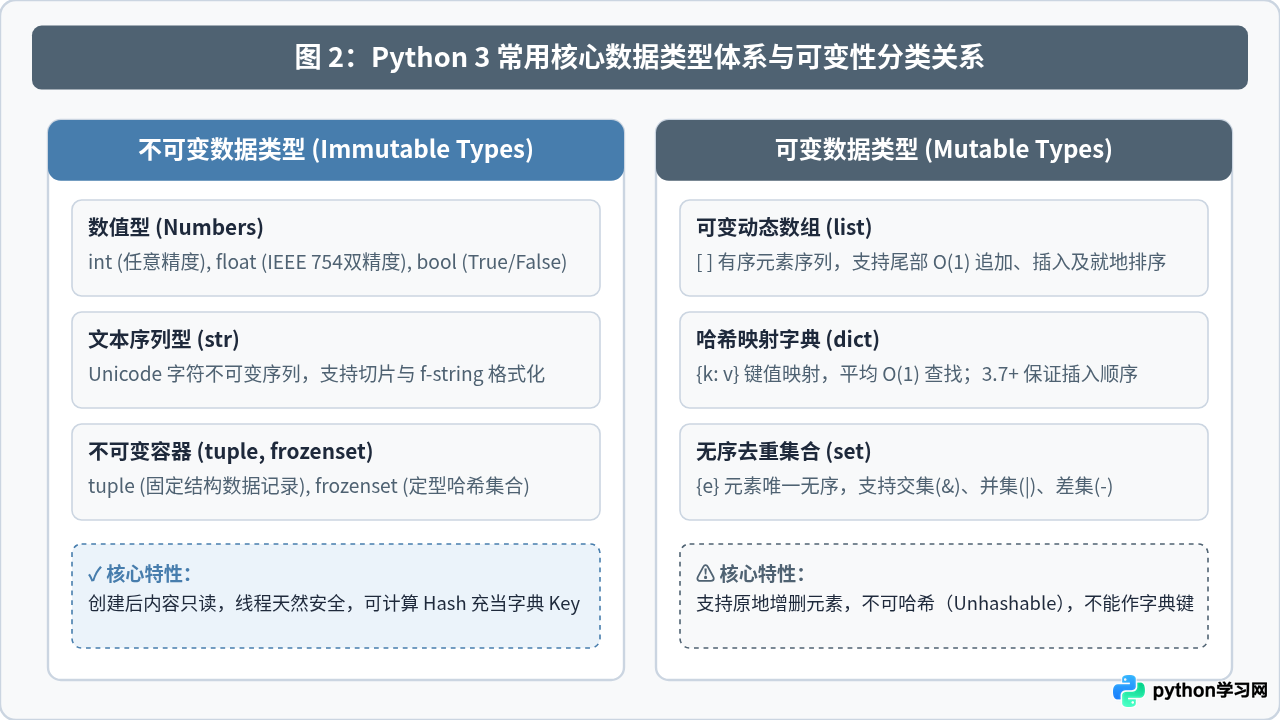
不可变类型的对象一旦在内存中创建,其内部状态就永远无法被篡改。如果对它进行所谓“修改”操作,底层都会生成全新对象返回。
- 整数(int)与浮点数(float):Python 3 的
int拥有任意精度,理论上不会溢出;float遵循 IEEE 754 双精度标准,受二进制舍入限制,比较两浮点数是否相等时应使用math.isclose()而不是==。 - 布尔型(bool):
bool是int的派生子类,只有True(等价于 1)与False(等价于 0)。 - 字符串(str):表示 Unicode 字符序列,支持负索引与切片操作。格式化推荐使用 Python 3.6+ 引入的
f-string(如f"当前用户:{username}"),性能与可读性优于传统的%操作符或str.format()。 - 元组(tuple):用圆括号
( )定义的定长只读序列。常用于多返回值解包、充当不可变数据记录或作为字典的键。
2. 可变数据类型(Mutable Types)
可变对象支持原地更新(In-place mutation),修改内容时其内存地址(id)保持不变。
- 列表(list):底层为连续引用指针数组。支持
append()(摊还复杂度 O(1))、insert()、pop()等操作。 - 字典(dict):基于哈希表实现的键值映射容器。Python 3.7+ 正式规范化了其插入顺序保持特性。字典的“键”必须为可哈希对象(Hashable),因此列表、字典和集合不能作为字典的键,而数字、字符串、元组可以。
- 集合(set):用花括号
{ }定义的无序不重复容器。内部同样基于哈希表,元素必须可哈希。支持高效的数学集合运算:并集|、交集&、差集-。
# 核心数据结构操作示例
# 1. 列表操作与就地修改
scores = [85, 92, 78]
scores.append(99)
scores.sort(reverse=True)
print(f"排序后成绩列表: {scores}")  # 示例输出: 排序后成绩列表: [99, 92, 85, 78]

# 2. 字典安全检索与默认值
student = {"name": "林华", "age": 20, "major": "Computer Science"}
grade = student.get("grade", "未录入")
print(f"学生 {student['name']} 的年级: {grade}")  # 示例输出: 学生 林华 的年级: 未录入

# 3. 集合快速去重与交集
user_tags_a = {"python", "backend", "linux"}
user_tags_b = {"python", "data_science", "ai"}
common_tags = user_tags_a & user_tags_b
print(f"共同技能标签: {common_tags}")  # 示例输出: 共同技能标签: {'python'}
三、控制流逻辑:条件分支与循环控制
控制流决定了指令在不同运行状态下的执行分支与重复次数。Python 采用严格的缩进(通常为 4 个空格)来标定代码块范围,不使用大括号,因此代码结构与执行层级紧密相扣。
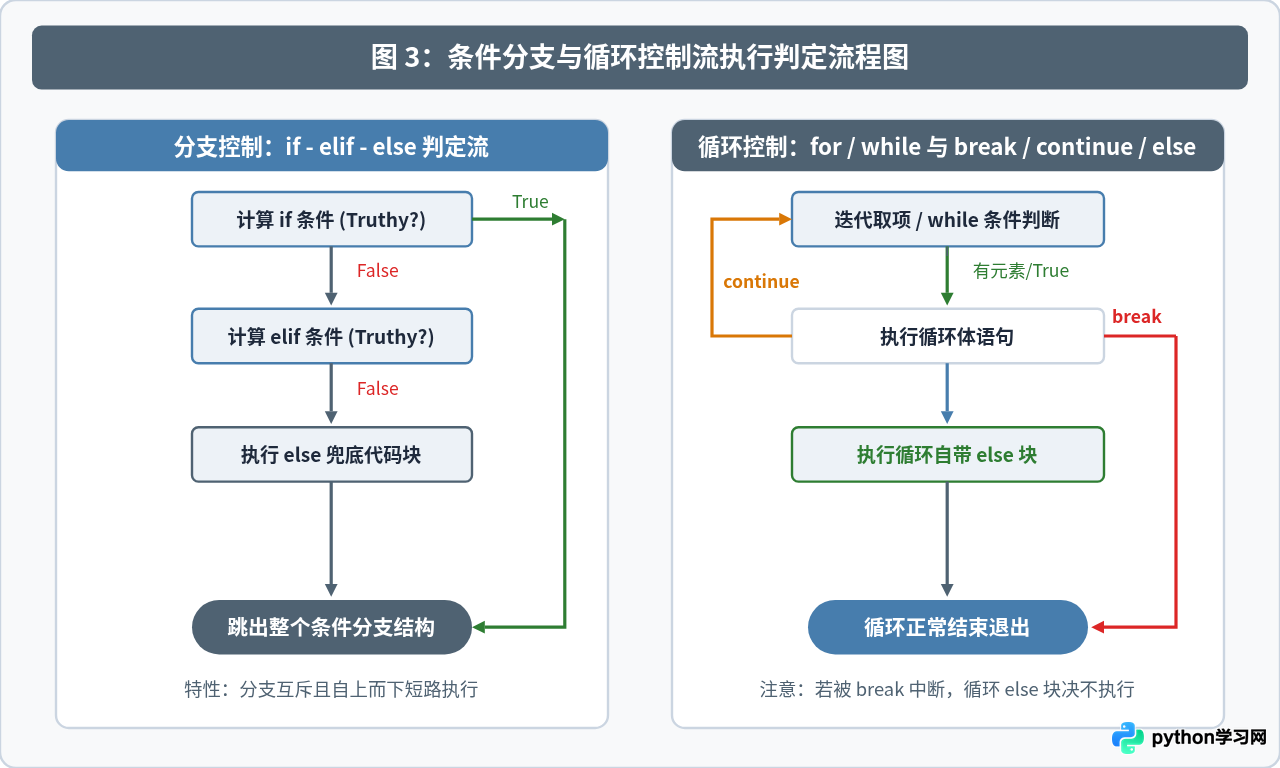
1. 条件分支(if - elif - else)与真值判定
Python 会自动对条件表达式计算其布尔上下文(Boolean Context)。除了显式的 True 与 False,以下值在条件判断中均被视作假值(Falsy):
- 常量:
None、False - 数值零值:
0、0.0、Decimal(0) - 空容器与序列:
""(空字符串)、[](空列表)、()(空元组)、{}(空字典)、set()(空集合)
其余绝大部分对象在默认情况下均计算为真值(Truthy)。因此,判断一个列表是否非空时,推荐写 if my_list:,而不是 if len(my_list) > 0:。
2. 逻辑运算符与短路求值(Short-circuit Evaluation)
Python 使用英文关键词 and、or、not。在计算组合表达式时遵循短路原则:
A and B:如果 A 计算为 False,直接返回 A,不再计算 B。A or B:如果 A 计算为 True,直接返回 A,不再计算 B。
该特性常用于防御性编程,例如 user is not None and user.is_authenticated(),即使 user 为 None 也绝不会引发属性访问异常。
3. 迭代循环(for...in)与条件循环(while)
for...in 语句基于 Python 的迭代器协议(Iterator Protocol),可以遍历任何可迭代对象(如列表、字符串、字典键、文件句柄等),配合内置函数可实现优雅高效的遍历:
range(start, stop, step):惰性生成整数序列,占用恒定内存。enumerate(iterable, start=0):同时获取元素序号与值。zip(iter_a, iter_b):并行配对遍历多个序列。
# 循环进阶与遍历工具函数示例
servers = ["web-01", "web-02", "db-primary"]
ports = [8080, 8081, 5432]

# 同时获取序号与元素
for index, server in enumerate(servers, start=1):
    print(f"节点 [{index}]: {server}")

# 并行配对组合
for server, port in zip(servers, ports):
    print(f"服务 {server} 监听端口: {port}")
4. 流程跳转控制:break、continue 与循环 else 契约
除了常规的 break(彻底中断当前循环)和 continue(提前跳过本轮剩余语句,直接进入下一轮),Python 提供了一个常被忽视却极其有用的特性:循环体的 else 语句块。
for...else 或 while...else 中的 else 块,仅在循环正常执行完毕(没有被 break 提前打断)时执行。如果循环被 break 中途跳出,else 块将被跳过。这一特性非常适用于“遍历查找目标,若未找到则执行补救逻辑”的场景。
# 搜索目标与循环 else 配合模式
target_id = 104
cluster_nodes = [101, 102, 103]

for node in cluster_nodes:
    if node == target_id:
        print(f"成功定位目标节点: {node}")
        break
else:
    # 仅当循环完整遍历完毕未遇到 break 时触发
    print(f"警报:集群节点列表中未发现目标 ID {target_id}")
# 示例输出: 警报:集群节点列表中未发现目标 ID 104
四、高频陷阱排查指引与最佳实践
在实际工程开发中,变量、类型与控制流的交叉使用常常伴随以下典型陷阱。通过下方的排错指引,可以在编码初期规避绝大多数隐蔽缺陷。
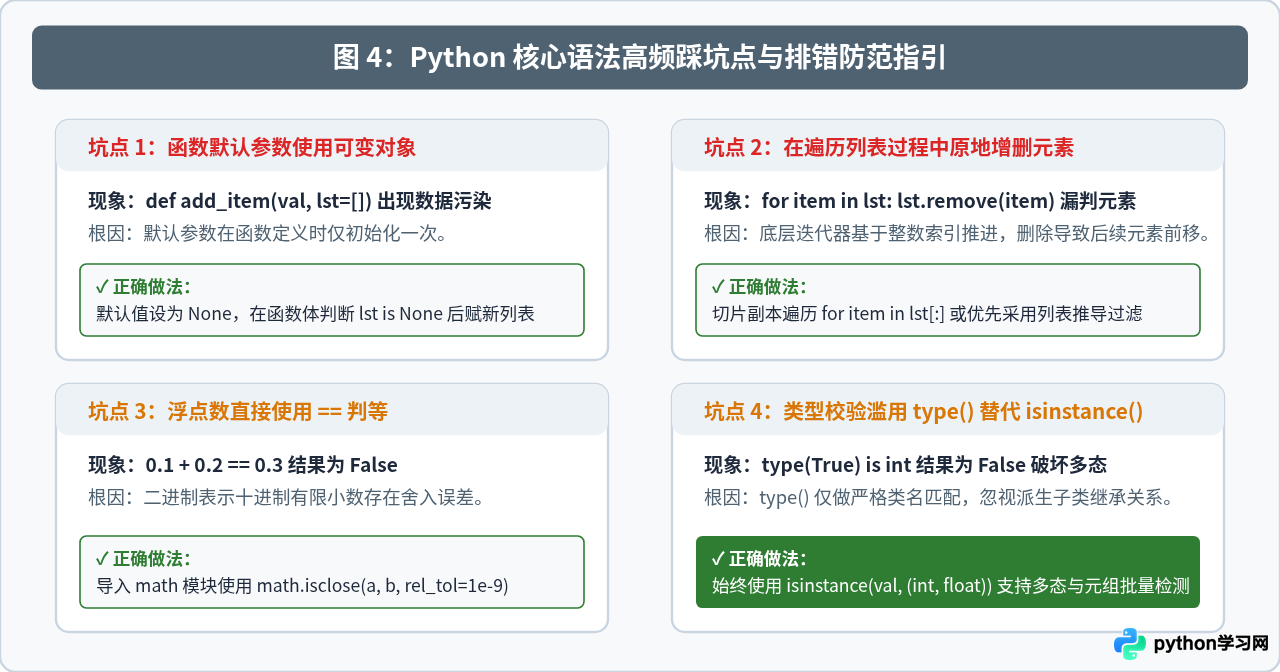
1. 陷阱:函数默认参数使用可变容器
Python 的函数默认参数在函数定义阶段(模块加载时)完成求值,并且只初始化一次。如果将 list 或 dict 作为默认参数,所有未传入该参数的函数调用将共享同一个容器对象。
# 错误示例:共享同一个底层列表
def append_worker(task_id, task_list=[]):
    task_list.append(task_id)
    return task_list

print(append_worker(1))  # 预期 [1], 实际 [1]
print(append_worker(2))  # 预期 [2], 实际 [1, 2](出现跨调用数据污染!)

# 正确防范模式:使用不可变的 None 作为哨兵值
def safe_append_worker(task_id, task_list=None):
    if task_list is None:
        task_list = []  # 每次调用显式创建独立新列表
    task_list.append(task_id)
    return task_list

print(safe_append_worker(1))  # 示例输出: [1]
print(safe_append_worker(2))  # 示例输出: [2]
2. 陷阱:在遍历容器时原地删除或增加元素
当使用 for item in my_list: 遍历列表时,底层迭代器维护着内部索引指针。如果在循环体内调用 my_list.remove(item),原列表中后续元素会向前移动填补空位,导致迭代器下一次移动索引时跳过紧随其后的元素。
# 错误示例:原地删除引发漏判
numbers = [1, 2, 2, 3, 4]
for num in numbers:
    if num == 2:
        numbers.remove(num)
print(numbers)  # 示例输出: [1, 2, 3, 4](第二个 2 被漏过!)

# 正确防范模式 1:切片浅拷贝遍历副本
for num in numbers[:]:
    if num == 2:
        numbers.remove(num)

# 正确防范模式 2:优先采用列表推导式构建纯净新集合
numbers = [num for num in numbers if num != 2]
print(numbers)  # 示例输出: [1, 3, 4]
五、综合实战案例:数据清洗与分类统计
以下代码演示如何在一个真实的任务处理场景中综合运用变量引用、类型转换、字典/集合/列表以及控制流逻辑:
# 实战:学生成绩清洗与分数段分组聚合
raw_records = [
    {"id": "S101", "name": "王强", "score": "88"},
    {"id": "S102", "name": "李娜", "score": "95"},
    {"id": "S103", "name": "张伟", "score": None},     # 缺失数据
    {"id": "S104", "name": "刘洋", "score": "72"},
    {"id": "S105", "name": "陈敏", "score": "invalid"},  # 异常字符串
    {"id": "S101", "name": "王强", "score": "88"},     # 重复数据
]

# 1. 利用 set 存储已处理 ID 实现快速去重
processed_ids = set()
grade_buckets = {"优秀(90+)": [], "良好(80-89)": [], "及格(60-79)": []}
skipped_count = 0

for record in raw_records:
    rec_id = record.get("id")

    # 遇到重复数据直接跳过
    if rec_id in processed_ids:
        continue

    # 校验分数字段是否有效
    raw_score = record.get("score")
    if raw_score is None:
        skipped_count += 1
        continue

    try:
        score_val = float(raw_score)
    except ValueError:
        # 数据无法转换为数值类型
        skipped_count += 1
        continue

    # 记录已有效处理的唯一 ID
    processed_ids.add(rec_id)
    student_entry = (record["name"], score_val)  # 使用只读元组包装记录

    # 控制流分支分类
    if score_val >= 90:
        grade_buckets["优秀(90+)"].append(student_entry)
    elif score_val >= 80:
        grade_buckets["良好(80-89)"].append(student_entry)
    elif score_val >= 60:
        grade_buckets["及格(60-79)"].append(student_entry)

# 输出统计聚合结果
print("==== 学生成绩清洗与分组结果 ====")
for level, students in grade_buckets.items():
    print(f"【{level}】(共 {len(students)} 人): {students}")
print(f"跳过无效/缺失记录数: {skipped_count}")

# 示例输出:
# ==== 学生成绩清洗与分组结果 ====
# 【优秀(90+)】(共 1 人): [('李娜', 95.0)]
# 【良好(80-89)】(共 1 人): [('王强', 88.0)]
# 【及格(60-79)】(共 1 人): [('刘洋', 72.0)]
# 跳过无效/缺失记录数: 2
六、核心要点总结
掌握 Python 3 的核心语法,不需要死记硬背语法糖,而应当立足于底层对象模型:
- 变量是标签而非容器:赋值操作是名称与内存中对象之间的指针连接。不可变对象的“改变”实为重新绑定,可变对象的多重引用则共享同一份内存实体。
- 善用类型可变性与哈希约束:只读数据与字典键优先选用
tuple与frozenset,动态增删改查选用list与dict,浮点判等需引入误差容限。 - 掌控控制流的隐式约定:利用 Pythonic 的 Truthy/Falsy 简化分支判断,借助
enumerate与zip规范遍历流程,牢记break会跳过循环else块,在防御性代码中坚持使用不可变对象充当默认参数。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









