

Matplotlib、Seaborn和Plotly有什么区别?Python可视化库对比
深入对比 Python 主流数据可视化库 Matplotlib、Seaborn 和 Plotly 的底层架构、API 范式、实际代码示例与技术选型决策,助你在科研出版、统计探索与 Web 业务交付中准确选择工具。
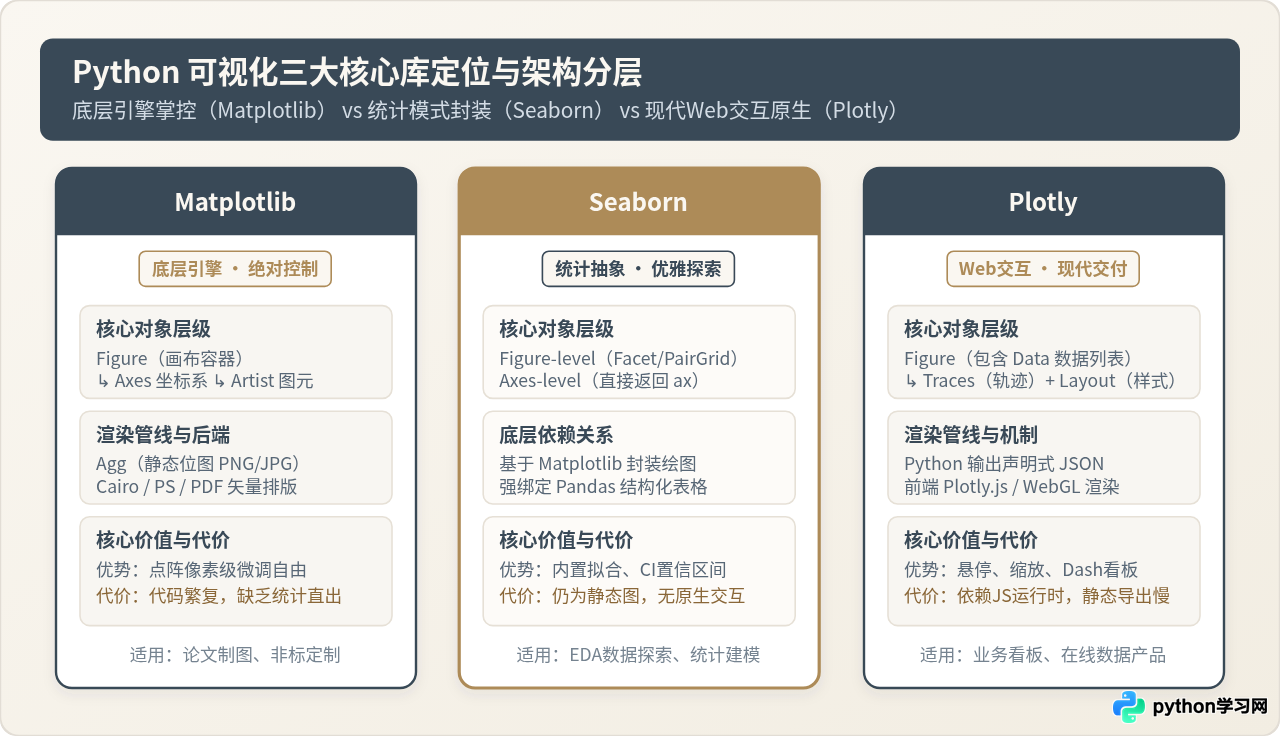
一、核心定位与技术架构的本质区别
初学者常困惑于“为什么写同一个散点图,三者的语法结构和结果完全不同”。根本原因在于三者的架构出发点与设计哲学截然不同。
1. Matplotlib:底层绘图引擎与“无限控制权”
Matplotlib 诞生于 2003 年,设计初衷是让 Python 拥有类似 MATLAB 的制图体验。经过长期演进,它已经成为整个科学计算可视化生态的“操作系统”。在 Matplotlib 中,任何图表都被拆解为一个严密的面向对象体系:
- Figure(画布容器):最顶层的容器,管理整张图像的尺寸、DPI 和背景颜色。
- Axes(坐标轴区域):真正的绘图核心区域,一个 Figure 可以包含多个 Axes(子图)。几乎所有绘图方法(如
plot、scatter、set_title)都绑定在 Axes 上。 - Artist(图元层级):画布上的所有可见元素——包括文字、线条、刻度标记、网格甚至坐标轴本身,都是具体的 Artist 对象。
由于 Matplotlib 采用了“无假设设计”,它不会替你预设任何复杂的业务逻辑。你可以精确移动某一个刻度标签 2 个像素,或者将某一条网格线的虚线间隙调为 1.5 磅。这种极致的自由度带来了巨大的确定性,但代价是代码较为繁重,面对复杂分组或多变量统计时需要编写大量样板代码。
2. Seaborn:面向统计探索的高阶声明式封装
Seaborn 并不重新发明底层的渲染引擎,而是直接构建在 Matplotlib 之上。它的诞生是为了解决数据科学中最核心的痛点:如何用最少的代码探索 Pandas DataFrame 中的多变量关系。
Seaborn 的核心创新在于语义映射(Semantic Mapping)。在 Seaborn 中,你不需要手动按类别循环拆分数据并分别着色,只需要将 DataFrame 的列名传给 x、y、hue(颜色分组)、style(标记形状)或 size(大小分组),Seaborn 会在内部自动完成数据分组、核密度计算、均值与置信区间估计(Bootstrap CI),并将绘制委托给底层的 Matplotlib Axes。Seaborn 输出的本质依然是标准的 Matplotlib 对象,因此两者完全可以无缝混用。
3. Plotly:以现代 Web 技术为核心的交互式引擎
与前两者完全不同,Plotly 从一开始就放弃了服务端的纯静态烘焙路线,而是拥抱了现代 Web 体系。当你在 Python 中调用 Plotly 时,Python 代码的角色仅仅是一个配置构建器。它将你的数据、布局和图表类型打包成一个严格遵循 JSON Schema 的声明式结构,随后交由前端的 Plotly.js(基于 D3.js 和 WebGL)在浏览器中动态解析与渲染。
这使得 Plotly 的图表天然具备 Web 应用特性:读者可以通过鼠标悬停查看任意数据点的详细数值,可以通过框选局部区域实现多级放大,也可以点击图例动态隐藏或显示某一组数据。当需要将图表嵌入网页、移动端视图,或者使用 Dash 框架搭建全交互的数据监控系统时,Plotly 展现出无可比拟的优势。
二、三大库核心维度的横向深度对比
为了让差异更具象化,我们可以从统计建模、控制自由度、交互能力、出版排版、开发效率和生产集成六个关键维度展开评估。
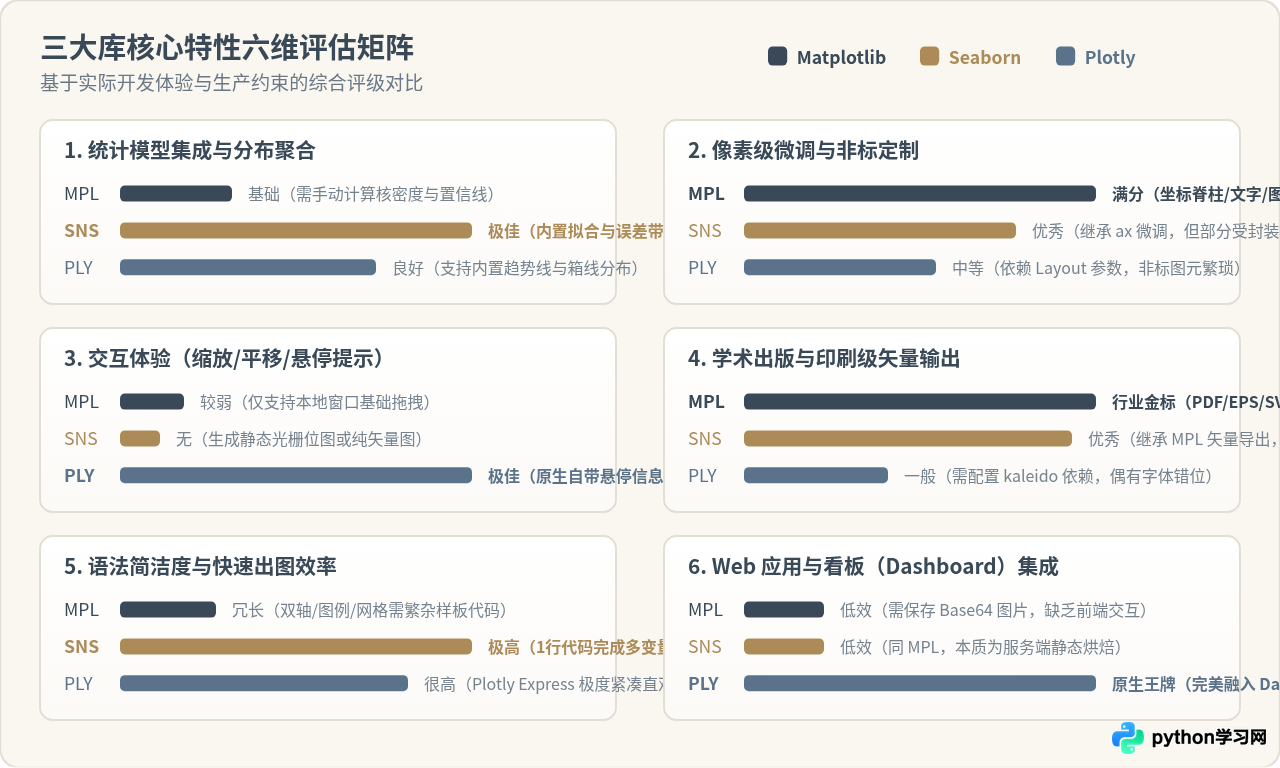
| 核心维度 | Matplotlib | Seaborn | Plotly |
|---|---|---|---|
| 底层架构 | C/C++ 封装的渲染后端(Agg、Cairo) | 基于 Matplotlib 的高阶 Python 封装 | Python 导出 JSON + 前端 Plotly.js/WebGL 渲染 |
| 数据契合度 | NumPy 数组、原生列表、基础字典 | 与 Pandas 长格式 DataFrame 深度绑定 | 结构化 DataFrame、字典或 JSON 数组 |
| 默认美观度 | 朴素、技术感强,需手动调色 | 现代统计美学,学术配色优雅且协调 | 扁平化现代 Web 风格,高亮与对比度鲜明 |
| 交互功能 | 极弱(仅限本地 GUI 简单拖放) | 无(纯静态图像输出) | 极强(原生支持悬停、缩放、联动筛选、滑块) |
| 出版级导出 | 行业黄金标准(PDF/EPS 矢量精度高) | 极佳(继承 Matplotlib 矢量导出能力) | 一般(依赖外部 kaleido 插件,偶尔有排版偏移) |
| 生产 Web 适配 | 仅能保存为图片后经由静态流展示 | 同 Matplotlib,无法进行前端状态监听 | 原生嵌入 HTML,与 Dash / Vue / React 深度契合 |
三、同一业务场景的代码实操比对
空谈概念不如实际对照。我们设定一个常见的数据分析任务:分析 200 家零售门店的“广告支出与销售额”关系,并区分两类门店(旗舰店 vs 社区店),要求绘制散点分布并绘制各组的线性回归拟合线与图例。
Python 3.10+,已安装
matplotlib、seaborn、plotly、pandas、numpy、statsmodels。输入数据为一个名为 df 的 Pandas DataFrame,包含三个字段:ad_budget(浮点型,万元)、sales_revenue(浮点型,万元)和 store_type(分类变量,值为 "旗舰店" 或 "社区店")。
1. Matplotlib 实现:手动分组与底层绘制
在纯 Matplotlib 中,没有开箱即用的“按列自动分组并分别拟合”的高阶接口。我们需要手动筛选类别、循环遍历、利用 NumPy 计算拟合多项式,并逐项配置图例与标题:
import matplotlib.pyplot as plt
import numpy as np

# 1. 显式创建画布与坐标系
fig, ax = plt.subplots(figsize=(8, 5), dpi=100)

# 2. 手动按类别拆分并绘制散点与回归线
colors = {"旗舰店": "#394957", "社区店": "#AD8B58"}
markers = {"旗舰店": "o", "社区店": "s"}

for st_type, group in df.groupby("store_type"):
    # 绘制基础散点
    ax.scatter(group["ad_budget"], group["sales_revenue"],
               label=f"{st_type}数据", color=colors[st_type],
               marker=markers[st_type], alpha=0.75, s=40)

    # 手动计算一元线性回归参数 (y = kx + b)
    k, b = np.polyfit(group["ad_budget"], group["sales_revenue"], deg=1)
    x_line = np.linspace(group["ad_budget"].min(), group["ad_budget"].max(), 50)
    ax.plot(x_line, k * x_line + b, color=colors[st_type],
            linestyle="--", linewidth=1.8, label=f"{st_type}趋势拟合")

# 3. 手工配置坐标轴、网格与图例
ax.set_title("广告支出与销售额关系(Matplotlib 实现)", fontsize=14, fontweight="bold", pad=12)
ax.set_xlabel("广告支出(万元)", fontsize=11)
ax.set_ylabel("销售额(万元)", fontsize=11)
ax.grid(True, linestyle=":", alpha=0.6)
ax.legend(frameon=True, facecolor="#FAF7F1")

plt.tight_layout()
plt.show()2. Seaborn 实现:极简统计声明
在 Seaborn 中,这种典型的统计关系只需一行声明。Seaborn 会自动完成分类分组、调色盘映射、线性回归模型运算以及置信区间(Confidence Interval)的带状着色:
import seaborn as sns
import matplotlib.pyplot as plt

# 设置优雅的排版风格与调色盘
sns.set_theme(style="whitegrid", palette=["#394957", "#AD8B58"])

# 一行调用完成多变量分组拟合
g = sns.lmplot(
    data=df,
    x="ad_budget",
    y="sales_revenue",
    hue="store_type",
    markers=["o", "s"],
    scatter_kws={"alpha": 0.7, "s": 40},
    aspect=1.5,
    height=5
)

# 仅需补充标题与轴标签微调
g.set_axis_labels("广告支出(万元)", "销售额(万元)")
g.figure.suptitle("广告支出与销售额关系(Seaborn 实现)", y=1.02, fontsize=14, fontweight="bold")

plt.show()3. Plotly 实现:开箱即用的 Web 交互报表
如果希望用户能够将鼠标移动到某家门店上查看具体的数字,或者在密集区域框选放大,我们使用 plotly.express:
import plotly.express as px

# 调用 Plotly Express,通过 trendline 开启内置 OLS 拟合
fig = px.scatter(
    df,
    x="ad_budget",
    y="sales_revenue",
    color="store_type",
    symbol="store_type",
    trendline="ols",
    title="广告支出与销售额关系(Plotly 交互式)",
    labels={"ad_budget": "广告支出(万元)", "sales_revenue": "销售额(万元)", "store_type": "门店类型"},
    color_discrete_map={"旗舰店": "#394957", "社区店": "#AD8B58"},
    hover_data=["store_id", "region"]  # 鼠标悬停额外展现维度
)

# 优化整体排版背景
fig.update_layout(
    template="plotly_white",
    title_font=dict(size=16, color="#394957"),
    hovermode="closest"
)

# 保存为独立 HTML 文件交付,或直接在浏览器打开
fig.write_html("sales_analysis.html")
fig.show()四、技术选型决策树与场景推荐
面对具体的工程或科研任务,盲目选择“最新”或“最有名”的库往往会导致工作流受阻。下方的决策树清晰梳理了从交付目标到具体库的选择逻辑:
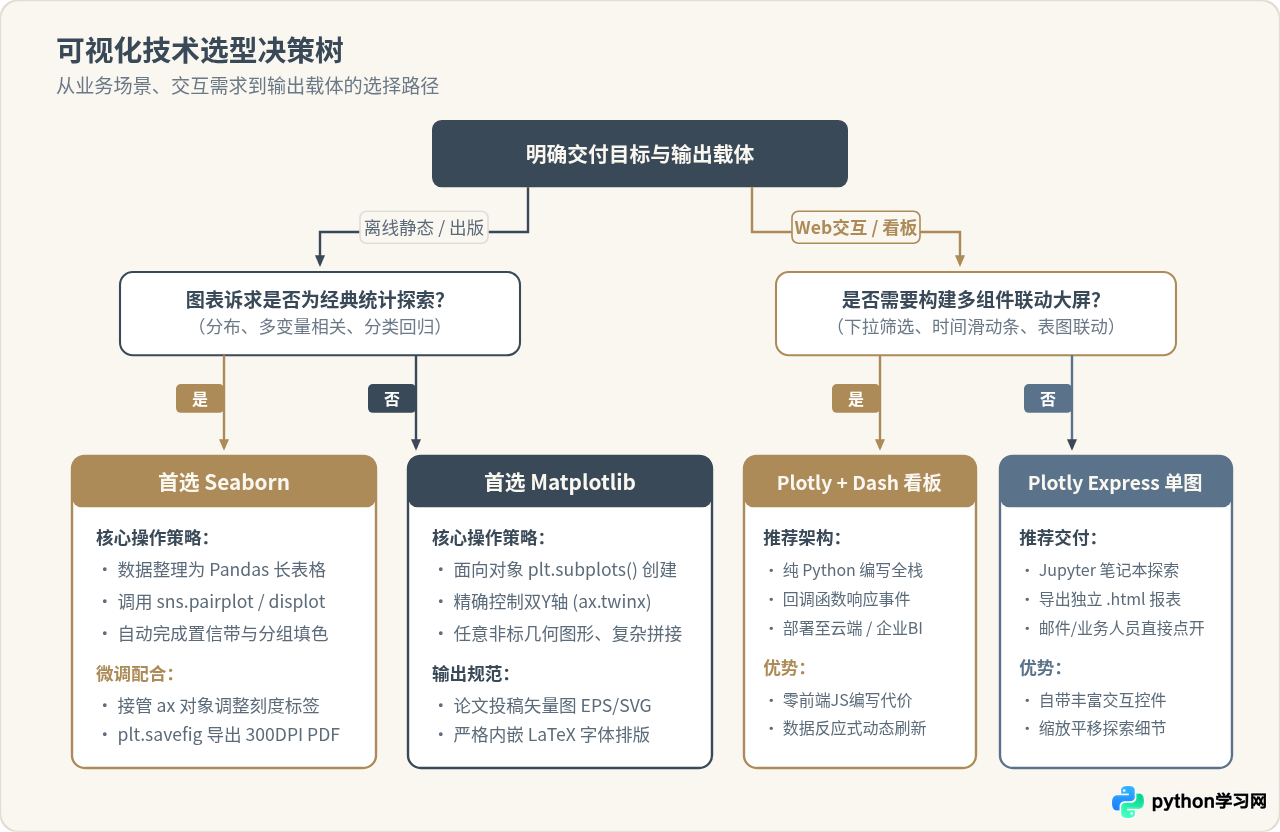
1. 场景一:学术论文、期刊投稿与印刷报告
推荐组合:Seaborn 快速建模 + Matplotlib 精确微调
国际顶会或期刊(如 IEEE、ACM、Nature 子刊)通常对图表的尺寸比例、字体嵌入(如 Helvetica 或 Times New Roman)以及矢量格式(PDF / EPS)有严格标准。直接用 Plotly 导出矢量图往往会遇到 kaleido 依赖环境难配置、字体未内联轮廓化等问题。最成熟的实践是:使用 Seaborn 的统计函数生成骨架,然后接管其返回的 matplotlib.axes.Axes 对象,设置 plt.rcParams,最后通过 plt.savefig('figure.pdf', dpi=300, bbox_inches='tight') 导出无损矢量图。
2. 场景二:日常探索性数据分析(EDA)
首选工具:Seaborn
当你刚刚拿到一份清洗好的百万级数据,需要快速摸清特征之间的分布规律、缺失关联和偏态情况时,编写繁重的 Matplotlib 代码是巨大的时间浪费。使用 Seaborn 的 sns.pairplot(df, hue="target") 或 sns.heatmap(df.corr(), annot=True),三行代码就能生成全特征相关性热力图与双变量联合分布图,能够以最高的性价比支撑探索结论。
3. 场景三:业务交付、在线产品与交互监控大屏
首选工具:Plotly(搭配 Dash 或 Streamlit)
如果你的受众是产品经理、业务运营或企业管理层,静态图片往往无法满足他们“查明细、换区间、下钻分析”的直觉诉求。通过 Plotly 生成的图表可以直接嵌入现有的 Vue、React 前端架构,也可以直接用纯 Python 编写的 Dash 框架构建全套多图联动的 BI 仪表盘,无需前端工程师介入即可完成生产级数据看板搭建。
4. 场景四:算法研发内部的特殊复合图与自定义几何图元
首选工具:Matplotlib 面向对象 API
当你的图表不再是常规的折线散点,而是涉及复杂的机器人路径规划、神经网络前向传播几何拓扑、雷达波形扫描图,或者是多个不等宽、不等高的复杂排版网格(GridSpec)时,任何上层封装都会成为枷锁。此时唯有 Matplotlib 的底层 Artist 体系能提供毫无保留的实现能力。
五、生产环境协同流水线与关键实践
在成熟的数据科学团队中,这三个库从不是割裂的,而是形成了一条协同流水线。
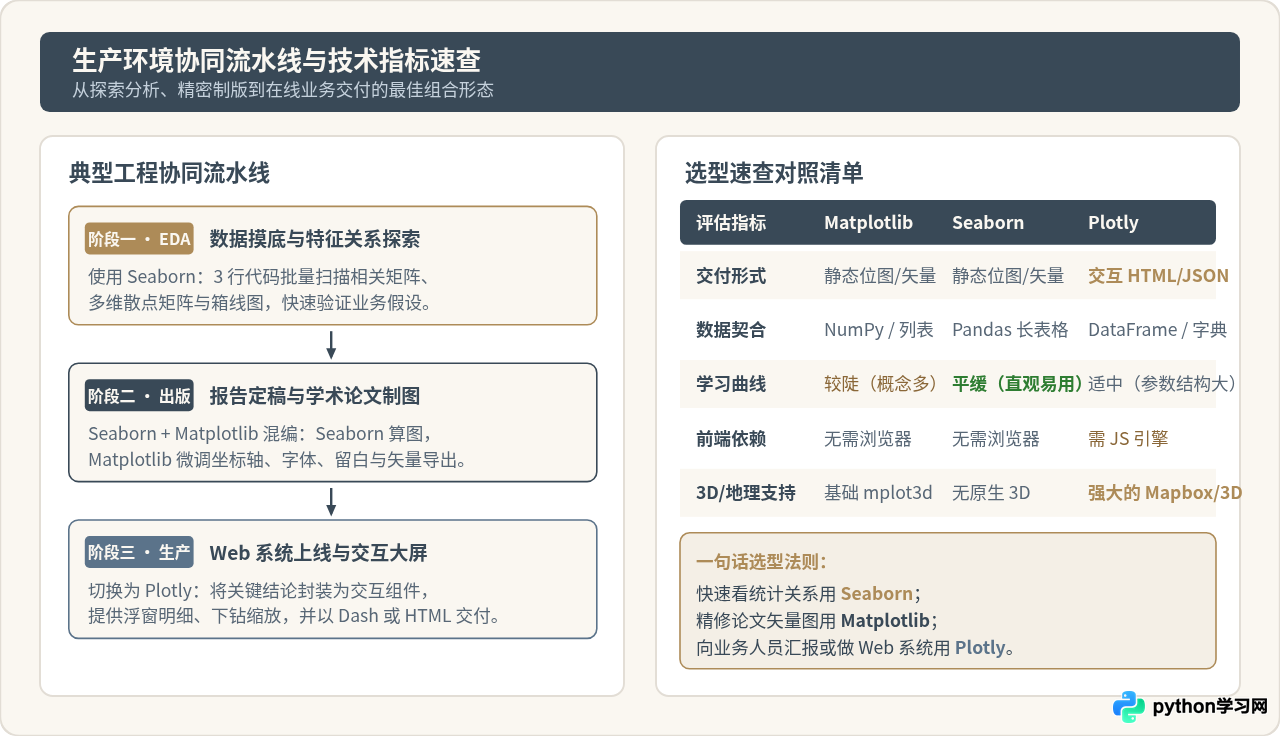
1. Seaborn 与 Matplotlib 的混编范式
很多开发者误以为用了 Seaborn 就不能用 Matplotlib。实际上,Seaborn 的所有绘图函数均支持接收或返回 Matplotlib 的 ax 对象。请牢记下面这个极其常用的生产混合写法:
import matplotlib.pyplot as plt
import seaborn as sns

# 1. 显式由 Matplotlib 创建具有特定比例的画框
fig, ax = plt.subplots(figsize=(7, 4), dpi=150)

# 2. 将 ax 传给 Seaborn 进行复杂的统计绘图
sns.boxplot(data=df, x="store_type", y="sales_revenue", ax=ax, palette="Blues")

# 3. 立即切回 Matplotlib 强大的底层微调能力
ax.set_ylim(0, 500)
ax.axhline(280, color="#AD8B58", linestyle="--", linewidth=1.5, label="公司季度达标基准线")
ax.spines["top"].set_visible(False)   # 去除上方坐标脊柱
ax.spines["right"].set_visible(False) # 去除右侧坐标脊柱
ax.legend(loc="upper left")

# 4. 保存为高分辨率印刷矢量文件
fig.savefig("sales_benchmark.pdf", format="pdf", bbox_inches="tight")
2. 性能边界与海量点阵渲染避坑
当数据规模上升到 10 万点以上时,不同库的性能瓶颈截然不同:
- Matplotlib:依靠 C 语言实现的 Agg 后端,渲染 10 万个散点大约需要 0.5 到 1 秒。虽然速度可以接受,但在交互模式下缩放会出现明显卡顿。对于千万级超大数据集,应搭配
datashader库预先栅格化。 - Plotly:默认的
px.scatter使用 SVG 节点绘制每个数据点。一旦数据超过 1 万点,浏览器 DOM 树会急剧膨胀导致网页崩溃。正确做法:在 Plotly 中处理大数据集时,必须使用基于 WebGL 硬件加速的go.Scattergl替代默认的Scatter,这样即可轻松流畅交互 10 万乃至 50 万量级数据点。
3. 中文字体配置防乱码速记
中文开发者最常遇到的问题是图表中的中文被渲染为“豆腐块”方框。这是因为 Matplotlib 默认的英文字体(DejaVu Sans)不包含中文字符。统一解决方案如下:
import matplotlib.pyplot as plt

# 兼容 macOS 与 Windows 系统的优雅回退字体方案
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
# 解决负号 '-' 显示为方块的问题
plt.rcParams['axes.unicode_minus'] = False
由于 Seaborn 依赖 Matplotlib,上述配置一旦生效,Seaborn 的所有图表将同步恢复正常中文显示。而 Plotly 运行在浏览器端,只要宿主操作系统或浏览器安装了常规中文字体,即可直接正确显示中文,无需配置 rcParams。
六、总结速查与选型法则
总结三者的定位差异,可以归结为以下三句实战法则:
- 需要快速验证统计假设、挖掘多变量相关性时:毫不犹豫选择 Seaborn,它能让你专注于数据本身,而非语法细节。
- 撰写学术论文、制作高精印刷图表、需要像素级定制排版时:以 Matplotlib(或 Seaborn+Matplotlib 混编)为终极基石,掌控每个图元的导出质量。
- 面向客户、业务汇报、交付 Web 页面或搭建交互看板时:全面采用 Plotly,让交互能力成为阐述数据价值的核心载体。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









