

Python爬虫数据保存指南:存入CSV、Excel与MySQL数据库
全面讲解Python网络爬虫采集数据的三种主流持久化方式:使用标准库csv模块导出CSV文件并解决中文乱码与空行问题;使用openpyxl与pandas生成多表单格式化Excel文件;使用PyMySQL实现高效批量入库、唯一键去重更新与事务安全控制。
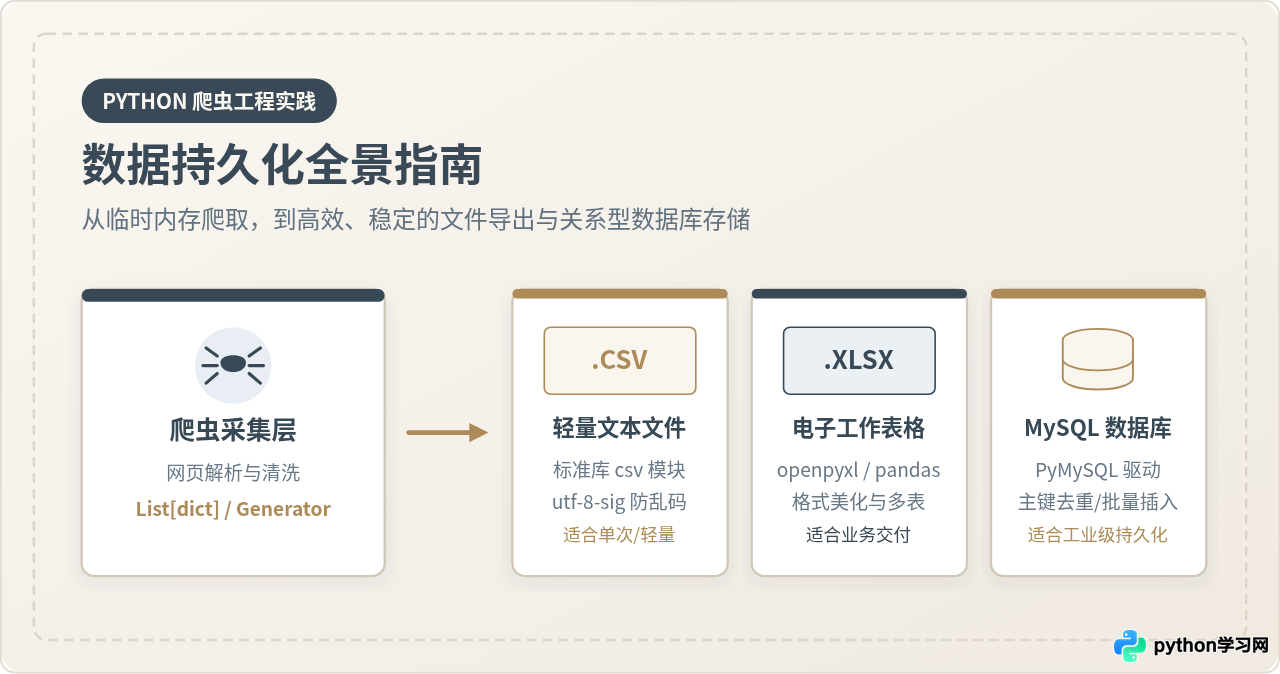
List[dict])或生成器中。要让这些数据发挥分析与应用价值,必须将其落盘存储。本文针对爬虫工程中最常用的三种持久化介质——CSV纯文本文件、Excel电子表格以及MySQL关系型数据库,提供从原理到代码实现的完整落地指南,逐一攻克中文乱码、多表格式化、批量高效写入与幂等去重等核心痛点。
数据持久化技术选型依据
面对不同的抓取需求与数据规模,选择合适的存储方案是爬虫项目工程化的第一步。若选型不当,可能导致程序内存暴涨崩溃、数据二次抓取重复污染,或交付给业务同事时无法直接查看。
选择存储方案时,主要从三个维度考量:数据体量、后续使用方式、以及是否需要长期增量排重维护。
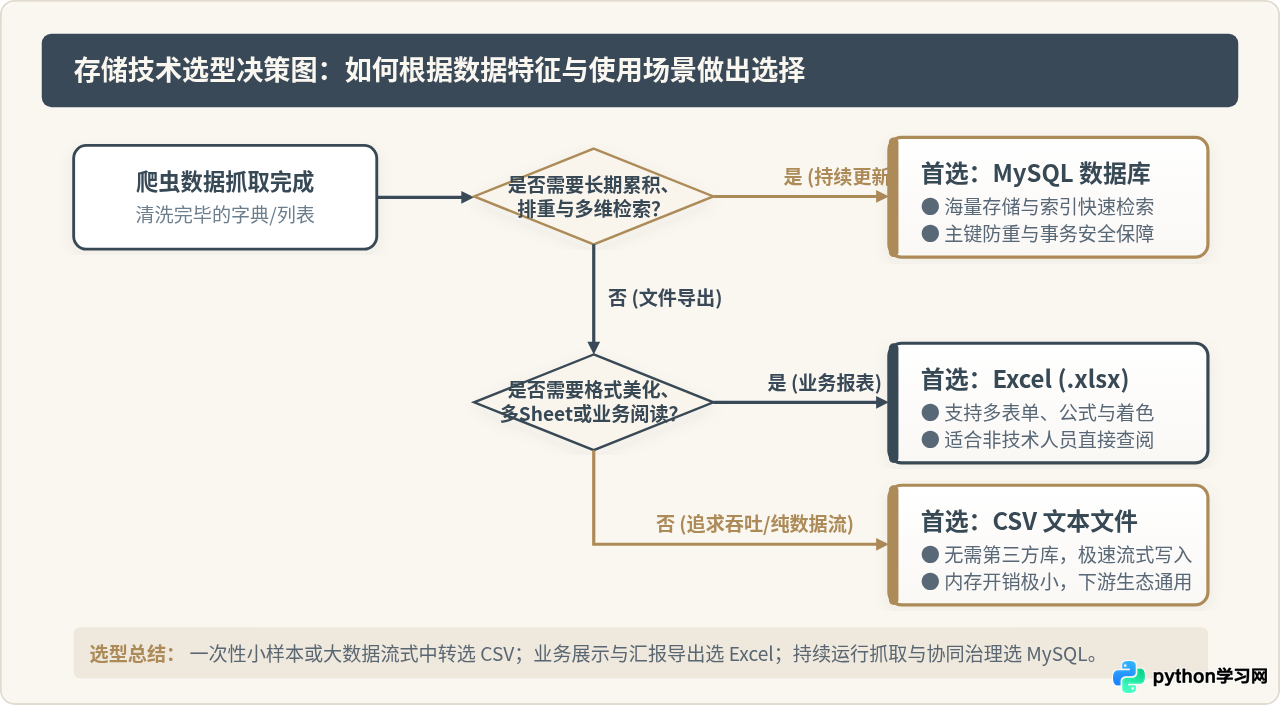
从上图可以看出明确的选型分工:
- CSV 文件:适用于单次或中短期抓取、数据结构扁平且字段固定、需要极速流式落盘、或后续交由大数据计算框架(如 Pandas、Spark)进行二次中转处理的场景。
- Excel 文件(.xlsx):适用于汇报总结、需区分多个子表(Sheet)、需要直观展示样式(如表头加粗、列宽自适应、条件格式)并直接发送给非技术业务人员直接开箱查阅的场景。
- MySQL 数据库:适用于长周期运行的持续监控爬虫、数据量级超过百万行、需要依靠主键或唯一索引自动防重排重、以及需要通过 SQL 多条件复杂检索的工业级生产场景。
方案一:保存为 CSV 文件(轻量、高效与防乱码)
CSV(Comma-Separated Values)是以纯文本形式存储表格数据的格式,Python 标准库自带 csv 模块,无需额外安装第三方依赖。爬虫抓取到的单条记录通常是字典形式,使用 csv.DictWriter 是最健壮、最不易错位的方式。
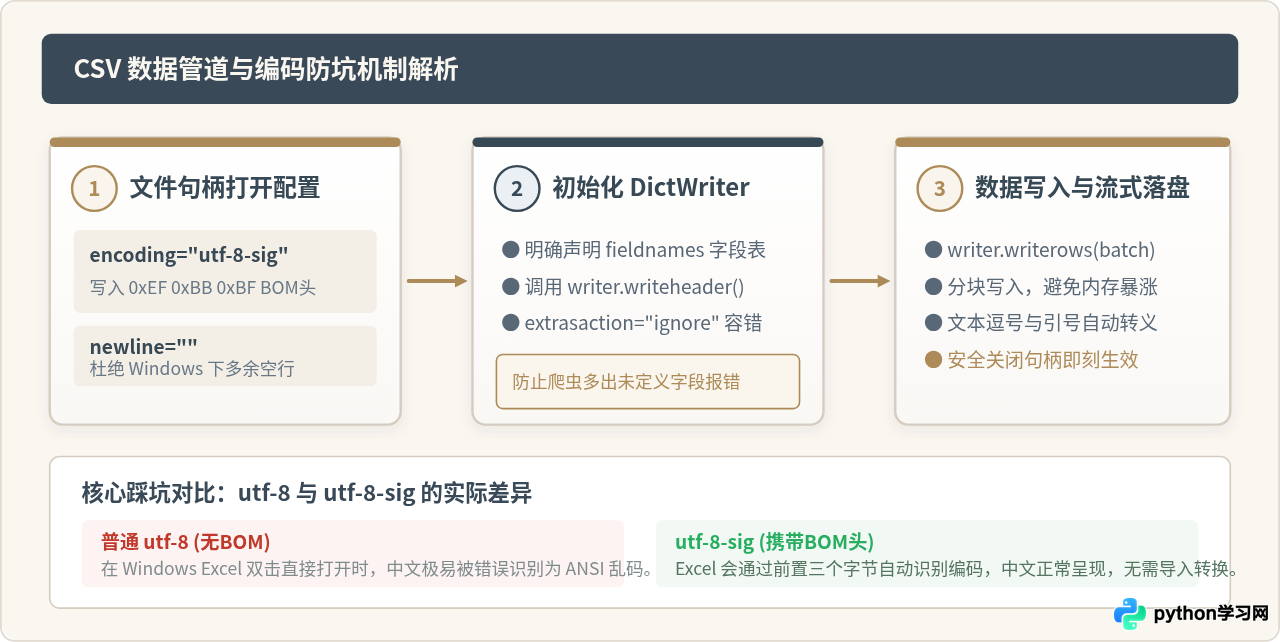
1. 核心踩坑与规避规则
在向 CSV 写入中文爬虫数据时,开发者最常遇到两个问题:空行间隔与Windows 打开乱码。
- 空行问题:Windows 系统默认行末换行为
\r\n,如果open()函数未设置newline='',Python 的csv写入器在写入行时会自行追加\r\n,导致文本中出现双重换行,在表格阅读软件中每一行正文之间都会夹杂一个空白空行。 - Excel 中文乱码:虽然现代软件普遍支持
utf-8,但 Windows 平台的微软 Excel 在直接双击打开.csv文件时,默认会依据系统区域设置使用 ANSI(如 GBK)解码。若文件声明为无 BOM 的纯utf-8,Excel 将无法正确识别而显示乱码。解决办法是将文件编码指定为utf-8-sig,它会在文件头部写入 3 字节的 BOM 标记(\xEF\xBB\xBF),强制 Excel 准确按 UTF-8 解码。
2. 完整实战代码:分块批量写入 CSV
以下示例模拟爬虫解析出来的结构化字典数据,展示如何安全创建表头并流式追加数据:
import csv
from typing import List, Dict, Any

def save_to_csv(file_path: str, data_list: List[Dict[str, Any]], fieldnames: List[str]) -> None:
    """
    安全保存爬虫数据为 CSV 文件
    :param file_path: 输出文件路径
    :param data_list: 抓取到的字典列表
    :param fieldnames: 规范表头字段列表
    """
    if not data_list:
        print("[提示] 暂无数据需要写入 CSV")
        return

    # newline='' 杜绝空行;encoding='utf-8-sig' 确保 Excel 打开中文不乱码
    with open(file_path, mode='w', encoding='utf-8-sig', newline='') as f:
        # extrasaction='ignore':如果抓取字典有多余字段,自动忽略而不崩溃
        writer = csv.DictWriter(f, fieldnames=fieldnames, extrasaction='ignore')

        # 1. 写入表头
        writer.writeheader()

        # 2. 批量写入行
        writer.writerows(data_list)

    print(f"[成功] 已成功将 {len(data_list)} 条数据保存至: {file_path}")

# 示例调用
if __name__ == "__main__":
    fields = ["goods_id", "title", "price", "shop_name", "comment_count"]
    sample_crawled_data = [
        {"goods_id": "1001", "title": "机械键盘 青轴 RGB", "price": 299.00, "shop_name": "极客数码旗舰店", "comment_count": 5200},
        {"goods_id": "1002", "title": "人体工学电脑椅 网布透气", "price": 899.00, "shop_name": "健康办公家居", "comment_count": 3100},
        {"goods_id": "1003", "title": "4K IPS 显示器 27英寸", "price": 1499.50, "shop_name": "视界数码专营", "comment_count": 12800},
    ]
    save_to_csv("crawled_products.csv", sample_crawled_data, fields)
当爬虫数据量极大、无法全部塞在内存中时,应将文件打开模式设为 'a'(追加)。在爬虫启动前先检查文件是否存在,若不存在则以 'w' 写入一次 writeheader(),之后爬完一批即可调用 writer.writerows(batch) 及时落盘并清空内存批次列表,有效防止进程被系统 OOM 强杀。
方案二:保存为 Excel 文件(多表单与报表美化)
当数据需要直接交付给业务部门、财务或运营人员时,Excel(.xlsx)是最受欢迎的格式。Python 生态中主要使用 openpyxl(偏向格式定制与工作簿底层操作)或 pandas(偏向数据批量分析与快捷导出)。
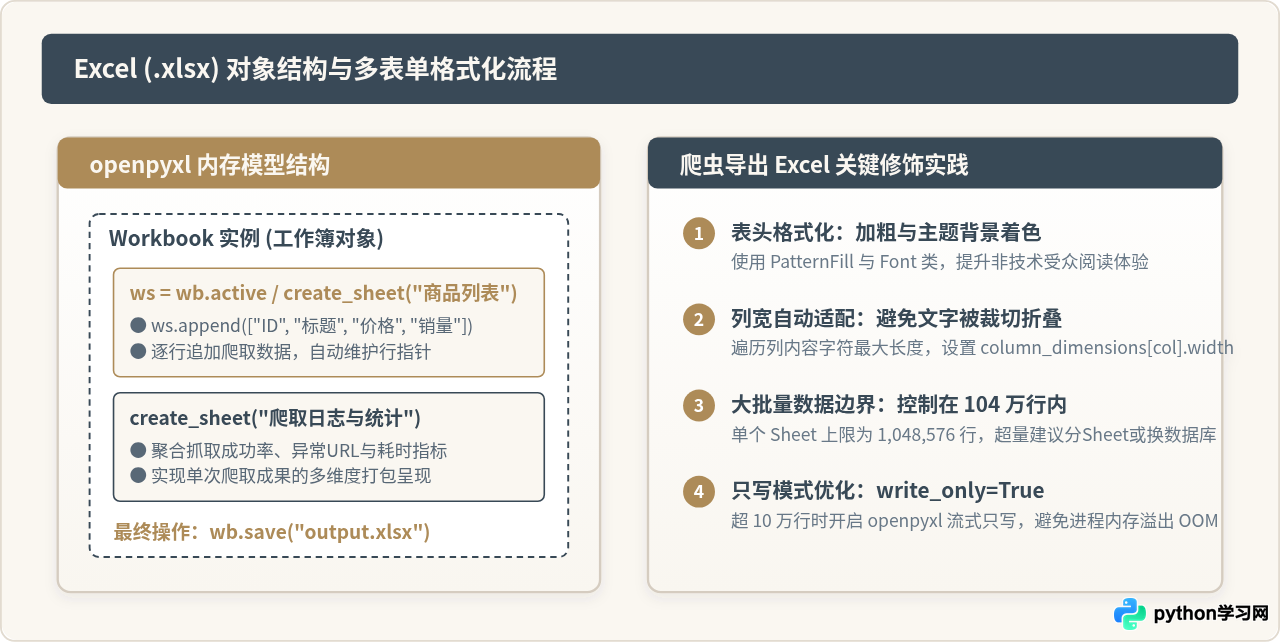
1. openpyxl 安装与结构理解
首先安装所需依赖库:
pip install openpyxl pandasExcel 文件由工作簿(Workbook)和若干工作表(Worksheet)组成。爬虫在导出数据时,往往可以在第一个 Sheet 存放采集的正文核心数据,在第二个 Sheet 记录爬虫运行摘要(如抓取起始时间、请求总数、成功条数、耗时等)。
2. 完整实战代码:多 Sheet 与自适应列宽美化导出
from openpyxl import Workbook
from openpyxl.styles import Font, PatternFill, Alignment, Border, Side
from openpyxl.utils import get_column_letter

def export_to_styled_excel(file_path: str, items: list, log_info: dict) -> None:
    wb = Workbook()

    # ---------------- 1. 核心数据 Sheet ----------------
    ws_data = wb.active
    ws_data.title = "商品采集数据"

    headers = ["商品编号", "商品名称", "标价 (元)", "店铺名称", "评价数量"]
    ws_data.append(headers)

    # 美化表头:深蓝灰底色、白色粗体、文字居中
    header_fill = PatternFill(start_color="394957", end_color="394957", fill_type="solid")
    header_font = Font(name="Microsoft YaHei", size=11, bold=True, color="FAF7F1")
    align_center = Alignment(horizontal="center", vertical="center")

    for col_num in range(1, len(headers) + 1):
        cell = ws_data.cell(row=1, column=col_num)
        cell.fill = header_fill
        cell.font = header_font
        cell.alignment = align_center

    # 填充正文行
    for item in items:
        row_values = [
            item.get("goods_id", ""),
            item.get("title", ""),
            item.get("price", 0.0),
            item.get("shop_name", ""),
            item.get("comment_count", 0)
        ]
        ws_data.append(row_values)

    # 自动适配列宽(避免内容被截断)
    for col in ws_data.columns:
        max_len = 0
        col_letter = get_column_letter(col[0].column)
        for cell in col:
            val_str = str(cell.value or "")
            # 中文字符长度补偿(双字节)
            char_len = sum(2 if ord(c) > 127 else 1 for c in val_str)
            if char_len > max_len:
                max_len = char_len
        ws_data.column_dimensions[col_letter].width = max(max_len + 4, 12)

    # ---------------- 2. 爬虫日志 Sheet ----------------
    ws_log = wb.create_sheet(title="采集元数据")
    ws_log.append(["统计项", "统计值"])
    for k, v in log_info.items():
        ws_log.append([k, str(v)])

    # 保存工作簿
    wb.save(file_path)
    print(f"[成功] 格式化 Excel 已保存至: {file_path}")

# 执行调用
if __name__ == "__main__":
    data = [
        {"goods_id": "A101", "title": "降噪无线头戴耳机", "price": 1299.00, "shop_name": "声学先锋官方店", "comment_count": 8900},
        {"goods_id": "A102", "title": "便携式机械键盘 68键", "price": 359.00, "shop_name": "外设制造工坊", "comment_count": 420},
    ]
    meta = {"抓取任务ID": "TASK-202611-09", "抓取总页数": 10, "采集成功率": "100%", "操作人": "SpiderBot"}
    export_to_styled_excel("crawled_report.xlsx", data, meta)
1. 行数天花板:单个 .xlsx 工作表最大支持 1,048,576 行。如果爬取的数据量预计超百万行,强行写入会导致 openpyxl 报错崩溃。
2. 内存消耗:openpyxl 默认在内存中构建完整的 DOM 树,十几万条数据就可能吃掉数 GB 内存。若必须导出大批量 Excel,建议在初始化时启用 Workbook(write_only=True) 流式写入模式。
方案三:保存为 MySQL 数据库(高并发、排重与工业级存储)
在生产环境和商业爬虫中,关系型数据库 MySQL 是绝对的主力。无论是多爬虫节点并发抓取,还是按天增量监控更新,MySQL 的 ACID 事务、B+ 树索引检索和主键防重机制都能提供不可替代的稳定性。
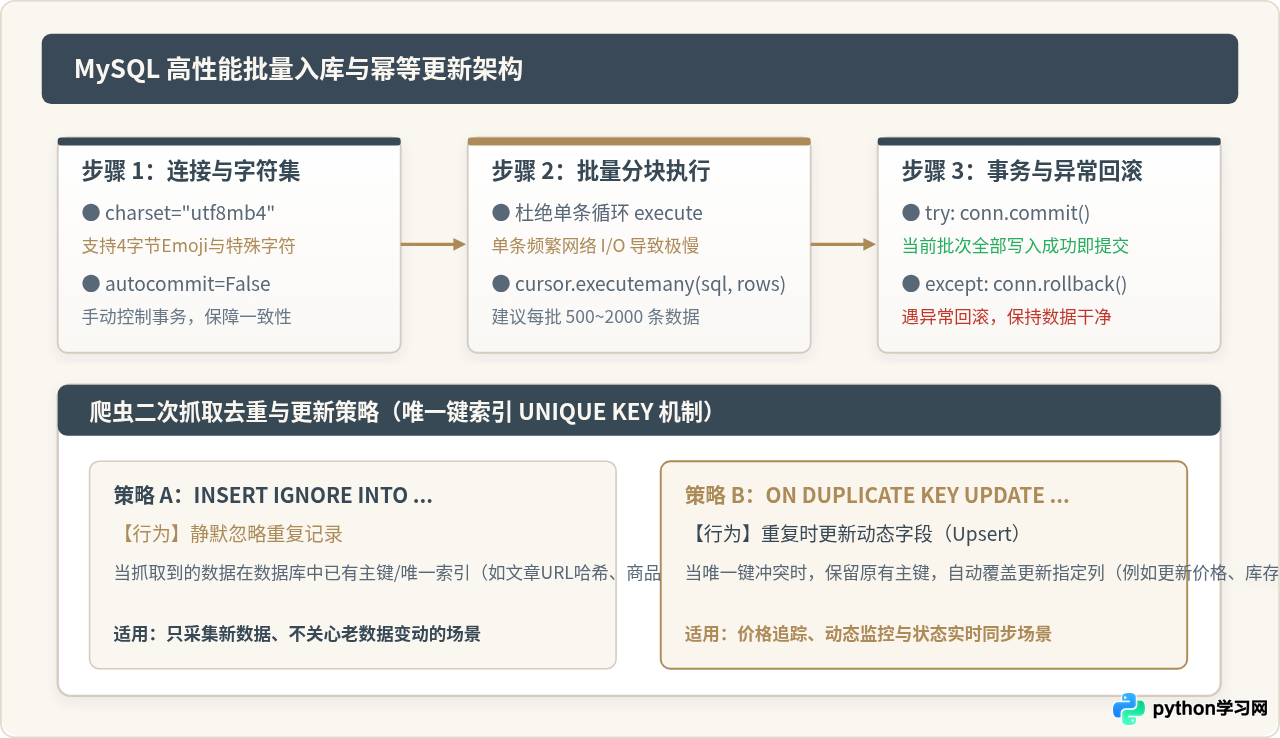
1. 表结构设计核心规范
设计爬虫目标数据表时,有三个原则必须遵守:
- 字符集选择
utf8mb4:网页内容五花八门,用户昵称、评论及商品描述中经常含有 Emoji 表情符号(4 字节)。传统的utf8仅支持最多 3 字节字符,遇到 Emoji 会直接抛出OperationalError: 1366, Incorrect string value异常。 - 唯一键去重(UNIQUE KEY):为数据的唯一标识(如网页 URL 的 MD5 哈希、平台的
item_id)设置唯一索引,这是后续实现无痛增量防重的基础。 - 时间戳跟踪:配备
created_at和updated_at字段,便于按抓取批次检索与监控数据时效性。
2. DDL 建表 SQL 语句
CREATE TABLE IF NOT EXISTS `spider_products` (
  `id` BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '自增主键',
  `goods_id` VARCHAR(64) NOT NULL COMMENT '目标平台唯一商品ID',
  `title` VARCHAR(255) NOT NULL COMMENT '商品标题',
  `price` DECIMAL(10,2) NOT NULL DEFAULT 0.00 COMMENT '最新价格',
  `shop_name` VARCHAR(128) NOT NULL DEFAULT '' COMMENT '店铺名称',
  `comment_count` INT UNSIGNED NOT NULL DEFAULT 0 COMMENT '评价条数',
  `crawl_time` DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '采集时间',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uniq_goods_id` (`goods_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci COMMENT='爬虫采集商品表';
3. 完整实战代码:PyMySQL 批量插入与幂等更新(Upsert)
为了实现高效入库,我们使用 cursor.executemany() 配合 SQL 的 ON DUPLICATE KEY UPDATE 语法:
import pymysql
from typing import List, Tuple

def save_to_mysql(items: List[dict]) -> None:
    # 数据库连接配置(生产环境建议从环境变量或配置文件读取)
    db_config = {
        "host": "localhost",
        "port": 3306,
        "user": "root",
        "password": "your_secure_password",
        "database": "crawler_db",
        "charset": "utf8mb4",
        "autocommit": False  # 手动控制事务,保障一致性
    }

    if not items:
        return

    # 准备 SQL 语句:利用 ON DUPLICATE KEY UPDATE 实现存在即更新,不存在即插入
    sql = """
    INSERT INTO spider_products (goods_id, title, price, shop_name, comment_count, crawl_time)
    VALUES (%s, %s, %s, %s, %s, NOW())
    ON DUPLICATE KEY UPDATE
        price = VALUES(price),
        comment_count = VALUES(comment_count),
        crawl_time = VALUES(crawl_time);
    """

    # 提取为 tuple 列表供 executemany 批量使用
    params = [
        (
            item["goods_id"],
            item["title"][:250],  # 截断防超长
            item["price"],
            item.get("shop_name", ""),
            item.get("comment_count", 0)
        )
        for item in items
    ]

    conn = None
    try:
        conn = pymysql.connect(**db_config)
        with conn.cursor() as cursor:
            # 批量执行,性能比单条 execute 高出数十倍
            affected_rows = cursor.executemany(sql, params)
            conn.commit()
            print(f"[成功] 批量入库完成,影响行数: {affected_rows} (插入数 + 更新数*2)")
    except Exception as e:
        if conn:
            conn.rollback()  # 遇到异常立即回滚当前批次,避免脏数据
        print(f"[错误] MySQL 入库失败,已执行回滚: {e}")
        raise e
    finally:
        if conn:
            conn.close()

# 模拟调用
if __name__ == "__main__":
    crawled_batch = [
        {"goods_id": "SKU-9901", "title": "无线降噪蓝牙耳机", "price": 499.00, "shop_name": "官方自营", "comment_count": 3000},
        {"goods_id": "SKU-9902", "title": "智能运动手表 防水", "price": 799.00, "shop_name": "穿戴数码馆", "comment_count": 1500},
    ]
    # save_to_mysql(crawled_batch)  # 需配置可用 MySQL 实例运行
初学者常在 for item in items: cursor.execute(...) 循环插入。每一条 SQL 都会产生一次 Python 进程到数据库服务的网络往返延迟(Round-Trip Time)与语法解析开销。实测在抓取 10,000 条数据时,单条循环可能需要 20~40 秒,而使用 executemany 分批(如每批 1000 条)只需不到 0.8 秒,性能提升达数十倍。
三种方案综合对比与工程演进建议
为了让读者在实际项目启动时迅速定位方案,下表将三种方式在核心维度的表现进行汇总提炼:
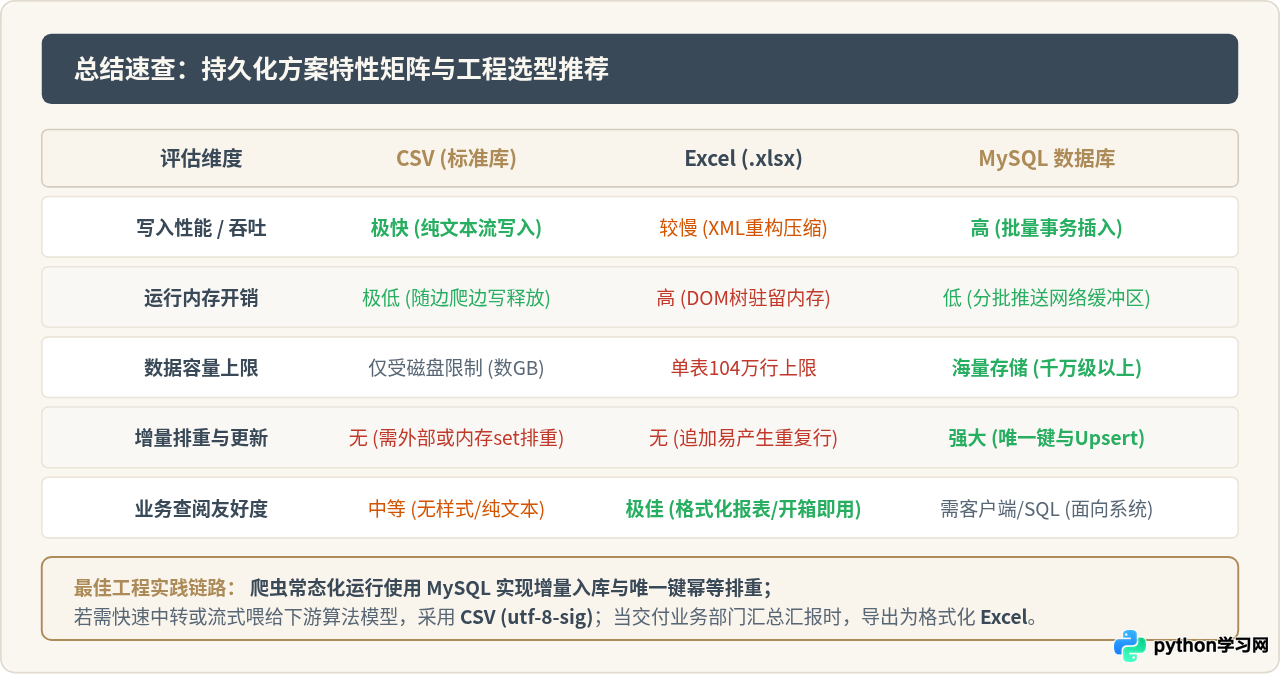
| 特性维度 | CSV 文本文件 | Excel (.xlsx) | MySQL 关系型数据库 |
|---|---|---|---|
| 核心工具库 | 标准库 csv(零第三方依赖) |
openpyxl / pandas |
pymysql / SQLAlchemy |
| 写入速度 | 极快(毫秒级纯文本输出) | 较慢(涉及 XML 封装与压缩) | 高(配合 executemany 批处理) |
| 排重与更新 | 无(只能在内存或外部维护哈希集) | 无(只能整表重写或末尾追加) | 极强(依赖 UNIQUE KEY 幂等更新) |
| 数据容量 | 仅受操作系统与硬盘限制 | 单表上限 1,048,576 行 | 千万级至亿级(支持分库分表与分区) |
| 适合交付对象 | 数据研发、算法清洗、日志存储 | 业务分析师、运营、管理层直接查阅 | 后端业务服务、定时监控调度系统 |
工程总结
在成熟的爬虫架构演进中,这三种方式并不是非此即彼的孤立存在,而是常常协同作战:
- 爬取监控期:爬虫采集任务全天候不间断调度,数据实时使用
pymysql批量写入 MySQL,借助唯一索引自动过滤重复抓取的旧网页,并刷新动态价格与库存字段。 - 数据清洗期:离线数据分析流水线可随时利用 SQL 导出按需切片的轻量
CSV文件,以极高的 IO 吞吐供给 Pandas 或机器学习模型进行特征工程处理。 - 运营交付期:当产出分析结论或异常报警清单时,编写自动化脚本将聚合后的统计数据渲染为样式优雅、排版工整的多 Sheet
Excel报表,通过邮件自动分发至业务团队。
掌握以上各存储载体的机制与规避细节,即可根据具体的吞吐量、业务场景与架构层级,设计出高效、健壮且无后顾之忧的爬虫持久化管道。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









