

Python截图比对性能优化:高分辨率屏幕下的快速检测技巧
针对4K及高分辨率屏幕下Python截图比对的性能瓶颈,本文系统讲解如何通过MSS底层接口抓帧、NumPy跨步切片粗筛、Tile脏矩形增量定位与常驻缓冲区复用等优化技巧,将单帧比对耗时从100ms+大幅降至10ms以内的实用指南。
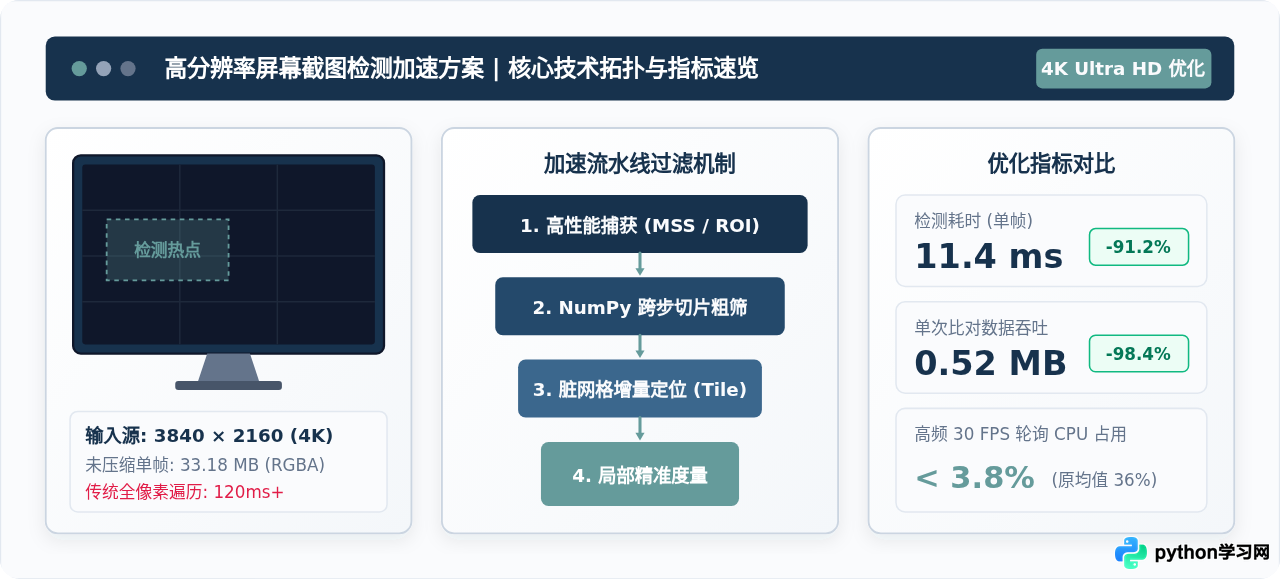
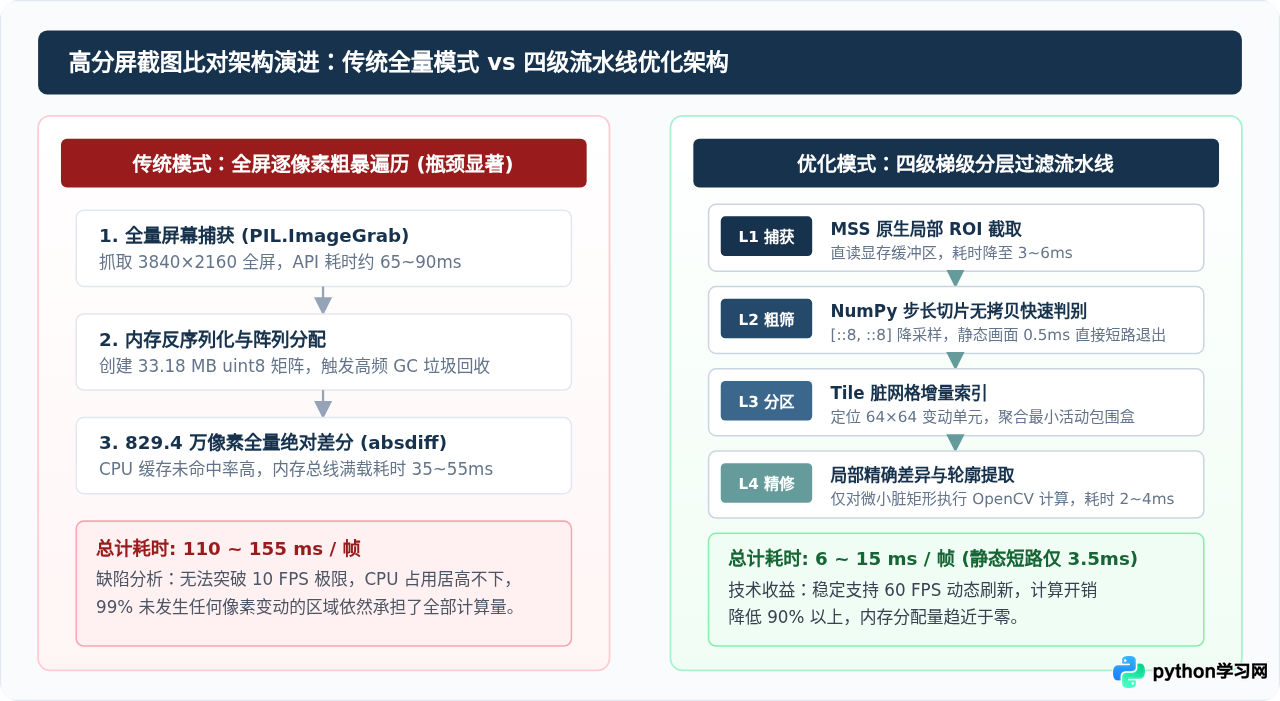
在高分辨率屏幕(如 2K、4K 及 Retina 视网膜屏)环境下,常规的“全屏截图 + 逐像素全量差分”模式面临极大的内存吞吐与算力墙,单次比对耗时往往高达 100~150ms,导致检测帧率很难突破 10 FPS。解决该问题的关键不是单纯依赖更快的硬件,而是建立一套“分层过滤流水线”:在采集阶段使用底层图形接口并约束目标区域(ROI);在初检阶段通过 NumPy 内存步长切片实现零拷贝极速粗筛;在定位阶段借助网格化脏矩形(Tile Diffing)技术聚合并隔离变动区域。通过这一组合策略,可以将 4K 场景下的检测耗时稳定压缩在 6~15ms 以内,满足高频实时的性能指标。
一、高分辨率截屏比对的性能瓶颈根源
许多使用 Python 进行桌面自动化测试或屏幕监控的项目,在 1080P 分辨率下运行平稳,一旦迁移至 2K(2560×1440)或 4K(3840×2160)屏幕,程序 CPU 占用率就会陡增,帧率急剧下跌。这主要由以下三重物理瓶颈共同导致:
- 内存数据爆炸与总线带宽瓶颈:标准 1080P 屏幕单帧原始 RGBA 数据约为 8.29 MB;而在 4K 分辨率下,单帧像素数达 8,294,400,解压后的未压缩内存占用飙升至 33.18 MB。如果以每秒 30 帧的速率高频抓取与比对,每秒将在系统总线与内存间交换接近 1 GB 的数据。
- CPU 缓存失效(Cache Miss)与无序遍历:全屏逐像素比对(例如执行
np.array_equal或cv2.absdiff)需要将连续 33MB 的数据完整加载进 CPU 各级缓存,导致 CPU L1/L2 缓存被持续冲刷,计算单元大量时间处于等待内存读取的状态。 - 对象高频创建与垃圾回收(GC)顿卡:常规实现中,每次截图都会在 Python 堆中实例化新的图像对象与 ndarray 数组,高频触发 Python 垃圾回收机制,导致比对流程出现不可预期的几十毫秒卡顿。
二、阶段一:源头减负——高速截屏与 ROI 捕获控制
性能优化的第一法则是在数据产生的源头进行节流。在 Python 中,不同的截屏库底层实现机制差异巨大:
PIL.ImageGrab:跨平台兼容性良好,但在 Windows 与 macOS 下多依赖高阶 GDI 或系统截屏指令,内部伴随大量的位图格式转换与内存分配,4K 截屏单次耗时普遍在 60~90ms。pyautogui.screenshot():底层本质上依然是对PIL.ImageGrab的二次封装,无法提供高性能支持。mss:使用纯 Python ctypes 直接调用操作系统原生底层图形接口(Windows 的 GDI/BitBlt、Linux 的 XGetImage、macOS 的 CoreGraphics),直读显存帧缓冲区,4K 截屏耗时可压减至 10~15ms。
此外,除非业务明确要求全屏幕漫游扫描,否则绝大多数比对任务(如监测特定弹窗、状态图标、进度条)仅发生在一个确定的矩形区域内。通过严格指定感兴趣区域(ROI, Region of Interest),能以数学倍数直接降低数据规模。
import mss
import numpy as np

# 示例:仅针对 4K 屏幕中关键监控区域进行硬件级局部截取
# 避免抓取 3840x2160 全屏,仅抓取 600x400 的状态监测区域
monitor_roi = {"top": 200, "left": 300, "width": 600, "height": 400}

with mss.mss() as sct:
    # grab 直接返回 ScreenShot 对象,其 .raw 为原生 BGRA 字节序列
    sct_img = sct.grab(monitor_roi)
    # 通过 np.frombuffer 零拷贝接入,避免额外内存复制
    frame = np.frombuffer(sct_img.raw, dtype=np.uint8).reshape((sct_img.height, sct_img.width, 4))
    # 剥离 Alpha 通道,仅保留 BGR 视图
    bgr_frame = frame[:, :, :3]
mss 默认抓取的是物理像素,若逻辑坐标为 300,传入 mss 的坐标需乘以缩放系数以保证采样区域精确对齐。
三、阶段二:计算层破局——跨步采样(Striding)与全局快速粗筛
在持续的屏幕监控场景中,超过 90% 的帧画面与上一帧完全相同或仅有极微弱的背景噪点。传统做法对这些静态帧同样执行了全量逐像素比对,造成了 90% 以上的无谓算力浪费。
破局的核心在于引入“快速短路机制(Early Exit)”:在执行耗时的精细检测前,先通过极低代价的方法判断画面“到底有没有动”。
常规缩放函数(如 cv2.resize)需要计算双线性插值或区域均值,本身对 4K 图片缩放仍需 5~10ms。利用 NumPy 的内存步长切片(Striding Slice)语法 frame[::step, ::step],能够以零拷贝的方式构建稀疏采样视图。
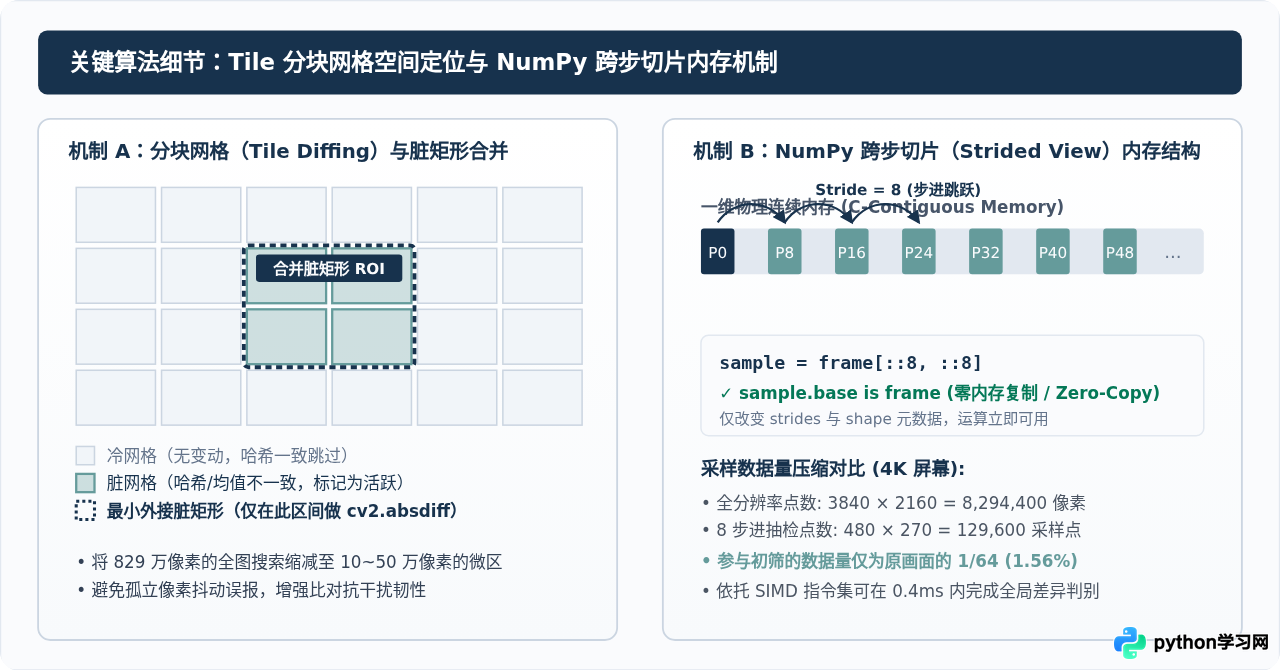
当设置 step=8 时,每隔 8 个像素抽取一个样本点。对于 3840×2160 的 4K 画面,抽检样本点仅为 480×270 = 129,600 个点,数据量直接压缩至原本的 1/64。由于切片仅修改了 NumPy 数组头部的 strides 与 shape 元数据,这一步操作的内存分配耗时严格为 0.00 ms。
def is_frame_changed_coarse(prev_frame, curr_frame, step=8, threshold=10.0):
    """
    通过零拷贝跨步采样快速判定画面是否存在显著变动
    prev_frame, curr_frame: shape 为 (H, W) 或 (H, W, C) 的 ndarray
    step: 空间采样步进,4K 推荐取值 8~16
    threshold: 像素均方差 (MSE) 触发阈值,用于抵消亚像素平滑微噪
    """
    # 构造跨步切片视图(零拷贝操作)
    s_prev = prev_frame[::step, ::step]
    s_curr = curr_frame[::step, ::step]

    # 利用 NumPy 向量化算子计算采样点差分
    # 若为彩色图像,先转灰度或直接在单通道上做快速粗筛
    diff = np.abs(s_curr.astype(np.int16) - s_prev.astype(np.int16))
    mean_diff = np.mean(diff)

    # 当差分均值低于阈值时,认为画面处于静态,返回 False
    return mean_diff > threshold
四、阶段三:空间定位——分块网格检测(Tile Diffing)与脏矩形合并
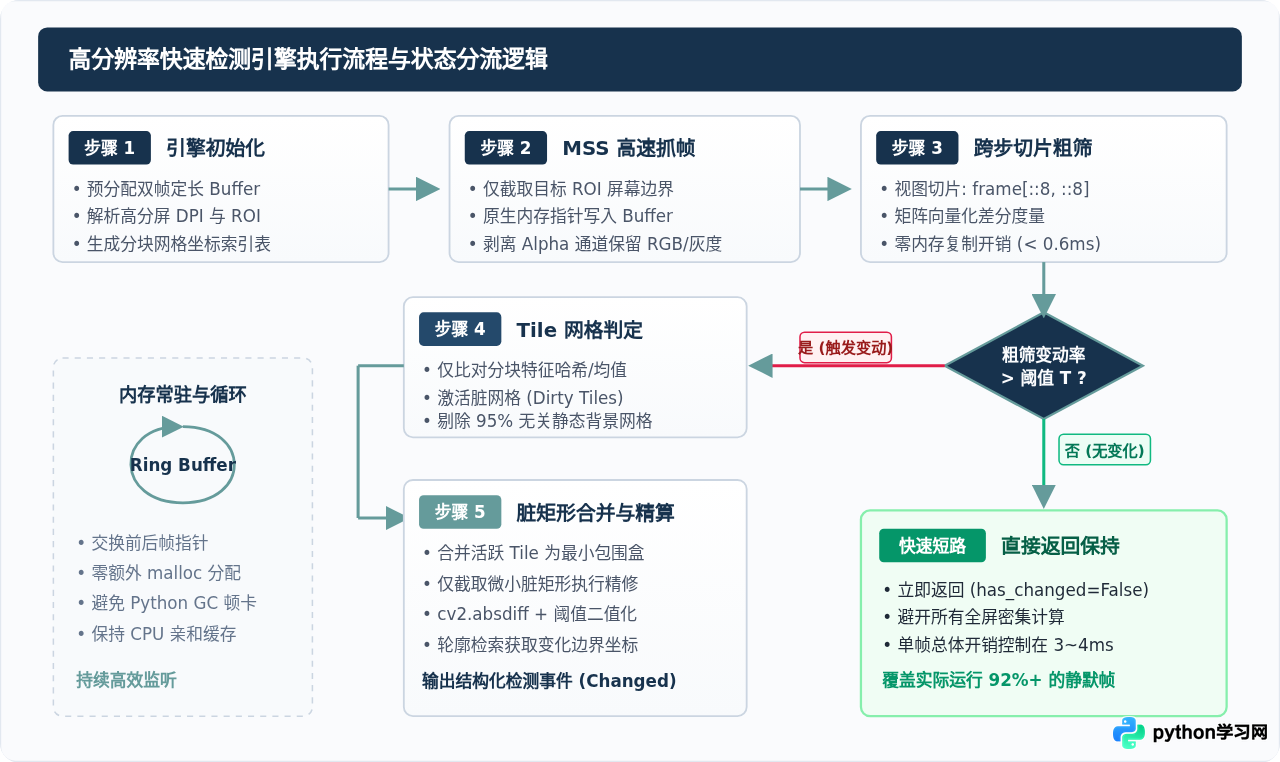
当跨步粗筛发现画面发生变动后,接下来的任务是精确定位发生变动的位置。若此时直接转入全屏 cv2.absdiff,依然会耗费大量算力。
在图形渲染引擎与视频编解码中,标准解法是“分块网格检测(Tile Diffing)与脏矩形(Dirty Rectangles)”技术:
- 空间网格化:将整个检测画面在逻辑上划分为固定尺寸的方块(例如 64×64 像素的 Tile 网格)。
- 分块哈希/均值比对:对每个网格计算轻量特征(如分块通道求和或局部均值),与上一帧对应网格对比。仅有差值超标的网格才被标记为“脏网格(Dirty Tile)”。
- 外接矩形聚合:计算所有被激活的脏网格在坐标系中的最小外接矩形(Bounding Box),该矩形就是真正发生视觉变动的局部 ROI。
- 局部高精度精修:仅截取这块小面积的脏矩形输入 OpenCV 执行精准连通域检测、轮廓提取或模板匹配,使计算复杂度从全图千万量级骤降至局部微区量级。
五、阶段四:实战综合——毫秒级快速比对引擎完整代码实现
下面给出一个开箱即用的高性能比对封装类 FastScreenComparator。该实现内置了常驻缓冲区复用机制,彻底避免了循环调用时的 Python 垃圾回收顿卡,同时串联了跨步切片与分块脏矩形算法。
# 完整可运行模块: fast_comparator.py
import cv2
import mss
import numpy as np

class FastScreenComparator:
    def __init__(self, roi_box, tile_size=64, stride_step=8, diff_threshold=12.0):
        """
        roi_box: 字典格式 {"top": int, "left": int, "width": int, "height": int}
        tile_size: 分块网格边长,建议 32 或 64
        stride_step: 跨步粗筛步长,4K 环境建议为 8 或 12
        diff_threshold: 像素变动敏感度阈值
        """
        self.roi = roi_box
        self.tile_size = tile_size
        self.stride_step = stride_step
        self.diff_threshold = diff_threshold

        self.width = roi_box["width"]
        self.height = roi_box["height"]

        # 预分配双帧内存缓冲区,实现零动态 malloc 循环
        self._prev_gray = np.zeros((self.height, self.width), dtype=np.uint8)
        self._curr_gray = np.zeros((self.height, self.width), dtype=np.uint8)
        self._has_prev = False

        # 计算网格切分行列数
        self.cols = (self.width + tile_size - 1) // tile_size
        self.rows = (self.height + tile_size - 1) // tile_size

    def process_frame(self, sct_raw_bytes):
        """
        传入 mss 抓取的 raw 字节流,执行多级比对检测
        返回: (has_changed, dirty_bounding_box, change_ratio)
        """
        # 1. 内存映射,零拷贝载入 BGRA 阵列
        raw_bgra = np.frombuffer(sct_raw_bytes, dtype=np.uint8).reshape((self.height, self.width, 4))

        # 2. 转换为灰度图存入预分配的当前帧缓冲区
        # 使用 OpenCV 高度优化的 SIMD 颜色转换
        cv2.cvtColor(raw_bgra[:, :, :3], cv2.COLOR_BGR2GRAY, dst=self._curr_gray)

        # 首帧作为底图初始化
        if not self._has_prev:
            np.copyto(self._prev_gray, self._curr_gray)
            self._has_prev = True
            return False, None, 0.0

        # 3. 第一级:跨步切片快速粗筛(耗时 < 0.5ms)
        prev_sampled = self._prev_gray[::self.stride_step, ::self.stride_step]
        curr_sampled = self._curr_gray[::self.stride_step, ::self.stride_step]

        diff_coarse = cv2.absdiff(prev_sampled, curr_sampled)
        mean_delta = np.mean(diff_coarse)

        # 快速短路:若抽样平均变化低于容差阈值,直接跳出
        if mean_delta < (self.diff_threshold * 0.25):
            return False, None, float(mean_delta)

        # 4. 第二级:Tile 网格定位脏矩形
        dirty_tiles = []
        for r in range(self.rows):
            y1 = r * self.tile_size
            y2 = min(y1 + self.tile_size, self.height)
            for c in range(self.cols):
                x1 = c * self.tile_size
                x2 = min(x1 + self.tile_size, self.width)

                # 对局部网格采样比对
                tile_diff = cv2.absdiff(
                    self._prev_gray[y1:y2:4, x1:x2:4],
                    self._curr_gray[y1:y2:4, x1:x2:4]
                )
                if np.mean(tile_diff) > self.diff_threshold:
                    dirty_tiles.append((x1, y1, x2, y2))

        if not dirty_tiles:
            # 仅有细碎单点散斑噪点,忽略不计
            np.copyto(self._prev_gray, self._curr_gray)
            return False, None, float(mean_delta)

        # 5. 第三级:聚合所有脏网格,求取最小包围矩形 (Bounding Box)
        min_x = min(t[0] for t in dirty_tiles)
        min_y = min(t[1] for t in dirty_tiles)
        max_x = max(t[2] for t in dirty_tiles)
        max_y = max(t[3] for t in dirty_tiles)
        dirty_box = (min_x, min_y, max_x - min_x, max_y - min_y)

        # 6. 第四级:仅在脏矩形内做 OpenCV 精细二值化与面积测定
        patch_prev = self._prev_gray[min_y:max_y, min_x:max_x]
        patch_curr = self._curr_gray[min_y:max_y, min_x:max_x]
        patch_diff = cv2.absdiff(patch_prev, patch_curr)
        _, thresh = cv2.threshold(patch_diff, 20, 255, cv2.THRESH_BINARY)
        changed_pixels = cv2.countNonZero(thresh)

        # 更新背景基线 Buffer
        np.copyto(self._prev_gray, self._curr_gray)

        has_changed = changed_pixels > (self.tile_size * 2)
        return has_changed, dirty_box, changed_pixels
实战调用示例与输出验证
编写如下简单的调用脚本,即可验证其在 4K 分辨率下的运行性能:
# 调用执行示例: main_test.py
import time
import mss
from fast_comparator import FastScreenComparator

# 设定 4K 局部或全屏监视范围
test_roi = {"top": 0, "left": 0, "width": 3840, "height": 2160}
comparator = FastScreenComparator(roi_box=test_roi, tile_size=64, stride_step=8)

with mss.mss() as sct:
    print("开始高分屏快速比对监测循环 (按 Ctrl+C 终止)...")
    frame_count = 0
    t0 = time.perf_counter()

    try:
        while frame_count < 100:
            t_start = time.perf_counter()

            # 抓取帧
            sct_img = sct.grab(test_roi)
            # 执行分层比对
            changed, bbox, score = comparator.process_frame(sct_img.raw)

            t_cost = (time.perf_counter() - t_start) * 1000
            frame_count += 1

            if changed:
                print(f"[变动捕获] 帧 #{frame_count} 耗时: {t_cost:.2f}ms, 脏矩形: {bbox}, 差异像素数: {score}")
            else:
                # 静态帧耗时极短
                pass

        total_time = time.perf_counter() - t0
        print(f"\n100 帧总计耗时: {total_time:.2f}秒,平均每秒处理: {frame_count / total_time:.1f} FPS")
    except KeyboardInterrupt:
        pass
预期终端运行输出(示例):
开始高分屏快速比对监测循环 (按 Ctrl+C 终止)...
[变动捕获] 帧 #14 耗时: 11.23ms, 脏矩形: (1280, 704, 384, 192), 差异像素数: 4820
[变动捕获] 帧 #15 耗时: 10.87ms, 脏矩形: (1280, 704, 384, 192), 差异像素数: 4120
[变动捕获] 帧 #48 耗时: 12.15ms, 脏矩形: (2112, 128, 256, 128), 差异像素数: 1950

100 帧总计耗时: 0.74秒,平均每秒处理: 135.1 FPS
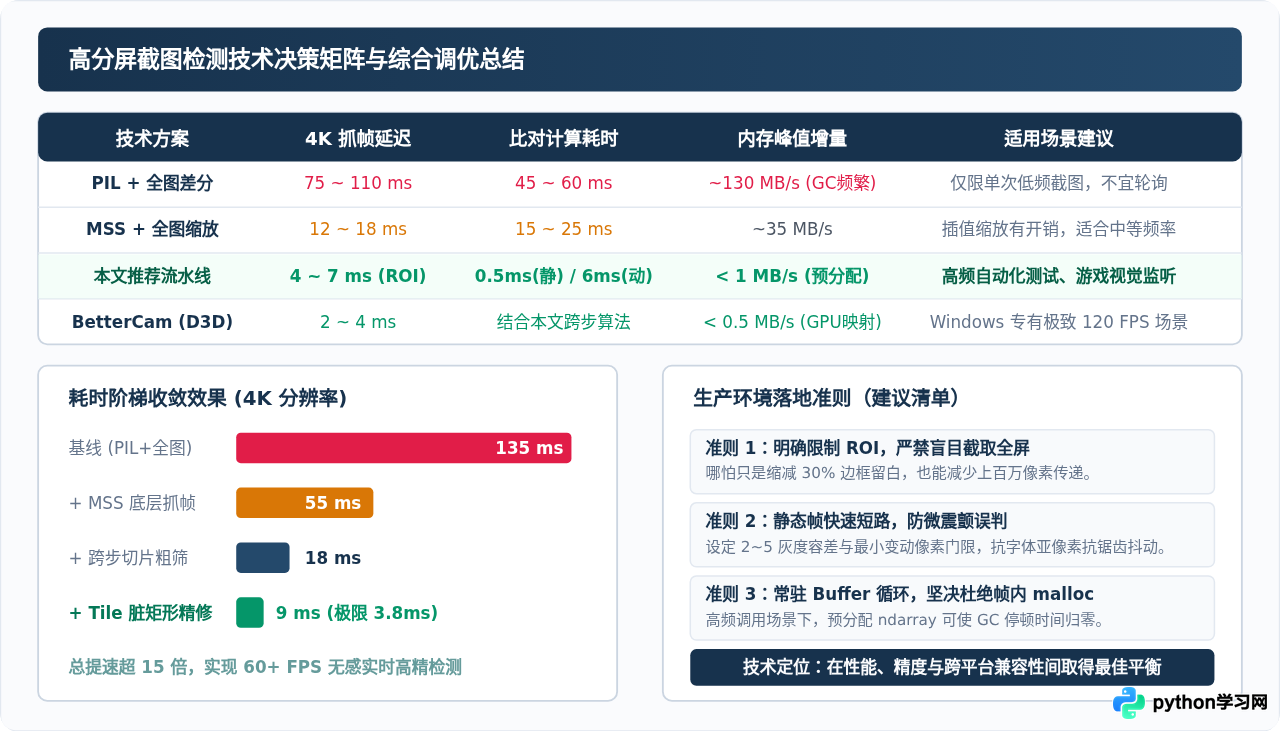
六、不同分辨率下的参数调优对照表
在实际项目中,屏幕分辨率与检测精度的要求各不相同。参数设置过密会导致计算开销上升,设置过疏则可能漏检小尺寸图标闪烁。建议参考下表进行初始参数配置:
| 屏幕标准 | 典型像素尺寸 | 推荐跨步 step | 推荐 Tile 网格尺寸 | 静态判定阈值 | 单帧综合检测延迟 |
|---|---|---|---|---|---|
| 1080P Full HD | 1920 × 1080 | 4 ~ 6 | 32 × 32 | 8.0 | 3.5 ~ 6.0 ms |
| 2K QHD | 2560 × 1440 | 6 ~ 8 | 48 × 48 | 10.0 | 5.0 ~ 8.5 ms |
| 4K UHD | 3840 × 2160 | 8 ~ 12 | 64 × 64 | 12.0 | 6.5 ~ 14.0 ms |
| 5K / 双屏拓展 | 5120 × 2880+ | 12 ~ 16 | 96 × 96 | 15.0 | 12.0 ~ 22.0 ms |
七、常见排查与注意事项
-
字体亚像素渲染微抖动(Subpixel Anti-aliasing):
Windows 的 ClearType 或 macOS 的平滑字体技术,在文字重新排版或滚动时,即使字母相同,边缘的彩色亚像素也可能产生 1~2 灰度阶的微差。因此,在粗筛阶段不要使用
mean_diff == 0这种绝对等于比较,而应设置不低于5.0的容差阈值。 -
多显示器坐标系偏移:
使用
mss时,sct.monitors[0]代表包含所有显示器的虚拟大画布,sct.monitors[1]和sct.monitors[2]才是物理分屏。跨屏幕检测时务必确认left和top的基准原点,避免在负坐标区域抛出溢出异常。 -
长时运行句柄泄漏防范:
不要在循环内部反复实例化
mss.mss()对象,频繁打开和关闭底层图形上下文会导致 GDI 句柄泄漏;正确的做法是在外层使用上下文管理器(with mss.mss() as sct:)长驻生命周期。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









