

C++转Python:怎么处理#define导致的语法错误
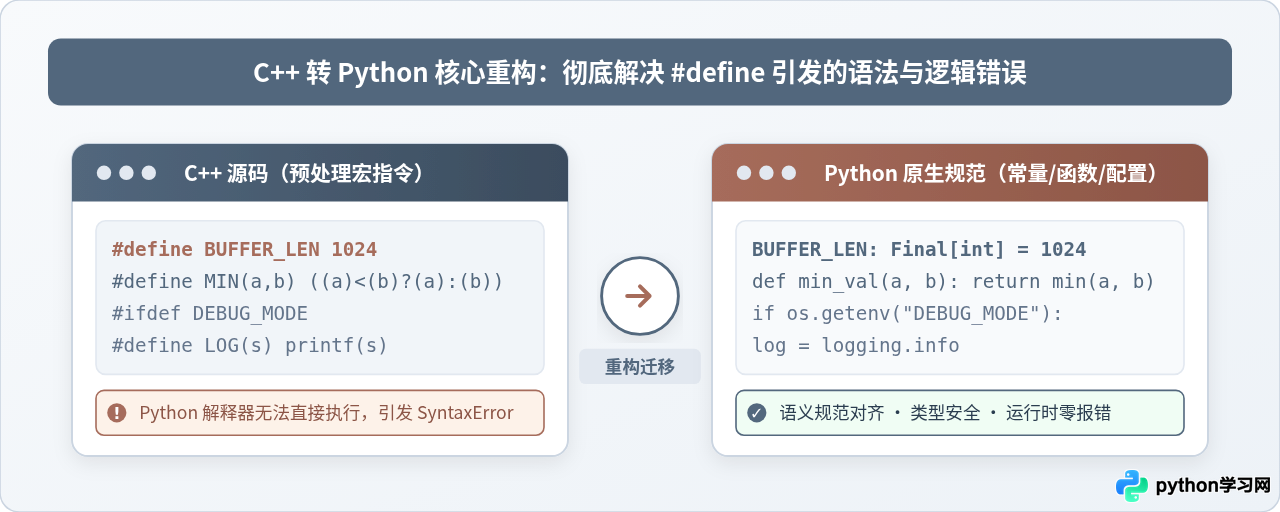
详细讲解在将C++代码迁移至Python时,如何妥善解决因#define预处理指令遗留引发的SyntaxError及相关语法错误,提供常量、函数宏、条件编译等完整重构方案与工程实践指南。
#define 是在编译前由预处理器执行纯文本替换的指令;而 Python 并没有独立的预处理器阶段。将带有 #define 的 C++ 代码直接复制到 Python 脚本中时,虽然单行 # 会被 Python 词法分析器识别为注释,但因其文本替换未发生,或多行续行符、C 语法声明外露,会导致接踵而至的 SyntaxError: invalid syntax 或 NameError。解决这个问题的根本做法不是寻找“Python 预处理插件”,而是将 #define 依据其承担的工程职责,规范转换为 Python 原生机制:模块级常量(typing.Final)、原生函数(def)、枚举类型(Enum)、类型别名(TypeAlias)以及基于运行时环境的显式分支逻辑。
一、错误根源剖析:为什么 #define 会引发 Python 语法错误
在进行 C++ 到 Python 的移植过程中,许多开发者最常遇到的困扰之一,就是顺手把 C++ 头文件中的宏定义或者带宏的代码片段直接贴入 .py 文件。此时执行脚本,控制台往往会立刻抛出如下错误:
SyntaxError: invalid syntax或者在某些情况下,代码能够通过词法解析,却在紧接着的第一条业务逻辑处抛出:
NameError: name 'BUFFER_SIZE' is not defined
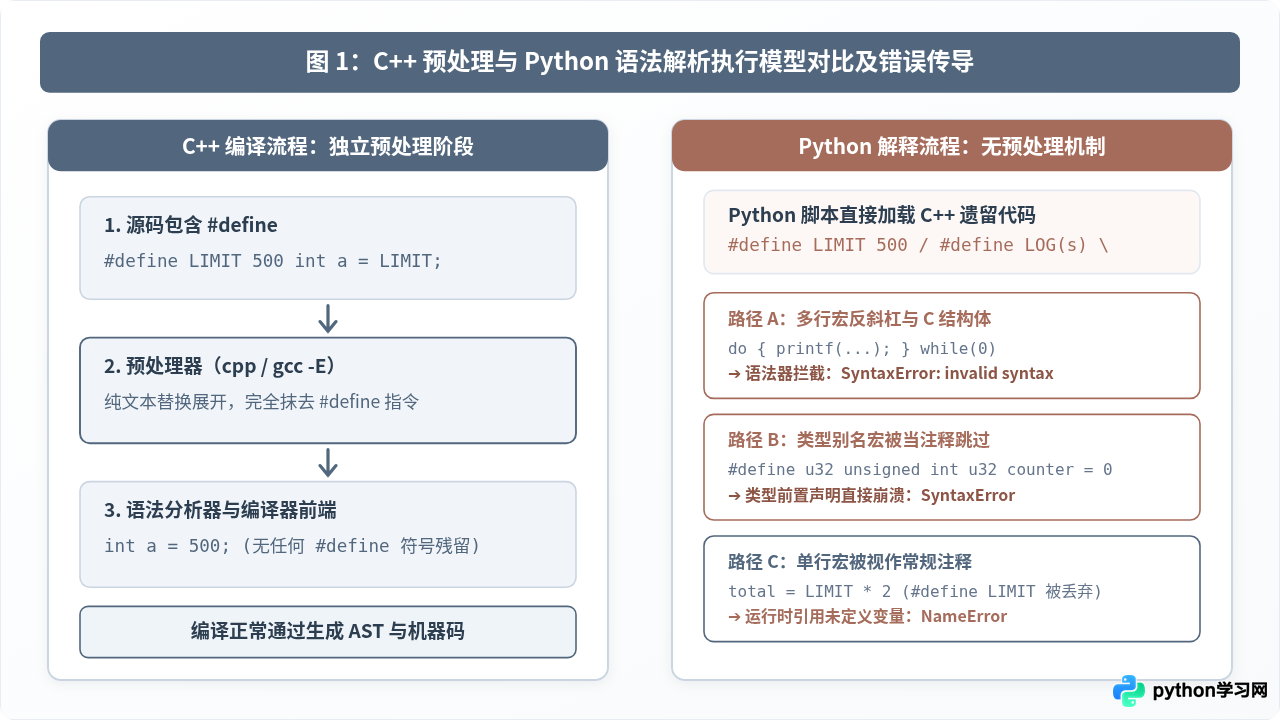
产生这种现象的根本原因,在于两种语言在执行管道(Execution Pipeline)模型上的本质差异。C++ 编译体系是一个严格的分阶段流程:源码首先送入预处理器(cpp),预处理器会查找所有以 # 开头的指令,完成头文件展开、条件编译分支裁剪以及宏标识符的无条件文本替换。当真正的编译器前端开始构建抽象语法树(AST)时,代码中已经不存在任何 #define 字符。
与之截然不同的是,Python 解释器是一个直接面向 AST 解析并生成字节码的系统。Python 语法规范中,# 是单行注释的唯一起始标记。表面上看,以 #define 开头的单行代码似乎只会被当作一行普通注释忽略,那为什么还会报错呢?主要由以下三种传导链条引发:
-
多行宏反斜杠续行导致 C 语法裸露:C++ 宏常用反斜杠
\实现多行定义。在 Python 中,当注释行以反斜杠结尾时,某些版本或换行解析会将反斜杠后的下一行代码视为同一逻辑行的延续或截断,紧接着的 C 语法结构(例如结构体花括号{ ... }、类型强转、分号或do { ... } while(0))暴露在 Python 词法解析器面前,直接触发SyntaxError。 -
类型别名宏与静态声明冲突:例如 C++ 中定义了
#define uint32 unsigned int,后面出现uint32 counter = 0;。在 Python 看来,前一行变成了无用的注释,而后一行uint32 counter = 0这种“类型标识符紧跟变量名”的结构完全不符合 Python 的赋值语法,解释器在扫描到counter时便会因语法非法而中断。 -
符号缺失引发运行时崩溃:即使
#define BUFFER_SIZE 1024单独成行被当作注释跳过,后续的data = [0] * BUFFER_SIZE就会因为全局命名空间中根本不存在BUFFER_SIZE这个变量而立刻抛出NameError。
##)和内联宏嵌套,用字符串替换极易引入幽灵般的命名覆盖和更难排查的逻辑死锁。
二、分类重构:从 C++ 宏到 Python 原生特性的迁移路径
由于 Python 不存在预处理器,消除这些错误的唯一正确路径,就是辨别 C++ 代码中每一个 #define 具体承担了什么工程角色,并将其逐一替换为 Python 官方推崇的原生语法。
1. 对象式常量宏:转换为模块级常量与 typing.Final
在 C++ 中,最常见的宏就是数值和字符串常量:
// C++ 头文件中的宏定义
#define MAX_CONNECTIONS 1024
#define SERVER_BANNER "GATEWAY-V1.0"
#define DEFAULT_TIMEOUT_MS 5000
在 Python 中,应在专用的常量文件或当前模块顶部,将其声明为全大写变量。如果希望利用静态类型检查器(如 Mypy)防止后续代码误修改该常量,可以使用 typing.Final 进行约束:
# Python 等价重构:constants.py
from typing import Final

MAX_CONNECTIONS: Final[int] = 1024
SERVER_BANNER: Final[str] = "GATEWAY-V1.0"
DEFAULT_TIMEOUT_MS: Final[int] = 5000
如果这一批宏属于同一类状态码或枚举集合,推荐使用 enum.IntEnum 或 enum.Enum:
from enum import IntEnum

class HttpStatus(IntEnum):
    OK = 200
    NOT_FOUND = 404
    SERVER_ERROR = 500
2. 带参计算宏:转换为标准 def 函数
C++ 程序员常利用带参宏来避免函数调用开销或实现简易多态,例如:
// C++ 函数式宏
#define CLAMP(x, low, high) (((x) < (low)) ? (low) : (((x) > (high)) ? (high) : (x)))
#define SQUARE(x) ((x) * (x))
在 Python 中,宏的直接拷贝会使调用方引发 NameError,或者因嵌套的三元运算符在宏展开时引入括号歧义。正确的做法是将其改写为 Python 的标准函数,并附带类型提示与文档说明:
# Python 等价重构:使用原生函数
from typing import TypeVar

T = TypeVar("T", int, float)

def clamp(val: T, low: T, high: T) -> T:
    '''限制输入值在 [low, high] 区间内。'''
    if val < low:
        return low
    if val > high:
        return high
    return val

def square(x: float) -> float:
    '''计算数值的平方。'''
    return x * x
不要贪图简便使用 lambda 来模拟所有宏,因为 lambda 缺乏清晰的函数签名,在报错时难以在堆栈跟踪(Traceback)中呈现明确的函数名。
3. 类型别名宏:转换为 TypeAlias 或类继承
C++ 遗留项目中经常存在类似 #define u64 unsigned long long 或 #define Handle void* 的写法。在 Python 中不需要声明变量类型,但如果为了维护大型工程的静态检查严谨性,可以使用 typing.TypeAlias 或 NewType:
# Python 等价重构
from typing import TypeAlias, NewType

# 纯别名定义(静态检查阶段与 int 等价)
U64: TypeAlias = int

# 强类型标识符(确保不会将普通 int 误传给 Handle)
Handle = NewType("Handle", int)
4. 条件编译分支:转换为运行时环境分发
C++ 中常使用条件编译来区分操作系统或调试模式:
// C++ 条件编译
#ifdef _WIN32
    #define PATH_SEP '\\'
#else
    #define PATH_SEP '/'
#endif
如果直接把上面的代码保留在 Python 里,#ifdef 和 #else 都会被当成普通注释,导致无论在什么平台上,下方的赋值都会按顺序依次执行,后者永远覆盖前者。在 Python 中,这必须用 sys.platform 或 os 模块进行真正的运行时判断:
import sys
import os

# Python 原生跨平台判断
if sys.platform == "win32":
    PATH_SEP = "\\"
else:
    PATH_SEP = "/"

# 或者优先利用标准库现有属性
PATH_SEP = os.sep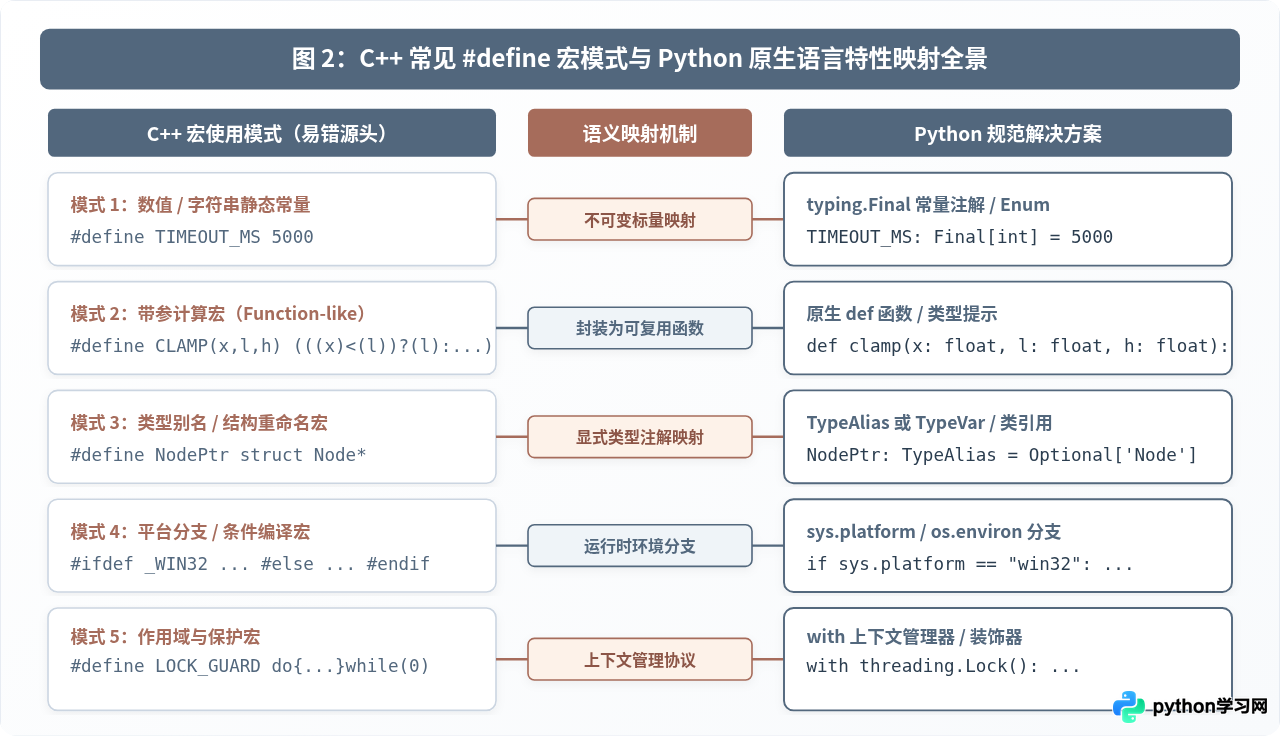
三、实操五步法:系统排查与彻底消除 #define 错误
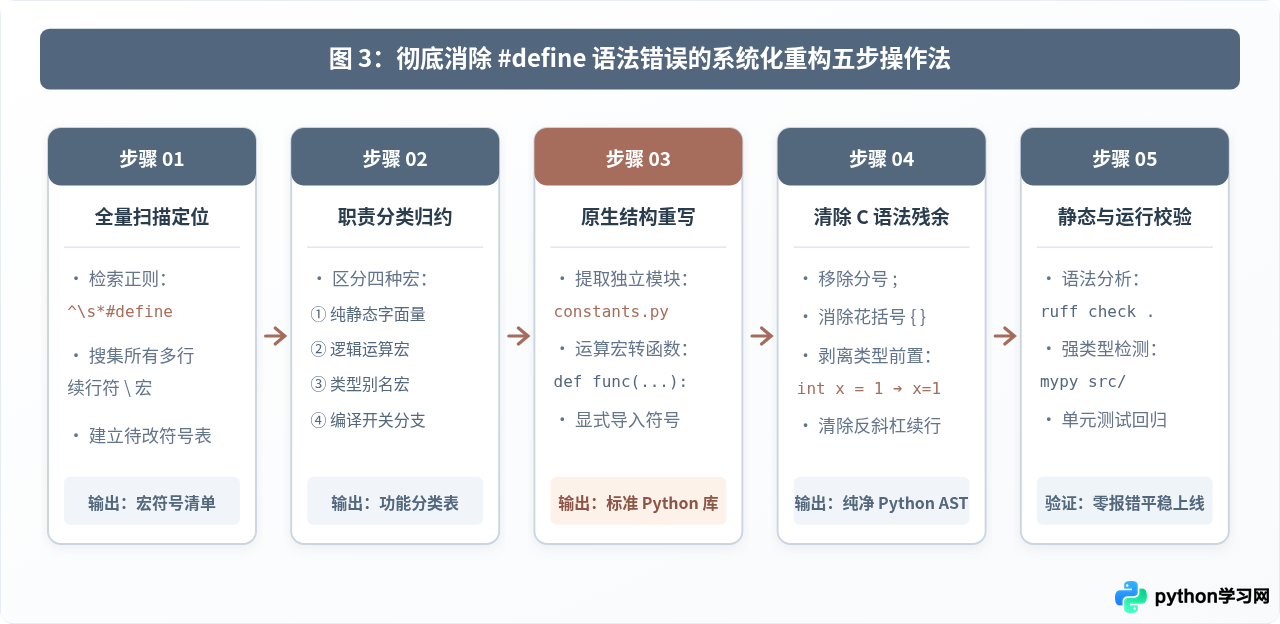
当面对数千行从 C++ 转译而来的代码库时,逐行人工排查极易遗漏。建议按照以下五个标准化步骤展开重构:
-
第一步:静态正则全量扫描
使用终端工具快速定位所有潜在的预处理指令位置:
特别留意行末带# 检索项目中所有遗留的宏指令 grep -En "^\s*#(define|ifdef|ifndef|endif|else|pragma)" **/*.py\的多行宏定义,将这些位置记录为重点清理目标。 -
第二步:建立符号职责映射表
将搜集到的宏划分为四类:配置字面量、内联算法函数、系统平台开关、以及纯语法包装(如do {} while(0))。 -
第三步:抽离集中式 constants.py 模块
在模块包根目录下建立constants.py,统一存放常量;在相关业务代码顶部通过显式导入引用,如from .constants import MAX_SIZE。 -
第四步:剥离 C 语法附属物
在宏替换完成后,彻底清除行末的分号;、类型声明(如int a = 10;改为a = 10)以及多余的花括号。 -
第五步:静态分析器与测试回归
运行现代 Python 代码检查工具确保语法树合法且不存在悬空引用:# 运行 ruff 极速校验语法与未定义名称 ruff check . # 运行 mypy 检查类型一致性 mypy .
四、常见边界情况与工程避坑指南
在深入重构时,还有几类特殊的 #define 衍生场景需要格外警惕:
1. CFFI / ctypes 绑定时的头文件陷阱
许多团队在 Python 中通过 cffi.FFI().cdef(...) 直接导入 C++ 头文件。需要注意的是,cdef 仅仅支持纯 C 声明,并不支持完整的 C 预处理器功能。如果头文件中包含复杂的宏计算、函数宏或带参宏,ffi.cdef() 会直接抛出语法解析错误 cffi.error.CDefError。
解决办法:在调用 cdef 之前,利用系统的预处理器先将头文件进行宏展开,或者仅将去除宏后的纯结构体与函数原型传递给 cdef:
# 自动化生成已展开宏的纯声明头文件
gcc -E -P clean_header.h -o expanded_header.h
2. 宏中的字符化操作符(#)与连接符(##)
C++ 宏中的 #var 会把参数转换为字符串,而 a ## b 会把两个词元拼接为一个新符号。在 Python 中切勿试图通过宏的方式实现,直接使用 f-string 和内置的 getattr 反射机制:
# C++ 宏拼接:#define GET_MODULE(name) mod_##name
# Python 等价实现:
import importlib

def get_module_attr(target_obj, name: str):
    attr_name = f"mod_{name}"
    return getattr(target_obj, attr_name)
五、总结与迁移速查对照表
处理 #define 语法错误的核心,在于认识到 Python 的“显式优于隐式(Explicit is better than implicit)”哲学。下表归纳了常见场景的快速转换方案:
| C++ #define 宏形态 | Python 规范实现机制 | 常见诱发报错 | 关键注意事项 |
|---|---|---|---|
#define PI 3.14159 |
PI: Final[float] = 3.14159 |
NameError(被当作注释略过) |
推荐集中存放在 constants.py 中 |
#define MIN(a, b) ((a)<(b)?(a):(b)) |
def min_val(a, b): return min(a, b) |
SyntaxError / NameError |
避免使用 lambda 模拟复杂多行宏 |
#define u8 unsigned char |
U8: TypeAlias = int |
SyntaxError: invalid syntax |
清理后续代码中的前置类型声明 |
#ifdef DEBUG ... #endif |
if os.getenv("DEBUG"): ... |
逻辑双分支全部执行、状态污染 | 必须转换为真实的 Python 运行时条件判断 |
#define LOCK() do{...}while(0) |
with contextlib.contextmanager |
SyntaxError(C 块语法裸露) |
改写为标准的 Python 上下文管理器 |
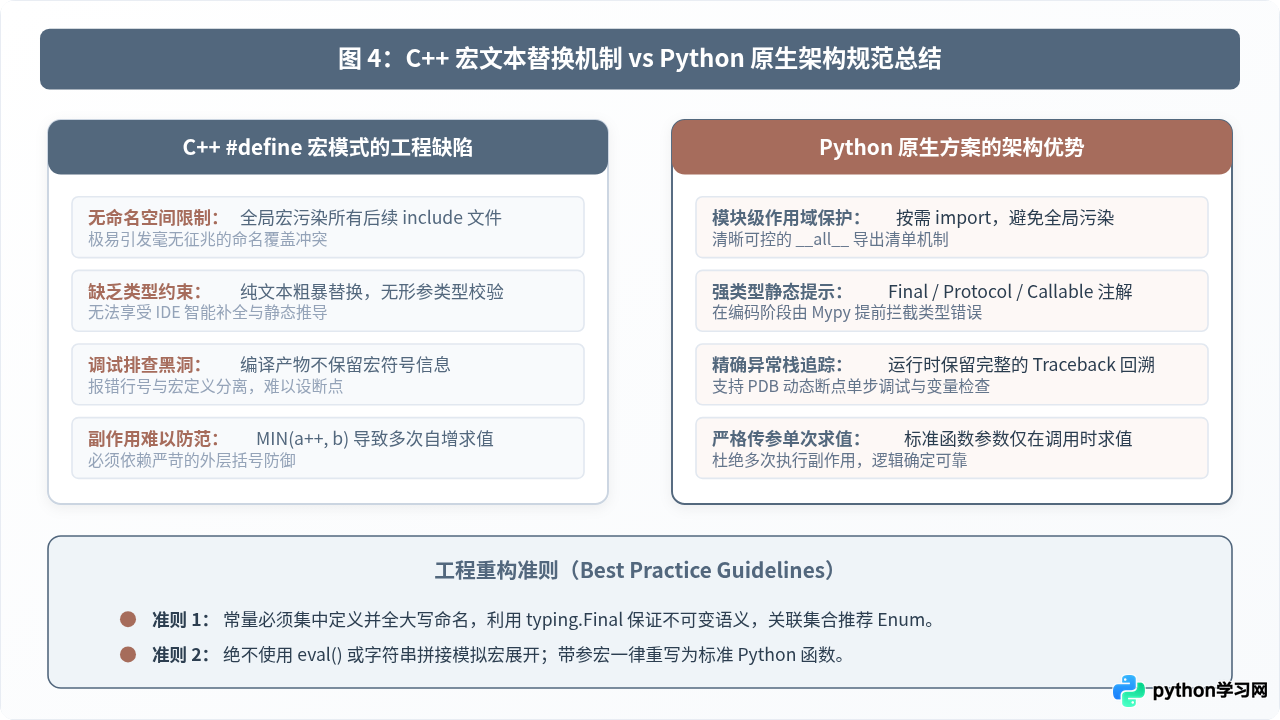
只要掌握了 C++ 预处理器与 Python AST 解析器的本质差异,在代码迁移时严格执行“职责识别—原生替换—语法清理—静态验证”的闭环,就能从根本上杜绝 #define 引发的一切语法错误与隐式运行时缺陷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









