

Python list与array模块数组获取长度的区别
深入解析Python中list与array模块获取长度的区别。对比二者在语法层面的统一性、CPython底层的ob_size读取机制、物理内存中的指针与紧凑缓冲区差异,以及缓冲区协议与切片长度交互。
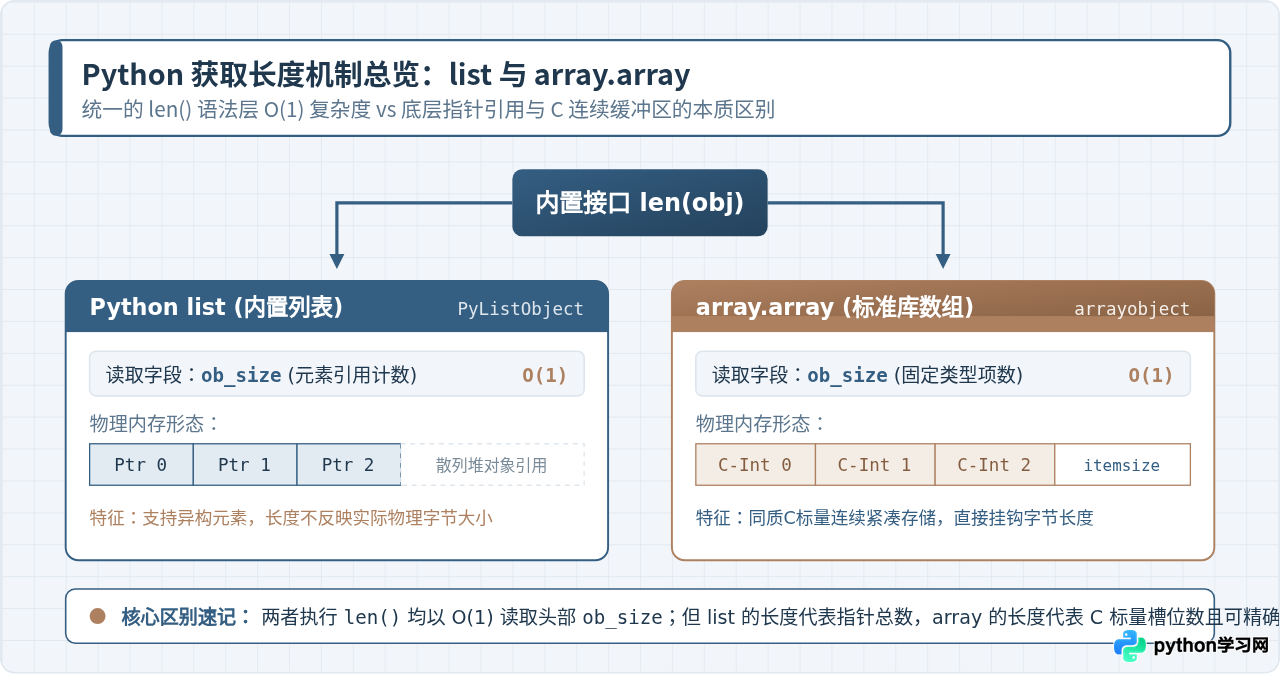
list 还是标准库 array 模块中的数组对象,获取当前元素个数均使用相同的内置函数 len(),且两者的执行时间复杂度均为 O(1) 常数时间。然而,二者在底层内存结构和长度语义上存在根本分歧:list 维护的是对象指针引用的计数,各元素以离散堆对象形式存在;而 array.array 记录的是紧凑连续 C 标量槽位的计数,能结合 itemsize 瞬时推导物理字节长度,并原生支持高效的零拷贝缓冲区协议(Buffer Protocol)。
一、获取长度的语法与基础操作对比
在实际编程中,针对 list 与 array.array,开发者均通过内建函数 len() 或对象的特殊方法 __len__() 来读取长度。由于 Python 的协议化设计,两者的调用形式与返回结果完全一致。
以下代码演示了创建包含相同整数序列的两个容器并分别获取其长度的操作:
import array

# 1. 实例化 Python 内置列表
num_list = [10, 20, 30, 40, 50]

# 2. 实例化 array 数组(指定 'i' 类型码,对应 C 语言有符号整型)
num_array = array.array('i', [10, 20, 30, 40, 50])

# 3. 获取并打印两者长度
print(f"List 元素长度: {len(num_list)}")
print(f"Array 元素长度: {len(num_array)}")

# 4. 通过魔法方法验证底层协议一致性
print(f"List __len__(): {num_list.__len__()}")
print(f"Array __len__(): {num_array.__len__()}")
Array 元素长度: 5
List __len__(): 5
Array __len__(): 5
从执行表现来看,两个容器在获取长度这一操作上没有语法门槛。两者均保证了 O(1) 的时间复杂度,这表明无论列表中包含 5 个元素还是 5,000,000 个元素,调用 len() 均可在纳秒级内完成,无需遍历任何内部节点。
二、底层原理:CPython 中长度获取的实现机制
为了探究为什么两者能够实现完全一致的 O(1) 查询性能,需要观察 CPython 源码中的对象定义。
在 CPython 实现中,list 对应的 C 结构体是 PyListObject,而 array.array 对应的 C 结构体是 arrayobject。两者都继承自变长对象头宏 PyObject_VAR_HEAD,该宏的核心定义中包含了一个有符号整数字段 Py_ssize_t ob_size。
- 常数时间读取: 当在 Python 中调用
len(x)时,解释器会调用 C-API 中的PyObject_Size(),继而分派到类型的序列方法槽type->tp_as_sequence->sq_length。该函数仅执行一次结构体字段读取:直接返回((PyVarObject*)x)->ob_size。 - 动态更新代价: 无论是通过
append()添加元素,还是通过pop()移除元素,解释器在执行内存插入或删除的同时,会同步对ob_size执行+1或-1。因此长度信息是“时刻就绪”的元数据,而非动态计算得出的结果。
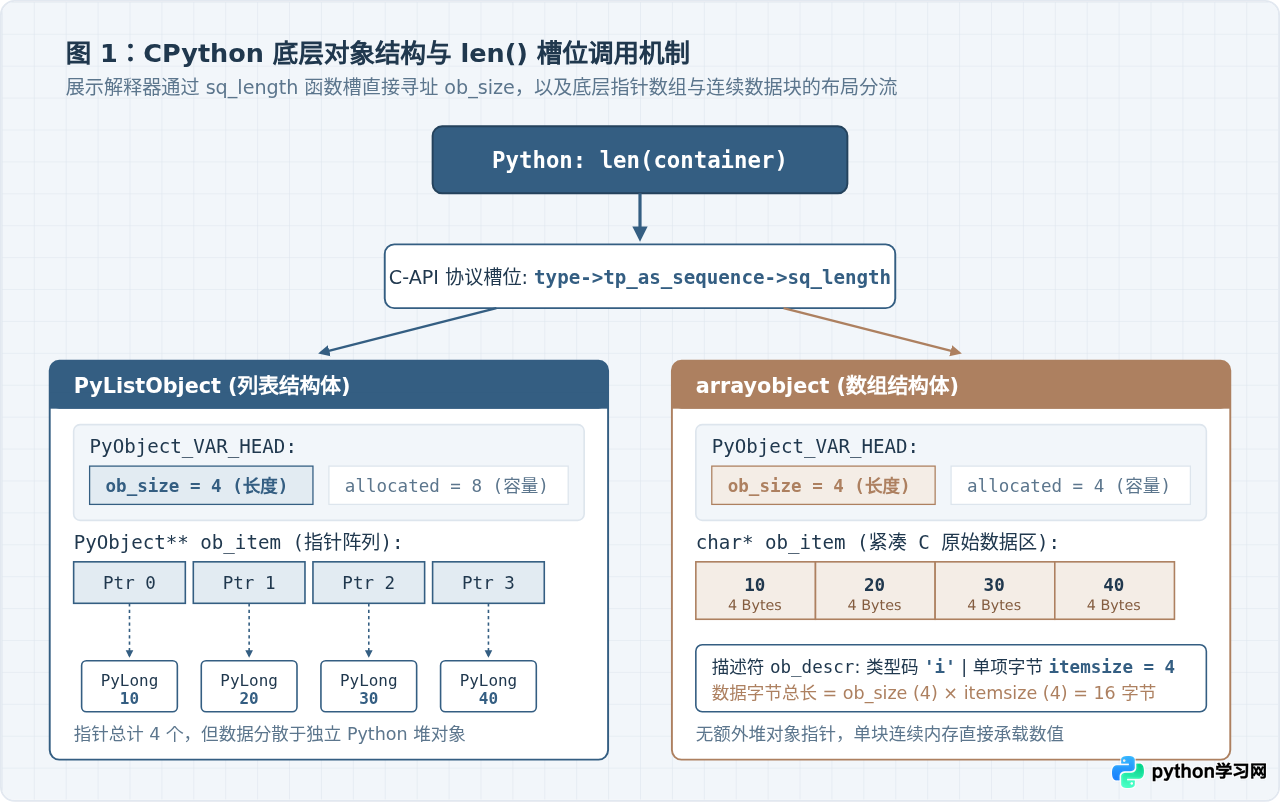
如上图所示,虽然获取 ob_size 的步骤完全相同,但二者的内部存储机制发生了分流:
PyListObject 内部维护的是二级指针 PyObject** ob_item。它指向一个由对象指针构成的数组,每个指针再指向独立的 Python 堆对象(如 PyLongObject)。因此,list 中的 ob_size 记录的本质是引用的指针个数。
arrayobject 内部维护的则是一级原始字节指针 char* ob_item,指向一块紧凑分配的连续 C 内存。其 ob_size 记录的是按照指定类型码排布的 C 基础数据项总数。
三、内存物理布局对长度语义的深层差异
物理存储形态的差异直接赋予了两者在“长度”语义上的不同衍生价值。在工程实践中,仅知道元素个数通常不足以评估系统的物理承载能力。
1. 物理字节长度的推导效率
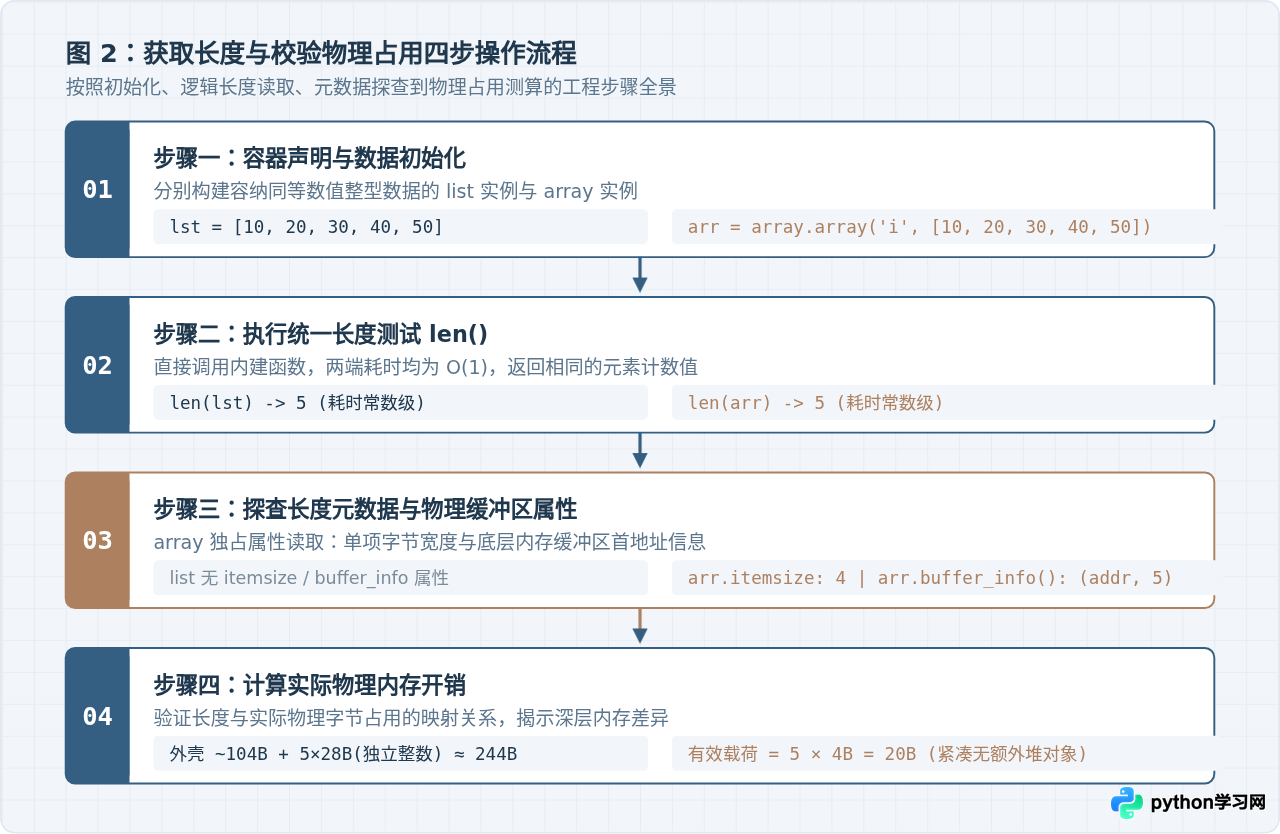
对于 array.array,由于其元素类型固定,标准库提供了 itemsize 属性(单个数据项占用的字节数)以及 buffer_info() 方法(返回包含内存基地址和项数的元组)。
开发者可以通过一个极简公式精确求得有效载荷所占用的连续字节总长度:
payload_bytes = len(arr) * arr.itemsize
反观 list,其不具备 itemsize 属性,也不提供 buffer_info() 接口。由于 list 支持异构数据(同一个列表中可以同时容纳字符串、整数和浮点数),不同元素自身占用的字节各不相同。若想精确评估列表的总物理开销,必须使用递归遍历结合 sys.getsizeof() 逐一求和。
2. 物理开销验证代码
通过以下示例可以直观比对长度与实际内存开销的脱节现象:
import array
import sys

# 分别初始化包含 100,000 个相同整型的容器
count = 100_000
test_list = [i for i in range(count)]
test_array = array.array('i', range(count))

# 逻辑长度完全一致
print(f"List 元素长度: {len(test_list)}")
print(f"Array 元素长度: {len(test_array)}")

# 物理占用核算
list_shell_size = sys.getsizeof(test_list)
array_total_size = sys.getsizeof(test_array)
array_buffer_address, array_length = test_array.buffer_info()
array_payload_bytes = len(test_array) * test_array.itemsize

print(f"Array 单元素字节数: {test_array.itemsize} 字节")
print(f"Array buffer_info() 长度: {array_length} (首地址: {hex(array_buffer_address)})")
print(f"Array 计算出的有效数据字节长: {array_payload_bytes} 字节")
print(f"Array 整体 sys.getsizeof(): {array_total_size} 字节")
print(f"List 外壳指针阵列 sys.getsizeof(): {list_shell_size} 字节")
print(f"List 包含元素的预估总内存: ~{list_shell_size + count * 28} 字节 (每个整型对象约28字节)")
Array 元素长度: 100000
Array 单元素字节数: 4 字节
Array buffer_info() 长度: 100000 (首地址: 0x105a30000)
Array 计算出的有效数据字节长: 400000 字节
Array 整体 sys.getsizeof(): 400064 字节
List 外壳指针阵列 sys.getsizeof(): 800984 字节
List 包含元素的预估总内存: ~3600984 字节 (每个整型对象约28字节)
len() 返回值相同,但 array 的实际占用约为 400KB,而 list 的整体开销高达 3.6MB(相差近 9 倍)。因此在进行大数据容量评估时,切勿将 len() 的数量等同于内存占用规模。
四、缓冲区协议与切片中的长度交互
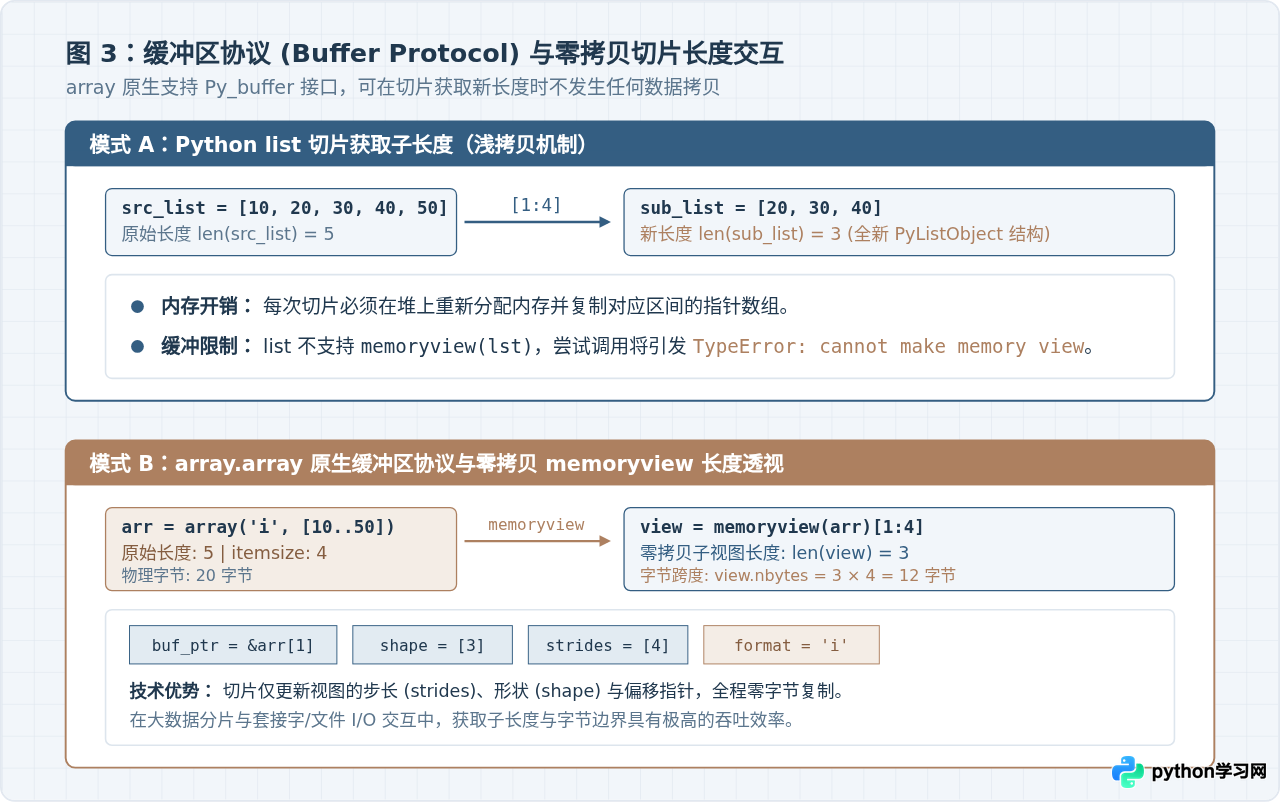
当需要对容器进行切片(Slicing)并获取子区间长度时,两者的底层行为呈现出截然不同的性能表现。
1. list 切片的拷贝代价
当对列表执行切片操作 sub_list = num_list[1:4] 时,CPython 会在堆中开辟一块全新的 PyListObject 空间,并将对应区间的元素指针复制过去。虽然 len(sub_list) 能迅速返回 3,但这一过程伴随着内存分配与引用复制,其时间与空间复杂度均为 O(k)(k 为切片长度)。
2. array 与 memoryview 的零拷贝长度穿透
array.array 实现了标准的 CPython 缓冲区协议(Buffer Protocol)。这意味着它无需任何序列化步骤即可被 memoryview 直接包装:
import array

raw_arr = array.array('i', [10, 20, 30, 40, 50])
# 构建内存视图
mv = memoryview(raw_arr)

# 获取完整视图长度
print(f"memoryview 长度: {len(mv)}")        # 5
print(f"memoryview 字节总长: {mv.nbytes}")     # 20

# 零拷贝切片
sub_mv = mv[1:4]
print(f"子切片视图长度: {len(sub_mv)}")       # 3
print(f"子切片字节长: {sub_mv.nbytes}")        # 12
在创建 sub_mv 时,系统不发生任何底层数据字节的拷贝。memoryview 仅在其 C 结构体中记录了视图的步长(strides)、形状(shape)与偏移基地址。子切片的长度计算 len(sub_mv) 完全是基于形状元数据的瞬时计算。
如果尝试对列表执行 memoryview(num_list),解释器将立即抛出 TypeError: cannot make memory view because object does not have the buffer interface 异常。这一差异决定了在网络 I/O、二进制文件解析等场景中,基于 array 的子长度划分比 list 具备显著的性能优势。
五、选型建议与常见陷阱
在系统架构与日常开发中,正确理解 list 与 array 的长度差异有助于避免常见的内存误判和选型失误。
1. 常见开发误区
-
误区一:混淆逻辑长度与扩容预留容量。
无论是list还是array,当频繁使用append()时,底层都会采用超额分配(Over-allocation)策略以平摊插入开销。此时对象的物理容量(allocated)通常大于len()返回的有效长度(ob_size)。开发者通过len()仅能获知当前逻辑元素数量,无法直接获知预留空间。 -
误区二:误认为 array 的单元素类型转换是静默的。
list可以随时添加任意类型的元素,而array在追加元素时会强制执行 C 类型的范围检验。如果类型不匹配(例如将字符串追加至'i'数组中),会在插入阶段立刻抛出TypeError。因此array的len()始终保证所有计数的元素都是符合强类型规范的。
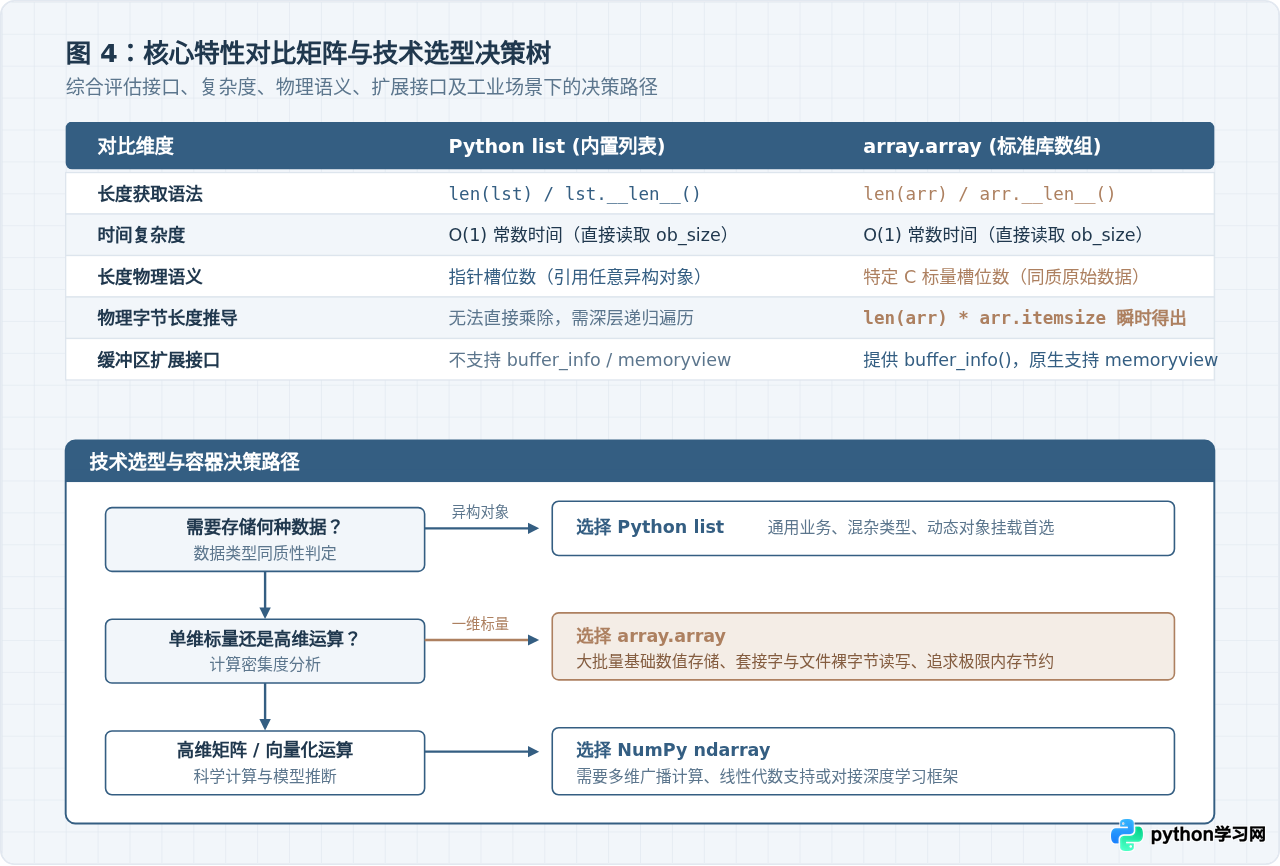
2. 场景化选型指南
| 业务场景与技术需求 | 推荐容器 | 核心决策依据 |
|---|---|---|
| 通用业务开发、混杂数据存储、频繁动态结构变更 | Python list | 语法简单、原生支持异构对象、无需预设类型码。 |
| 百万级同构基础数值存储、追求低内存占用 | array.array | 内存布局平坦紧凑,无指针额外开销,直接挂钩字节长度。 |
| 二进制文件编解码、套接字(Socket)通信、零拷贝切片分发 | array.array | 原生支持缓冲区协议,配合 memoryview 实现零拷贝长度截取。 |
| 高维张量运算、向量化数学计算、数据分析与算法模型 | NumPy ndarray | 提供多维广播能力与丰富的线性代数底层加速库支持。 |
总结而言,list 与 array.array 获取长度在表层接口上具有高度的统一性——均通过 len() 在 O(1) 常数时间内完成读取。但在系统工程层面,list 的长度代表指针引用的聚集,而 array 的长度则代表规整 C 内存槽位的度量。充分理解这一物理实质,能够帮助开发者在面对高并发、海量数据与底层 I/O 任务时,做出更加高效、精准的技术选型。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









