

Python嵌套列表怎么取深层数据?多级索引与遍历方法
全面解析Python嵌套列表中深层数据的提取方案,包括链式多级索引底层逻辑、IndexError防御机制、固定层级推导式与任意深度递归与栈遍历方法。
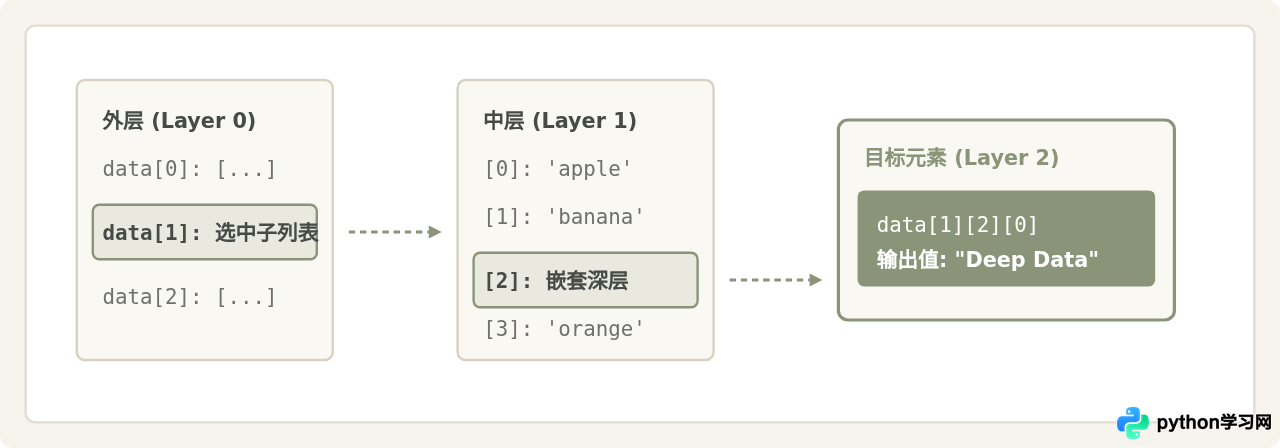
在 Python 中提取嵌套列表深层数据,核心只有两条路径:层级结构固定已知时,使用多级方括号链式索引(如 data[i][j][k])或嵌套推导式;层级不规则或深度未知时,采用递归生成器或显式栈进行遍历提取。本文将系统梳理链式索引的执行机制、常见语法误区与边界防护,并提供完整的遍历方案与选型标准。
一、多级链式索引的底层寻址原理
Python 中的嵌套列表本质上是“包含列表引用的列表”。对于多维或多层数据,Python 并没有专门的二维或三维矩阵原生类型,而是通过外层列表存储子列表的内存地址来实现层级嵌套。
当读取 matrix[1][2] 时,Python 解释器并不是一次性定位到坐标 (1, 2),而是按照从左向右的顺序,将其分解为两次连续的操作:先计算 matrix[1] 得到内层列表的引用,再对该内层列表求值 [2] 取得具体数据。
# 示例:三层嵌套列表
data = [
    ["A", ["B1", "B2"]],
    ["C", ["Target", "D"], "E"]
]

# 逐步取值过程分解
step1 = data[1]          # 取得第二项: ['C', ['Target', 'D'], 'E']
step2 = step1[1]         # 取得内层子列表: ['Target', 'D']
result = step2[0]        # 取得深层数据: 'Target'

# 等价于单行链式多级索引
target = data[1][1][0]
print(target)  # 输出示例: Target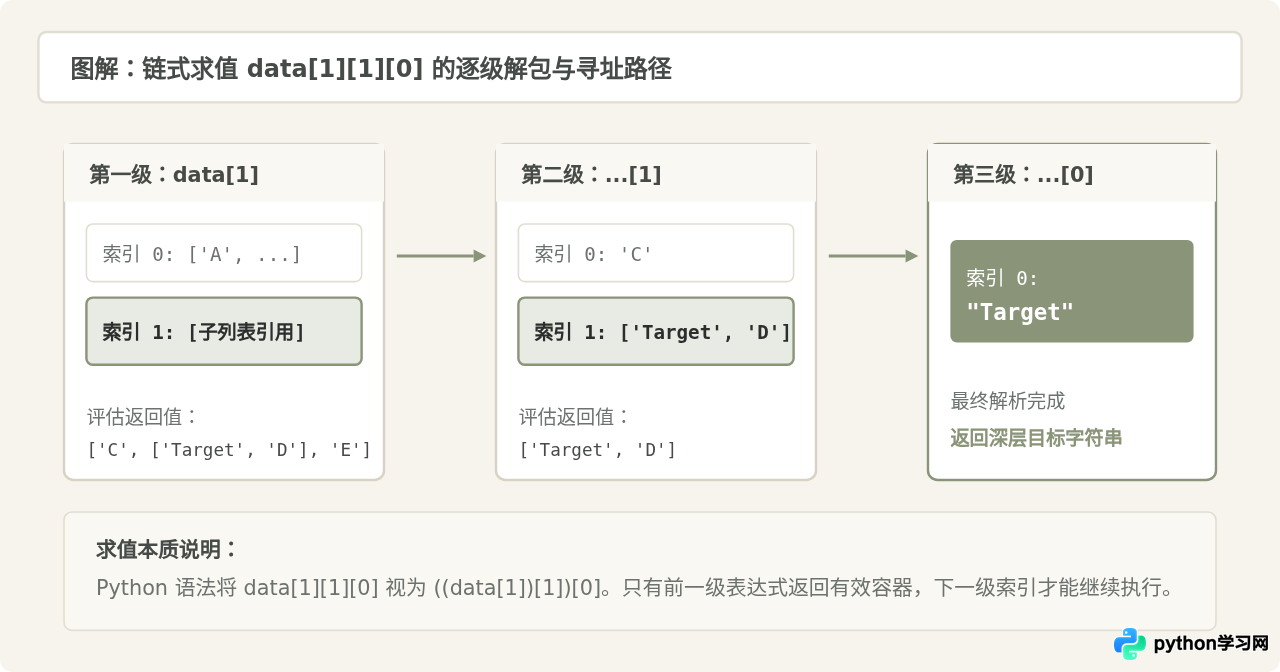
二、典型语法误区与边界安全防御
在实际编写多级索引时,初学者最常遇到的两类问题是:将其它库(如 NumPy)的索引语法误套用在原生列表上,以及因列表长度不足触发 IndexError 崩溃。
1. 混淆单方括号与元组索引
在使用 NumPy 等第三方科学计算库时,二维数组可以使用类似 arr[1, 2] 的写法。但在 Python 原生列表中执行 matrix[1, 2] 会直接抛出异常:
matrix = [[1, 2], [3, 4]]

# 错误写法:
# val = matrix[1, 0]
# 报 TypeError: list indices must be integers or slices, not tuple

# 正确写法:连续方括号
val = matrix[1][0]  # 结果为 3
原因在于方括号内使用逗号时,Python 解释器会先将其打包为一个元组 (1, 0)。原生列表的 __getitem__ 方法仅接收整数(int)或切片(slice),传入元组便会抛出类型错误。
2. 多级安全提取函数封装
当嵌套列表来自网络请求或动态解析时,各子列表的长度通常不一致。若直接盲目索引深层元素,只要任何一级下标越界,程序就会立即中断。针对已知路径但结构可能缺失的情况,可以封装一个通用的安全提取函数:
def safe_deep_get(lst, *indices, default=None):
    """安全提取多级列表深层数据,若越界或类型不匹配则返回默认值"""
    current = lst
    for idx in indices:
        try:
            if not isinstance(current, (list, tuple)):
                return default
            current = current[idx]
        except IndexError:
            return default
    return current

# 测试场景
raw_data = [[10, 20], [30]]

# 正常获取: 对应 raw_data[0][1]
print(safe_deep_get(raw_data, 0, 1))          # 输出: 20

# 越界保护: raw_data[1] 仅有 1 个元素,请求索引 1 触发保护
print(safe_deep_get(raw_data, 1, 1, default=-1)) # 输出: -1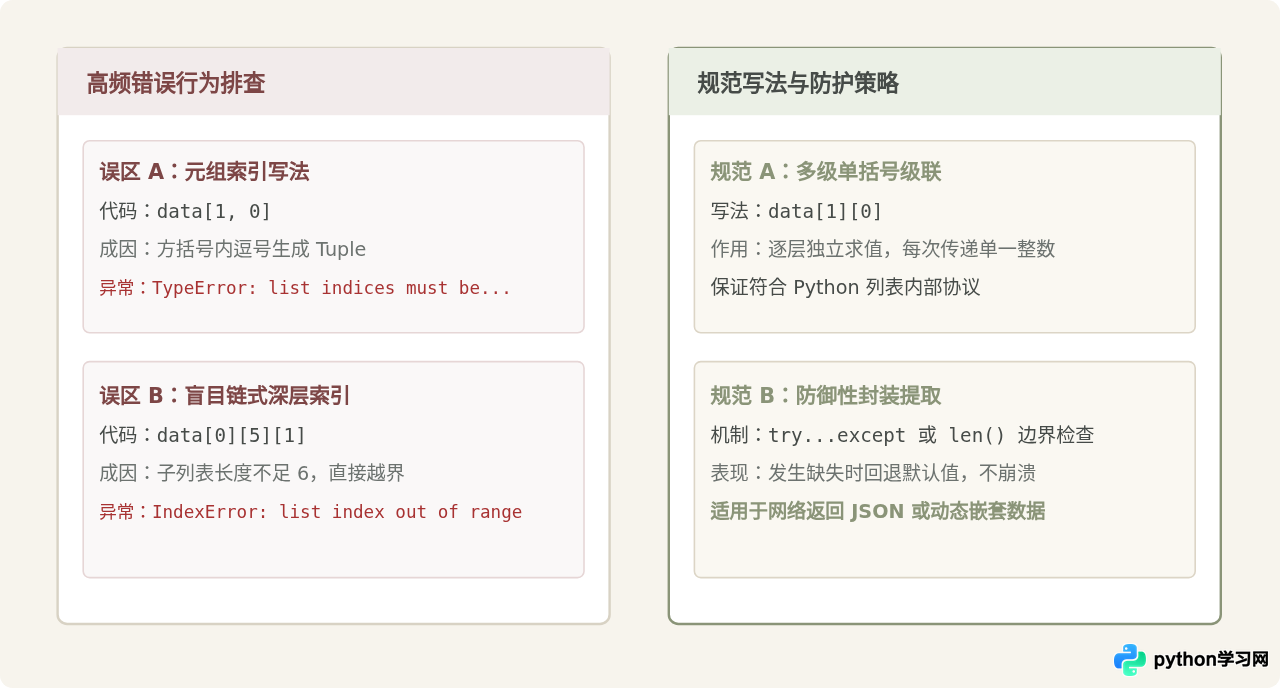
三、固定层级列表的遍历与批量提取
当数据结构具有明确的固定深度(例如规则的二维矩阵、或者层数确定的三维结构),通常需要遍历所有叶子元素。常见方式包括多层嵌套 for 循环与列表推导式。
1. 嵌套循环提取特定列或全部平铺
假设有一个二维列表,若要提取每一行的深层特定索引(例如提取第二列所有值),通过单层循环配合深层索引即可:
matrix = [
    ["ID01", "Alice", 95],
    ["ID02", "Bob",   88],
    ["ID03", "Charlie", 92]
]

# 提取第 2 列数据(姓名)
names = [row[1] for row in matrix]
print(names)  # 输出: ['Alice', 'Bob', 'Charlie']
2. 多层列表推导式的执行顺序
若需要将二维矩阵展开为一维列表,推导式的循环语句书写顺序极易让人困惑。编写推导式时,循环顺序必须与常规多层 for 循环嵌套的先后次序保持一致:
# 展开二维列表的所有元素
flattened = [val for row in matrix for val in row]

# 其逻辑等价于:
# flattened = []
# for row in matrix:      # 外层循环在前
#     for val in row:     # 内层循环在后
#         flattened.append(val)
注意:当嵌套层级超过 3 层时,列表推导式的可读性会急剧下降,此时推荐改用显式函数或递归生成器处理。
四、动态未知深度的提取方法:递归与迭代
在实际生产环境中,许多嵌套列表往往是非对称的(Ragged List),或者嵌套深度不可预期(例如 [1, [2, [3, 4], 5], 6])。此时传统的固定方括号索引无法胜任,必须采用动态遍历技术。
1. 递归生成器(Memory-Efficient Generator)
递归是处理分层树状数据最直观的模型。利用 Python 的 yield from 语法,能够以极低的内存开销惰性生成深层数据:
def extract_deep_recursive(nested_list):
    """递归遍历未知深度的嵌套列表,输出所有深层叶子元素"""
    for item in nested_list:
        if isinstance(item, (list, tuple)):
            # 如果是列表或元组,继续向下递归解包
            yield from extract_deep_recursive(item)
        else:
            # 达到深层叶子节点,产出数值
            yield item

# 复杂不规则嵌套数据
ragged = [1, [2, [3, "Target"], 4], [5, [6]]]
all_items = list(extract_deep_recursive(ragged))
print(all_items)  # 输出: [1, 2, 3, 'Target', 4, 5, 6]
2. 显式栈迭代法(防止深层递归栈溢出)
Python 默认有最大递归深度限制(通常为 1000)。当嵌套层数极深时,递归可能会触发 RecursionError。使用基于 Python 列表实现的显式栈(Stack),可以安全高效地完成非递归的深度优先遍历:
def extract_deep_iterative(nested_list):
    """使用自定义栈进行迭代遍历,避免递归深度超限,保持原有顺序"""
    stack = list(reversed(nested_list))
    result = []

    while stack:
        current = stack.pop()
        if isinstance(current, (list, tuple)):
            # 逆序入栈以保证出栈顺序与原列表一致
            stack.extend(reversed(current))
        else:
            result.append(current)

    return result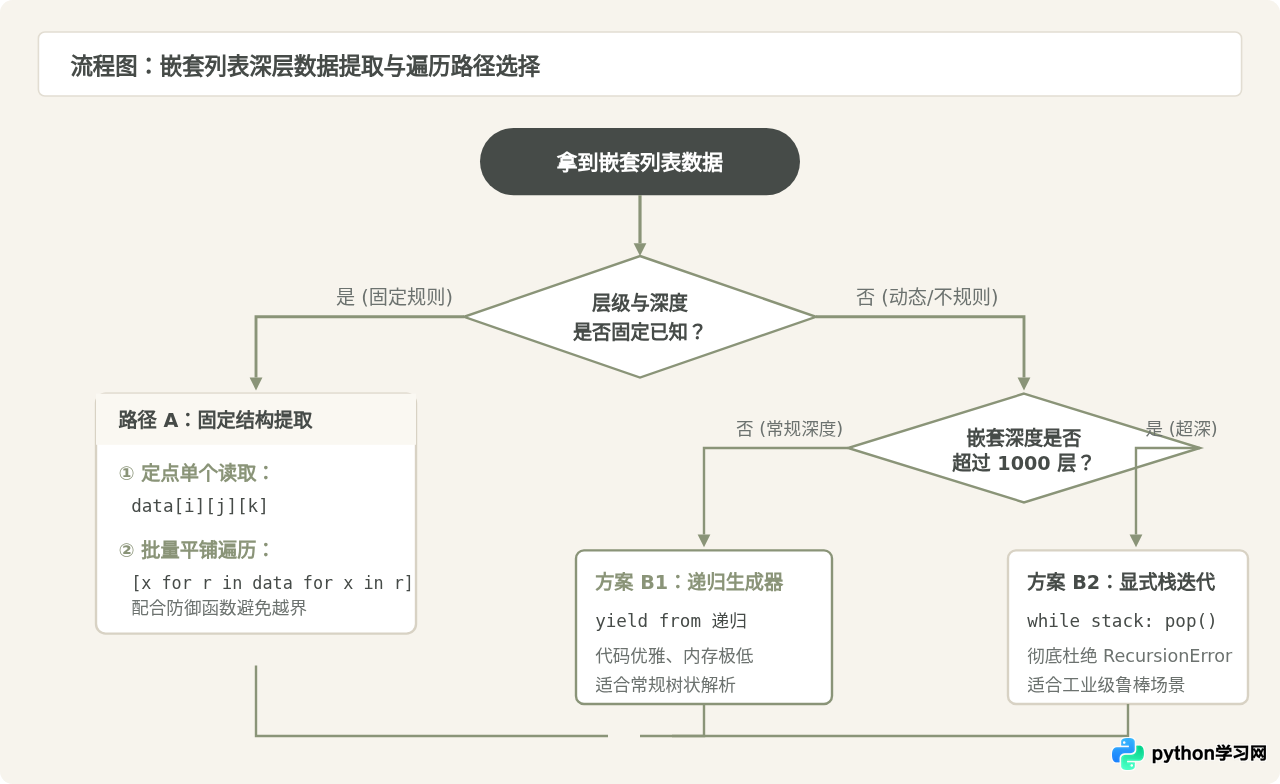
五、四种提取方法对比与选型指南
为了在不同业务场景下快速做出合理的技术选型,我们将上述四种方案的核心指标进行横向对比:
| 提取方式 | 典型语法 | 时间复杂度 | 空间复杂度 | 适用场景与局限 |
|---|---|---|---|---|
| 多级链式索引 | data[i][j][k] |
O(1) | O(1) | 精确定位单点数据;需预先知道确切层级与坐标,易发生 IndexError。 |
| 多层推导式 | [x for r in d for x in r] |
O(N) | O(N) | 规则 2~3 层平铺;简单优雅,但不适合不规则深度或多于 3 层的结构。 |
| 递归生成器 | yield from fn(child) |
O(N) | O(D) 深度开销 | 任意不规则深层提取;支持惰性求值,极端深度下受 Python 递归上限限制。 |
| 显式堆栈迭代 | stack.pop() 循环 |
O(N) | O(N) 堆空间 | 超大规模、超深层嵌套数据;无爆栈风险,但代码略长。 |
 总结建议
处理 Python 嵌套列表时,首先要辨清目标是单个值还是全部平铺,以及结构是固定还是动态。对于简单的单点获取,保持清晰的 data[i][j] 并在外层包裹防御性检查即可;对于复杂业务逻辑,优先考虑递归生成器以保持代码简洁与低内存占用。掌握这套思路,就能从容应对各类层级的深层数据提取任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









