

值得阅读的GitHub高质量Python开源项目有哪些
深入梳理适合学习与精读的GitHub高质量Python开源项目,覆盖单文件微架构、CLI终端工具、现代网络库与Web框架,详解核心架构设计、推荐切入源文件与源码内化实操指南。
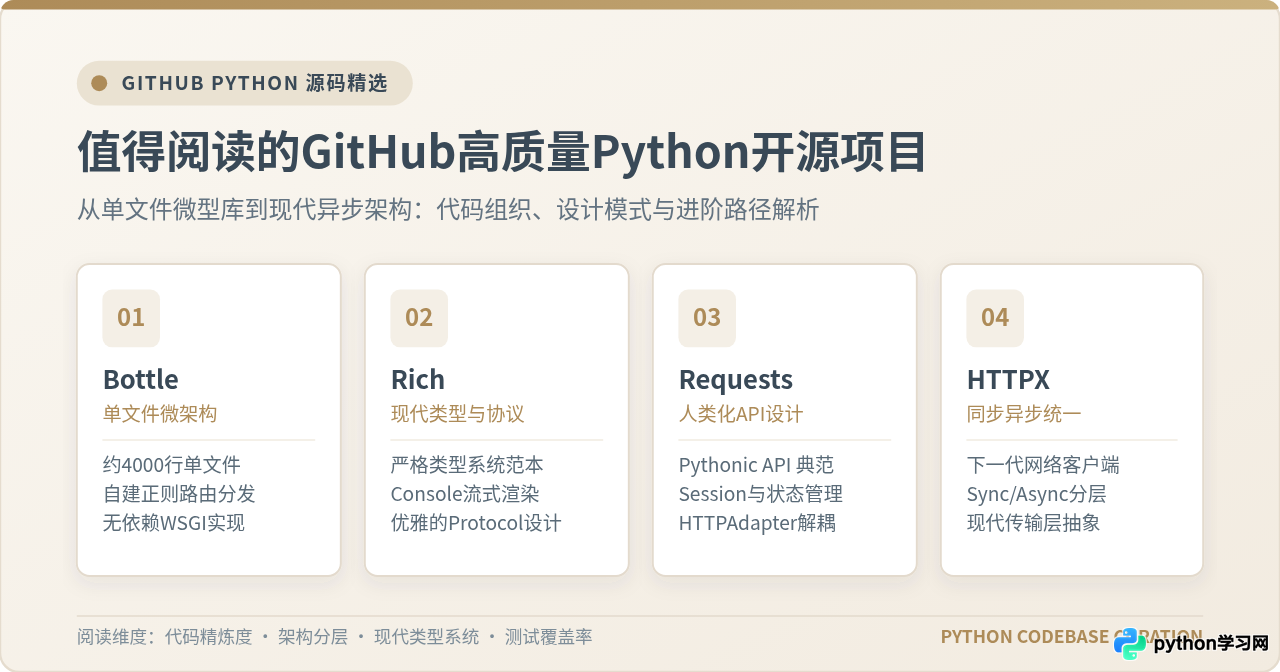
阅读经过工业级检验的开源源码,是跨越“掌握语法”到“写出高质量工程代码”之间鸿沟最快的方式。挑选阅读目标时,项目的 Star 数量并不等同于可读性,过早钻入带有大量向下兼容补丁与复杂插件生态的巨型项目往往让人迷失。最值得通读的代码,通常具备清晰的单一职责、极简且符合直觉的 API 暴露、严谨规范的现代类型注解,以及像可执行文档一样的测试用例。本文精选了 6 个不同技术维度与抽象层次的高质量 GitHub 开源项目,并提供针对性的阅读切入点与架构解析。
一、源码阅读的分级策略与学习路径
阅读开源源码切忌“盲目通读”。直接克隆一个数十万行的成熟企业级系统,读者很容易被各种边界防御性代码、跨版本兼容分支和大量宏配置淹没,从而失去方向。合理的阅读路径应当遵循“由浅入深、由孤立组件到分层体系”的梯度递进。
第一阶段应选择单文件微型库,目的是打破对底层运行机制的神秘感,看清一个完整功能如何仅靠标准库闭环实现;第二阶段进阶至具有优雅交互与严格类型定义的现代工具,重点学习面向对象模式与 Python 3 现代语法特性;第三阶段攻克网络与通信类项目,理解接口与物理传输解耦的分层设计;第四阶段再涉足拥有全局状态管理与复杂上下文生命周期的成熟框架体系。
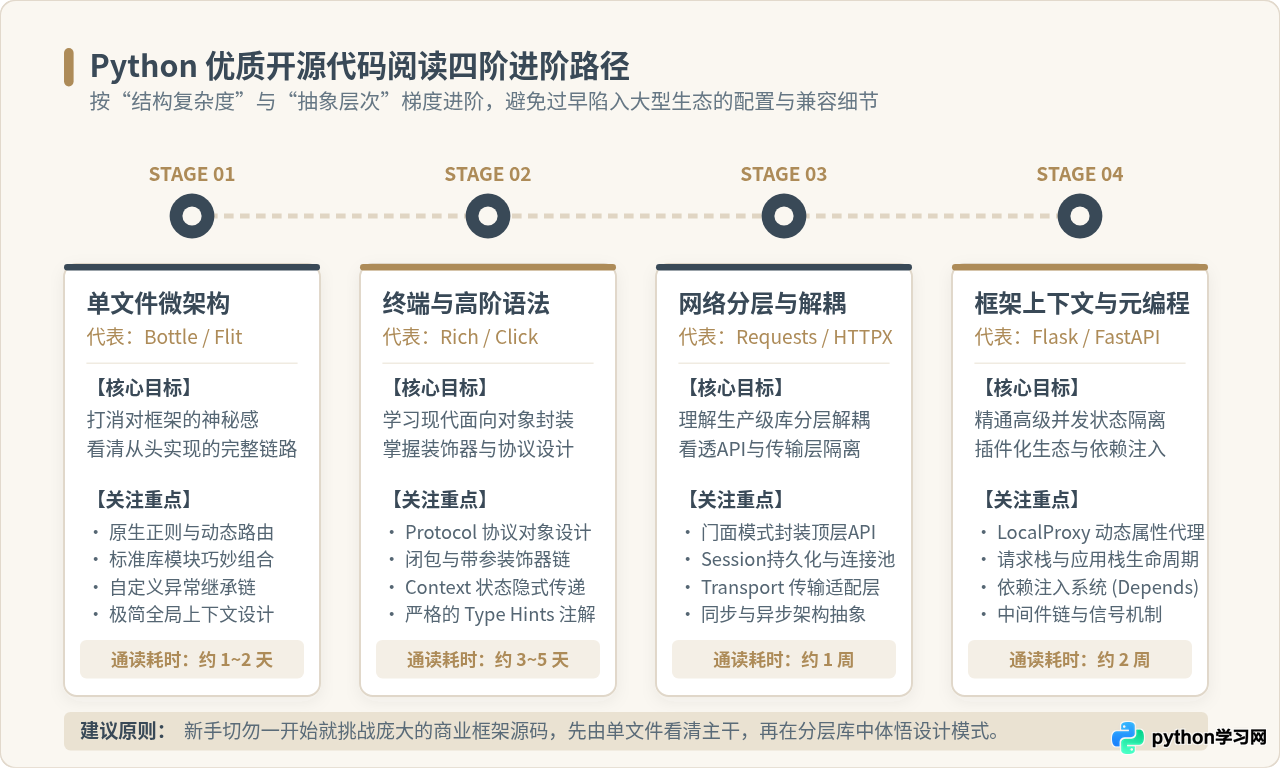
每进入一个阶段,关注的核心焦点应适时迁移:前期聚焦于函数划分、命名规范与异常处理链条;中期聚焦于协议接口(Protocol)与设计模式的具象化落地;后期则重点剖析并发隔离、配置传播与插件系统的扩展机制。
二、精选高质量开源项目分类详解
基于上述阅读梯度,下文精选了 6 个在代码品味、架构清晰度和工程规范上均属行业标杆的项目。每个项目均标注了仓库地址、推荐理由及具体的起始源文件。
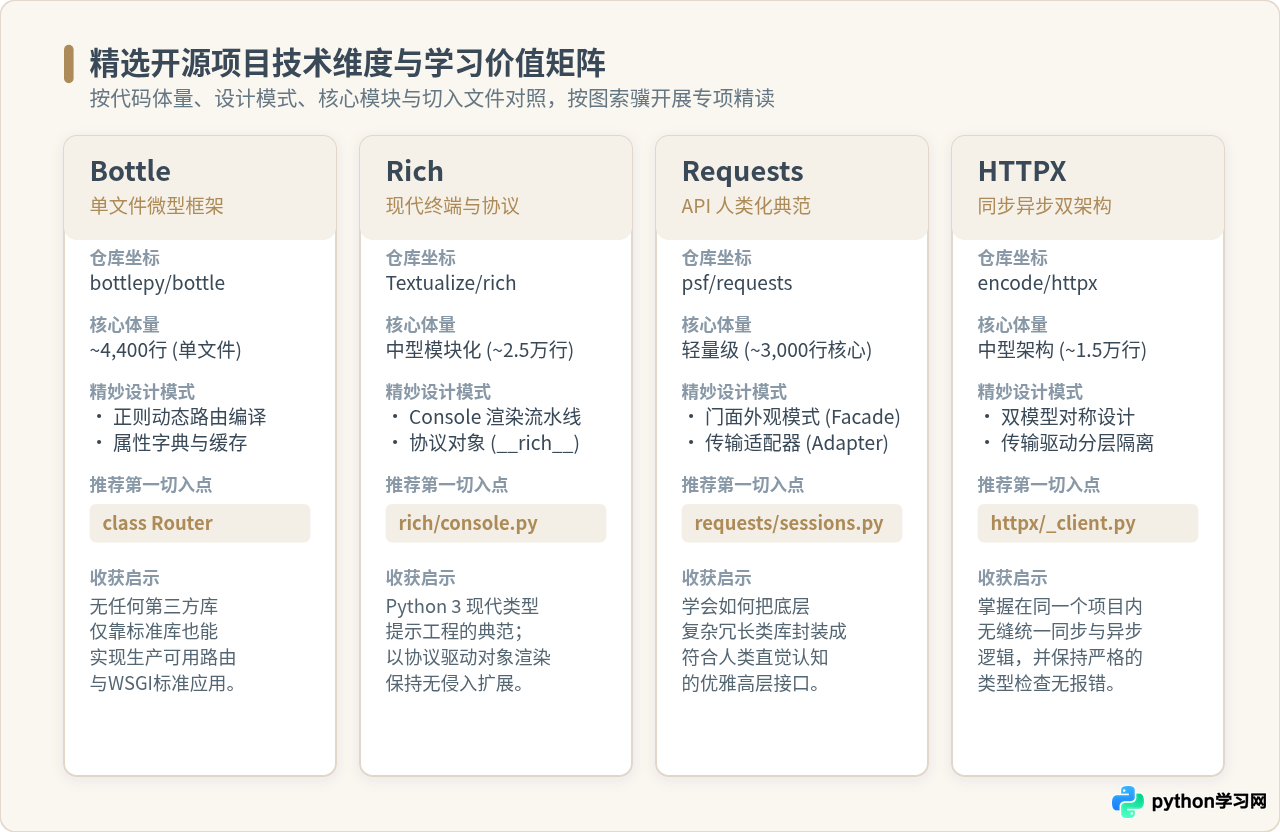
为什么值得读:在现代 Web 框架普遍高度分模块拆分的背景下,Bottle 始终坚持将所有核心逻辑收敛在单个 bottle.py 文件中(约 4400 余行代码)。它没有任何第三方外部依赖,却完整实现了基于 WSGI 的请求处理流水线、动态正则路由引擎、简单模板引擎以及 Cookie 解析。
推荐阅读切入点:直接打开 bottle.py,重点阅读 class Router 以及 class BaseRequest。
- 动态路由匹配机制:看
Router.add是如何将形如/user/<id:int>的用户路由规则,通过内部正则表达式编译成具备命名分组的正则对象,并在请求到达时高效分发路由的。 - WSGI 环境封装:观察
BaseRequest是如何将 Python 规范中原始的environ字典逐步解包为具备属性化访问特性的对象。
# 核心阅读片段示例:Bottle 中字典到属性的轻量转换模式
class FormsDict(MultiDict):
    """展示 Bottle 如何在单文件中以极其克制的方式扩展原生 dict 特性"""
    def __getattr__(self, key):
        try:
            return self[key]
        except KeyError:
raise AttributeError(key)为什么值得读:Rich 是现代 Python(Python 3.8+)优秀工程实践的代表作。其代码结构工整清晰,通篇贯彻严格的 Type Hints 类型注解,几乎可以作为 Python 静态类型系统的实操教材。更重要的是,Rich 采用协议驱动(Protocol-driven)架构,任何第三方类只要实现了对应协议方法,就能无缝在终端中被流式打印。
推荐阅读切入点:从 rich/console.py 中的 Console.render() 入手,随后阅读 rich/segment.py。
- Renderable 协议模式:Rich 并不对要渲染的对象进行硬编码类型检查,而是检查对象是否定义了
__rich_console__生成器方法。这种基于协议的设计极大降低了模块间的耦合。 - 不可变元组与段流(Segment Stream):所有复杂的树状组件、语法高亮和进度条,最终都被拍平成由
Segment(text, style, control)构成的最小不可变单元流,最后统一刷新到底层终端。
# 核心阅读片段示例:Rich 的协议驱动扩展方式
from typing import Generator
from rich.segment import Segment
from rich.style import Style

class CustomBadge:
    """任何自定义类实现 __rich_console__ 即可变身可渲染组件"""
    def __init__(self, label: str):
        self.label = label

    def __rich_console__(self, console, options) -> Generator[Segment, None, None]:
        yield Segment(f"[{self.label}]", Style(color="gold3", bold=True))
为什么值得读:Requests 被 Python 官方多次评价为“Pythonic API 设计”的教科书。在 Requests 诞生前,使用内置库 urllib2 处理重定向、Basic Auth 和 Cookie 需要层层嵌套各种 Handler 和 Opener,极其违背直觉。Requests 的精髓在于用一层极度轻巧的门面(Facade),将底层传输复杂性彻底封装隔离。
推荐阅读切入点:从 requests/api.py 顺藤摸瓜,进入 requests/sessions.py,再深入 requests/adapters.py。
- 顶层 API 的门面模式:
requests.get()内部只有寥寥数行,其本质是即时创建一个临时的Session实例并触发调用,既保证了单次调用的极简性,又保持了架构的一致性。 - 传输适配器(HTTPAdapter):在
Session.mount()中,Requests 使用了经典适配器模式,通过 URL 前缀将请求分派给HTTPAdapter,由适配器负责与底层urllib3线程池交互,完全实现了高层 API 与网络物理收发解耦。
为什么值得读:Click 是构建高质量命令行界面的黄金标准。如果你想深入理解 Python 装饰器的嵌套、参数收集、惰性求值以及如何通过上下文(Context)在多层函数调用之间优雅传递状态,Click 是最好的学习素材。
推荐阅读切入点:打开 click/core.py,重点阅读 BaseCommand、Group 以及 Context 类的实现。
- 声明式装饰器链:学习
@click.command()与@click.option()如何在不执行目标函数的前提下,将其元数据(参数类型、帮助文档、默认值)打包挂载到目标可调用对象上。 - Context 的生命周期维护:Click 为每次 CLI 执行维护一个独立的
Context对象,通过pass_context装饰器动态注入,避免了使用危险的全局变量。
# 核心阅读片段示例:Click 中 Context 上下文如何实现安全传参
class Context:
    """管理命令解析执行期间的全部上下文状态与父子回溯"""
    def __init__(self, command, parent=None, info_name=None, obj=None):
        self.command = command
        self.parent = parent
        self.obj = obj  # 供开发者自由挂载业务状态数据
为什么值得读:随着异步编程(asyncio)在 Python 领域的普及,如何在同一个项目中同时支持同步调用(httpx.Client)与异步调用(httpx.AsyncClient),同时最大化复用请求构造、Header处理与重试逻辑?HTTPX 给出了完美的架构范式。
推荐阅读切入点:对比阅读 httpx/_client.py 中的 BaseClient、Client 与 AsyncClient,并查看 httpx/_transports/default.py。
- 双架构代码复用:HTTPX 将所有的请求构建、URL 解析、编码校验收敛于
BaseClient,仅在发生物理 I/O 的最底层切分为HTTPTransport与AsyncHTTPTransport。 - 严格的模块隔离:核心层处理协议语义,底层的具体 Socket 连接交由
httpcore库完成,展示了现代大型基础库的严谨拆解思路。
为什么值得读:为什么在 Flask 中可以直接 from flask import request,而不同并发请求之间的数据绝不会发生串扰?阅读 Flask 的源码,是彻底掌握 Python 动态属性代理(LocalProxy)、线程/协程本地存储与上下文栈生命周期的必由之路。
推荐阅读切入点:阅读 flask/app.py 中的 wsgi_app(),以及 flask/ctx.py 中的 AppContext 和 RequestContext。
- 动态代理对象:观察
werkzeug.local.LocalProxy是如何通过魔术方法重写,将所有属性访问实时重定向到当前工作线程的上下文栈顶对象。 - 双栈分离模型:理解为什么需要将“应用级上下文(
current_app,g)”与“请求级上下文(request,session)”拆分为两个独立的栈结构,以及这给单元测试带来的巨大便利。
三、标杆项目深度架构剖析:高内聚与低耦合设计
优秀开源项目之所以能够保持长期稳定与易于维护,核心在于其内部极其分明的层级边界。以 Requests 与 Rich 为例,我们能够清晰提炼出两种针对不同应用场景的顶级设计模式。
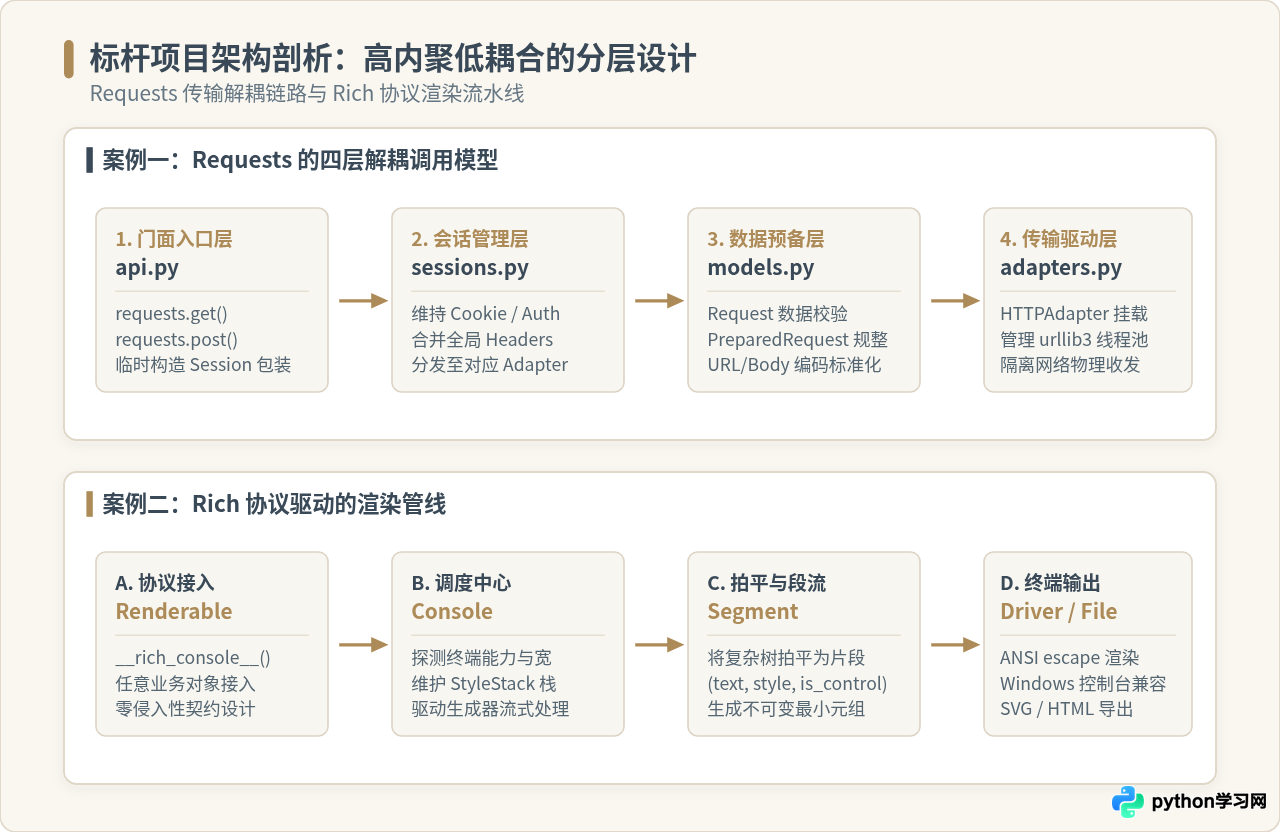
1. Requests 的四层调用模型
如上图上半部分所示,Requests 构建了一个经典的单向调用链路:
- 入口门面层(api.py):对开发者暴露最直观的快捷函数,内部只负责统一生命周期,不做任何底层网络逻辑。
- 状态会话层(sessions.py):维护跨请求的 Cookie、重试策略、默认 Headers 以及身份凭证。所有的单个请求都会被组织成统一的会话流程。
- 数据预备层(models.py):将零散的参数组装为不可变的
PreparedRequest。这一步完成了所有的 URL 编码、Body 序列化与文件打包,确保传给底层网络层的数据是完全规范且干净的。 - 物理传输层(adapters.py):
HTTPAdapter实现统一的send()接口。无论底层使用urllib3还是未来替换为其他连接库,上层代码均无需修改一行。
2. Rich 的协议驱动渲染管线
如上图下半部分所示,Rich 面临的挑战在于:如何渲染无数种完全不同的控制台元素(如表格、树形目录、JSON、Markdown),同时避免 Console 核心类膨胀成一个庞大的“上帝类”?
Rich 采用了协议倒置思想:让每个待渲染的组件自行承担渲染职责(实现 __rich_console__ 方法)。Console 调度器只负责提供当前终端的物理参数(列宽、颜色能力)和样式栈状态。组件将其内部数据打散为最小颗粒度的 Segment 流并输出给调度器。调度器再根据系统环境(如是否运行在 Windows 旧控制台或重定向到了文件)选择最终的输出驱动。这种管道化处理使得 Rich 获得了近乎无限的无侵入扩展能力。
四、高质量源码阅读的实战技巧与避坑指南
很多开发者在刚开始阅读开源代码时,常常直接从第一行代码硬读,容易因理解卡顿而半途而废。以下经过实践检验的操作方法能够显著提升阅读效率:
单元测试是作者意图最纯粹的表达。优秀的开源库其 tests/ 目录下都有极高质量的测试用例。先看测试用例,不仅能立刻了解该类或函数的最小使用范例,还能清晰观察作者针对各类异常入参所做的防御性考量。
写一个 3~5 行的最简调用脚本,在入口处打上断点(例如使用 breakpoint() 或 VSCode/PyCharm 调试器),使用“单步跳入(Step Into)”一路跟踪一次调用的完整调用栈(Call Stack)。通过调用栈画出时序图,能瞬间理清主干脉络。
第一次精读时,请主动跳过以下三类代码:跨平台编码兼容补丁(如针对 Windows 特定版本的兼容处理)、废弃 API 的重定向警告(DeprecationWarning)、以及极其罕见的边缘分支防御。紧扣主要数据流即可。
如果当前主分支的代码已经演化得过于庞大,可以利用 Git 检出项目的早期版本(如 git checkout v0.1.0)。绝大多数项目在其首个发布版本时,通常仅有几百到一千行代码,其核心设计思想和原型结构往往最容易在此阶段被一眼看透。
五、高质量代码评估体系与内化指南
通读源码的最终目的,不是背诵别人的代码,而是将优秀的工程规范内化为自己的编程直觉。在评估一段代码是否属于“高质量”时,业界通常围绕五个关键维度展开考量。
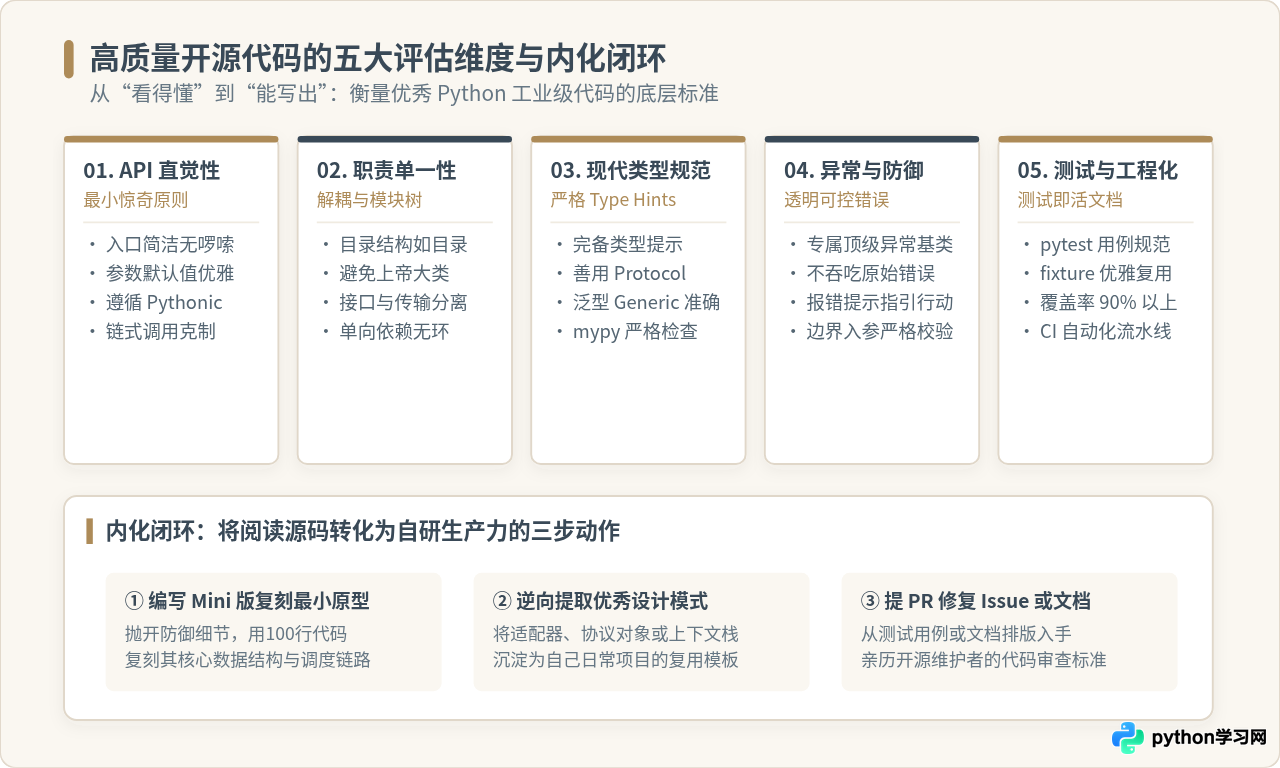
高质量 Python 代码的五项检验清单
| 评估维度 | 高质量表现(推荐做法) | 低质量警示(应极力避免) |
|---|---|---|
| API 直觉性 | 符合“最小惊奇原则”,核心功能开箱即用,参数默认值安全合理。 | 调用前需要初始化大量冗余配置,入参过多且类型混乱。 |
| 职责单一性 | 每个文件、类与函数仅聚焦于一件事情,层级清晰,单向依赖。 | 上千行的“上帝类”,各模块之间双向循环导入,层级杂乱。 |
| 现代类型系统 | 完备使用 Type Hints 注解,善用 Protocol,能通过 mypy 严格检查。 | 全篇没有类型提示,或滥用 Any 导致静态类型检查形同虚设。 |
| 异常可控度 | 拥有项目专属的异常基类,报错信息精准描述问题并附带排查建议。 | 直接 except Exception: pass 吞掉底层错误,导致调试极其困难。 |
| 测试完整度 | 测试用例条理分明,善用 fixture,覆盖边界条件且独立可重复运行。 | 没有自动化测试,或测试强依赖外部特定物理网络及文件系统状态。 |
内化闭环操作
为了把“读懂代码”切实转化为自己的开发实力,建议每精读完一个库后,实施以下三步复盘:
- 复刻 Minimal 原型:抛开所有的边缘处理逻辑,用 100~200 行代码亲手实现其核心骨架(例如自己手写一个极简的动态路由分发器,或一个基于装饰器的 CLI 参数解析器)。
- 沉淀通用设计模式:将项目中优秀的适配器、协议对象或上下文栈抽离为通用代码片段,存入个人或团队的基础工具包中。
- 参与开源协同:从修复一个拼写错误、完善一份测试用例或改进中文文档开始向官方仓库提交 Pull Request,在与全球顶级开源维护者的 Code Review 对话中体会工业级代码的审查标准。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









