

Python os.system 与 subprocess 的区别及为何推荐后者
深入对比 Python 中 os.system 与 subprocess 的底层工作原理、返回值差异、输出流捕获及安全性问题,详细解析为什么官方推荐使用 subprocess.run 替代 os.system,并提供具体的迁移步骤与避坑指南。
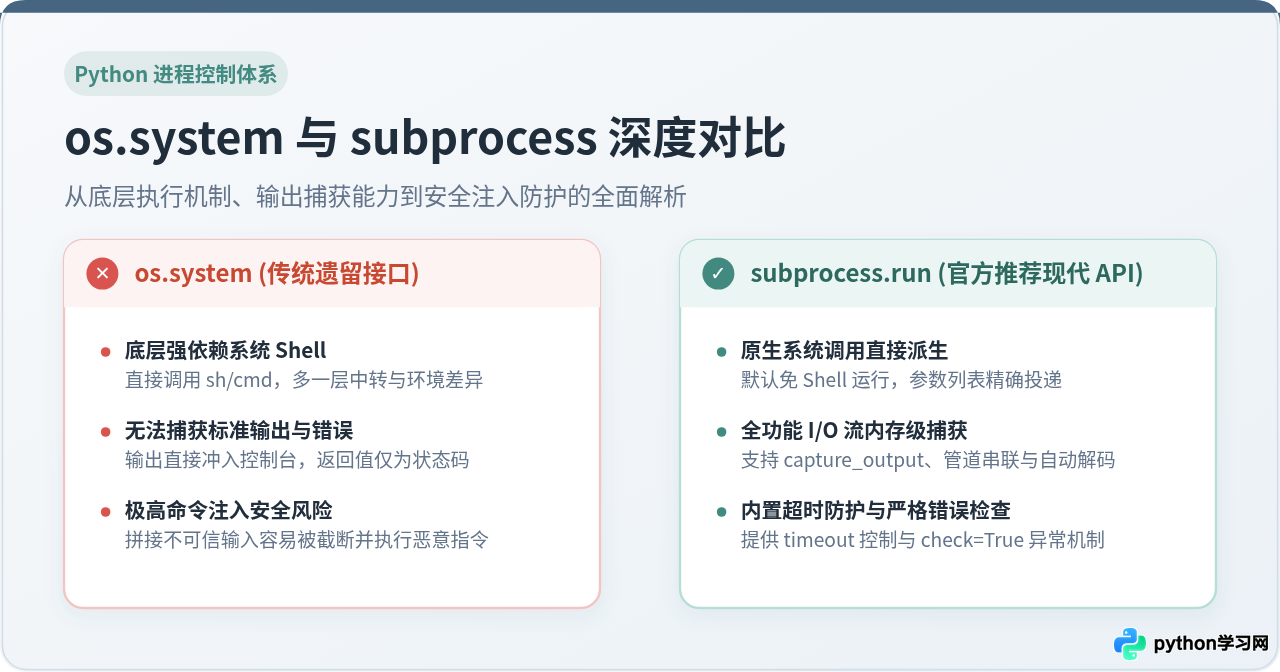
在 Python 中执行外部系统命令时,os.system 与 subprocess 都可以调用操作系统的外部可执行程序,但二者在设计理念、底层架构和安全机制上存在根本性差异。结论非常明确:os.system 是早期从 C 语言标准库直接移植过来的陈旧接口,它强制依赖系统 Shell 执行,无法在 Python 内部捕获命令输出文本,返回值需位移换算且极易引发 Shell 注入风险;而现代 Python(3.5+)首选推荐的 subprocess.run() 默认直接通过系统调用拉起进程,不仅提供完整的标准流捕获与超时控制,还凭借“参数列表传递”在机制层面彻底杜绝了注入隐患。官方文档早在 Python 2.4 就已将 subprocess 确立为替代各种分散旧接口的标准方案。
一、os.system 的底层工作原理及其固有缺陷
os.system(command) 是 Python os 模块中最早用于执行命令行指令的函数。它的底层直接封装了 C 标准库的 system() 函数。正因如此,它在现代软件工程实践中暴露出了多项难以克服的结构性硬伤。
1.1 依赖底层 Shell 导致的环境耦合与开销
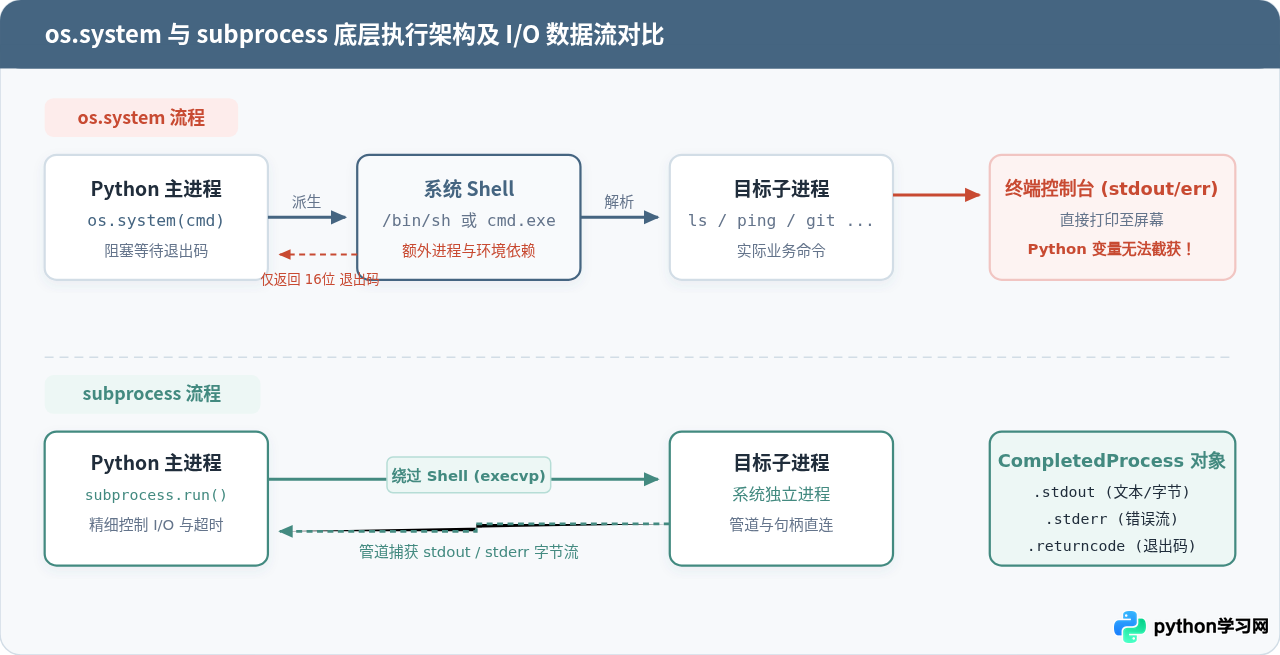
在 POSIX 系统(如 Linux、macOS)中,os.system("command") 会在底层隐式调用 /bin/sh -c "command";在 Windows 系统中,则调用 cmd.exe /c "command"。这意味着每次调用都会额外派生一个 Shell 解释器进程,再由 Shell 解析并启动最终的目标程序。这不仅带来了额外的进程分叉(fork/exec)开销,还会受到宿主机器当前 Shell 环境变量、别名(alias)以及通配符展开行为的影响,破坏了代码在不同平台之间的行为一致性。
1.2 无法在 Python 内存中捕获命令的输出结果
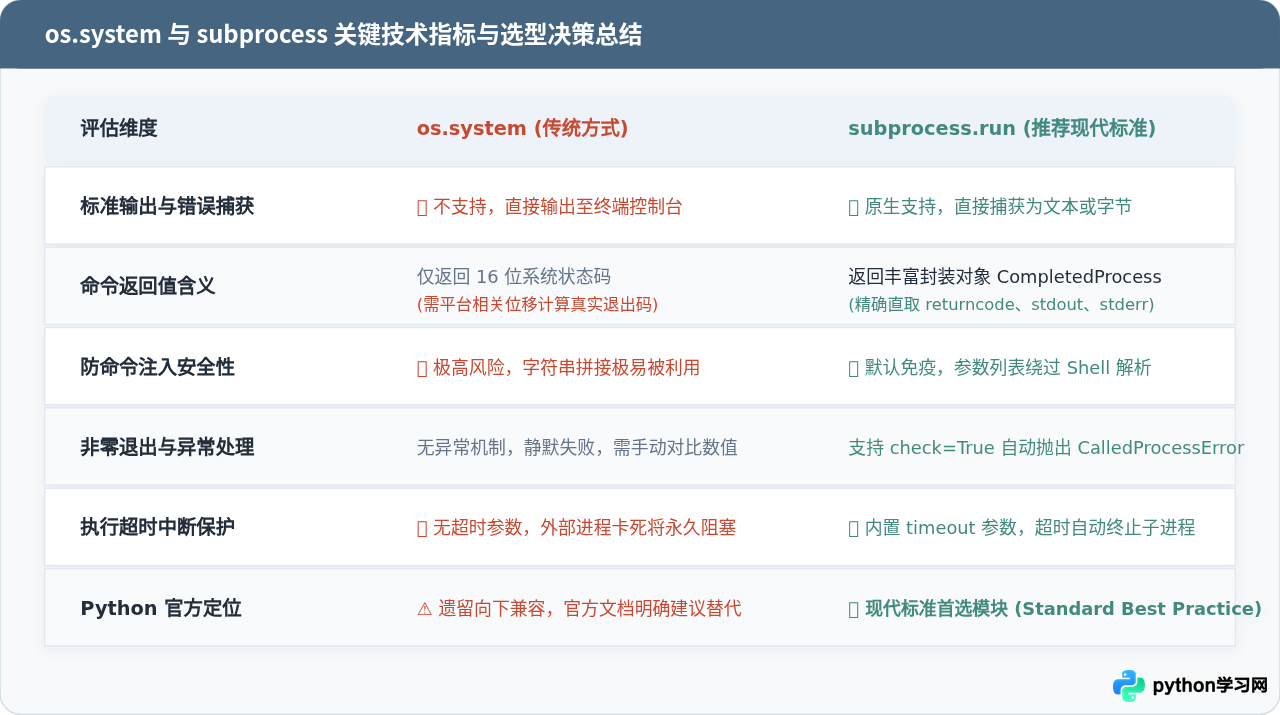
这是初学者在使用 os.system 时最常遇到的痛点。os.system 执行命令时,子进程的标准输出(stdout)和标准错误(stderr)会被直接冲刷绑定到当前 Python 解释器所在的终端屏幕上,Python 程序内部根本无法获取这些文本内容。
import os

# 试图通过变量接收命令输出
output = os.system("date")
print(f"变量 output 的值是: {output}")如示例所示,终端第一行直接打印出了日期,但变量 output 拿到的只是数值 0(表示执行状态),而非日期文本。如果业务需求是“读取外部命令的输出并参与后续计算或字符串处理”,os.system 完全无法单独完成,往往导致一些开发者编写创建临时文本文件重定向的复杂补丁代码。
1.3 返回值的“16 位状态码”位移掩码陷阱
os.system 返回的整型数值并不是子进程直接返回的退出码(Exit Code),而是由操作系统 wait() 系统调用返回的 16 位进程终止状态值(Wait Status):
- 高 8 位:存储子进程真正的退出状态码(Exit Code)。
- 低 8 位:用于指示杀死该进程的系统信号(Signal Number)以及是否生成了 Core Dump。
例如,当子进程以状态码 1 退出时,在 POSIX 系统上 os.system 返回的值实际上是 256(即 1 << 8)。如果不做位移运算 status >> 8 或调用 os.waitstatus_to_exitcode(),直接判断 if os.system(...) == 1 将产生严重逻辑误判。
1.4 字符串直接拼接引发的严重命令注入漏洞
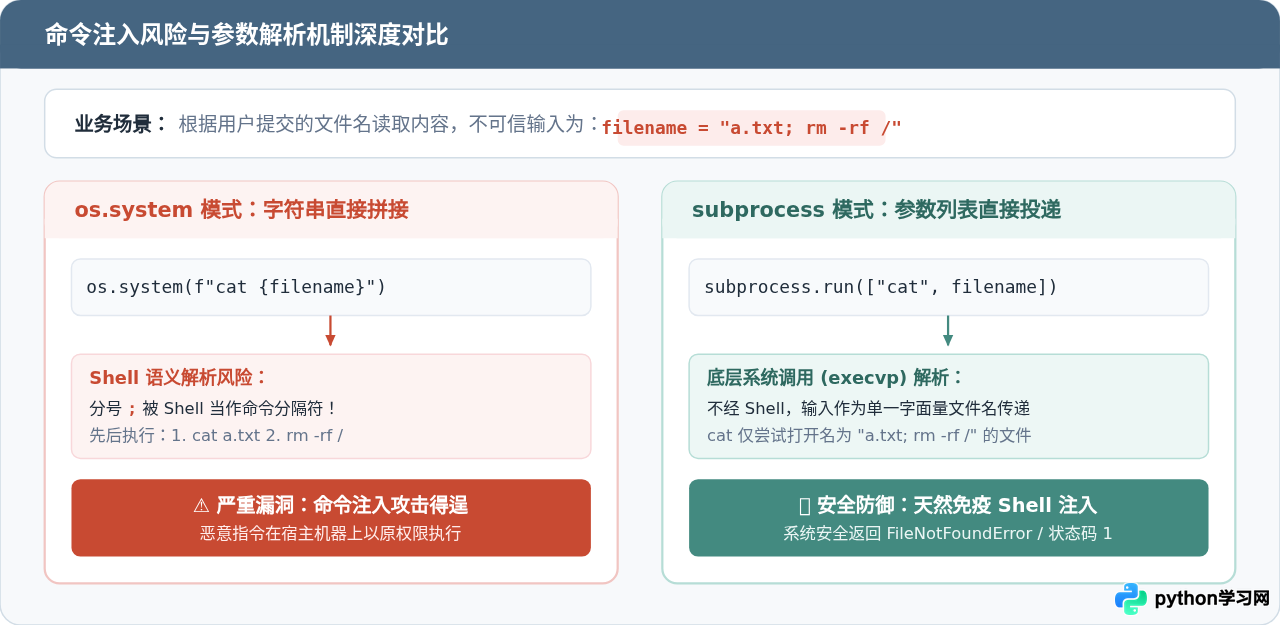
由于 os.system 将整个字符串原封不动提交给 Shell 解释,一旦命令行中包含未经过滤的外部输入变量,攻击者即可利用 Shell 元字符(如 ;、&&、|、`、$())实施命令注入攻击。
import os

# 模拟接收外部用户传入的文件名参数
user_input = "report.txt; rm -rf /"
command = f"cat {user_input}"

# Shell 会将其解析为两条独立指令连续执行!
os.system(command)如上述代码所示,Shell 解析器遇到分号 ; 会将其视为指令分界符。程序在执行完 cat report.txt 之后,会紧接着在宿主系统上以当前用户的权限执行破坏性命令 rm -rf /。这种安全脆弱性是纯文本拼接 Shell 模式的先天缺陷。
二、subprocess 模块的核心优势与执行机制
Python 在 2.4 版本引入了 subprocess 模块,旨在用一套功能统一、安全可靠的体系全面替代 os.system、os.spawn*、os.popen* 以及 popen2.* 等杂乱接口。从 Python 3.5 起,官方新增了高阶封装函数 subprocess.run(),成为日常执行外部命令的首选最佳实践。
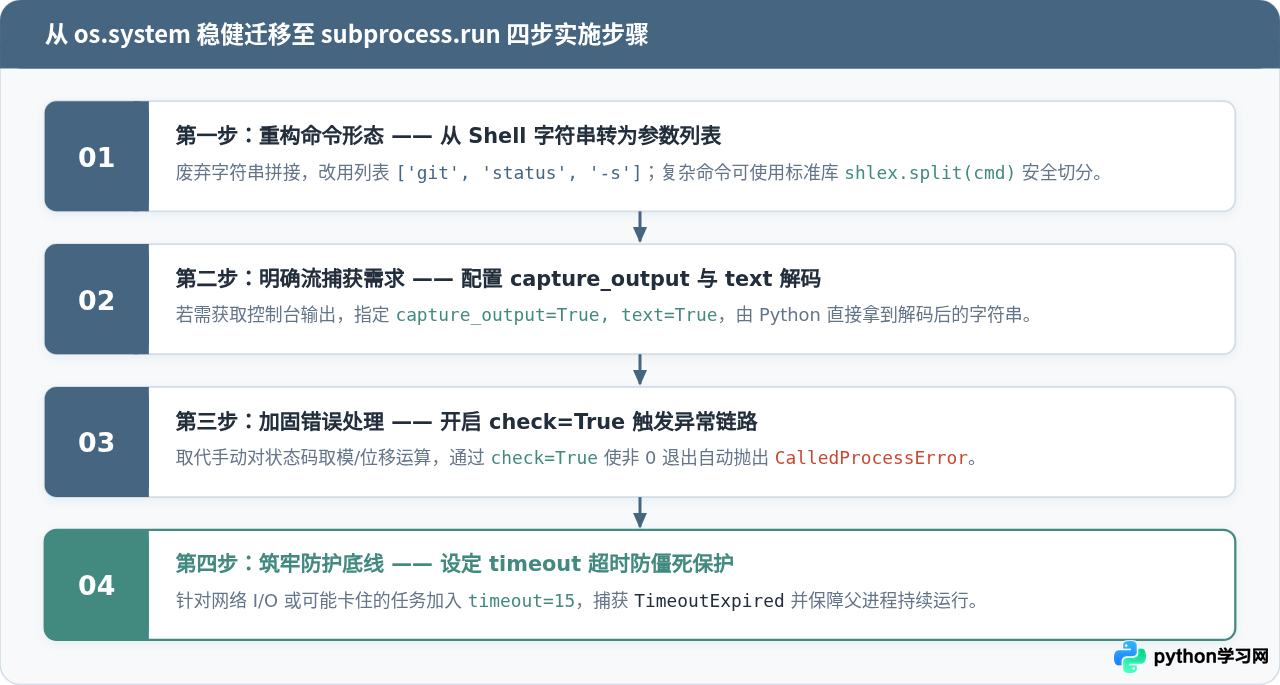
2.1 默认免 Shell 执行(shell=False)与参数列表传递
subprocess.run() 默认设置 shell=False,要求用户以列表(List)形式传递命令及参数,如 ["git", "commit", "-m", "fix: bug"]。在底层:
- 类 Unix 平台:直接调用底层的
execve/execvp系统调用,操作系统内核将列表中的每个元素精确作为一个argv字符串传递给目标二进制程序。 - Windows 平台:直接通过 Win32 API
CreateProcessW创建进程。
这种机制完全绕过了 Shell 解释器,即使参数中包含分号、管道符、空格或重定向符号,操作系统也只会将其当做纯字面量参数传给可执行程序,从而在架构根源上封死了命令注入漏洞。
2.2 原生全功能流捕获(capture_output 与 text 解码)
通过传入 capture_output=True(或显式指定 stdout=subprocess.PIPE, stderr=subprocess.PIPE),subprocess.run() 可以在内存中创建匿名管道,准确截获子进程的标准输出流与标准错误流,并封装在返回的 CompletedProcess 实例中。
配合 text=True(或 encoding="utf-8"),返回的 result.stdout 会自动将字节流解码为 Python 字符串,省去了手动处理 bytes.decode() 的繁琐步骤。
2.3 完备的异常处理与退出状态检查(check=True)
在 os.system 中,如果命令执行失败(例如文件不存在或命令退出码非 0),调用方如果不主动检查返回值就会默默继续往下走,造成“静默失败”。而 subprocess.run() 提供了 check=True 参数:一旦子进程返回非 0 退出码,就会自动抛出 subprocess.CalledProcessError 异常,这与 Python 提倡的异常驱动设计高度契合。
2.4 确定性的超时终止机制(timeout)
外部命令可能因死锁、网络阻塞或等待用户终端输入而发生无限期挂起。os.system 没有内置超时机制,一旦卡死整个 Python 主线程将被永久阻塞。subprocess.run() 支持通过 timeout=秒数 参数设置执行上限。一旦超过设定时间,父进程会自动向子进程发送终止信号并抛出 subprocess.TimeoutExpired 异常,保障主程序的健壮性。
三、常见场景代码对照与迁移指南
针对日常开发中常见的使用场景,以下给出从 os.system 迁移到 subprocess.run 的具体实现对比。
场景一:仅执行命令,判断是否成功并捕获失败
传统做法(os.system):
import os

# 传统方式:需手动判断返回值是否为 0
status = os.system("ping -c 1 127.0.0.1")
if status == 0:
    print("主机可达")
else:
    print(f"探测失败,原始状态码: {status}")
现代化推荐做法(subprocess.run):
import subprocess

try:
    # check=True 在命令返回非 0 码时自动抛出异常
    subprocess.run(["ping", "-c", "1", "127.0.0.1"], check=True)
    print("主机可达")
except subprocess.CalledProcessError as e:
    print(f"探测失败,进程退出码: {e.returncode}")
场景二:捕获外部命令的标准输出并做字符串处理
现代推荐做法(subprocess.run):
import subprocess

# 获取当前 git 分支名称并过滤首尾换行
result = subprocess.run(
    ["git", "branch", "--show-current"],
    capture_output=True,
    text=True,
    check=True
)

current_branch = result.stdout.strip()
print(f"当前所在分支: {current_branch}")场景三:为高风险或网络命令配置超时防御
import subprocess

try:
    # 限制命令必须在 3 秒内执行完毕
    result = subprocess.run(
        ["sleep", "10"],
        timeout=3,
        capture_output=True,
        text=True
    )
except subprocess.TimeoutExpired as e:
print(f"执行超时!命令 {e.cmd} 超过 {e.timeout} 秒未响应,已强行终止。")场景四:长耗时后台任务与实时管道交互(subprocess.Popen)
当需要向外部子进程持续写入标准输入(stdin),或者外部进程输出极其庞大、需要分批流式消费时,可以使用 subprocess 提供的底层类 Popen:
import subprocess

# 启动子进程并建立管道通信
process = subprocess.Popen(
    ["grep", "ERROR"],
    stdin=subprocess.PIPE,
    stdout=subprocess.PIPE,
    text=True
)

# 向 grep 进程输入两行测试数据并获取过滤结果
stdout_data, stderr_data = process.communicate(input="INFO: 系统正常\nERROR: 磁盘已满\n")
print(f"过滤命中行:\n{stdout_data.strip()}")四、常见避坑指南与最佳实践
在实际工程项目中使用 subprocess 替代 os.system 时,开发者需要注意以下三个高频踩坑点:
4.1 警惕滥用 shell=True
在迁移过程中,部分开发者为了少写参数列表,习惯性地写出 subprocess.run("cat " + filename, shell=True)。必须明确:一旦开启 shell=True,就再次引入了 Shell 解析器,os.system 存在的命令注入风险将卷土重来!
避坑策略:
- 坚决保持默认的
shell=False,传列表而非字符串。 - 如果命令来自于复杂的长文本配置,可以使用标准库
shlex.split()安全切分,例如subprocess.run(shlex.split(command_str))。 - 仅当确实需要使用 Shell 语法特性(如管道
cmd1 | cmd2、输出重定向>、通配符*.log)时才开启shell=True,且严禁将不可信的外部变量拼接入该字符串。
4.2 字符编码兼容性(显式指定 encoding 与 errors)
在 Windows 环境下,中文系统的命令行默认代码页往往是 GBK(CP936),而 Linux/macOS 默认是 UTF-8。若仅使用 text=True,Python 会采用 locale.getpreferredencoding() 进行隐式解码,容易在解析包含中文路径或特定字符时引发 UnicodeDecodeError。
最佳实践:如果知道外部程序的编码输出,建议显式指定编码方式及容错策略:
result = subprocess.run(
    ["dir"],
    shell=True,
    capture_output=True,
    text=True,
    encoding="gbk",           # 显式指定代码页
    errors="replace"          # 解码异常时用占位符替换,杜绝崩溃
)
4.3 避免 Popen 管道死锁(切忌直接调用 process.stdout.read())
在使用底层的 subprocess.Popen 时,如果子进程输出的内容超过操作系统的默认管道缓冲区大小(通常在 Linux 上为 64KB),而父进程没有及时清空管道,子进程就会被阻塞无法继续写入,同时父进程还在等待子进程退出,从而造成永久死锁。
避坑策略:切勿直接通过 process.stdout.read() 读取阻塞流,而应统一使用 process.communicate(),它内部实现了多线程或多路复用轮询,能够安全处理大体积数据并防止死锁。
五、总结
os.system 是早期 Python 遗留下来的简单工具,只适用于临时测试或极为粗糙的本地玩具脚本。在任何涉及数据交互、结果验证、网络环境以及生产级稳定性的项目中,subprocess.run() 都是唯一被推荐的标准方案。
从 os.system 转向 subprocess.run(),不仅是一次 API 调用的升级,更是将程序从“黑盒终端打印”推向“精细流控制与防御性编程”的关键一步。通过使用参数列表、开启错误检查、配置超时约束,你的 Python 脚本将在安全性、跨平台稳定性以及健壮性上获得质的提升。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









