

Python中#和三引号注释的区别:解析器怎么处理这两种符号
深入解析Python中井号(#)与三引号字符串的区别,从词法分析、语法树构建到字节码编译,详尽拆解Python解析器对这两种符号的处理底层机制与工程实践建议。
在 Python 编程中,很多人习惯用 # 写单行注释,用成对的三引号(''' 或 """)包裹多行文字当作“多行注释”。在表面效果上,两者都能让文字不直接作为指令执行,但在 Python 解析器眼底,它们是完全不同的两类语法构造:# 是 Python 语法中唯一定义的真正注释,在词法分析阶段就会被完全剔除;而三引号本质上是多行字符串字面量(String Literal),解析器会将其完整词法化并纳入语法分析流程。 理解两者的底层处理差异,对于掌握 Python 运行时机制、避免隐蔽语法陷阱以及编写规范的代码至关重要。
一、解析器如何处理“#”符号:词法阶段的直接丢弃
当 Python 解释器读取一个 .py 脚本时,第一步是由词法分析器(Lexer / Tokenizer)将连续的字符流分解成有意义的标记(Tokens)。
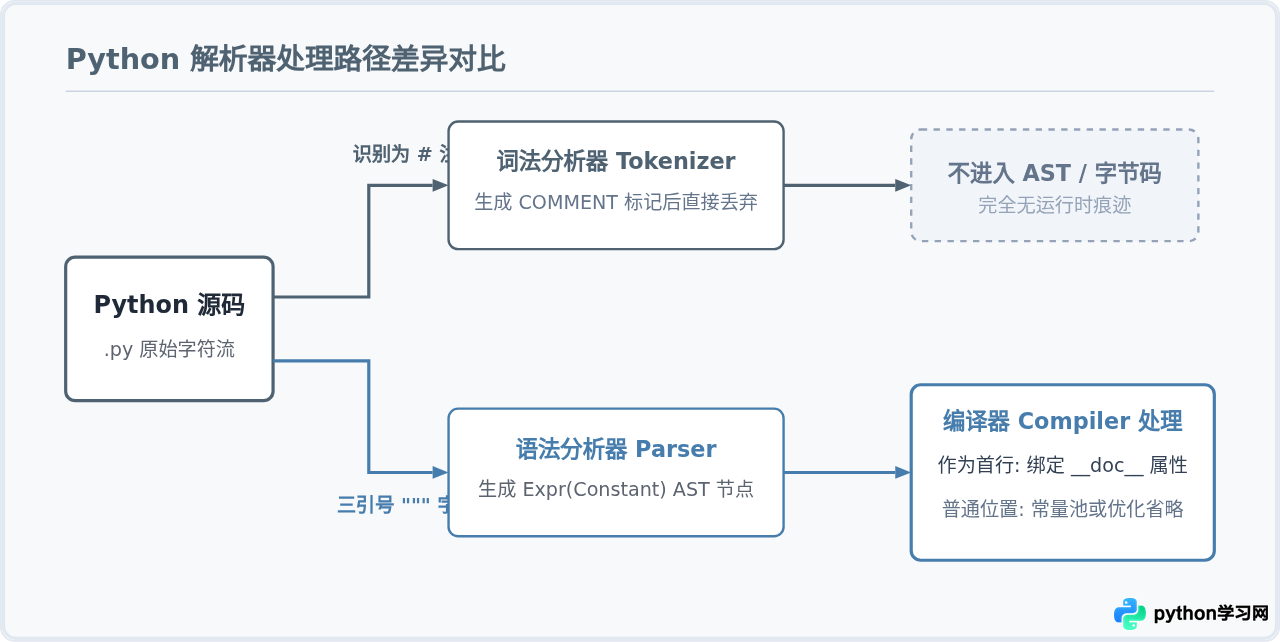
当词法分析器遇到井号 # 时,会立即识别出注释的起始。根据 Python 语法规范,从 # 开始直到该物理行末尾的所有字符,都会被归类为 COMMENT 类型的标记。
关键机制在于:在词法分析器向后续的语法分析器(Parser)传递 Token 流时,普通 COMMENT 标记会被直接过滤忽略。这意味着:
- 不生成 AST 节点: 语法分析器生成的抽象语法树(AST)中,没有任何关于
#及其后文字的节点。 - 不进入字节码: 编译器在生成字节码对象(Code Object)时,完全感知不到注释的存在。
- 零运行时开销: 无论程序中写了多少行
#注释,程序运行时的内存占用、常量池大小和执行速度均不受任何影响。 - 语法完全宽容: 在
#后面写任何非法的语法(例如未闭合的括号、非法字符),解析器都不会抛出语法错误。
二、解析器如何处理“三引号”:字符串字面量的生命周期
许多教程习惯将三引号包裹的代码称为“多行注释”,这在语言规范层面是不准确的。Python 语言标准(PEP 8、PEP 257 以及官方语法词法参考)中,并不存在多行注释语法。三引号仅仅是表示可以跨越多行的普通字符串字面量。
由于它是合法的表达式语句,解析器会经历完整的生命周期处理:
- 词法分析: 识别为
STRING标记,检查引号闭合与转义字符。 - 语法分析: 语法分析器为它构建抽象语法树节点,通常是一个表达式语句节点(
ast.Expr),其值为字符串常量(ast.Constant)。 - 作用域与上下文判定: 编译器在将 AST 转为字节码时,会检查这个字符串所处的位置。
1. 作为文档字符串(Docstring)处理
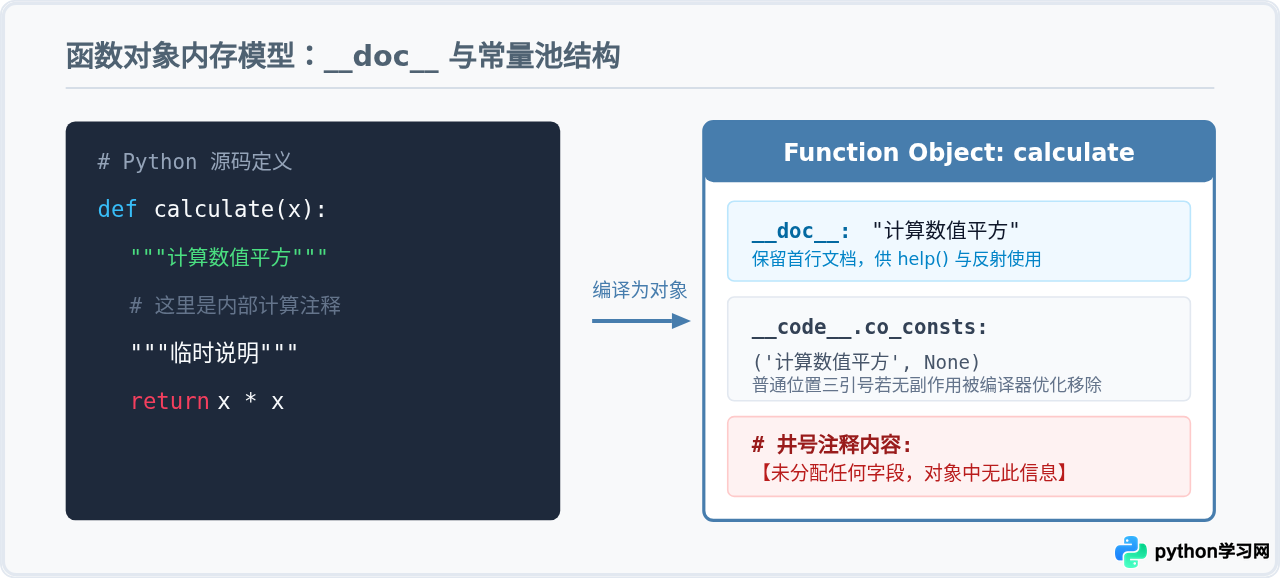
如果三引号字符串出现在模块、类定义或函数定义的第一条语句(允许其前面有 # 注释或空白行),编译器会识别其为该对象的文档字符串:
- 该字符串会被编译并存入代码对象的常量表
co_consts中。 - 在对象创建时,自动将其赋值给该对象的
__doc__属性。 - 在运行时,可以通过
help()函数或直接读取obj.__doc__访问该文本,它会在整个程序生命周期中驻留内存。
2. 作为代码块中的孤立表达式(裸字符串)
当三引号字符串出现在函数体中间、if 分支内部或循环体中,且没有被赋值给任何变量时,它在语法上是一个独立的常量表达式语句(Expression Statement)。
在 Python 编译器的优化阶段(AST 优化与窥孔优化 Peephole Optimizer):
- 由于纯字符串常量表达式没有任何可执行的副作用,现代 CPython 编译器(Python 3.7+)会将其从生成的执行字节码中剪除,不会发出
LOAD_CONST接着POP_TOP的无用指令。 - 但是,语法与缩进检查依然必须通过。如果代码块内的三引号缩进不符合规范,或者字符串内部存在未转义的语法冲突,解析器会毫不留情地抛出
IndentationError或SyntaxError。
三、代码证据:通过 AST 与字节码观察两种符号
我们可以使用 Python 标准库自带的 tokenize、ast 和 dis 模块,直接透视解析器在各阶段的处理结果。
1. 词法分析阶段的 Token 对比
运行以下示例脚本,观察词法分析器输出的标记流:
import tokenize
import io

code = """
# 这是井号注释
'''这是三引号字符串'''
"""

tokens = list(tokenize.generate_tokens(io.StringIO(code).readline))
for tok in tokens:
    if tok.type in (tokenize.COMMENT, tokenize.STRING):
        print(f"类型: {tokenize.tok_name[tok.type]:<8} | 内容: {tok.string}")
输出示例:
类型: COMMENT  | 内容: # 这是井号注释
类型: STRING   | 内容: '''这是三引号字符串'''
词法分析器清晰地区分了两者:一个是 COMMENT,另一个是常规的数据类型 STRING。
2. 语法树(AST)构建结果
接下来观察语法分析器构建的抽象语法树:
import ast

code_block = """
def demo():
    # 井号注释
    '''三引号文档'''
    '''内部裸字符串'''
    pass
"""

tree = ast.parse(code_block)
print(ast.dump(tree, indent=2))
解析得到的树形结构中:
# 井号注释完全没有出现在 AST 树的任何节点中。'''三引号文档'''和'''内部裸字符串'''都被解析成了完整的Expr(value=Constant(value='...'))节点。
3. 反汇编字节码对比
使用 dis 模块反编译包含两种符号的函数:
import dis

def func_with_comment():
    # 这里是计算前说明
    # 另一个注释
    return 42

def func_with_doc():
    """这是函数文档说明"""
    return 42

def func_with_orphan_string():
    """文档字符串"""
    '''中间的临时三引号说明'''
    return 42

print("=== func_with_comment 常量池 ===")
print(func_with_comment.__code__.co_consts)

print("\n=== func_with_doc 常量池 ===")
print(func_with_doc.__code__.co_consts)

print("\n=== func_with_orphan_string 字节码 ===")
dis.dis(func_with_orphan_string)
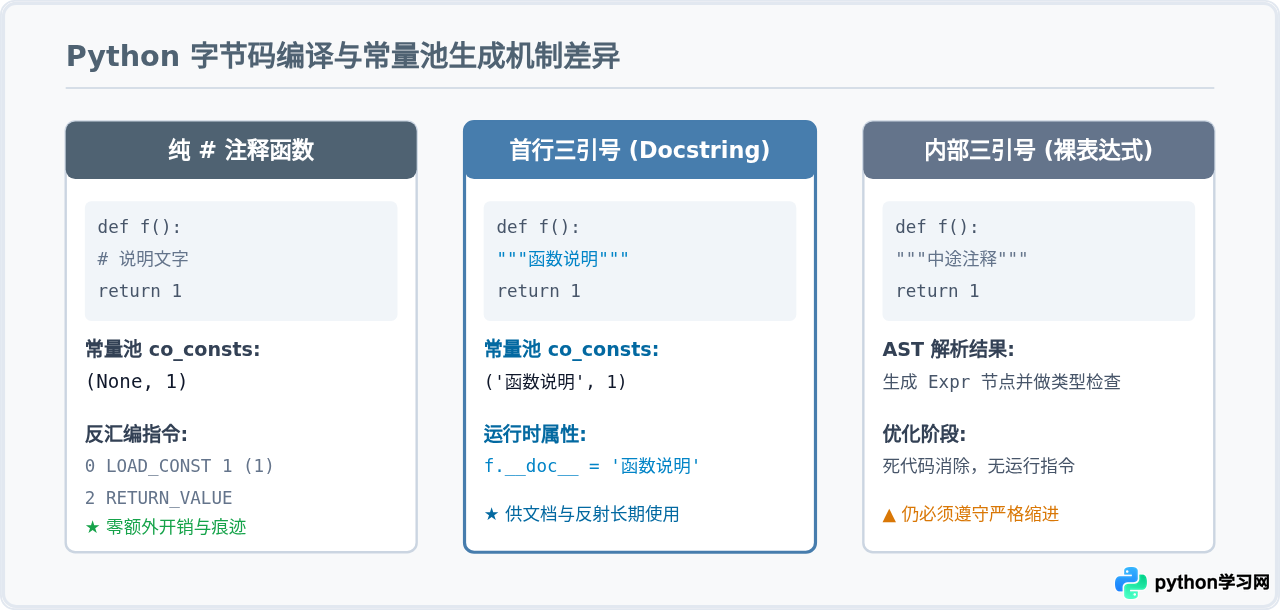
运行结果分析:
=== func_with_comment 常量池 ===
(None, 42)

=== func_with_doc 常量池 ===
('这是函数文档说明', 42)

=== func_with_orphan_string 字节码 ===
  7           0 LOAD_CONST               1 (42)
              2 RETURN_VALUE
通过字节码可以明确证实:
func_with_comment中完全没有保留注释内容,常量池仅有返回值和默认的None。func_with_doc的常量池co_consts第一个元素就是文档字符串,并在运行时被func_with_doc.__doc__引用。func_with_orphan_string内部的中间裸字符串在字节码中被优化掉了(没有产生多余指令),但依然经过了解析器的语法校验阶段。
四、为什么不能随意把三引号当多行注释用?
虽然将一段不需要的代码用三引号包裹起来能临时阻止其执行,但在实际工程开发中,随意将三引号作为普通注释使用会引入诸多严重问题:
陷阱一:破坏缩进规则引发 IndentationError
三引号字符串是合法的语句,它必须严格遵循当前代码块的缩进级别。如果随手将三引号顶格写在带缩进的代码块中,解析器在语法分析阶段就会直接报错终止:
def process_data(items):
    for item in items:
"""
这里临时顶格注释几行说明
"""
        print(item)
# 报错:IndentationError: unexpected indent相比之下,# 可以放在行首、行尾或任意缩进位置,解析器绝对不会因此报缩进错误。
陷阱二:字符串内部的转义与未闭合字符
如果注释的代码本身包含未匹配的单双引号、特殊反斜杠路径(如 Windows 文件路径 C:\new_folder 中的 \n)或结尾恰好有反斜杠,作为字符串字面量解析时会导致转义异常或 SyntaxError: (unicode error)。而 # 会让整行变成单纯的纯文本,内部任何符号均不参与转义。
陷阱三:覆盖真正的文档字符串
如果在类或函数定义的第一行随手用三引号写了一段“临时禁用的代码”,该段废弃代码就会直接成为该函数对外的 __doc__ 文档。这会导致自动化文档生成工具(如 Sphinx、pydoc)或者 IDE 的悬停提示抓取到错误的废弃代码,产生误导。
五、规范与选型:两者的正确使用场景
为了编写健壮且符合 PEP 8 规范的 Python 代码,建议遵循以下清晰的划分原则:
| 对比维度 | 井号注释 ( # ) | 三引号字符串 ( ''' / """ ) |
|---|---|---|
| 语法地位 | 语言规范唯一的官方注释 | 多行字符串字面量表达式 |
| 解析器行为 | 词法分析阶段直接丢弃,不生成 AST | 经过词法、语法解析,生成 AST 节点 |
| 运行时内存 | 完全为零 | 作为 docstring 时常驻内存;裸字符串参与解析 |
| 缩进与语法敏感度 | 极低,内容写任何错误语法均不报错 | 极高,必须遵守当前块缩进,内部转义需合法 |
| 适用标准场景 | 单行说明、行尾注释、临时禁用代码、内部逻辑拆解 | 模块/类/函数的规范文档(Docstring)、多行 SQL / 模板文本 |
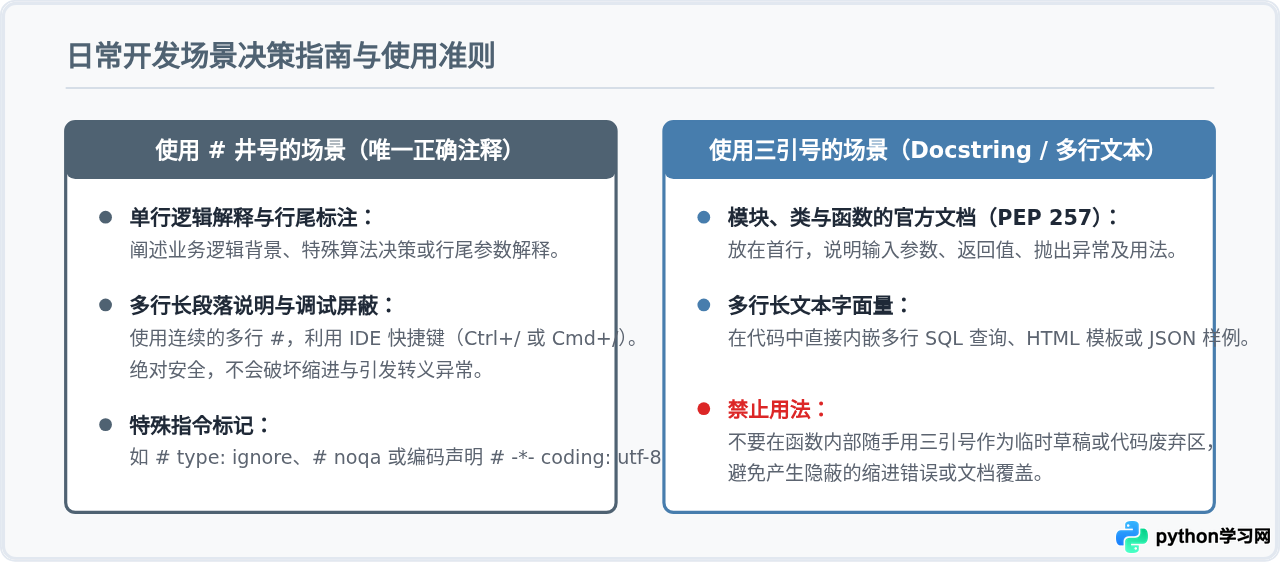
六、总结
回顾 Python 解析器的整个编译与运行流程:
#是语法树之外的无名英雄: 它仅存活于词法分析前线,用于向开发者解释代码逻辑,随后被完全抹除,具有最高的容错性和绝对的零开销。- 三引号是恪守语法的完整公民: 它是多行字符串数据,解析器必须为它分配 AST 节点并校验其缩进与格式。当且仅当位于定义首部时,它承担着文档载体的使命;在普通语句位置时,它只是一个被优化的表达式。
在日常编写 Python 代码时,面对多行需要注释说明的场景,请利用现代编辑器(如 VS Code、PyCharm)的批量注释快捷键(Ctrl + / 或 Cmd + /),生成整洁的连续 #;而将三引号严格保留给规范的 Docstring 和真实多行文本数据,从底层逻辑上写出稳健、规范的高质量 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









