

Kimi网页版隐藏技巧:提升对话效率的实用操作汇总
全面汇总Kimi网页版的实用操作与隐藏技巧,涵盖键盘快捷操作、长文档多文件精准交叉比对、联网检索信源过滤以及会话隔离管理,助你构建高效对话工作流。
很多用户在使用 Kimi 网页版时,往往习惯直接输入一两句口语化问题并等待回答。这种初级交互方式虽然简单,但在面对长篇专业研报、多份文件交叉比对或需要准确时效信息的场景下,极易遭遇回答空泛、关键数据被遗漏或多轮追问效率低下等困境。本文全面梳理 Kimi 网页版的交互控制、多文件精准交叉比对、结构化提示词排版、联网深度检索及会话隔离管理技巧,帮助你建立一套规范、可复用且高度可控的提问工作流。
一、输入框与交互控制:消灭误触与上下文污染
输入框是与大模型交互的第一道窗口。许多低效操作源于对网页端基本快捷逻辑和编辑机制的不熟悉:
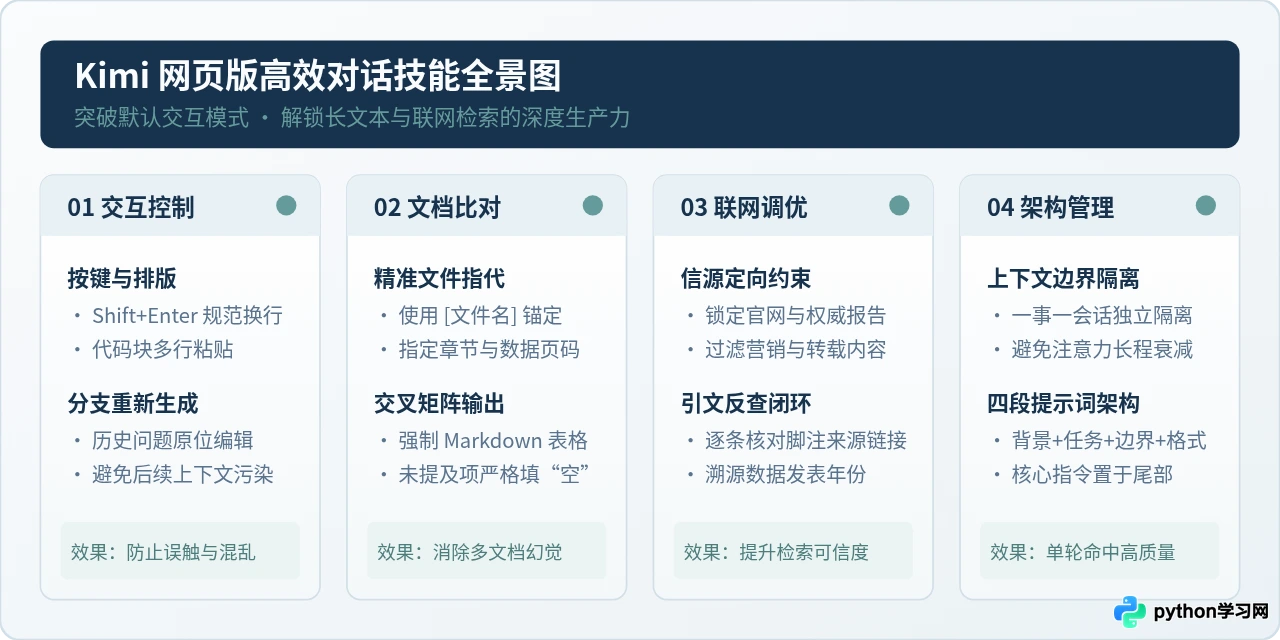
1. 换行与发送的分离习惯
在 Kimi 网页版中,直接按下 Enter 会立刻触发发送。如果你正在编写包含角色设定、多点要求的复杂提示词,一旦中途误按回车,模型便会接收到不完整的半截指令并开始生成,打断你的思路。养成使用 Shift + Enter 换行的肌肉记忆,或者在外部纯文本编辑器(如 VS Code、记事本)中整理好格式化文本后一次性粘贴进输入框,能够有效保证指令的完整性。
2. 多行文本与格式化块输入
向 Kimi 投喂代码片段、原始配置项或多段参考材料时,推荐在输入框中使用 Markdown 语法规范包裹。使用三个反引号(```)作为起止标记,能够让 Kimi 明确区分“背景资料”与“执行指令”,避免大模型将资料中的疑问句误判为用户当前提出的新问题。
3. 原位编辑与分支重试(规避对话污染)
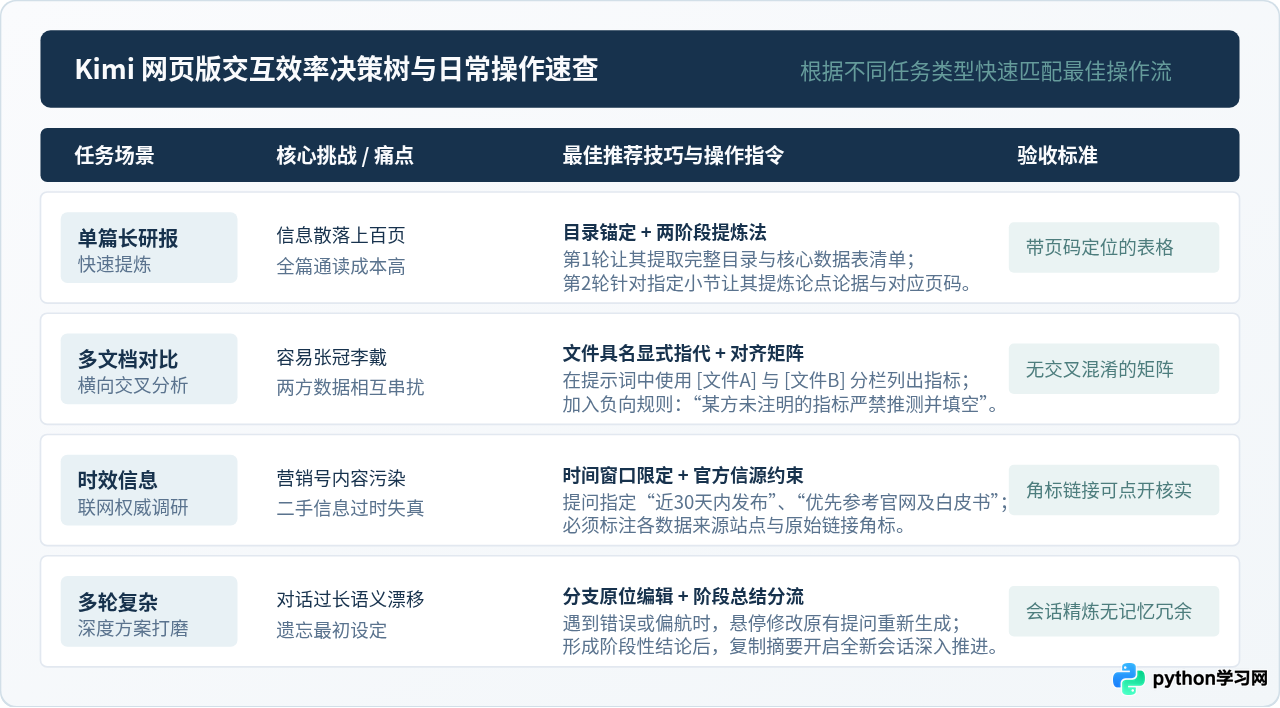
这是 Kimi 网页版最实用却常被忽视的高级功能之一。当模型对某个问题的理解出现偏差时,多数人的做法是在下方连续发送修正指令(例如“不是这个意思,我的意思是……”)。
这种做法会带来严重隐患:之前错误的问答记录仍然停留在会话上下文中,持续消耗 token,并在后续交互中对模型产生负向干扰(模型倾向于参考之前的错误上下文)。
二、多文档上传与交叉比对操作规范
Kimi 最大的核心优势之一是支持超长文本与多文档解析。但是,将多份 PDF、Word 或表格同时拖入窗口后,如果仅提问“对比这几份文件”,模型极容易在庞杂的内容中发生注意力分散,甚至将 A 公司的营收指标套用到 B 公司身上。
1. 步骤一:上传前规范命名
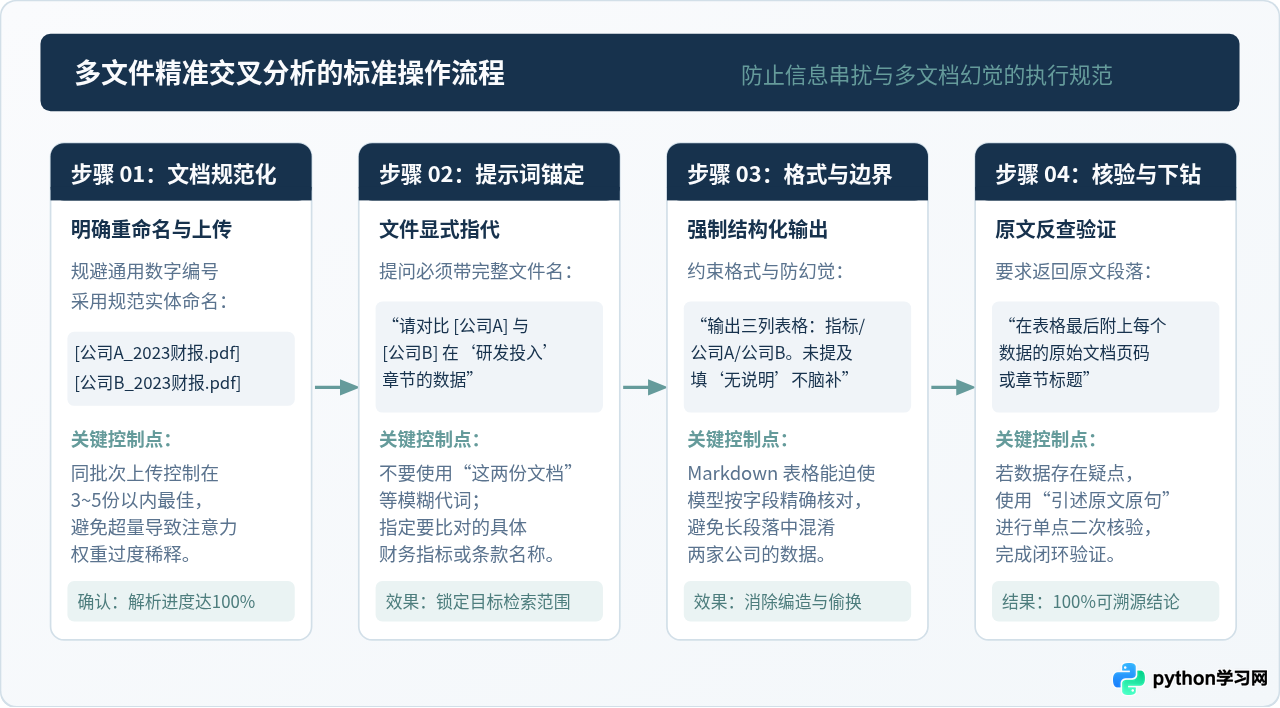
Kimi 在解析文件时,内部会记录文档的文件名作为实体标识。避免上传诸如 新建 文本文档(1).txt 或 未命名_2023.pdf 这种无意义名称。在上传前,将文件重命名为带有具体实体与属性的名称,例如 [公司A]_2023年度审计报告.pdf 和 [公司B]_2023年度审计报告.pdf。清晰的名称能成为提示词中无可替代的绝对引用锚点。
2. 步骤二:提示词中显式锚定文件名
在提问时,不要使用“这两份财报”或“上面的文件”等代词,而应在提示词中显式引用文件名:
请对比附件 [公司A_2023年度审计报告.pdf] 与 [公司B_2023年度审计报告.pdf]:
1. 分别提取两家公司在“营业收入”、“研发费用率”及“经营活动现金流净额”三项指标;
2. 指标数据仅限于 2023 完整会计年度;
3. 若某份文件中未明确公布某项数据,直接标注“未披露”,严禁推算。
3. 步骤三:强制输出表格与防幻觉约束
交叉比对务必强制要求使用 Markdown 表格输出。表格形式具有明确的行、列对应关系,能够倒逼大模型在逐个单元格填入数值时进行精确核验,最大限度遏制长篇段落叙述中可能出现的逻辑混淆与数值张冠李戴。
4. 步骤四:附带原始页码与段落复核
对于用于决策的严肃数据,在提示词末尾加上约束指令:“在表格最后一列附上对应数据的原始出处(文档页码或章节标题)”。利用 Kimi 返回的页码,读者可在几秒钟内快速定位原始 PDF 核验真伪,达成百分之百的可追溯性。
三、提示词工程:低效模糊提问 vs 结构化高效提问
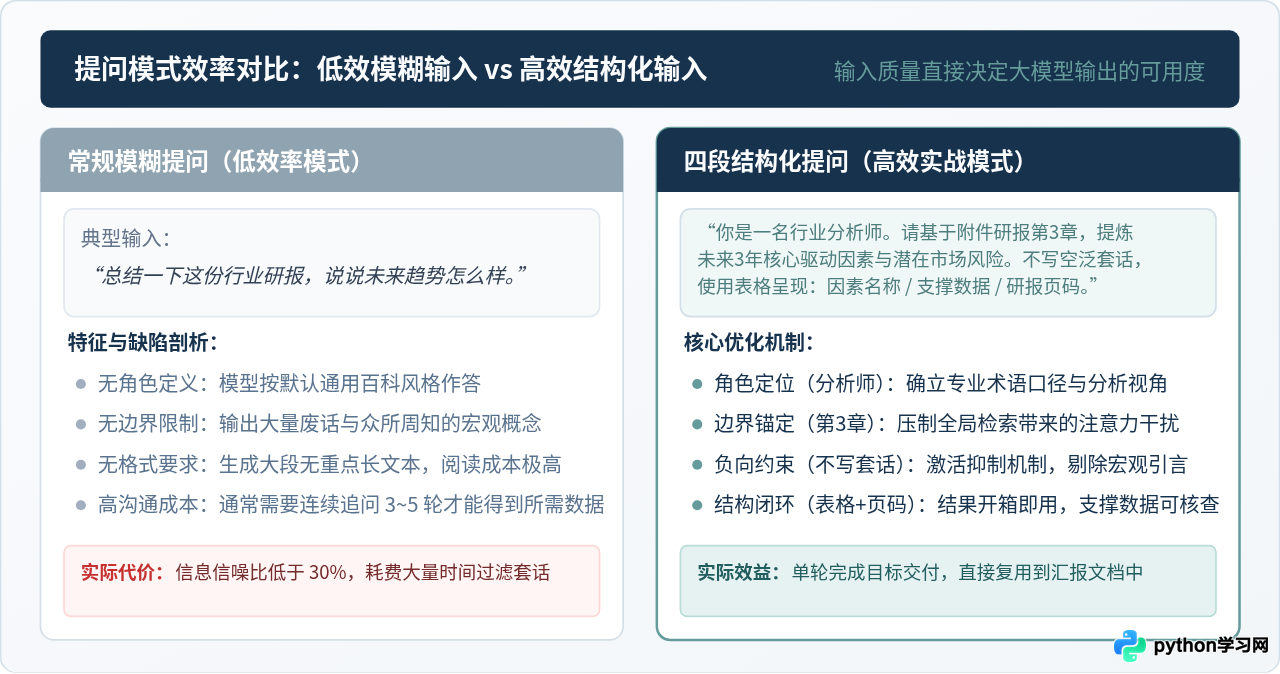
许多用户抱怨大模型回答“车轱辘话太多”、“缺乏实操性”,根本原因在于提问时没有给模型设定边界与结构。
1. 结构化四段提问法的核心逻辑
在专业任务中,建议严格采用“角色 + 背景 + 核心任务 + 约束与输出格式”的四段法构造提问:
- 角色定义(Role):设定专业身份(如“资深网络安全工程师”、“资深财报分析师”),快速锁定模型内部的专业术语口径;
- 背景范围(Context):限定输入资料或技术栈版本(如“基于附件第2章内容”、“基于 Python 3.11 及 FastAPI 框架”);
- 核心任务(Task):动词开头的具体动作(“列出排查步骤”、“提炼三种架构优缺点”);
- 约束与格式(Constraints & Format):排除废话(“直接输出执行命令,不写背景说明”、“以 Markdown 三列表格呈现”)。
2. 典型提示词模板演练
【角色】你是一名具备10年经验的数据库架构师。
【背景】我们需要对一个单表超过5000万行的 MySQL 8.0 订单表进行无锁在线加索引优化。
【任务】请给出基于 gh-ost 或 pt-online-schema-change 的完整实施方案与避坑清单。
【约束与格式】
1. 不输出任何关于数据库基础概念的科普段落;
2. 按“准备阶段 / 执行命令 / 状态监控 / 回滚策略”四个步骤分点说明;
3. 每个步骤给出明确的生产级命令参数与示例。
四、理解长上下文机制:避开“迷失在中间”现象
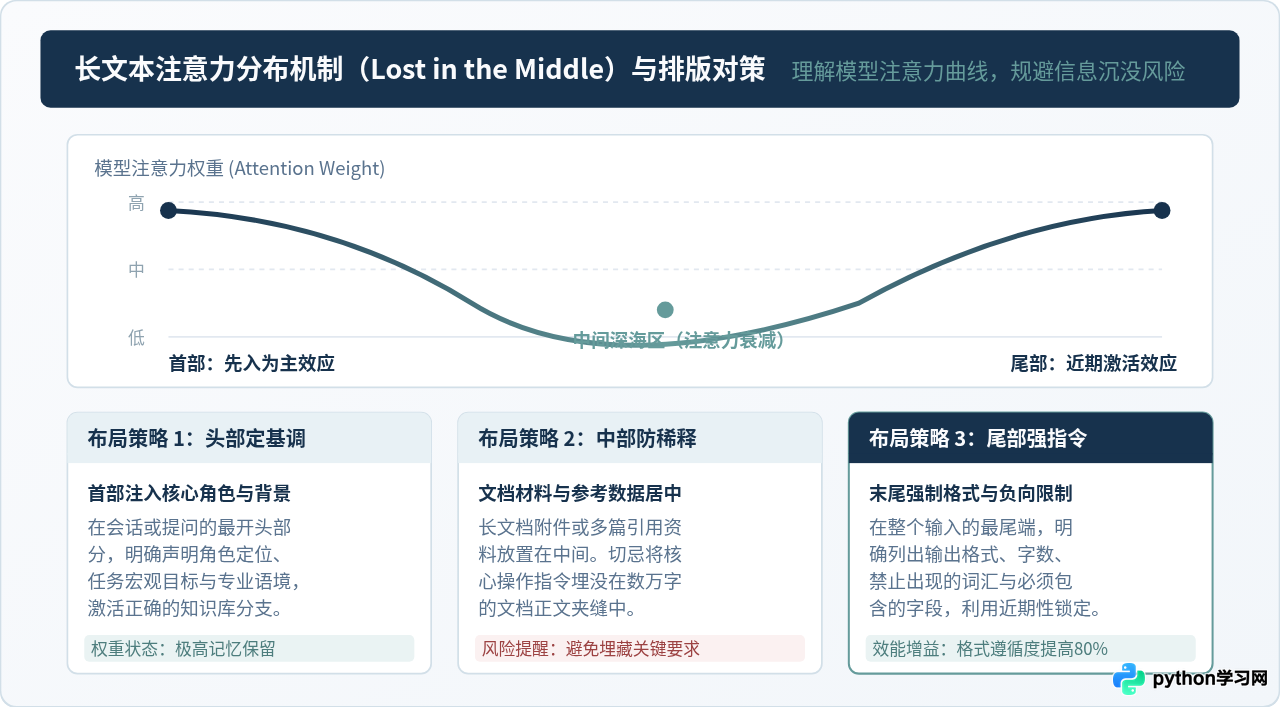
虽然 Kimi 支持长达数百万字的长上下文窗口,但在大语言模型底层注意力机制中,客观存在着学术界公认的 “Lost in the Middle(迷失在中间)” 现象。了解这一特性,是深度驾驭长文本的关键。
1. U 型注意力衰减的成因
大语言模型在计算自注意力权重时,处于输入序列最开头(首部)和最末尾(尾部)的内容会获得最充分的注意力分配(先入为主效应与近期激活效应)。
当用户一次性上传数十万字材料并将问题输入在最前或直接穿插在文档中间时,处于庞大文本“深海区”的指令很容易被稀释,导致模型漏答部分限定条件或忽略负向约束规则。
2. 针对性优化排版策略
- 核心规则置底:将最关键的格式约束、字数限制和负向规则(“不要写什么”)始终放在整段提问的最末尾,利用尾部注意力的近因效应强制模型执行;
- 长材料分段激活:对于超过 200 页的超大型手册,不要直接抛出“从头到尾找出所有关于安全配置的内容”。推荐采取“先大纲、后专题”的两阶段策略:第一阶段让 Kimi 提取出包含“安全”关键词的章节目录清单;第二阶段根据目录定位具体章节(如“请基于第4.2节到第4.5节深入展开”),以此将有效上下文压制在高注意力区间内。
五、联网搜索模式深度调优与信源核查技巧
Kimi 具备强大的实时联网检索能力,但在日常查询中,许多用户发现联网结果有时会混入自媒体营销号的洗稿内容。通过以下技巧可大幅提升联网检索的准确度:
1. 强制注入时效与权威信源限定词
大模型在触发网络搜索时,会先将用户的提问转化为内部搜索引擎的检索关键词。因此,在提问时主动加入时间窗口和信源级别词汇,能直接优化其底层的检索 Query:
- 限定时间区间:
“请检索 2024年下半年 发布的官方政策,忽略 2023 年之前的历史讨论”; - 指定信源层级:
“优先采纳工信部官网、国家统计局发布的数据或主流券商研究报告,过滤个人博客与营销号转载”; - 指定站点或专业术语:
“针对 Python 官方文档 docs.python.org 中的最新规范进行核对”。
2. 善用角标引用反查信源真实性
Kimi 在回答中给出的每一个上标数字编号,都对应着底层抓取到的原始网页卡片。高效的用法不是只看文字总结,而是针对关键结论或数字,点击角标查看对应的网页标题与发布日期,验证该网页是否为原始发布方,防止二手中转失真。
六、会话架构管理与长效使用建议
1. 一事一会话:严禁“全能无休止会话”
很多用户为了省事,在一个会话中连续提问:上午问行业研报,下午让其翻译合同,晚上又问编程报错。随着时间推移,该会话的历史 token 堆积如山,模型不仅响应变慢,还会将上午合同中的专有名词误带入晚上的代码场景中。保持“单一任务独立新建会话”是维持模型最高推理精度的最佳纪律。
2. 善用会话重命名与左侧边栏管理
Kimi 会根据第一轮提问自动生成会话名称,但往往不够直观。在完成一阶段工作后,及时点击左侧边栏会话项的“更多”菜单,将其重命名为标准格式,例如 [研报分析] A公司与B公司2023财报横向比对,便于日后随时回顾或继续追加分析,避免淹没在浩如烟海的历史列表中。
3. 阶段性摘要蒸馏法
当一个复杂项目需要进行 10 轮以上的深度推演时,在第 8 轮左右主动让 Kimi 执行:“请把截至目前我们达成的所有核心结论、参数设定及未解决事项,整理为一份 500 字以内的精炼备忘录”。随后将该备忘录复制到一个全新的空白会话作为初始设定,即可彻底甩掉前期沟通过程中产生的冗余对话包袱,实现上下文的高效复位。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









