

Python 2与Python 3的主要区别总结及迁移建议
深入总结Python 2与Python 3在字符编码、除法运算、内置迭代器及异常处理等方面的核心区别,并提供从依赖审查、自动化转换到深度运行时排错的完整迁移操作方案。
一、核心区别一:文本与二进制数据的分离机制
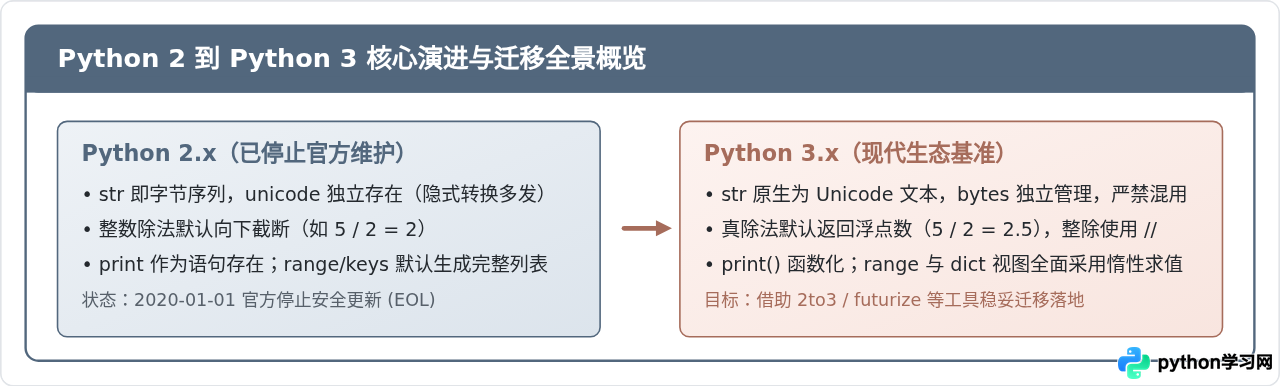
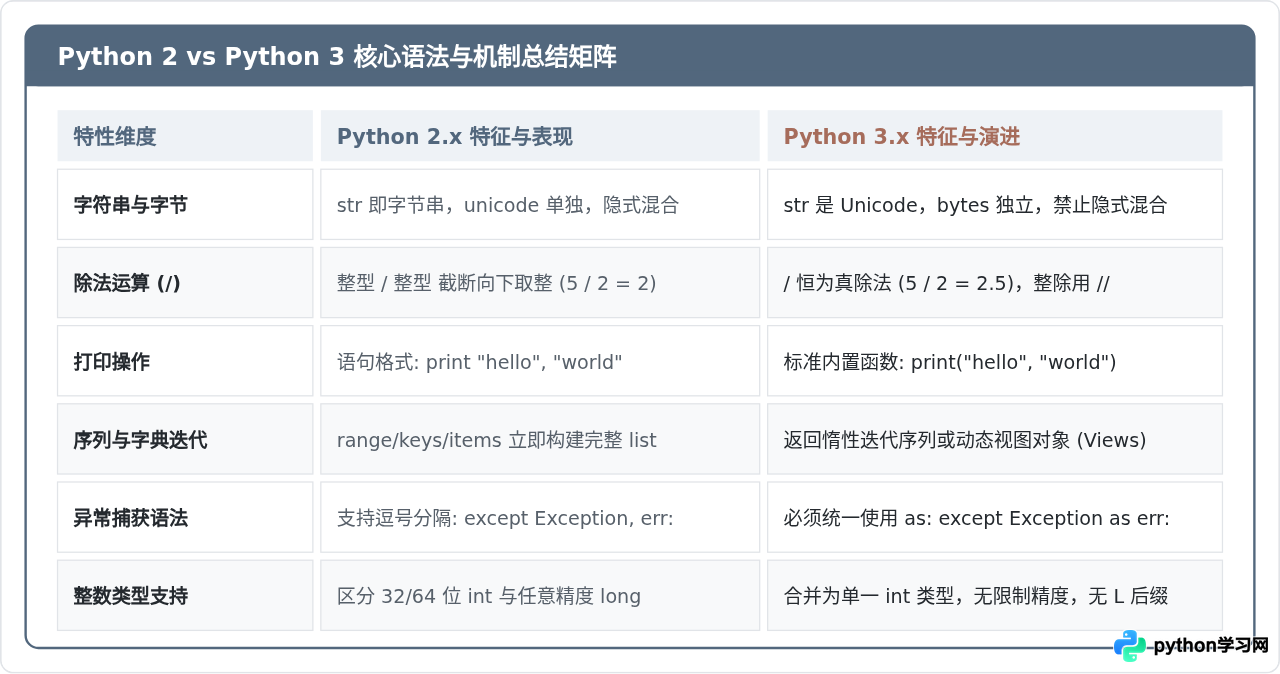
在许多开发者从 Python 2 切换到 Python 3 时,最常遭遇也是最隐蔽的运行时报错莫过于编码异常。在 Python 2 中,str 类型本质上是未经解码的 8 位字节序列(bytes),而 unicode 则是单独的一种类型。当开发者尝试对二者进行拼接或者比对时,解释器会悄悄使用默认的 ASCII 编码尝试隐式解码。只要字符串中包含非 ASCII 字符(例如中文),程序便会在运行时抛出知名的 UnicodeDecodeError: 'ascii' codec can't decode byte...。
Python 3 彻底重塑了这套模型:所有的 str 对象在内存中均为严格的 Unicode 字符序列,其源码文件默认以 UTF-8 编码解析;原本的字节序列则完全交由全新的 bytes 类型管理。在 Python 3 中,文本(str)和二进制数据(bytes)属于完全不兼容的类型,绝对不允许发生隐式转换或直接拼接。
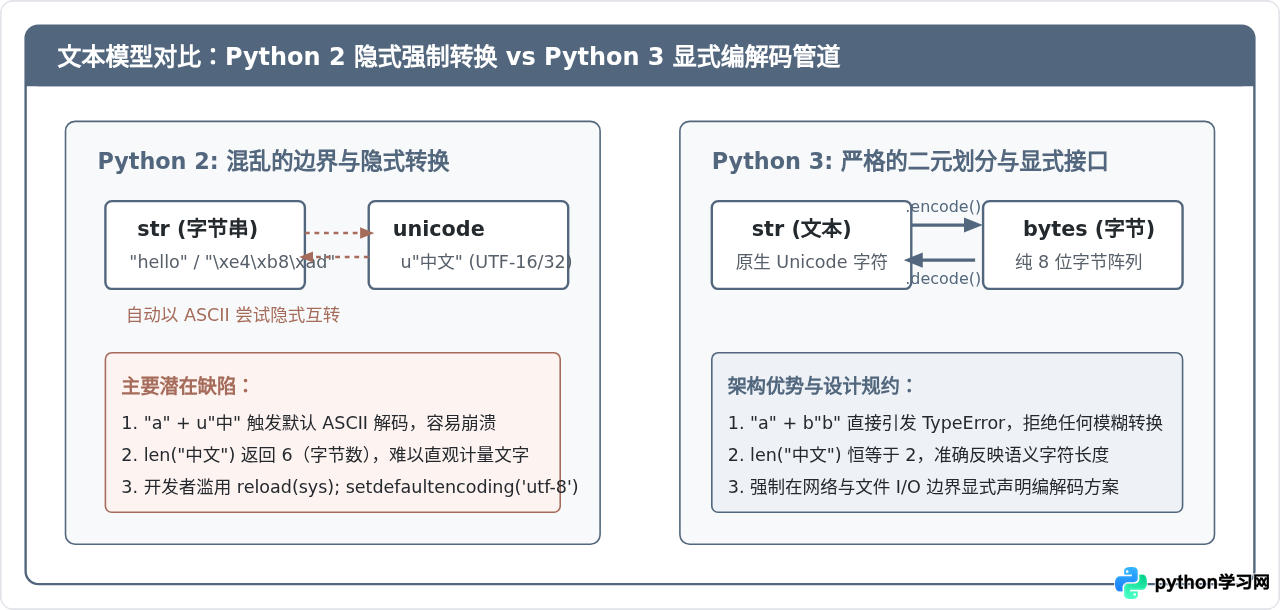
以下为文本与字节操作在具体运行时的对比示例:
# Python 2.7 环境
text_str = "中文"          # 实际为 UTF-8 编码的 str(字节流)
text_uni = u"编码"         # unicode 对象

# 隐式拼接尝试
print(text_str + text_uni)
# 输出报错示例:
# UnicodeDecodeError: 'ascii' codec can't decode byte 0xe4 in position 0: ordinal not in range(128)# Python 3.x 环境
text_str = "中文" # 默认就是 Unicode str
text_bytes = b"\xe4\xb8\xad\xe6\x96\x87"
# 文本拼接
combined = text_str + "编码" # 正常拼接,结果为 "中文编码"
# 文本与字节不能直接混合
# print(text_str + text_bytes) -> 立即抛出 TypeError: can only concatenate str (not "bytes") to str
# 正确做法:在边界显式解码或编码
decoded_text = text_str + text_bytes.decode("utf-8")
print(decoded_text) # 输出示例:中文中文二、核心区别二:数值计算与除法机制
另一个对业务逻辑具有实质影响的差异是除法操作符 / 的行为。在 Python 2 中,两个整数使用 / 进行除法运算时,遵循“向下取整”(Floor Division)规则。如果开发者期望获得精确的小数结果,必须将其中至少一个操作数显式转换为浮点数,或者在文件顶部引入 from __future__ import division。
Python 3 修正了这一不符合数学直觉的隐患。在 Python 3 中,单个斜杠 / 始终被定义为“真除法”(True Division),其返回值固定为浮点数;如果程序确实需要整数取整除法,则必须显式使用双斜杠 //。
# Python 2 环境
result = 5 / 2
print result
# 输出示例:2

# Python 3 环境
result_true = 5 / 2
result_floor = 5 // 2
print(result_true)   # 输出示例:2.5
print(result_floor)  # 输出示例:2
与此同时,Python 2 曾经将整数划分为 32/64 位机器字长的 int 和任意精度的长整型 long,长整型在字面值展示时带有明显的 L 后缀。而在 Python 3 中,long 类型被彻底移除,单一的 int 类型自身便支持任意精度,消除了数据类型切换所带来的细微差异。
三、核心区别三:语法规则与内置函数更新
除了底层数据模型的更迭,日常编写中频率最高的语法和内置 API 同样迎来了规范化调整:
-
print 从语句变为内置函数:在 Python 2 中,
print "hello"是类似关键字的语句;而在 Python 3 中,print("hello")成为了标准的内置函数。这使得print能够支持诸如end=""、file=f等关键字参数,也能作为一等公民(First-class citizen)被传入高阶函数。 -
字典与序列的惰性求值:在 Python 2 中,
range(1000000)、dict.keys()、dict.values()均会立即在内存中构建完整的list,对大内存场景极不友好。Python 3 中移除了xrange,由range()原生替代并返回按需生成的迭代对象;dict.keys()等方法则返回动态视图(Dictionary Views)。 - 循环变量的作用域泄露:在 Python 2 中,列表推导式内部定义的循环变量会泄露至外部局部作用域,容易意外覆盖同名变量。Python 3 赋予列表推导式独立的局部作用域,彻底根除了变量污染。
-
异常语法规范化:捕获异常时,Python 2 允许使用逗号分隔符:
except Exception, e;Python 3 强制必须使用as关键字:except Exception as e。
四、代码迁移工程建议与实施流程
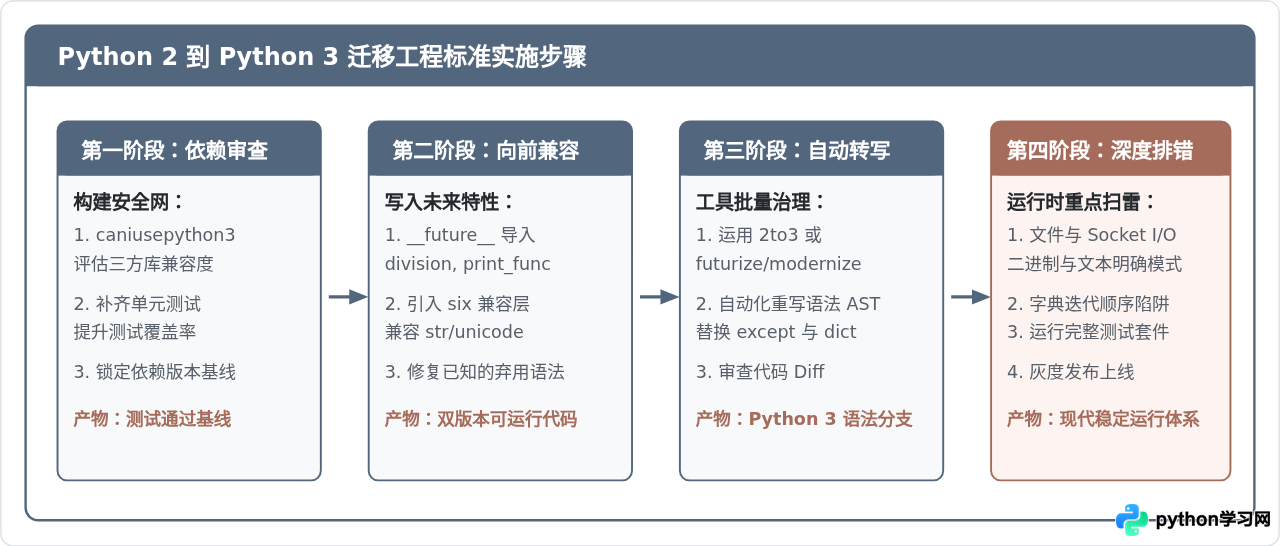
将现有 Python 2 代码平稳过渡到 Python 3 并不是简单地批量替换 print 那么容易。盲目改写往往会引入大量只有在特定数据流入时才会触发的隐藏 Bug。推荐遵循以下经过工业界验证的四阶段迁移路径:
1. 依赖项审查与测试安全网
在修改任何代码之前,必须先审查项目现有的三方依赖包是否均已支持 Python 3。可以使用官方推荐的检查工具 caniusepython3:
# 安装并检查当前 requirements.txt 文件的兼容性
pip install caniusepython3
caniusepython3 -r requirements.txt

# 示例提示输出:
# Finding and checking dependencies...
# All required packages already support Python 3!
如果部分内部自建库或旧包无维护版本,必须先寻找替代品或自行完成分模块移植。同时,健全的自动化单元测试是整个迁移工程的最高保障。没有足够测试覆盖率支撑的代码库,不应盲目开展全局自动化转换。
2. 编写向前兼容的双版本代码
对于规模较大、无法一次性停机切换的系统,可以通过在现存 Python 2 代码中引入未来模块,使代码行为向 Python 3 靠拢:
# 在所有 Python 2 代码文件首行添加
from __future__ import absolute_import, division, print_function, unicode_literals
import six

# 使用 six 抹平类型判定与模块位置差异
if isinstance(data, six.text_type):
    # 处理 Unicode 字符串
    pass
elif isinstance(data, six.binary_type):
    # 处理纯字节流
    pass
3. 使用自动化转写工具(2to3 与 python-futurize)
Python 官方自带的 2to3 能够解析 Python 2 源代码并将其转换为合法的 Python 3 代码。如果希望在过渡期保持 2 与 3 同时兼容运行,更推荐使用 futurize(基于 python-future):
# 方案 A: 直接转换为纯 Python 3 代码 (2to3)
# 预览代码改动 Diff
2to3 my_project/

# 写入修改并生成备份
2to3 -w my_project/

# 方案 B: 采用渐进式双版本兼容转写 (futurize)
# Stage 1: 安全修复现代 Python 2 语法(如 print 函数化、捕获异常 as 等)
futurize --stage1 -w my_project/*.py

# Stage 2: 引入 future/six 垫片,实现跨版本完全兼容
futurize --stage2 -w my_project/*.py
五、深度排错:工具无法自动解决的运行时陷阱
自动化工具能够解决约 80% 的表面语法变更,但剩余 20% 涉及逻辑语义的细节必须由工程师人工排查与修正。
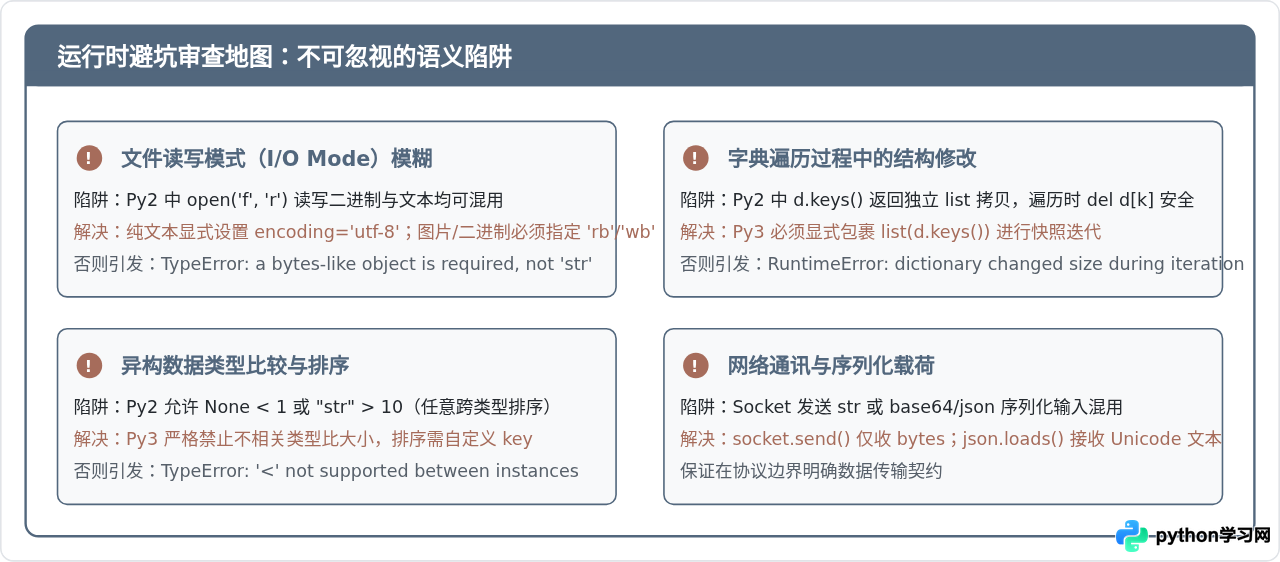
在 Python 2 代码中,大量读写文件的语句使用默认的 open("data.bin", "r") 甚至 open("text.txt", "r") 均能正常运转。但在 Python 3 中:
- 读取文本文件时,强烈建议指定编码:
open("text.txt", "r", encoding="utf-8"),以避免不同操作系统默认编码差异(如 Windows 下的 GBK)造成读取乱码。 - 读取二进制流(如协议报文、图像、压缩包)时,必须明确使用
"rb"/"wb",否则将直接遭遇字节类型与字符串不兼容的错误。
常见迁移错误与快速对照表
| 典型异常报错 (Python 3) | 根本产生原因 | 修复方案 |
|---|---|---|
TypeError: can't concat str to bytes |
在 socket 或文本处理中直接拼接了字符串与二进制数据 | 调用 .encode('utf-8') 或 .decode('utf-8') 在边界统一类型 |
TypeError: unsupported operand type(s) for /: 'int' and 'int' |
在需要整型索引处(如 range(len/2))使用了 / 导致返回 float |
将单斜杠除法改为取整除法 //,或用 int() 显式转换 |
AttributeError: 'dict_keys' object has no attribute 'sort' |
对 dict.keys() 直接调用了列表方法 |
使用 sorted(dict.keys()) 或显式转换为列表 list(dict.keys()) |
TypeError: '<' not supported between instances of 'str' and 'int' |
列表中混杂不同数据类型并直接执行了 .sort() |
规范数据清洗流程,或为排序函数指定统一的 key 转换逻辑 |
六、总结
Python 2 转向 Python 3 不是一次单纯的语法翻新,而是 Python 走向现代化、高内聚和严谨类型语义的必然选择。告别模糊的字节隐式转换,拥抱明确的 Unicode 文本规范和高效的惰性求值,使 Python 代码能够更可靠地运行在大规模分布式网络与数据处理场景中。
在实际项目推进中,切忌在缺乏测试防护的情况下进行一刀切重写。推荐遵循“评估依赖库 → 补充测试套件 → 工具辅助转写 → 攻坚字节与 I/O 陷阱 → 灰度验证”的工程闭环,从而以最小的维护成本和风险平稳完成现代化迁移。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









