

Python基础语法详解:变量、数据类型与控制流
深入详解Python核心基础语法,涵盖变量声明与引用本质、不可变与可变数据类型对比、条件判断分支以及for/while控制流执行机制,附带直观内联图解与排错避坑建议。
一、变量本质与内存引用机制
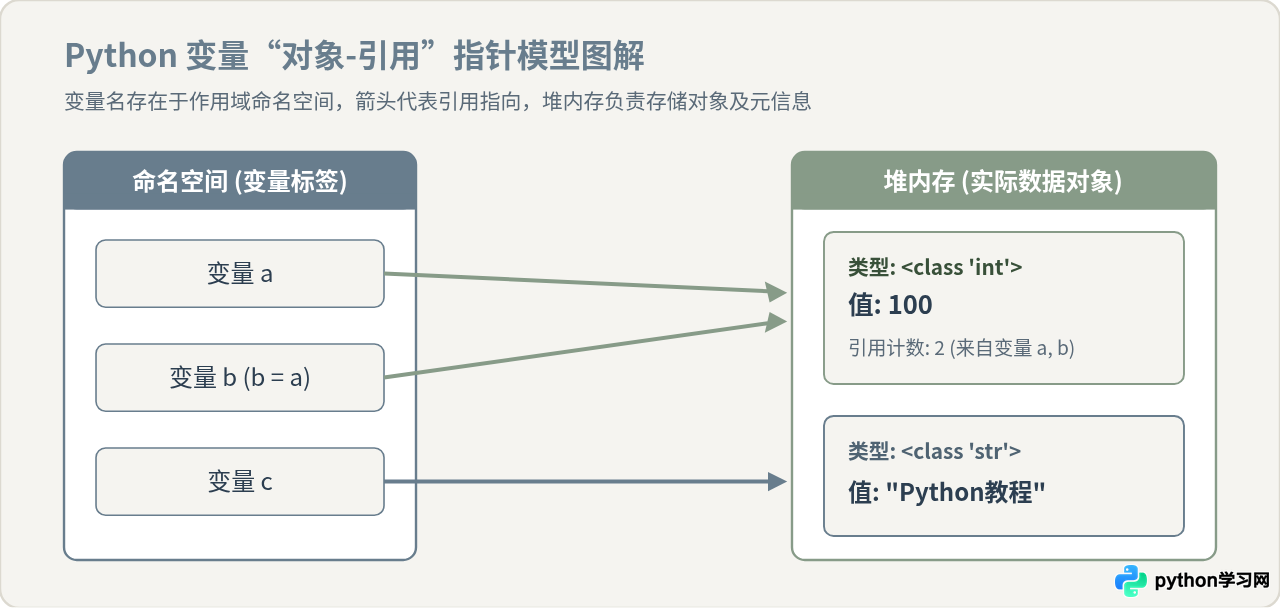
在许多编译型语言(如 C 或 Java)中,定义变量意味着向系统申请一块固定大小的内存空间,变量名与该内存格子紧密绑定。而在 Python 中,一切皆对象。变量名本身并不分配实际内存来装载数据,它本质上是一个指向内存堆中具体对象的“引用指针”或“标签”。
1. 变量赋值与绑定过程
当执行赋值语句 x = 100 时,Python 解释器在底层执行两步动作:首先在内存堆中创建整型对象 100;随后在当前命名空间中创建变量名 x,并将 x 指向该整型对象。若接着执行 y = x,并非复制了一份数值 100,而是让 y 同样指向同一个 100 对象。
# 引用与对象查看
a = 100
b = a

print(f"a 的内存地址: {id(a)}")
print(f"b 的内存地址: {id(b)}")
print(f"a 与 b 是否指向同一对象: {a is b}")  # 输出: True

# 重新给 a 赋值
a = 200
print(f"重新赋值后 a 的内存地址: {id(a)}")
print(f"此时 b 的值仍为: {b}") # 输出: 100a = 200 并没有把原来存放 100 的内存修改为 200,而是新建了整型对象 200,并将标签 a 重新贴到新对象上。原对象 100 因仍被 b 引用,并不会被垃圾回收。
二、核心数据类型与可变性本质对比
Python 具备动态强类型的特性:动态意味着变量不需要提前显式声明类型,运行时根据所指对象动态推断;强类型意味着解释器不会隐式发生不合理的类型强制转换(例如字符串 "10" 与整数 5 进行 + 加法会直接抛出 TypeError)。
1. 常见基础数据类型一览
- 整型 (int) 与 浮点型 (float):用于数学计算,Python 3 中整型支持任意精度,不会产生整型溢出。
- 布尔型 (bool):仅包含
True和False,本质是int的子类(1 和 0)。 - 字符串 (str):单引号或双引号括起的字符序列,支持负索引与切片操作。
- 列表 (list):使用方括号
[]包装的有序元素序列,支持灵活插入与删除。 - 元组 (tuple):使用圆括号
()包装的不可变序列,常用于保护数据结构不被意外篡改。 - 字典 (dict):使用大括号
{key: value}组织的键值对结构,基于哈希表实现极速查找。 - 集合 (set):无序且不重复的元素集,常用作去重与并集/交集计算。
2. 核心差异深度对比:不可变类型 vs 可变类型
理解 Python 数据类型最核心的界限是对象的可变性(Mutability)。不同类型的对象在内存中应对变更时的表现截然不同:
| 对比维度 | 不可变类型 (int, float, str, tuple) | 可变类型 (list, dict, set) |
|---|---|---|
| 内存变更机制 | 一旦分配无法在原内存地址修改,变更操作必产生新对象 | 支持“就地修改”(In-place modification),内存地址保持不变 |
| 多变量共享引用表现 | 修改其中一个变量,仅改变其引用指向,不影响其他变量 | 通过一个变量更新内容,所有指向该对象的变量均能看到变动 |
| 是否可作为字典的 Key | 可以(具有稳定哈希值 __hash__) |
不可以(哈希值随内容变动,抛出 TypeError: unhashable type) |
| 典型操作与函数传参影响 | 在函数内部赋值不会影响外部实参 | 在函数内直接调用 append() 或修改字段会直接影响外层实参 |
# 演示 1:不可变类型的变更效果
num = 10
old_id = id(num)
num += 1
print(f"num 变更前后内存是否相同: {id(num) == old_id}") # False,生成了新对象

# 演示 2:可变类型的就地更新与副作用
list_a = [1, 2, 3]
list_b = list_a  # 共享同一个列表对象
list_b.append(4)
print(f"list_a 的内容受波及: {list_a}")                  # 输出: [1, 2, 3, 4]
print(f"两个列表地址一致: {list_a is list_b}")          # 输出: True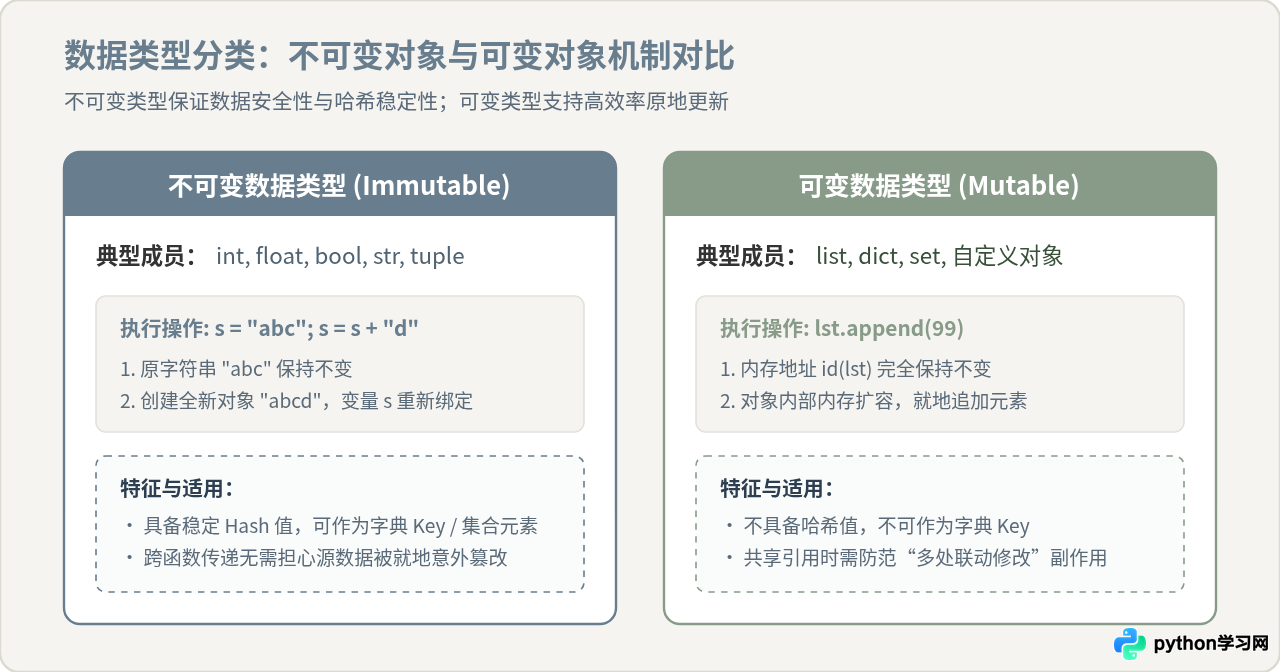
三、条件判断与分支控制
Python 使用严格的代码缩进(通常是 4 个空格)来确定代码块的作用域。条件判断语句通过 if、elif 和 else 来控制程序流向。
1. 条件判断的基本结构与短路逻辑
所有分支条件都会进行真值测试(Truth Value Testing)。在 Python 中,不仅布尔值 True / False 可以作为判断依据,以下值在条件判断中均被视作假(Falsy):None、数值 0 / 0.0、空字符串 ""、空列表 []、空元组 () 以及空字典 {}。
score = 85

if score >= 90:
    grade = "A"
elif score >= 80:
    grade = "B"
elif score >= 60:
    grade = "C"
else:
    grade = "D"

print(f"评估结果等级为: {grade}")  # 输出: B

# 短路求值特性 (Short-circuit Evaluation)
# 当第一个条件为真时,or 不会执行后续表达式;当第一个为假时,and 不会执行后续表达式
def check():
    print("触发了函数计算")
    return True

result = True or check()   # check() 不会被调用
四、循环结构与控制流跳转
Python 提供了两种主要循环结构:for...in 迭代循环和 while 条件循环。配合 break、continue 以及 Python 独有的 else 子句,可以构建清晰可控的循环逻辑。
1. for 与 while 的场景选型
- for 循环:用于遍历已知的“可迭代对象”(如列表、字符串、字典、生成器或
range()生成的序列),是 Python 编程中推荐的默认循环方式。 - while 循环:用于循环次数未知、依赖动态外部状态(如网络轮询、用户交互、等待锁释放)的场景。
2. break、continue 与循环 else 语句
在循环内部,continue 用于立即跳过当前轮次的剩余语句,直接开始下一轮迭代;break 则立即强行退出整个循环。
循环 else 子句:很多人误以为这里的 else 与 if-else 类似,实际上,只有在循环自然执行完毕、没有被 break 提前中断时,else 代码块才会执行。这在实现元素查找逻辑时尤为优雅,避免了额外维护 found = False 标记变量。
# 场景:检测列表中是否存在目标负数
numbers = [12, 45, 23, -5, 88]

for num in numbers:
    if num < 0:
        print(f"找到负数: {num},立即提前终止!")
        break
else:
    print("序列中不存在任何负数")

# 若列表中无负数,则 break 不触发,直接进入 else 分支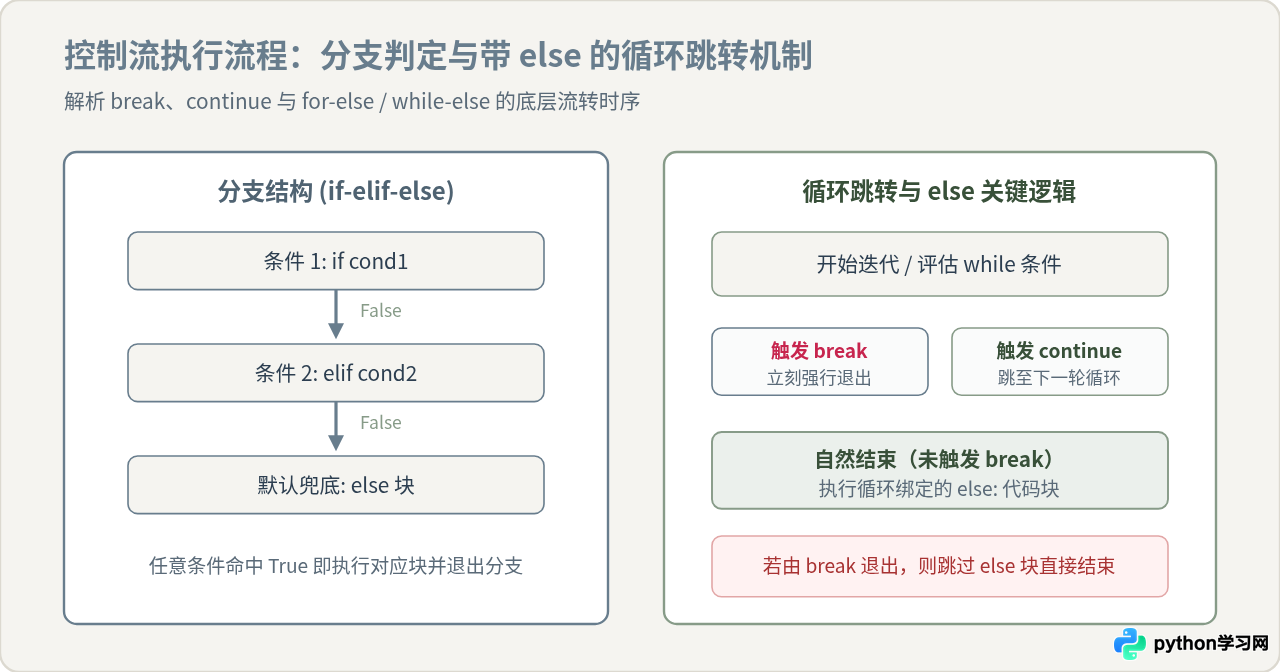
五、基础语法三大高频隐蔽陷阱与排查实践
在日常开发中,初学者常常因混淆赋值机制、可变性与作用域而陷入调试困境。以下是三个最经典的语法陷阱及修正手段:
1. 函数默认参数使用可变对象(Mutable Default Arguments)
错误表现:Python 中的函数定义是可执行语句,默认参数在函数定义时即完成求值,并在所有调用之间共享同一个对象实例。
# 陷阱写法:列表在多次调用中持续累积
def add_item(item, target_list=[]):
    target_list.append(item)
    return target_list

print(add_item("苹果"))  # 输出: ['苹果']
print(add_item("香蕉"))  # 输出: ['苹果', '香蕉'] (预期是只包含香蕉)

# 正确做法:使用不可变对象 None 作为默认哨兵值
def add_item_safe(item, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(item)
    return target_list
2. 循环遍历中直接修改正在遍历的列表
错误表现:在 for item in my_list: 遍历的同时执行 my_list.remove(item) 或 del。列表在内部是连续内存数组,删除元素会导致后续元素索引向前平移,造成部分元素被意外跳过。
# 陷阱:元素被漏删
nums = [1, 2, 2, 3]
for n in nums:
    if n == 2:
        nums.remove(n)
print(nums)  # 仍然残留一个 2: [1, 2, 3]

# 正确做法:使用列表推导式生成新列表,或遍历原列表切片浅拷贝 nums[:]
nums = [n for n in nums if n != 2]
print(nums)  # 正确输出: [1, 3]
3. 链式赋值创建嵌套可变列表
错误表现:使用 matrix = [[0] * 3] * 3 创建二维矩阵。此时乘号只是把内层列表的引用复制了 3 份,导致修改某一行时其他行同时变动。
# 陷阱写法
matrix = [[0] * 3] * 3
matrix[0][0] = 99
print(matrix) # 输出: [[99, 0, 0], [99, 0, 0], [99, 0, 0]]

# 正确做法:使用列表推导式在每轮循环创建独立内层列表
matrix_correct = [[0] * 3 for _ in range(3)]
matrix_correct[0][0] = 99
print(matrix_correct) # 正确输出: [[99, 0, 0], [0, 0, 0], [0, 0, 0]]
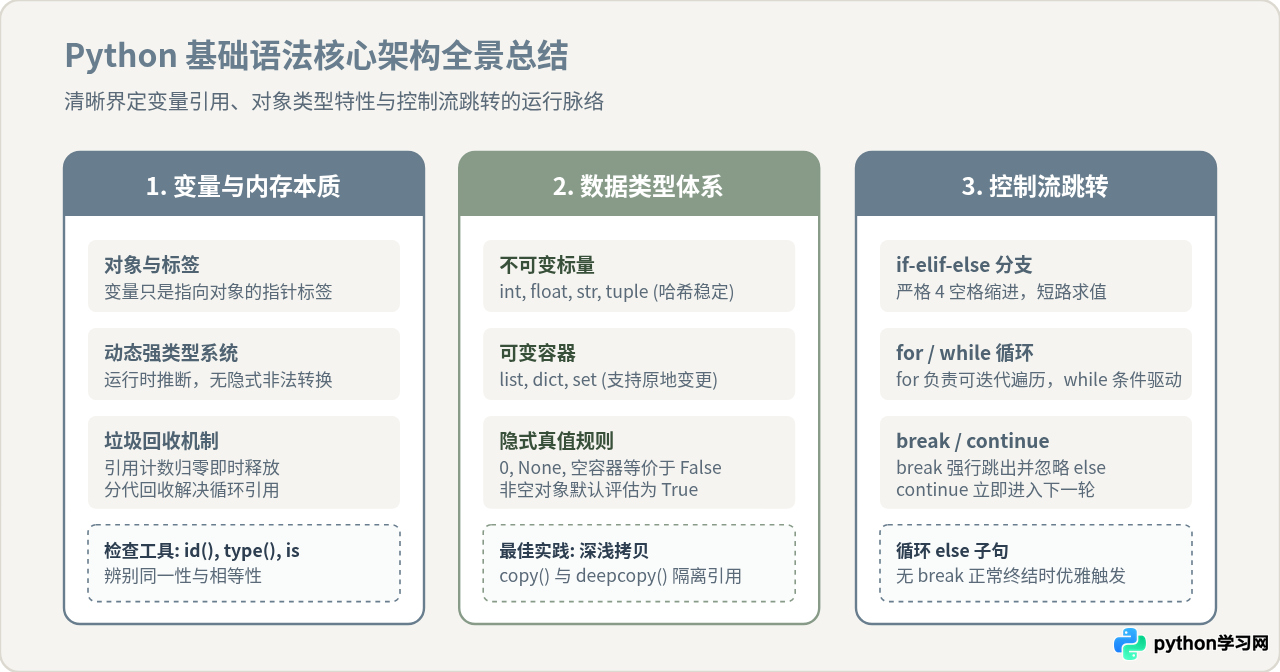
六、Python 基础语法核心全景梳理
回顾 Python 基础语法体系,变量、数据类型与控制流构成了编程能力的三大支柱。以下全景图概括了这三大板块的核心概念与关键连接点,便于在实际编码时快速查阅与对齐规则。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









