

Python内置函数手册清单:从print到len的定义与示例
一份系统的Python内置函数手册清单,重点解析从print到len等高频内置函数的官方定义、底层原理、典型代码示例与实战注意事项。
import导入任何模块,开发者即可在任意代码位置直接调用它们。本文聚焦于初学者与中级开发者最高频使用的内置函数集合,以最典型的输出函数print()和度量函数len()为首尾坐标,完整梳理作用域查找机制、核心函数定义、真实执行示例与容易踩坑的边界条件。
一、Python内置函数的命名空间与查找机制
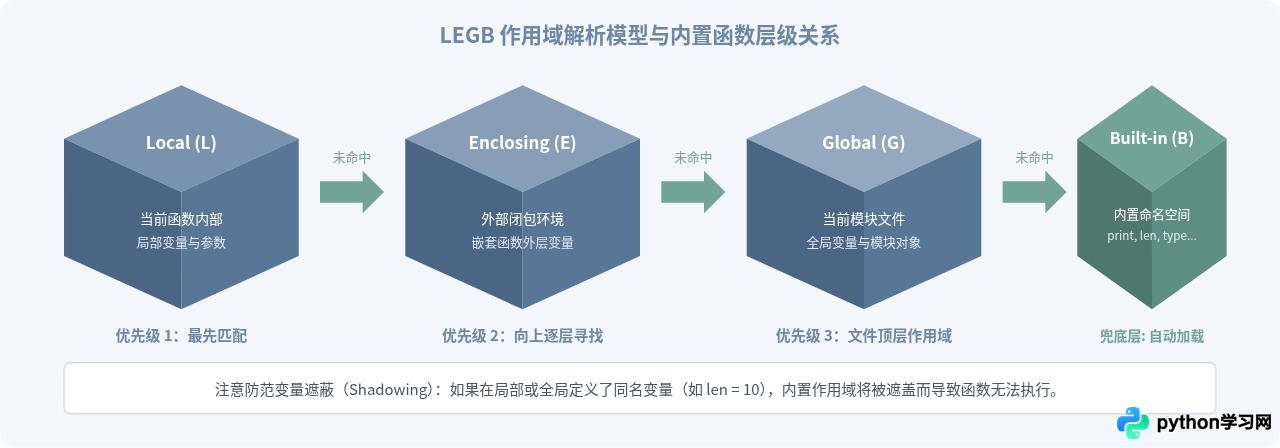
Python之所以能让我们随时随地调用print()或len(),是因为它具备一套严密的命名空间层次。在Python执行任意变量或函数查找时,遵循经典的LEGB法则:本地作用域(Local) → 嵌套作用域(Enclosing) → 全局作用域(Global) → 内置作用域(Built-in)。
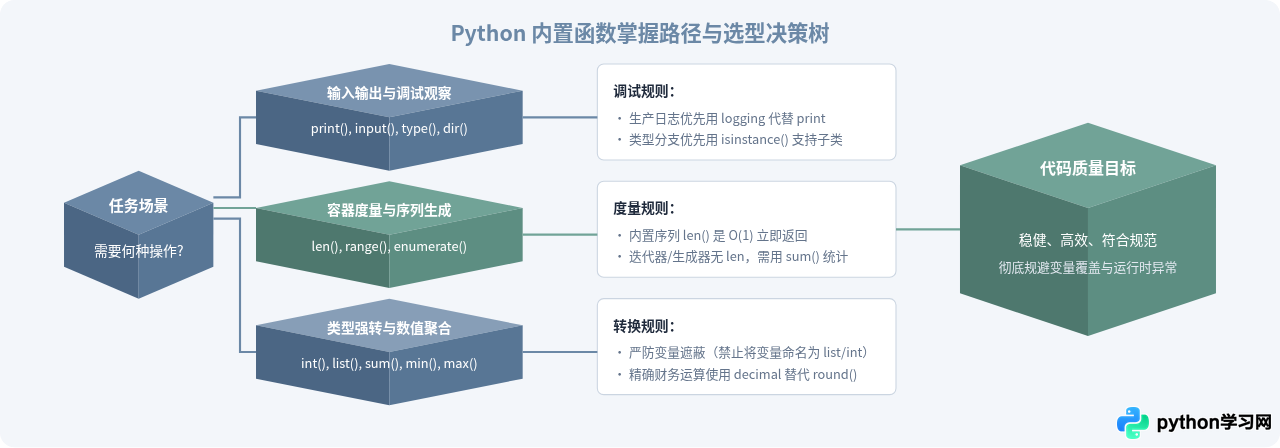
内置函数位于作用域的最顶层(即底层兜底层)。这意味着如果在局部或全局命名空间中定义了一个同名变量(例如赋值len = 5),根据LEGB查找规则,局部/全局的定义会先被命中,从而“遮蔽(Shadowing)”掉内置函数,导致后续调用引发TypeError: 'int' object is not callable异常。
二、核心函数清单与详细定义
Python 3.x 官方提供了近 70 个内置函数。在日常编程与项目构建中,以下一组覆盖输入输出、类型检测、数值计算和容器度量的核心函数构成了最高频的使用矩阵。
print(*objects, sep=' ', end='\n', file=sys.stdout, flush=False) I/O 输出
官方定义:将一个或多个对象输出到指定的文本流文件中,默认输出流为系统标准输出 sys.stdout。各个对象之间使用 sep 字符串分割,末尾追加 end 字符串。若 flush=True,则强制刷新缓冲区。
典型示例:
# 基础输出与分隔符定制
print("Python", "Rust", "Go", sep=" | ")
# 输出示例: Python | Rust | Go

# 抑制换行并进行进度输出
import time
for i in range(3):
    print(f"\r处理进度: {i+1}/3", end="", flush=True)
    time.sleep(0.1)
print() # 换行收尾flush=True,否则文本可能滞留在缓冲区无法实时呈现在终端界面上。
input([prompt]) I/O 输入
官方定义:如果存在 prompt 实参,则将其写入标准输出且不带换行。随后函数从标准输入中读取一行文本,将其转换为字符串(剥除行末换行符)并返回给调用者。若读取到 EOF,则抛出 EOFError。
典型示例:
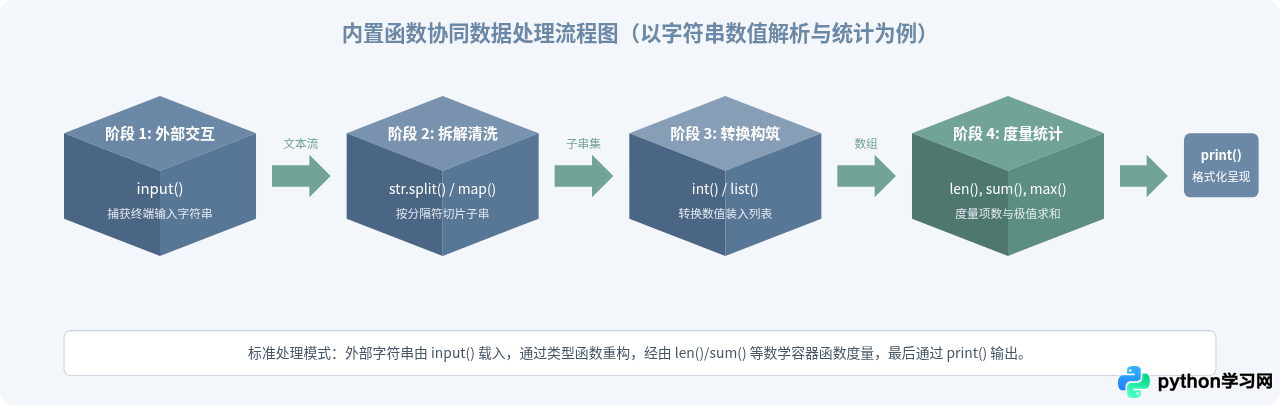
raw_input_val = input("请输入待处理的数值: ")
# input() 恒返回 str 类型,数学计算必须主动进行类型转换
parsed_num = int(raw_input_val)
print("计算平方:", parsed_num ** 2)input() 永远返回 str(字符串)类型,绝对不会像 Python 2 的 input() 那样自动进行 eval 执行。数值运算前必须通过 int() 或 float() 显式转换。
type(object) 与 isinstance(object, classinfo) 类型与反射
官方定义:type(object) 返回对象的所属类型(其实际类对象)。isinstance(object, classinfo) 判断对象是否为指定类(或其子类、元组中包含的类)的实例。
典型示例:
class Animal: pass
class Dog(Animal): pass

d = Dog()

# 使用 type 进行严格类型比较(不考虑继承关系)
print(type(d) is Dog)     # 输出示例: True
print(type(d) is Animal)  # 输出示例: False

# 使用 isinstance 进行鸭子类型/多态兼容检查(推荐)
print(isinstance(d, Animal))          # 输出示例: True
print(isinstance(10, (int, float))) # 输出示例: True (支持元组多选匹配)isinstance() 而非 type() == ...,因为前者能够正确处理面向对象的子类继承关系。
range(stop) 或 range(start, stop[, step]) 不可变序列
官方定义:生成一个不可变的等差数字序列。range 并不是一个纯函数,而是一种不可变的序列类型(Sequence Type)。它具有惰性求值特性,仅在被迭代时计算数值,内存占用恒定($O(1)$ 空间复杂度)。
典型示例:
# range 是惰性对象,直接打印不会展开
r = range(0, 10, 2)
print(r)             # 输出示例: range(0, 10, 2)
print(list(r))       # 输出示例: [0, 2, 4, 6, 8]

# 逆序步长生成
countdown = list(range(5, 0, -1))
print(countdown)     # 输出示例: [5, 4, 3, 2, 1]
len(s) 容器度量
官方定义:返回对象(序列或集合等映射容器)的项数。实参可以是序列(如 string, bytes, tuple, list, range)或集合/映射(如 dictionary, set, frozenset)。
底层机制:对内置容器类型(如 list, dict),len() 执行效率为极高的 $O(1)$。这是因为 CPython 在底层结构体中(例如 PyVarObject 的 ob_size 字段)直接记录了元素数量,调用 len() 时直接读取该内存字段,不需要遍历容器。对于自定义类,len(obj) 会触发调用 obj.__len__() 方法。
典型示例:
# 基础容器长度获取
data_list = [10, 20, 30, 40]
print("列表长度:", len(data_list))  # 输出示例: 4

# 自定义支持 len() 的容器类
class CustomBuffer:
    def __init__(self, items):
        self._items = list(items)

    def __len__(self):
        # 必须返回非负整数
        return len(self._items)

buf = CustomBuffer(["a", "b", "c"])
print("自定义容器大小:", len(buf))   # 输出示例: 3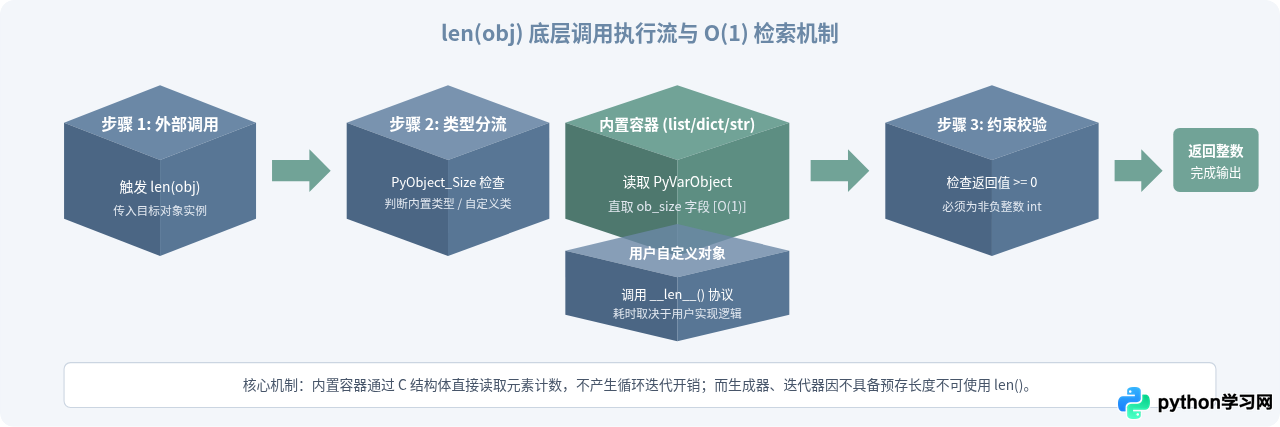
三、全景分类对照表
为了让知识脉络更具系统性,我们将从 print 到 len 之间常用的 16 个高频内置函数按功能属性分类汇总:
| 分类 | 函数名 | 入参格式 | 返回值类型 | 核心功能说明 |
|---|---|---|---|---|
| 标准 I/O | print() |
*objects, sep, end, file, flush |
None |
将对象格式化输出至流(默认为控制台终端)。 |
input() |
[prompt] |
str |
挂起并从控制台读取单行输入,恒返回字符串。 | |
| 基础类型构造 | int() |
x, base=10 |
int |
将字符串或浮点数截断转换为十进制整数。 |
float() |
x |
float |
转换为双精度浮点数,支持科学计数法字符串。 | |
str() |
object='' |
str |
返回适合用户阅读的对象非正式字符串表述。 | |
bool() |
x=False |
bool |
依据真值测试(Truth Value Testing)返回布尔值。 | |
| 集合容器转换 | list() |
iterable=() |
list |
将任意可迭代对象(如生成器、元组)实例化为可变列表。 |
tuple() |
iterable=() |
tuple |
将可迭代对象构建为不可变元组。 | |
dict() |
**kwargs / mapping / iterable |
dict |
通过键值对元组列表或关键字参数创建哈希字典。 | |
| 数值聚合与极值 | abs() |
x |
int / float |
返回数值的绝对值;复数则返回其模长。 |
round() |
number[, ndigits] |
int / float |
四舍六入五成双(银行家舍入算法)。 | |
sum() |
iterable, /, start=0 |
int / float |
对可迭代对象内部的所有数值求和。 | |
min() / max() |
iterable, *[, key, default] |
任意类型 | 依据自然大小或自定义 key 函数返回极值元素。 |
|
| 序列与度量 | range() |
[start,] stop[, step] |
range |
惰性生成等差整数序列,常用于循环控制。 |
enumerate() |
iterable, start=0 |
enumerate |
返回包含 (索引, 元素) 的迭代对象。 |
|
len() |
s |
int |
读取并返回容器元素数量,$O(1)$ 复杂度。 |
四、避坑指南:四大高频陷阱与解决策略
内置函数虽开箱即用,但在复杂业务场景下,若对其底层实现缺乏认识,容易造成严重逻辑缺陷。
1. 命名遮蔽(Shadowing)内置函数
这是初学者代码中最常见的错误。给变量起名时随手使用了 list = [1, 2, 3] 或 str = "hello"。此时 list 变成了一个局部变量名。当下一行试图使用 list(range(5)) 转换列表时,解释器会报:TypeError: 'list' object is not callable。
防范方法:若需要表示一组数据的变量名,可使用复数形式(如 items、values)或加前缀(如 item_list)。若不慎在全局遮蔽了内置函数,可通过 import builtins; list = builtins.list 恢复。
2. round() 的“银行家舍入法”
Python 3 的 round() 采用 IEEE 754 标准的“四舍六入五成双(Round to even)”原则,而不是中小学常识中的单纯四舍五入。
print(round(2.5))  # 输出示例: 2 (2为偶数,舍弃0.5)
print(round(3.5))  # 输出示例: 4 (4为偶数,进位至4)
print(round(4.5))  # 输出示例: 4 (4为偶数,舍弃0.5)
在金融财务等严谨算费场景下,切勿直接依赖 round() 处理资金,应使用标准库中的 decimal 模块并显式指定 ROUND_HALF_UP 舍入策略。
3. 对生成器(Generator)直接使用 len()
只有实现了 __len__() 魔术方法的类才能使用 len()。生成器对象(Generator)与大部分迭代器仅实现了 __next__() 与 __iter__(),它们在消耗完之前并不知道自身还有多少元素。
gen = (x * 2 for x in range(5))
# 直接运行 len(gen) 会抛出异常:
# TypeError: object of type 'generator' has no len()

# 正确计算生成器元素数量的方式:
# 方式 A:先转为 list(注意:会一次性消耗全部内存)
count_a = len(list(gen))

# 方式 B:通过 sum 计数(低内存占用)
gen2 = (x * 2 for x in range(5))
count_b = sum(1 for _ in gen2)
print("生成器项数:", count_b) # 输出示例: 5
4. 变长参数解包时忽略内置求值顺序
在组合使用 zip()、enumerate() 与 reversed() 时,入参若为一次性消耗的迭代器,一旦被遍历则数据流耗尽,第二次调用 len() 或再进行循环将得到空结果。
五、总结
Python 的内置函数库并非一堆杂乱的零散辅助工具,而是精心构建的高性能、高度优化的核心基础设施。从负责终端用户交互的 print(),到深入容器内存结构的 len(),掌握这些函数的执行机理不仅能让你的 Python 代码写得更简洁优美,更能从根本上规避变量遮蔽、类型陷阱以及非预期的性能开销。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









