

AI音乐创作入门:从提示词编写到成品导出的全流程
本文摒弃枯燥的参数罗列,以观点驱动的场景评析方式,深入探讨AI音乐创作的核心逻辑。文章从提示词工程的精准构建切入,解析如何通过风格标签与结构指令控制生成结果;进而分析在缺乏乐理基础的情况下,如何利用AI工具进行片段拼接与后期微调;最后梳理从多轨编辑到母带处理的导出规范。旨在帮助创作者理解AI并非替代者,而是将抽象灵感转化为具体音频的高效协作伙伴,明确其能力边界与最佳实践路径。
很多人面对空白的音轨界面时,最大的障碍不是不会操作软件,而是不知道如何开始。传统音乐制作要求创作者具备和声、配器甚至录音棚知识,这种高门槛让无数灵感止步于脑海。AI音乐工具的出现,看似降低了技术门槛,实则转移了核心能力要求:你不再需要亲手弹奏每一个音符,但必须学会如何清晰地描述你想要的声音。
这种转变带来了一种新的取舍。我们失去了对每一个微观音符的绝对控制,却获得了快速验证宏观创意的能力。AI音乐创作的本质,是从“执行者”向“导演”的角色转型。 如果你期待输入几个字就得到一首格莱美级别的完整交响乐,那注定会失望;但如果你将其视为一个能瞬间提供多种编曲可能性的超级会话乐手,工作流程将发生根本性改变。
提示词工程:用标签构建听觉蓝图
在AI音乐生成中,提示词(Prompt)不是简单的自然语言对话,而是一套结构化的元数据指令。大多数主流AI音乐平台并不完全理解“悲伤且充满希望”这样抽象的情感形容词,它们更依赖具体的风格标签、乐器组合和节奏参数。
有效的提示词通常遵循“风格+乐器+情绪+速度”的组合逻辑。例如,与其说“写一首好听的流行歌”,不如尝试“Upbeat Pop, Female Vocals, Bright Piano, 120 BPM, Summer Vibe”。在这种场景下,具体的乐器名称如“Bright Piano”比模糊的“好听”更能引导模型调用正确的音色库。风格标签如“Lo-fi Hip Hop”或“Cyberpunk Synthwave”则直接锁定了整体的混音质感与频率分布。
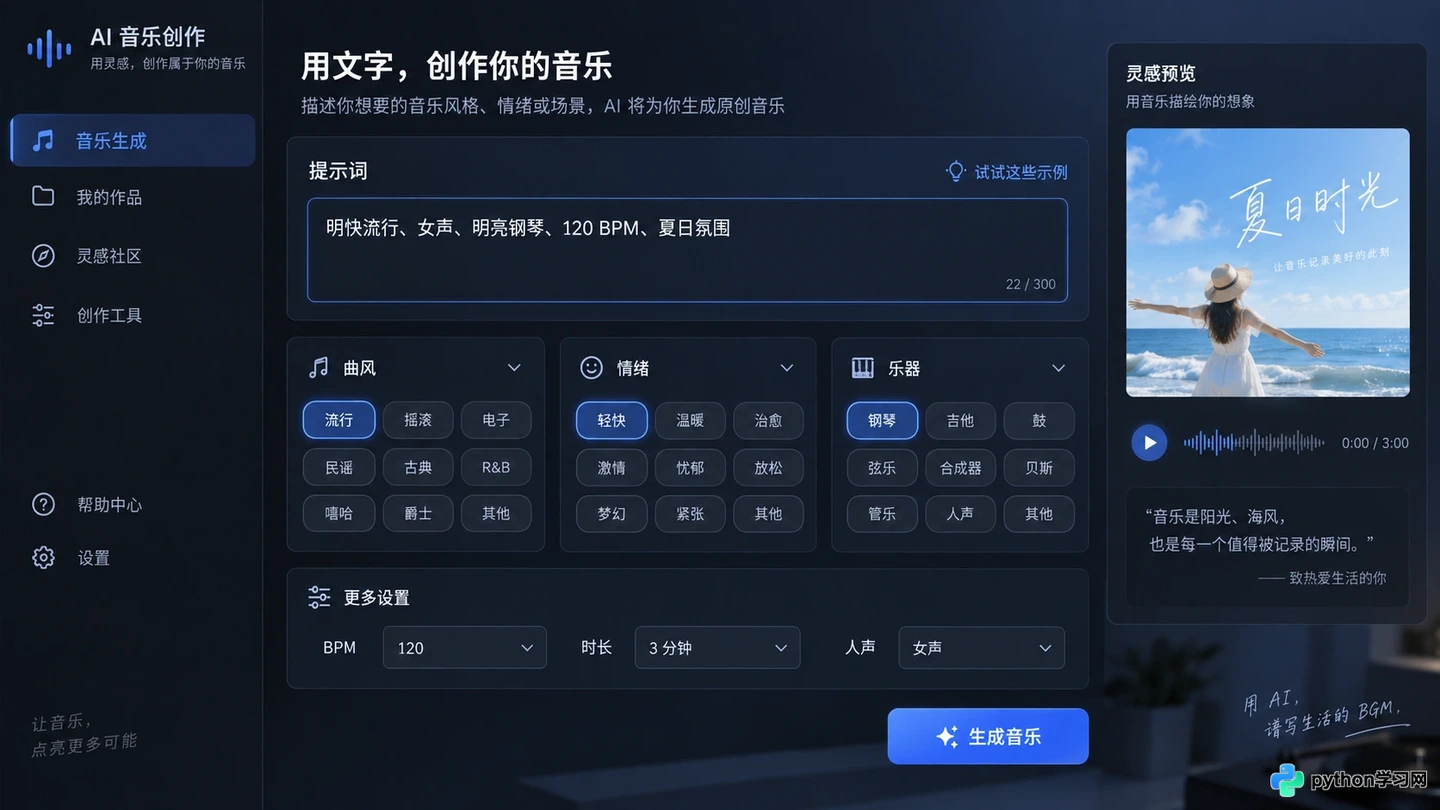
结构化的提示词输入界面,包含风格、乐器、情绪和速度参数
除了静态标签,结构指令同样关键。许多高级工具允许用户通过时间戳或段落标记来规划歌曲结构。你可以指定“Intro (4 bars) -> Verse -> Chorus”,从而避免AI生成一段无限循环的单调旋律。这种控制力虽然不如传统DAW(数字音频工作站)精确,但足以确保生成的素材具备基本的起承转合,为后续剪辑提供可用的骨架。
需要注意的是,不同模型对提示词的敏感度差异巨大。有些模型擅长捕捉复杂的爵士和声,却在处理人声歌词时显得生硬;另一些则专精于电子舞曲的节奏构建。理解你所用工具的“偏科”属性,是编写高效提示词的前提。 不要试图用一个提示词解决所有问题,分阶段生成往往比一次性生成全长曲目更有效。
迭代与筛选:在随机性中寻找确定性
AI生成的核心特征是随机性。即使使用完全相同的提示词,两次生成的结果也可能截然不同。对于初学者而言,这既是惊喜的来源,也是挫败感的根源。关键在于建立一套高效的筛选与迭代机制,而不是盲目地点击“重新生成”。
当第一版生成结果不尽如人意时,不要急于推翻整个提示词。首先检查是否偏离了核心风格。如果节奏对了但音色太薄,可以在提示词中增加“Heavy Bass”或“Rich Strings”等修饰词;如果旋律过于复杂,可以尝试加入“Minimalist”或“Simple Melody”进行约束。微调提示词的过程,实际上是在不断缩小搜索空间,逼近你心中的目标声音。
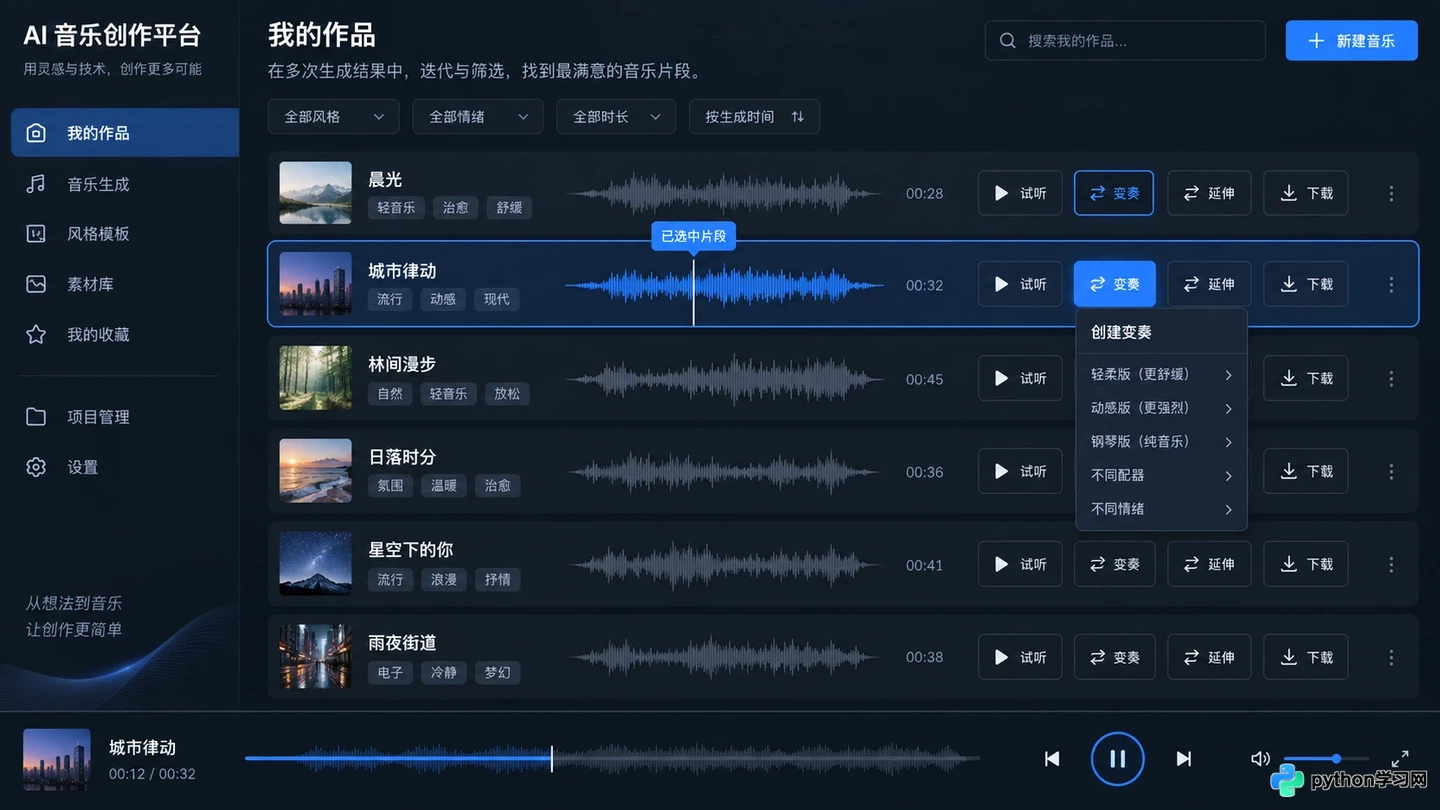
生成结果列表界面,支持对满意片段进行变奏和延伸
此外,利用“变奏”(Variation)功能比从头生成更高效。大多数平台允许用户上传一段已有的音频或选择某次生成的满意片段,以此为基础进行延伸或改编。这种方式保留了前一次生成中的优质基因(如独特的鼓点节奏或迷人的合成器音色),同时引入新的变化。在实际操作中,先生成多个短片段(如8小节或16小节),挑选最满意的一个作为种子,再扩展为完整曲目,往往能获得更高的一致性。
这一阶段的痛点在于听力疲劳。连续听取几十版相似的Demo容易导致判断力下降。建议采用“A/B测试”策略,将不同版本的片段放入简单的播放列表中对比,或者间隔一段时间后再回听。保持客观的听觉距离,才能识别出那些真正具有潜力的细微差别。
后期组装:从碎片到完整作品的跨越
AI生成的原始音频通常是单声道或立体声的混合文件,缺乏传统多轨工程的分层灵活性。因此,后期组装成为决定作品完成度的关键环节。这一步骤不再依赖AI的黑盒算法,而是回归到传统的音频编辑逻辑。
首先需要进行的是“切片与重组”。将AI生成的长音频导入DAW,根据之前设定的结构标记,切分出主歌、副歌、过门等部分。如果发现某一段落的过渡生硬,可以利用交叉淡化(Crossfade)技术平滑连接,或者插入一段由AI单独生成的过渡音效(如Riser或Drum Fill)来掩盖接缝。这种模块化的组装方式,赋予了创作者对歌曲结构的最终控制权。
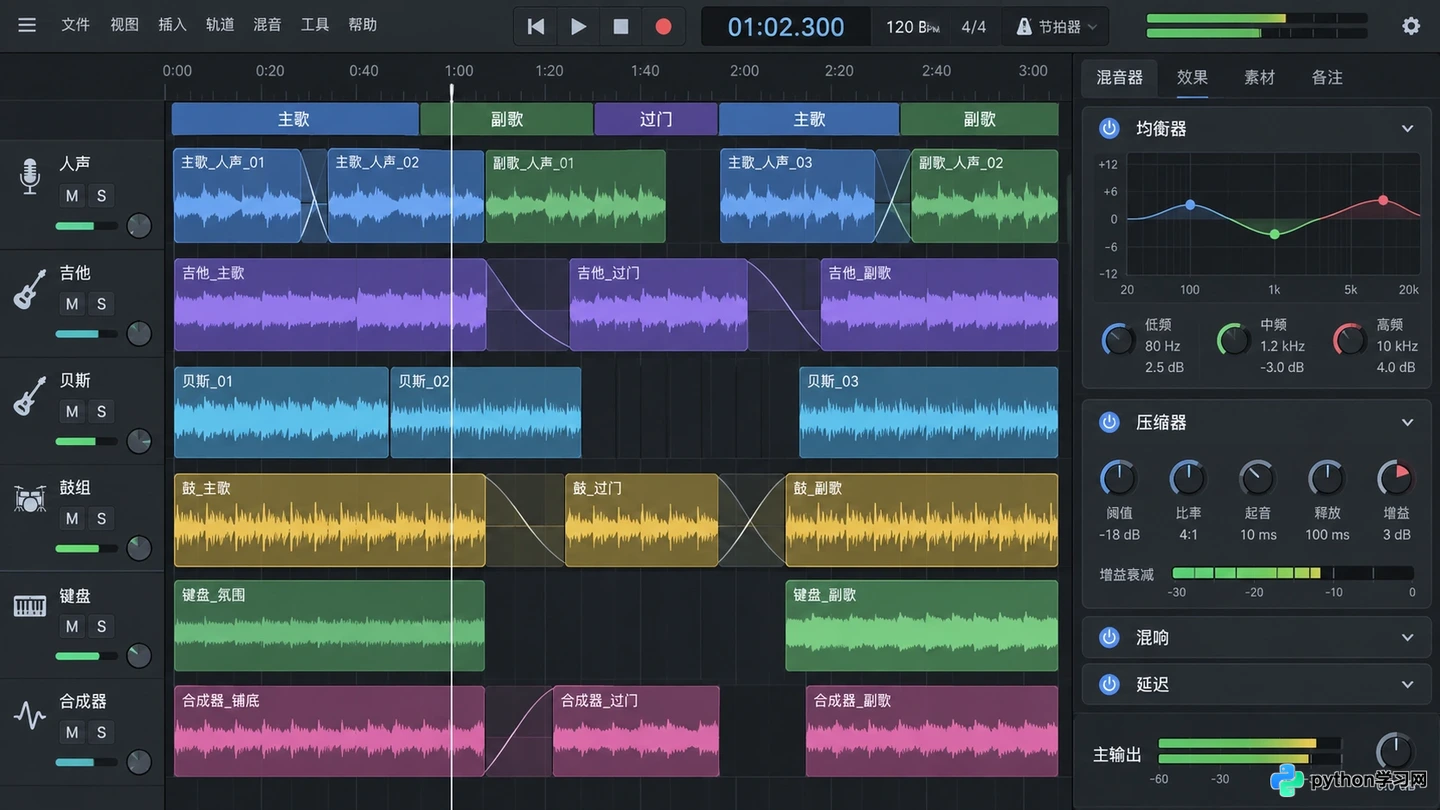
在DAW中对音频进行切片、重组和交叉淡化处理
其次是人声与伴奏的分离或融合。如果AI生成的是带人声的完整曲目,而你需要调整人声效果,可以使用AI分离工具将人声与伴奏拆分为独立音轨。虽然分离过程可能会引入轻微的相位失真或高频损失,但对于非专业发行级的演示作品或短视频背景音乐而言,其效率优势远大于音质损耗。若追求更高品质,建议仅使用AI生成纯伴奏,再由真人录制或使用高质量语音合成工具添加人声。
在这一阶段,基础的混音处理不可或缺。AI生成的音频往往动态范围过大或频率分布不均。简单的EQ(均衡器)切除低频浑浊,压缩器(Compressor)控制动态峰值,以及适量的混响(Reverb)增加空间感,都能显著提升听感。不要指望AI一键输出广播级音质,后期的手工打磨依然是区分业余与专业的分水岭。
导出与交付:适配场景的技术规范
最后一步是导出,但这不仅仅是点击“保存”那么简单。不同的发布渠道对音频格式、采样率和位深度有着截然不同的要求。错误的导出设置可能导致作品在社交媒体上听起来沉闷,或在专业平台上出现削波失真。
对于流媒体平台(如Spotify、Apple Music)或视频背景音乐,通常建议导出为44.1kHz/16bit的WAV或FLAC无损格式,以确保最佳的兼容性。如果用于短视频平台(如TikTok、Instagram),由于平台会对音频进行二次压缩,导出前可以适当提升整体响度,并检查高频是否刺耳。MP3格式仅适用于小样分享或网络传输,绝不应作为最终母带存档。
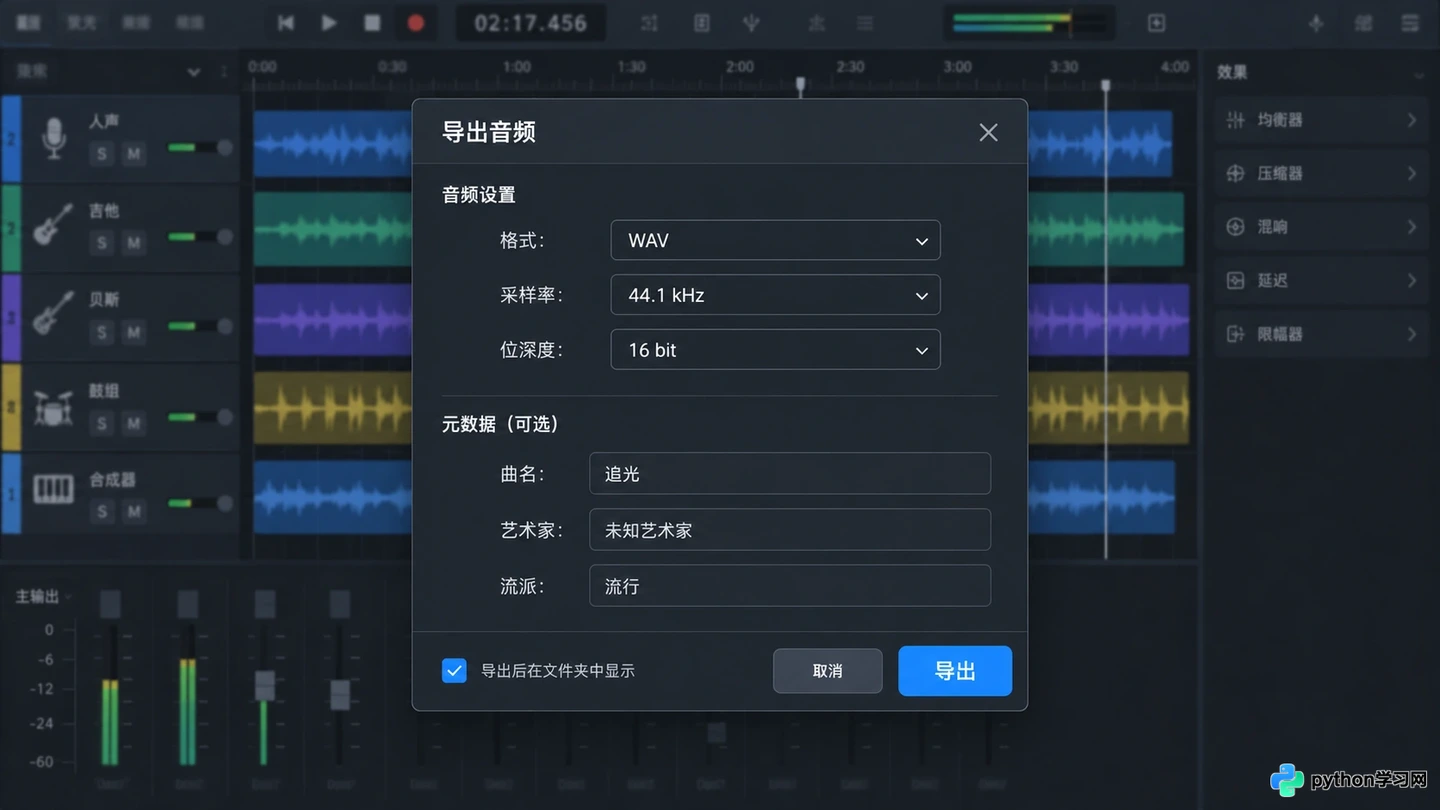
导出设置窗口,包含采样率、位深度和元数据填写项
此外,元数据(Metadata)的嵌入常被忽视。在导出文件中填入正确的曲名、艺术家、流派甚至ISRC编码,有助于作品在数字分发过程中的版权追踪与检索。虽然这对个人创作者看似繁琐,但在AI生成内容版权争议日益复杂的当下,完善的元数据是证明创作归属的重要辅助证据。
值得注意的是,目前多数AI音乐平台在服务条款中对商业用途有严格限制。免费用户生成的作品往往仅限个人非商业使用,订阅用户才可能获得商业授权。在导出并发布之前,务必仔细阅读平台的许可协议,确认你对生成内容拥有的权利范围,避免潜在的法律风险。
AI音乐创作并非魔法,它是一套将抽象意图转化为具体声波的新工艺。从精准的提示词编写,到理性的迭代筛选,再到严谨的后期组装与导出,每一步都需要创作者投入判断力与审美。工具负责提供可能性,而你负责做出选择。 当你不再纠结于某个音符的对错,而是专注于整体情感的传达时,AI才真正成为了你的乐器。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









