

Python练习题常见逻辑错误与调试技巧分析
深入分析Python编程练习中常见的逻辑错误成因,并系统讲解从简易print追踪、交互式pdb断点到二分排查的实用调试技巧。
在解答Python编程练习题时,最让人头疼的往往不是显式的语法报错(SyntaxError),而是程序能够顺利运行却输出了错误结果的“逻辑错误”(Logic Error)。逻辑错误的本质在于代码忠实地执行了编写者的指令,但指令本身的逻辑与题目要求或预期目标存在偏差。本文将系统拆解初学者在基础练习中最常遇到的四类逻辑陷阱,并介绍一套从轻量验证到深度断点排查的标准调试流程。
一、练习题中高频出现的典型逻辑错误
在算法刷题和日常练习中,大多数逻辑错误并非源于复杂的数学难题,而是由于对Python内置语法机制的边界理解不够透彻。以下是四种最高频的逻辑缺陷场景。
1. 差一错误(Off-by-One Error)与区间左闭右开
Python的 range(start, stop[, step]) 函数及切片语法采用数学上的半开区间 [start, stop),即包含起始值但不包含终止值。初学者在处理“求1到n之和”或遍历列表索引时,极易忽略右端点的排他性。
# 错误示例:计算 1 到 10 的累加和,漏掉了 10
def sum_to_n_wrong(n):
    total = 0
    for i in range(1, n):  # 此时只遍历到 n-1
        total += i
    return total

# 正确写法:终止条件设为 n + 1
def sum_to_n_correct(n):
    total = 0
    for i in range(1, n + 1):
        total += i
    return total
当执行 sum_to_n_wrong(10) 时,返回值为45;而预期应为55。类似问题还常见于逆序遍历,例如想从列表最后一个元素遍历到第一个元素,若写成 range(len(lst)-1, 0, -1) 则会遗漏索引0对应的元素,必须指定终止值为 -1。
2. 可变默认参数陷阱
在定义函数时,若将空列表 [] 或空字典 {} 直接作为参数默认值,该默认对象会在函数被定义时初始化一次,并在所有未传该参数的后续调用中共享,从而导致数据跨调用污染。
# 错误示例:共享默认列表
def record_score_wrong(score, history=[]):
    history.append(score)
    return history

print(record_score_wrong(85))  # 输出: [85]
print(record_score_wrong(92))  # 输出: [85, 92],而非预期的 [92]

# 正确写法:使用 None 作为哨兵值并在函数内部动态创建
def record_score_correct(score, history=None):
    if history is None:
        history = []
    history.append(score)
    return history
3. 遍历容器时就地修改元素
在通过 for item in list 遍历列表的同时调用 list.remove() 或 del,会导致列表底层索引向前移动,使得迭代器内部指针跳过紧随其后的下一个元素。
# 错误示例:过滤列表中的偶数
numbers = [1, 2, 2, 3, 4]
for num in numbers:
    if num % 2 == 0:
        numbers.remove(num)
# 预期得到 [1, 3],实际得到 [1, 2, 3],因为第二个 2 被跳过了

# 正确写法:列表推导式或遍历浅拷贝副本
filtered_numbers = [num for num in numbers if num % 2 != 0]
# 或者:for num in numbers[:]: if num % 2 == 0: numbers.remove(num)
4. 作用域遮蔽与变量覆盖
在循环体或嵌套函数中重用外部已有变量名(尤其是计数器变量如 i、j 或全局容器名),会导致外层逻辑被非预期修改。此外,把变量初始化放在循环外层而未在每轮开始时重置,也是统计类习题常见的逻辑隐患。
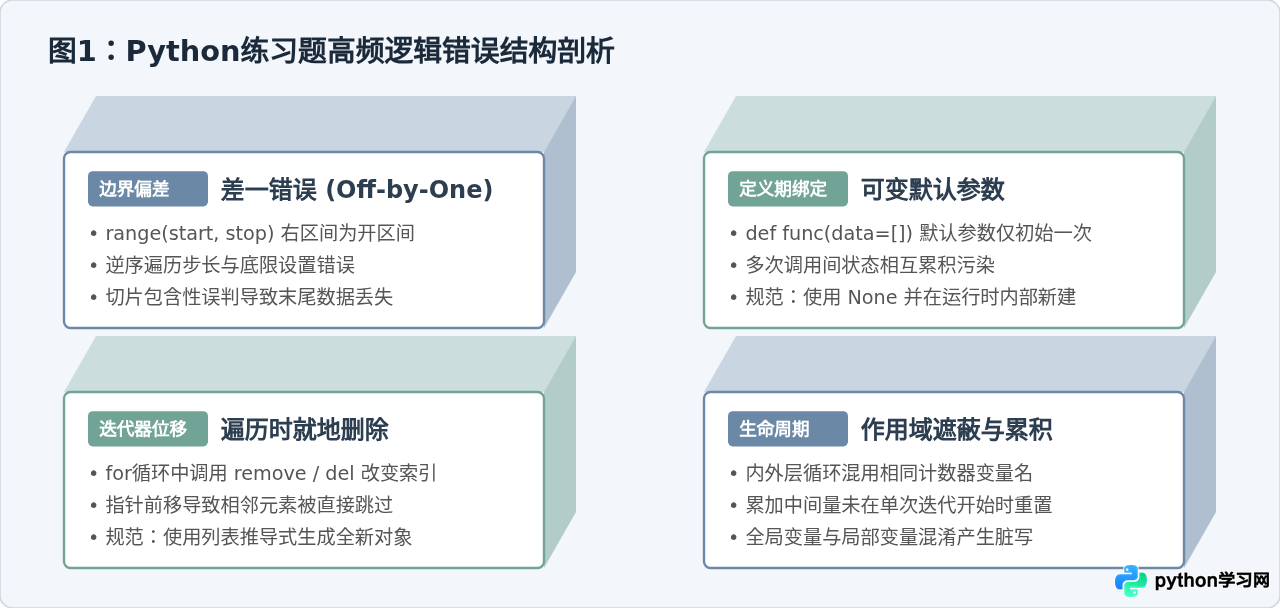 图1:Python四类典型逻辑错误的表现特征与规避原则
二、标准调试流程:从复现到验证
遇到程序逻辑错误时,胡乱修改代码(即所谓的“盲改尝试”)不仅效率低下,还往往引入新的问题。高效调试的核心在于构建可确定复现的最小测试用例,并按照层级收敛怀疑范围。
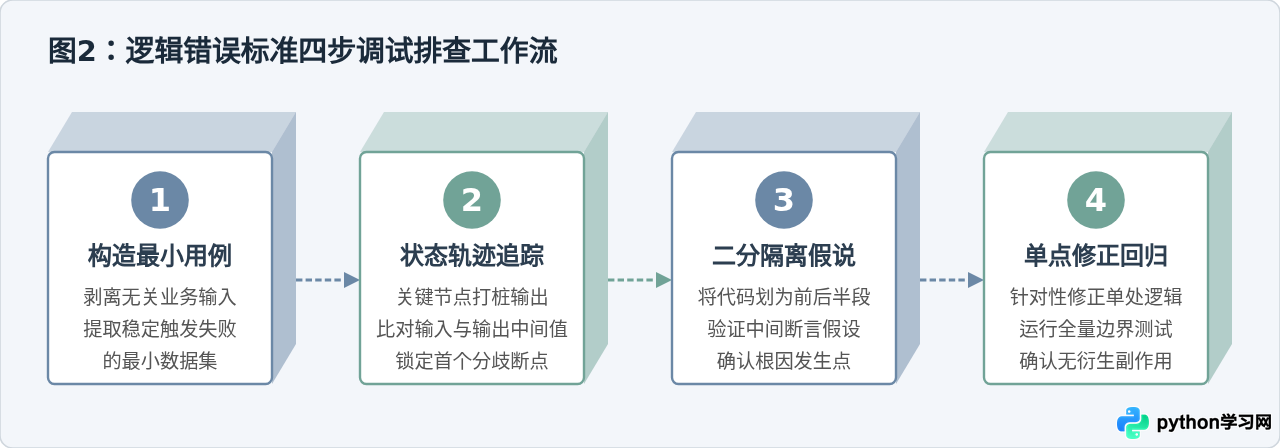 图2:排查逻辑缺陷的标准化操作流程
- 构造最小失败用例(Minimal Reproducible Example):若题目处理的是由100个整数构成的列表并发生错误,先手动构造仅有2到3个元素的简易列表,使输出依然出错,极大缩减单次排查的人脑推导成本。
- 追踪程序执行轨迹与变量状态:不依赖对代码的“猜测”,而是明确每一行代码执行后,内存中核心变量的实际内容是什么。
- 二分法收敛断点:在调用链条或循环执行的中间位置,检查状态是否符合数学或业务预期。如果前半段正常,错误必然在后半段;反之错误在前半段。
- 单点修复与边界回归:一次只修改一个疑点,修改后不仅要测试刚才失败的用例,还要测试空值、单元素、极值等常规用例,防止“治好一个又坏一个”。
三、核心调试技巧与实战用法
在排查逻辑错误时,根据场景选择合适的工具组合可以大幅节省时间。以下介绍三种在Python练习中最常用的调试手段。
1. 格式化 print 与 f-string 调试表达式
许多人使用 print(x) 进行调试,但当终端输出一大堆裸数字时,很难分清哪个是哪个。在 Python 3.8 及更高版本中,f-string 支持 {variable=} 语法,能够自动打印变量名及其当前求值结果。
# 实战:调试找列表中两个数之和等于目标值的索引
def two_sum(nums, target):
    seen = {}
    for i, num in enumerate(nums):
        complement = target - num
        # 使用 f-string 快速打桩
        # print(f"DEBUG: {i=}, {num=}, {complement=}, {seen=}")
        if complement in seen:
            return [seen[complement], i]
        seen[num] = i
return []打桩日志务必包含当前所处的作用域标识或迭代轮次,且在排查完毕提交作业前应统一删除或注释,避免影响自动化评测系统的判定输出。
2. 使用 assert 断言提前发现状态脱轨
在关键计算节点插入 assert 表达式, "错误提示",能够在变量偏离设计约束的瞬间使程序抛出 AssertionError 中断,从而立刻定位首次偏离的精确行号,防止错误状态继续向下游传导。
def calculate_average(grades):
    assert len(grades) > 0, "成绩列表不能为空"
    total = sum(grades)
    avg = total / len(grades)
    assert 0 <= avg <= 100, f"计算所得平均分异常: {avg}"
    return avg
3. 内置交互式调试器 pdb / breakpoint()
自 Python 3.7 起,标准库提供了内置函数 breakpoint(),它会自动调用 pdb 模块。在怀疑出现逻辑偏差的代码行上方插入 breakpoint(),程序运行到该处时会挂起并进入交互式命令行。
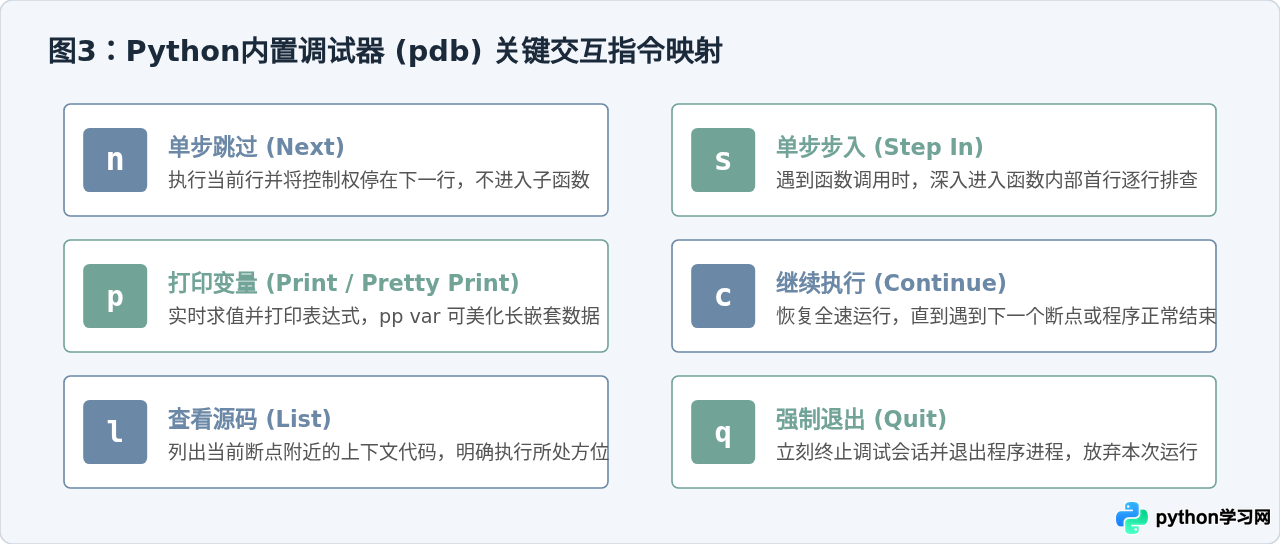 图3:pdb断点调试的核心交互命令速查
在 pdb 提示符 (Pdb) 下,开发者不仅能实时查看变量,甚至可以直接输入 Python 语句改变当前变量的值,以测试不同修复逻辑是否能让后续代码顺畅通过。
四、综合诊断与排错思维总结
解决逻辑错误不是依赖直觉碰运气,而是建立严谨的控制流与状态观察模型。在日常习题练习中,遇到计算结果不符时,推荐按下方总结的四象限思维模型进行快速定性分析与应对。
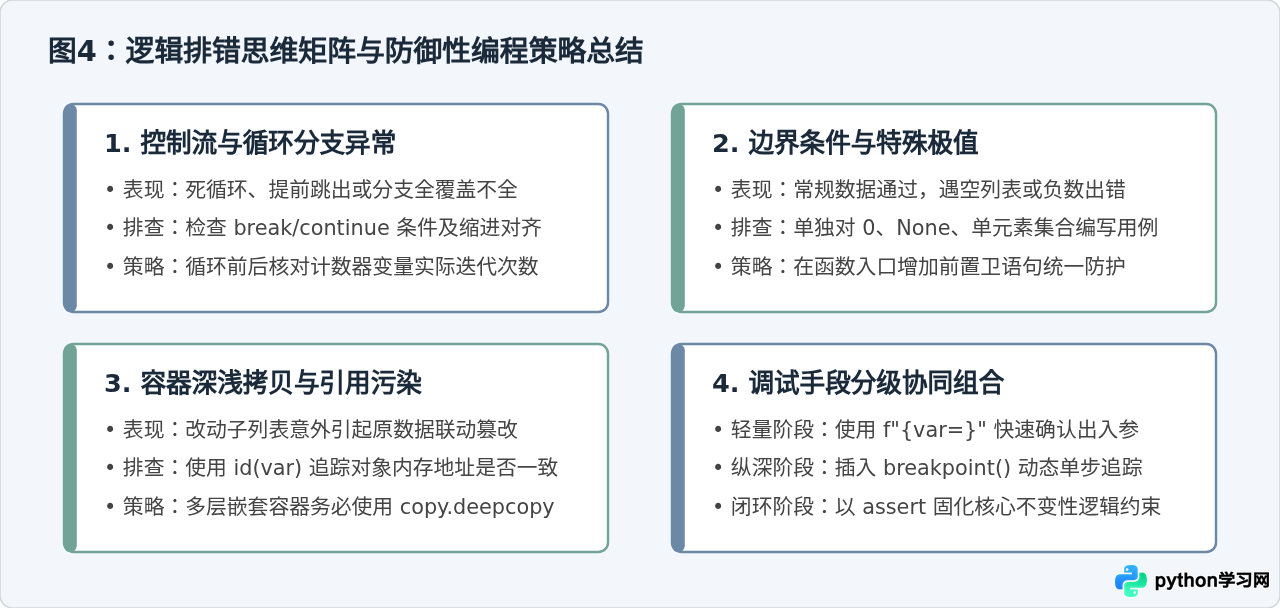 图4:Python练习题排错与防御性编程思维总结
在编写练习题代码时,建议遵循“先防御、后编写、再断点”的思维惯性:在编写逻辑前明确入参的有效边界与类型;在编写核心算法时主动利用不可变模式或推导式减少就地修改;当运行结果出现偏差时,保持耐心,使用 breakpoint() 和格式化输出逐步收敛,逻辑错误终将无所遁形。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









