

Python数据分析报告完整工作流:从数据获取到可视化输出
本文系统拆解基于Python的数据分析报告工程化工作流,涵盖多源数据获取、链式清洗规整、探索性指标建模、多维可视化呈现以及Jinja2自动化报告输出的全流程实操与注意事项。
搭建一份可靠的数据分析报告,核心并不在于罗列多少图表,而在于建立一条从底层原始数据到最终交付物之间的确定性流水线。一条健壮的工作流需要解决输入格式不一、脏数据干扰指标口径、代码复用度低以及报告更新繁琐等现实痛点。本文将拆解完整的工程化实现方案:通过结构化分层,将数据采集、清洗规整、聚合建模、图表渲染与HTML自动化组装串联为单一可重现的脚本系统,让后续每次分析只需运行一次管道即可生成标准分析报告。
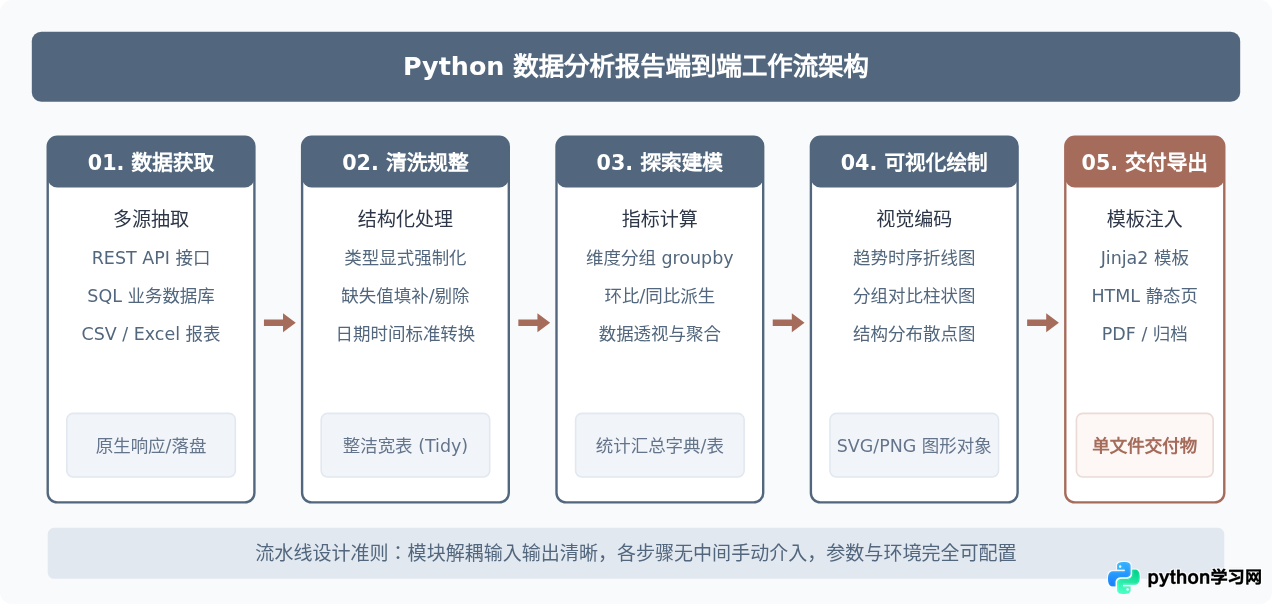
一、数据获取:规范化接入多源输入
真实项目中的分析数据鲜有直接准备妥当的单一CSV文件,往往分散在数据库、RESTful API和离线报表中。在数据获取阶段,核心原则是显式声明数据契约,避免隐式转换带来的不可控报错。
1. 关系型数据库的批量抽取
从PostgreSQL或MySQL读取数据时,推荐使用SQLAlchemy配合Pandas。不要把所有过滤逻辑拖到内存中用Pandas处理,应当在SQL层面完成首轮初筛,减轻本地IO压力:
import pandas as pd
from sqlalchemy import create_engine

# 建立连接引擎(推荐从环境变量读取凭据,避免硬编码)
db_url = "postgresql://reader_user:secure_pwd@db.internal:5432/analytics"
engine = create_engine(db_url)

# 参数化查询,限定起止时间与核心字段
query = """
    SELECT order_id, user_id, order_time, total_amount, status, channel
    FROM orders
    WHERE order_time >= '2026-01-01' AND order_time < '2026-04-01'
      AND status IN ('PAID', 'COMPLETED')
"""
df_orders = pd.read_sql(query, con=engine, parse_dates=['order_time'])
2. API 接口的容错拉取与结构展开
当依赖上游微服务的JSON接口时,网络抖动与嵌套字段是常见阻碍。必须设定超时时间、重试策略,并借助pd.json_normalize将多层嵌套字典平铺为二维分析表格:
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

def fetch_telemetry_data(endpoint: str, headers: dict) -> pd.DataFrame:
    session = requests.Session()
    retries = Retry(total=3, backoff_factor=1, status_forcelist=[500, 502, 503, 504])
    session.mount('https://', HTTPAdapter(max_retries=retries))

    response = session.get(endpoint, headers=headers, timeout=10)
    response.raise_for_status()
    payload = response.json()

    # 将包含嵌套对象的 items 展平为标准 DataFrame
    return pd.json_normalize(
        payload['items'],
        sep='_',
        meta=['device_id', 'firmware_version']
    )
二、数据清洗与规整:构建整洁分析宽表
未经清洗的数据直接进入分析会产生严重偏差。清洗阶段的目标是产出符合“每列为一个变量、每行为一个观测单元”的整洁数据集(Tidy Data)。
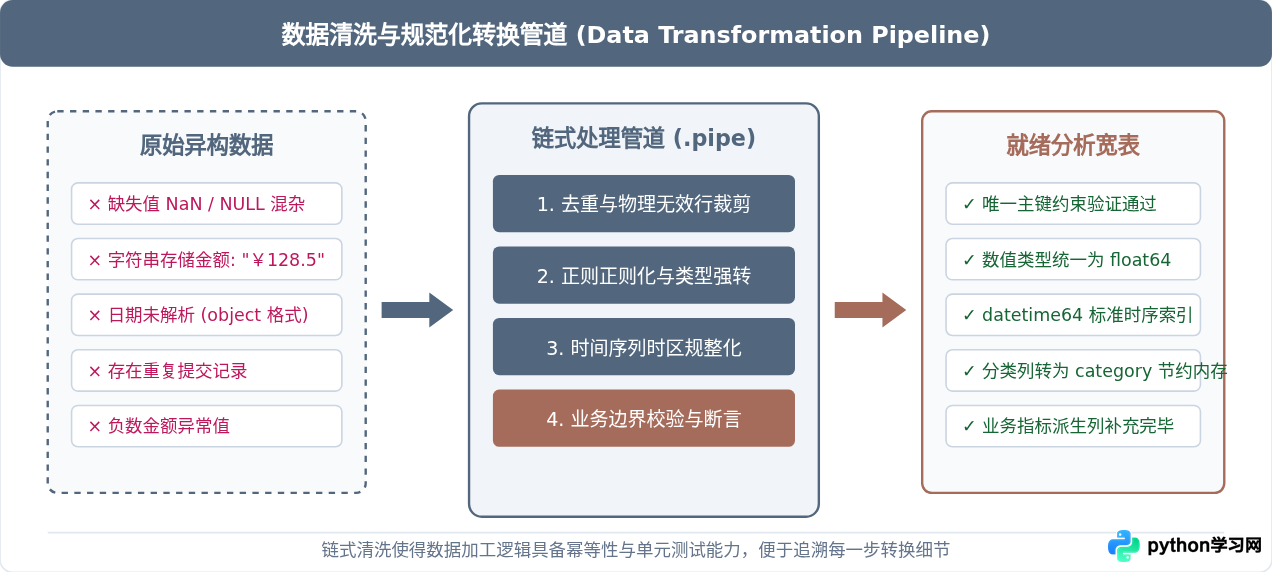
在实际编码中,建议采用方法链(Method Chaining)风格,将散落的赋值操作重构为连续且自解释的管道函数:
def clean_orders_pipeline(raw_df: pd.DataFrame) -> pd.DataFrame:
    return (
        raw_df
        # 1. 剔除完全重复与关键外键缺失记录
        .drop_duplicates(subset=['order_id'])
        .dropna(subset=['user_id', 'total_amount'])
        # 2. 字段类型清洗:剥离特殊字符并转换为数值
        .assign(
            total_amount=lambda d: (
                d['total_amount']
                .astype(str)
                .str.replace(r'[¥,$,\s]', '', regex=True)
                .astype(float)
            ),
            order_time=lambda d: pd.to_datetime(d['order_time'], utc=True),
            channel=lambda d: d['channel'].str.strip().str.lower().astype('category')
        )
        # 3. 业务有效性过滤:排除负值和极端测试异常单
        .query('total_amount > 0 and total_amount < 500000')
        # 4. 派生时间维度属性以供后续分组
        .assign(
            order_date=lambda d: d['order_time'].dt.date,
            order_hour=lambda d: d['order_time'].dt.hour,
            weekday=lambda d: d['order_time'].dt.day_name()
        )
)避坑提示:避免使用 inplace=True。原地修改会破坏链式操作的连续性,并常常引发 Pandas 的 SettingWithCopyWarning 警告。使用方法链配合显式变量赋值,能保证中间数据状态的可测性与回溯性。
三、探索性分析与核心业务指标建模
清洗完成后的数据需要沉淀为具体的业务指标。报告通常包含三类核心统计:总量概览(KPIs)、时序走势(Trends)和多维交叉对比(Breakdowns)。
1. 综合指标概览计算
从整洁数据集中快速提取核心业务大盘数值,并组织为适合模板渲染的字典结构:
def compute_summary_kpis(df: pd.DataFrame) -> dict:
    total_gmv = df['total_amount'].sum()
    order_count = len(df)
    unique_users = df['user_id'].nunique()
    arpu = total_gmv / unique_users if unique_users > 0 else 0
    avg_order_value = total_gmv / order_count if order_count > 0 else 0

    return {
        'total_gmv': round(total_gmv, 2),
        'order_count': order_count,
        'unique_users': unique_users,
        'arpu': round(arpu, 2),
        'avg_order_value': round(avg_order_value, 2)
    }
2. 维度下钻与时序聚合
利用 groupby 或 pivot_table 计算各渠道日度销售额及占比,为可视化阶段提供轻量化的聚合数据源:
def aggregate_daily_metrics(df: pd.DataFrame) -> pd.DataFrame:
    daily_channel_summary = (
        df.groupby(['order_date', 'channel'], observed=True)['total_amount']
        .agg(sales='sum', orders='count')
        .reset_index()
    )
    return daily_channel_summary
四、数据可视化:统一视觉语言与图表输出
高质量的可视化不仅要求图表类型匹配分析意图,还需要保持严谨的色彩系统与统一的排版边距。不要在每个绘图脚本中随机使用默认配色,应建立固定的调色板(Palette)与导出规格。
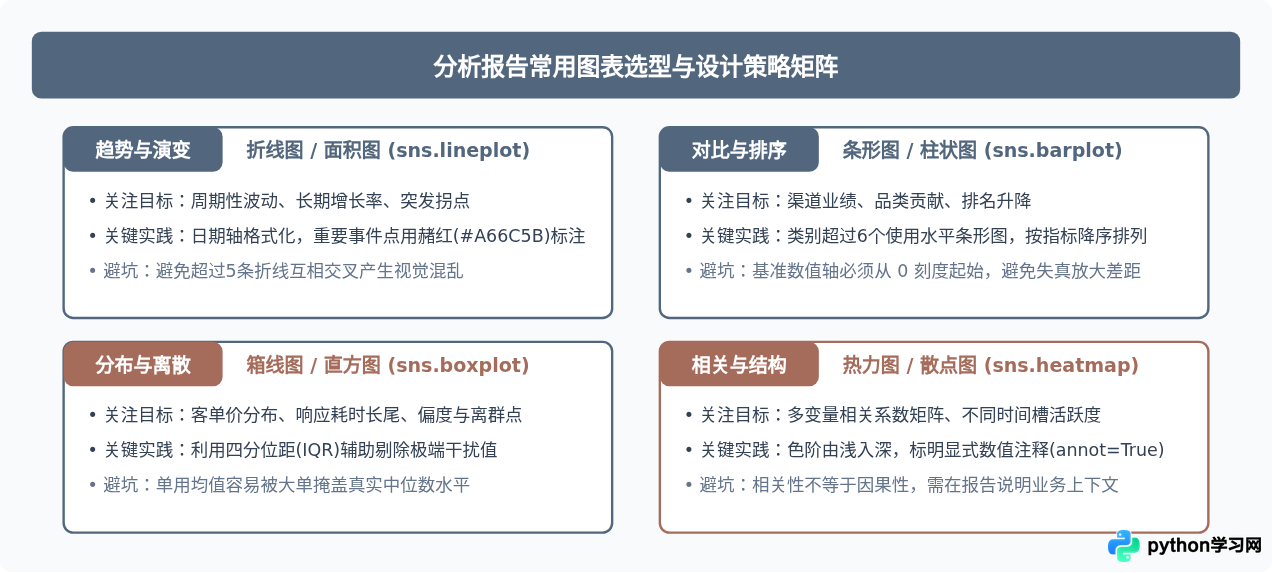
工程化绘图封装示例
在自动化流水线中,图表通常需要转换为内联图像(Base64编码或SVG字符串)嵌入最终HTML中,以消除外部静态资源文件路径依赖。以下是一个完整的图表生成与转换函数:
import io
import base64
import matplotlib.pyplot as plt
import seaborn as sns

# 全局设置中文字体与配色基准
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

def render_sales_trend_chart(daily_df: pd.DataFrame) -> str:
    fig, ax = plt.subplots(figsize=(10, 4.5), dpi=150)

    # 绘制主要折线(蓝灰色)
    ax.plot(daily_df['order_date'], daily_df['sales'],
            color='#52677D', linewidth=2.2, label='日总销售额')

    # 计算并绘制7日移动平均线(强调赭红色虚线)
    ma7 = daily_df['sales'].rolling(window=7, min_periods=1).mean()
    ax.plot(daily_df['order_date'], ma7,
            color='#A66C5B', linewidth=1.8, linestyle='--', label='7日移动平均')

    ax.set_title('业务日销售走势与平滑趋势', fontsize=14, fontweight='bold', pad=15)
    ax.set_xlabel('日期', fontsize=11, labelpad=10)
    ax.set_ylabel('金额 (元)', fontsize=11, labelpad=10)
    ax.grid(True, linestyle=':', alpha=0.6)
    ax.legend(frameon=True, facecolor='#FFFFFF', edgecolor='#CBD5E1')

    plt.tight_layout()

    # 内存中导出为 base64 PNG,不产生临时磁盘碎片
    buf = io.BytesIO()
    fig.savefig(buf, format='png', bbox_inches='tight')
    plt.close(fig)
    buf.seek(0)

    img_b64 = base64.b64encode(buf.read()).decode('utf-8')
    return f"data:image/png;base64,{img_b64}"
五、自动化报告生成:基于 Jinja2 的模板渲染闭环
很多开发者在完成计算后,习惯在Python中手动拼接HTML长字符串,这种方式可维护性极差。专业的做法是引入 Jinja2 模板引擎,将计算逻辑与视觉结构彻底分离。
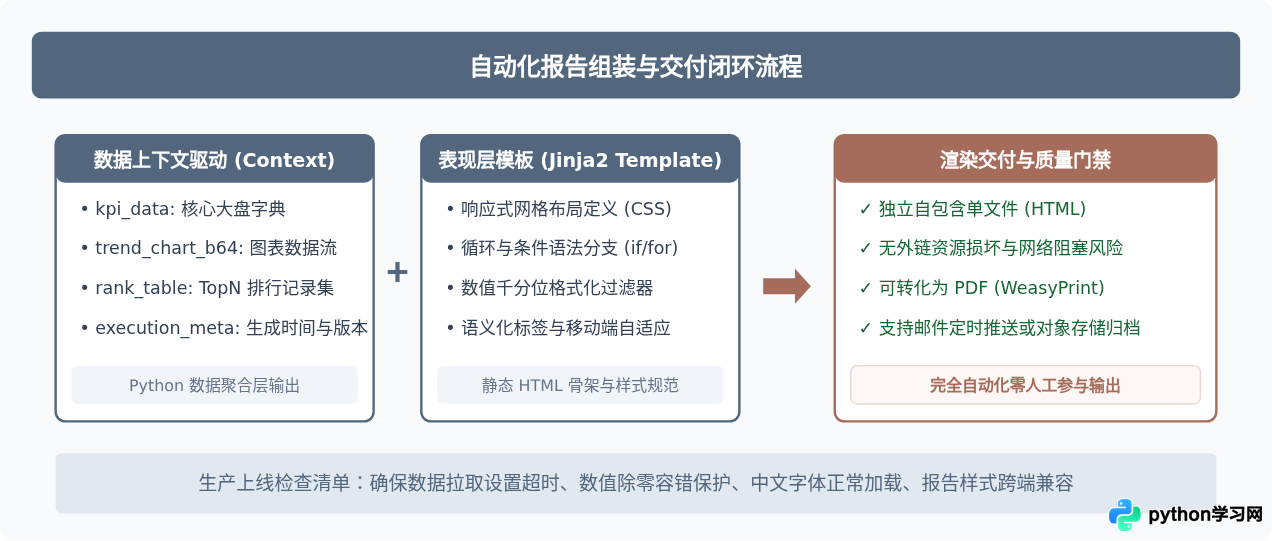
报告模板与渲染执行脚本
定义简洁清晰的 Jinja2 模板,并将清洗计算后的上下文参数一次性注入生成最终交付文件:
from jinja2 import Template
import datetime

HTML_TEMPLATE = """
<!DOCTYPE html>
<html>
<head>
  <meta charset="UTF-8">
  <title>{{ report_title }}</title>
  <style>
    body { font-family: sans-serif; margin: 30px; background: #FAFAFA; color: #333; }
    .card { background: #FFF; padding: 20px; border-radius: 8px; margin-bottom: 20px; border: 1px solid #E2E8F0; }
    .kpi-grid { display: flex; gap: 20px; }
    .kpi-item { flex: 1; padding: 15px; background: #F8FAFC; border-radius: 6px; border-left: 4px solid #52677D; }
    .kpi-value { font-size: 24px; font-weight: bold; color: #52677D; margin-top: 6px; }
    .chart-container { text-align: center; margin-top: 20px; }
    img { max-width: 100%; height: auto; border-radius: 6px; }
  </style>
</head>
<body>
  <div class="card">
    <h1>{{ report_title }}</h1>
    <p>生成时间:{{ generated_at }}</p>
    <div class="kpi-grid">
      <div class="kpi-item">
        <div>总销售额</div>
        <div class="kpi-value">¥{{ "{:,.2f}".format(kpi.total_gmv) }}</div>
      </div>
      <div class="kpi-item">
        <div>支付订单数</div>
        <div class="kpi-value">{{ "{:,}".format(kpi.order_count) }}</div>
      </div>
      <div class="kpi-item">
        <div>客单价</div>
        <div class="kpi-value">¥{{ "{:,.2f}".format(kpi.avg_order_value) }}</div>
      </div>
    </div>
  </div>
  <div class="card">
    <h2>销售趋势与预测走势</h2>
    <div class="chart-container">
      <img src="{{ trend_chart }}" alt="日销售趋势" />
    </div>
  </div>
</body>
</html>
"""

def generate_report(kpi_data: dict, chart_base64: str, output_path: str):
    template = Template(HTML_TEMPLATE)
    html_content = template.render(
        report_title="2026年第一季度经营分析报告",
        generated_at=datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S"),
        kpi=kpi_data,
        trend_chart=chart_base64
    )
    with open(output_path, 'w', encoding='utf-8') as f:
        f.write(html_content)
    print(f"报告已生成至:{output_path}")
六、生产环境运行与稳定性核验
在将工作流部署至调度系统(如 Airflow 或 Cron)长期运行时,需落实以下工程化核验准则:
| 工作流阶段 | 高发风险点 | 推荐防御措施 |
|---|---|---|
| 数据拉取 | 网络阻塞导致无响应挂起,上游数据未产出空读 | 显式配置 socket 超时参数;增加最少行数断言(assert len(df) > 0) |
| 清洗规整 | 脏数据导致列隐式降级为 object 类型引发聚合报错 | 使用 df.astype() 进行严格类型约束,捕获异常记录并打点报警 |
| 图表渲染 | 多进程并发或长期常驻服务中 Matplotlib 内存泄漏 | 每次绘图必须调用 plt.close(fig) 显式回收画布资源 |
| 交付产出 | 外部字体缺失导致中文在无头服务器上变成“豆腐块”乱码 | 在 Docker 镜像中预装开源中文字体(如 Noto Sans CJK SC),并在脚本中指定通用回退 |
通过遵循上述分层架构,数据分析报告从偶发性的手动 Notebook 探索转变为稳定可重现的工程流水线,既能显著降低日常维护成本,也保障了业务汇报输出的精确与高效。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









