

Python集合推导式怎么写?批量生成与过滤集合的高效写法
详细讲解Python集合推导式(Set Comprehension)的基本语法结构、条件过滤与批量去重写法,深入对比传统循环与列表转集合在内存与性能上的关键差异,提供规范实用的代码示例与避坑指南。
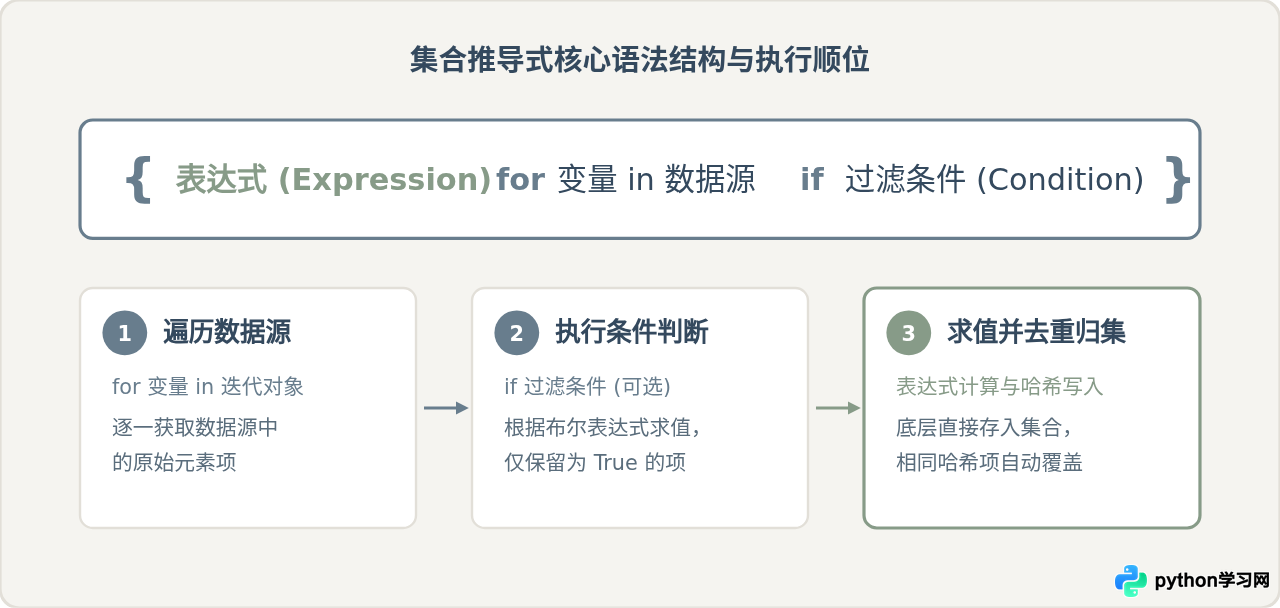
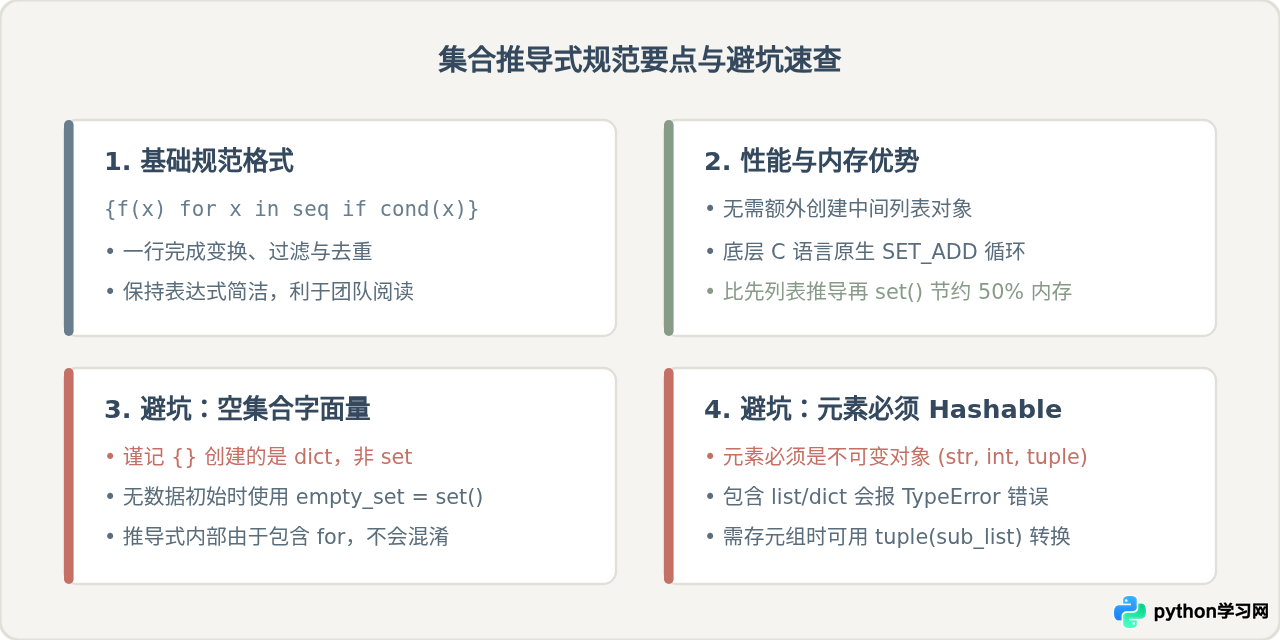
{表达式 for 变量 in 可迭代对象 if 过滤条件}。相比传统的多行 for 循环追加以及先构造列表再转集合的冗余方式,集合推导式不仅减少了代码层级,还能直接在 C 语言层面优化循环与哈希写入过程,大幅降低临时内存开销。
一、集合推导式的基本语法与执行逻辑
在 Python 中,集合(Set)是无序且元素唯一的容器。集合推导式在外形上使用花括号 {},内部结构由三个核心部分组成:位于最左侧的目标表达式、中间的遍历循环语句,以及可选的条件过滤子句。
来看一个最基础的对比示例。假设我们需要将一个包含重复数字的列表转换为其平方值的集合:
# 示例输入:包含重复数据的列表
numbers = [1, 2, 2, 3, 4, 4, 5]

# 集合推导式写法
squares_set = {x ** 2 for x in numbers}

# 输出结果:{1, 4, 9, 16, 25}
print(squares_set)
在这段代码中,推导式会按如下顺位执行:首先迭代 numbers 中的每一个元素;接着将元素代入左侧的表达式 x ** 2 进行求值;最后将求值结果依次加入集合底层哈希表中,遇到重复值时自动完成覆盖去重。全过程无需手动调用 set.add(),也不需要预先声明一个空集合。
二、在集合推导式中编写过滤条件
集合推导式最常见的使用场景是“批量清洗”,即在提取数据的同时,剔除不符合业务规则的值。过滤子句放在 for 循环之后,只有当该子句的计算结果为真(Truth-value 为 True)时,当前元素才会被传递给最左侧的表达式进行处理。
1. 单一条件过滤
例如,我们需要从一批混杂数据中筛选所有偶数,并生成其绝对值集合:
raw_data = [-6, 3, -2, 0, 7, 2, 4, -2, 9]

# 过滤偶数并取绝对值
even_set = {abs(n) for n in raw_data if n % 2 == 0}

# 输出结果:{0, 2, 4, 6}
print(even_set)
2. 多条件复合过滤与数据清洗
在实际工程中,待处理的数据往往包含空字符串、首尾空白或大小写混用。我们可以在 if 子句中使用逻辑操作符(如 and),或者配合内置方法进行复合清洗:
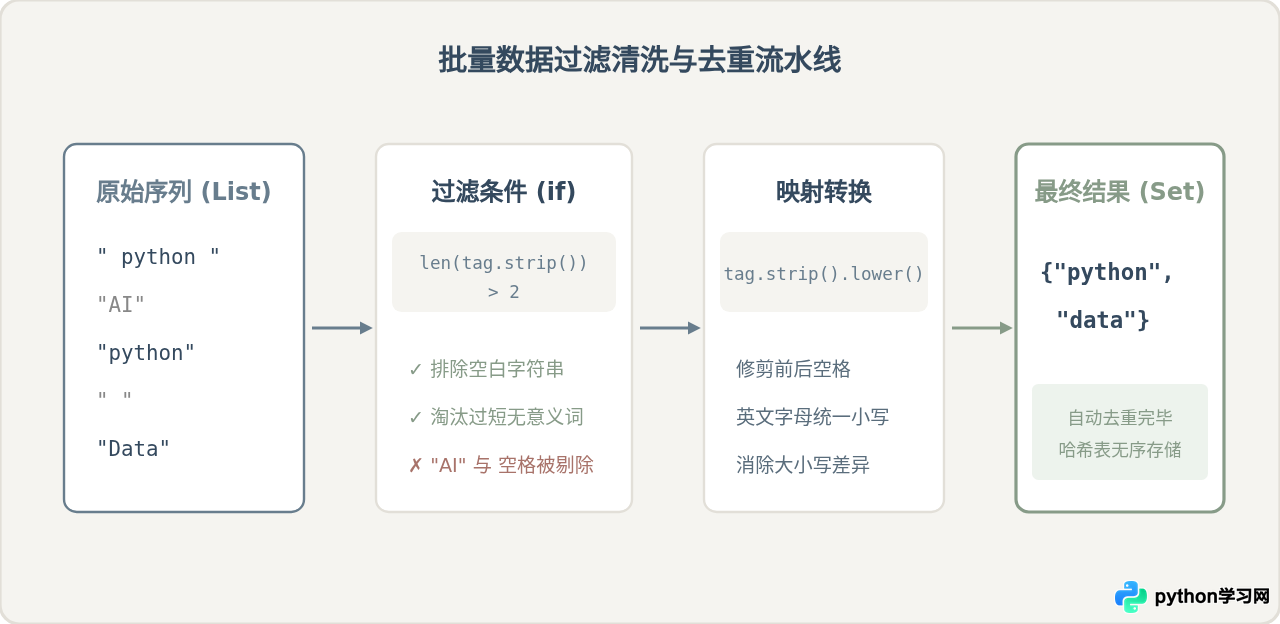
raw_tags = ["  python ", "AI", "python", "", "   ", "Data", "ai", "web"]

# 要求:剔除空字符、长度必须大于2、全部转为小写规范化
clean_tags = {tag.strip().lower() for tag in raw_tags if len(tag.strip()) > 2}

# 输出结果:{'python', 'data'}
print(clean_tags)在该清洗过程中,"python" 与 " python " 经过 strip().lower() 转换后拥有相同的字符串值,在写入集合时自动合为一个唯一元素,实现了清洗、格式规范化与去重一步到位。
三、关键机制差异:为什么集合推导式最高效?
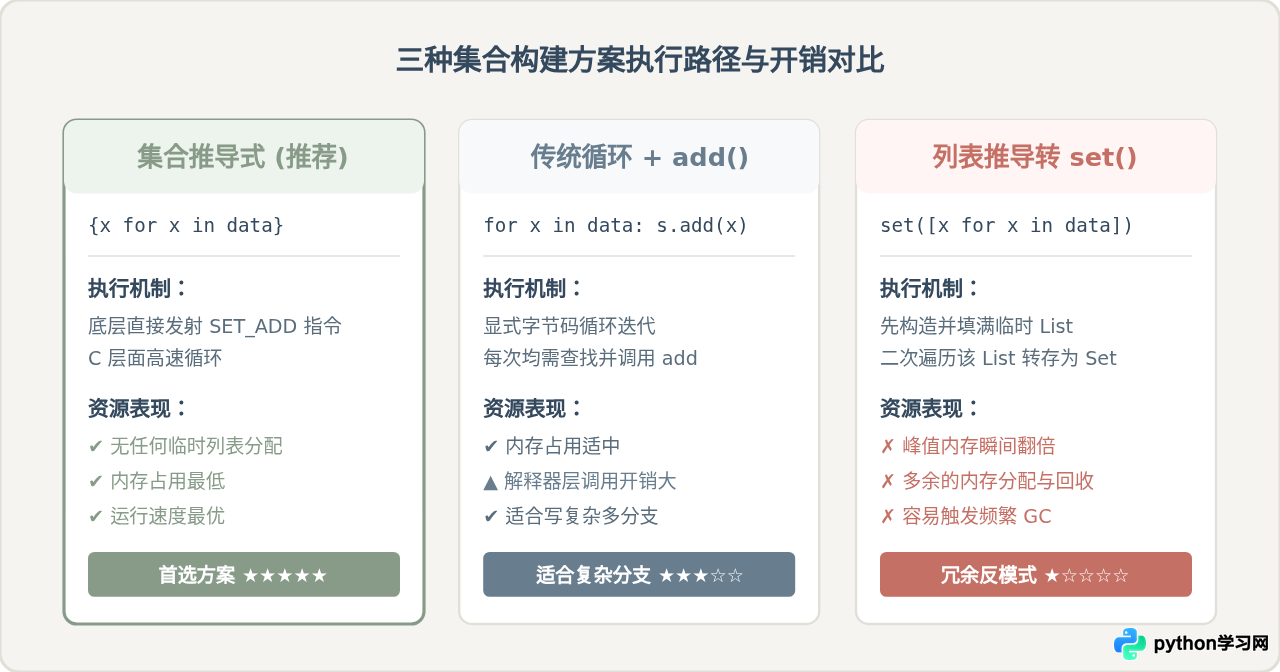
在面对批量生成唯一集合的需求时,开发者通常有三种不同的实现途径:
- 集合推导式:
result = {expr for x in data if cond} - 传统 for 循环 + set.add():显式定义空集合,逐行遍历并调用
add() - 列表推导式外包 set():
result = set([expr for x in data if cond])
理解这三者之间的运行差异,对于编写高质量、高吞吐量的 Python 代码至关重要。
1. 相比传统 for 循环:减少虚拟机指令与方法查找开销
在传统的 for 循环中,每次往集合添加元素都会经历 Python 解释器的方法查找过程(例如反复通过属性查找获取 add 函数对象),且每一次迭代都是一段显式的 Python 虚拟机字节码循环跳转。而在集合推导式中,解释器会生成专门的 SET_ADD 操作码,整个循环迭代是在底层的 C 实现中紧凑运行,避开了多次函数调用堆栈构建,因此执行速度通常能提升 20% 到 40% 左右。
2. 相比列表推导式后转 set():消除峰值内存开销
有些开发者习惯先写 [x for x in data] 生成列表,最后在外面套一层 set(...) 进行去重。这种写法在处理几十万条数据时存在严重的性能陷阱:
- 多余的中间内存占用:Python 会在内存中完整分配整个临时列表,包含所有冗余、重复的数据对象引用。
- 双重遍历开销:列表生成完毕后,
set()构造器必须再对该列表从头到尾进行第二次遍历,逐项计算哈希并填充集合,随后列表才会被垃圾回收器销毁。 - 集合推导式的直接优势:集合推导式从一开始就直接分配底层集合哈希表,元素生成即入集,从始至终不存在中间列表,峰值内存占用大幅降低。
四、进阶用法与常见错误防范
1. 多层嵌套循环(展平二维结构)
与列表推导式类似,集合推导式也支持多层 for 循环,常用于从二维矩阵、词典列表或嵌套数据源中提取去重集合:
matrix = [
    [1, 2, 3],
    [2, 3, 4],
    [3, 4, 5]
]

# 提取矩阵中所有出现的数字去重集合
unique_matrix_elements = {item for row in matrix for item in row}

# 输出结果:{1, 2, 3, 4, 5}
print(unique_matrix_elements)注意顺序原则:多层推导式的顺序与编写常规嵌套 for 循环的外层到内层顺序完全一致(先 for row in matrix,紧接着 for item in row)。虽然语法允许,但建议嵌套不要超过两层,否则代码可读性会急剧下降。
2. 核心注意事项与避坑指南
- 不可混淆空集合与空字典:在 Python 中,字面量
{}代表的是一个空字典(dict),而非空集合。若要初始化一个真正的空集合,必须显式调用set()。但在集合推导式中,花括号内部存在for结构,解释器能明确识别其为推导式,不会产生歧义。 - 元素必须具备可哈希性(Hashable):集合内部依赖哈希表进行定位与判重,因此推导出的元素必须是不可变对象(如整数、浮点数、字符串、元组)。如果尝试将列表(List)或字典(Dict)直接放入集合,解释器会抛出
TypeError: unhashable type: 'list'异常。 - 不要把复杂业务副作用写进推导式:推导式应聚焦于“数据变换与过滤”的纯计算。避免在表达式中调用具有文件写入、网络请求等严重副作用的操作。
五、总结
集合推导式是 Python 提供给开发者的声明式利器。当你面临“过滤脏数据、统一转换格式、消除重复值”这类典型数据预处理任务时,集合推导式是最符合 Python 惯用写法(Pythonic)的首选工具。在日常编写代码时,记住以下三条选用准则:
- 需要去重结果时,直接使用
{...}集合推导式,坚决避免使用set([...])产生无谓的中间列表开销; - 过滤逻辑尽量控制在单行表达清晰的范围内,复杂的嵌套过滤建议拆分为辅助判断函数;
- 时刻关注入集元素的可哈希性,避免因嵌套动态容器导致运行时错误。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









