

Python集合推导式语法详解与实战案例

在日常数据处理中,从一段包含大量重复项或格式混乱的数据中快速提取无重复、已清洗的目标元素,是 Python 开发者经常面临的高频任务。Python 集合推导式(Set Comprehension)通过大括号和内置循环语法的结合,让开发者能够在一行清晰易读的代码中同时完成“数据提取、条件过滤、格式转换与自动去重”四大操作。本文将从核心概念、语法规则、执行流程、实战案例到避坑指南展开详尽解析,帮助你彻底掌握这一高效工具。
一、集合推导式核心语法与工作机制
集合推导式在形式上与列表推导式非常接近,但其外层使用的是花括号 {},且计算生成的结果是一个无序且元素互不重复的 set 集合对象。
其标准语法结构如下:
{expression for item in iterable if condition}各部分语法要素的具体含义为:
expression(表达式):针对每个符合条件的元素进行计算或变换的操作,其运算结果将作为放入集合的元素。for item in iterable(循环迭代):遍历可迭代对象(如列表、元组、字符串或字典)的基础循环子句。if condition(过滤条件,可选):布尔判断子句,仅当条件为True时,当前元素才会被交付给表达式处理并存入集合。
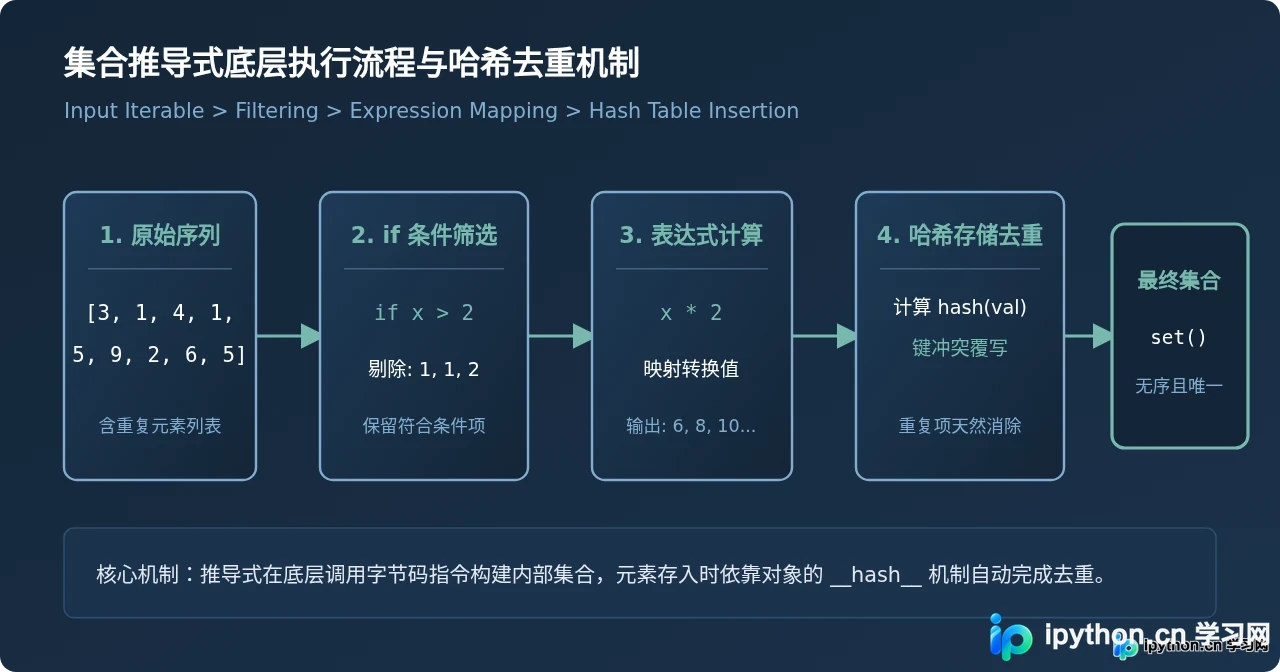
为了直观展现集合推导式从输入到最终产出的全流程,下图描绘了底层执行管道与哈希去重逻辑:
二、集合推导式的构建步骤与代码对比
初学者在学习推导式时,常将集合推导式与传统 for 循环混淆。实际上,推导式是传统循环构造集合的高级语法糖,但在底层字节码执行上效率更高,避免了显式调用 set.add() 的属性查找开销。
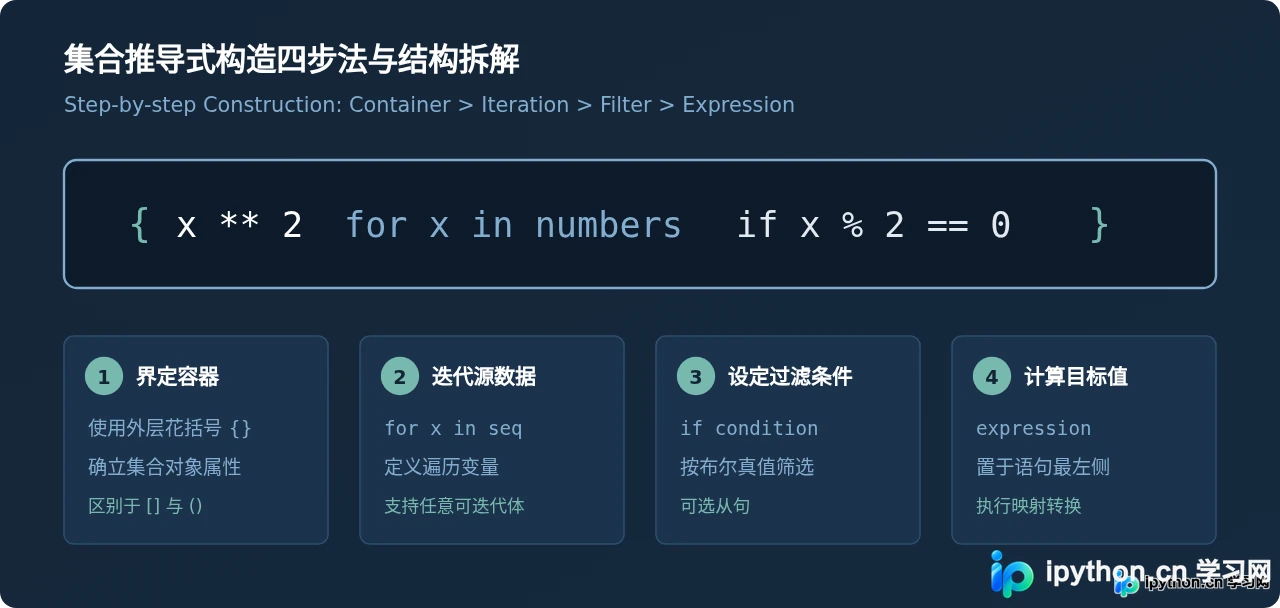
我们可以按照以下四个步骤来构造一个规范的集合推导式:
- 确定最终输出形态:写下外层花括号
{},明确结果类型为集合。 - 确定数据源与循环变量:写出循环子句
for x in source_data。 - 确定过滤规则:如需排除某些元素,追加
if condition(x)条件。 - 确定最终表达式:在最左侧放置要输出的元素或变换表达式
transform(x)。
对比传统循环写法与集合推导式的代码表达:
# 传统循环写法:需要手动实例化并显式调用 add()
numbers = [1, 2, 2, 3, 4, 4, 5, 6]
squares_set = set()
for x in numbers:
    if x % 2 == 0:
        squares_set.add(x ** 2)

# 集合推导式写法:一行完成,语义紧凑
squares_set = {x ** 2 for x in numbers if x % 2 == 0}
# 结果示例: {4, 16, 36}
三、集合推导式典型实战案例
案例 1:文本数据清洗与大小写归一化去重
在从日志、爬虫或表单输入中获取标签列表时,常常存在首尾空格未剔除、大小写混用导致同义标签重复的问题。使用集合推导式可以一步实现格式规范化与唯一化:
raw_tags = [" Python ", "python", "DJANGO", "Django ", "Flask", "flask ", "API"]

# 统一转为小写并剔除首尾空白字符
clean_tags = {tag.strip().lower() for tag in raw_tags if tag.strip()}

# 示例输出:{'python', 'django', 'flask', 'api'}
print("清洗后标签集合:", clean_tags)
案例 2:从对象集合中提取唯一属性
处理业务对象或字典列表时,常常需要获取所有用户的唯一部门代码或省份名称:
employees = [
    {"name": "Alice", "dept": "Engineering"},
    {"name": "Bob", "dept": "HR"},
    {"name": "Charlie", "dept": "Engineering"},
    {"name": "David", "dept": "Finance"},
    {"name": "Eva", "dept": "HR"},
]

# 提取所有不重复的部门名称
departments = {emp["dept"] for emp in employees}

# 示例输出:{'Engineering', 'HR', 'Finance'}
print("企业部门集合:", departments)
案例 3:多重嵌套循环展开与全排列过滤
集合推导式支持多层 for 循环,用于寻找组合、笛卡尔积或网格点,同时消除重复项:
colors = ["Red", "Green"]
sizes = ["M", "L", "M"]

# 获取所有不重复的颜色与尺寸组合(元组)
sku_combinations = {(c, s) for c in colors for s in sizes}

# 示例输出:{('Red', 'M'), ('Red', 'L'), ('Green', 'M'), ('Green', 'L')}
print("SKU唯一组合:", sku_combinations)
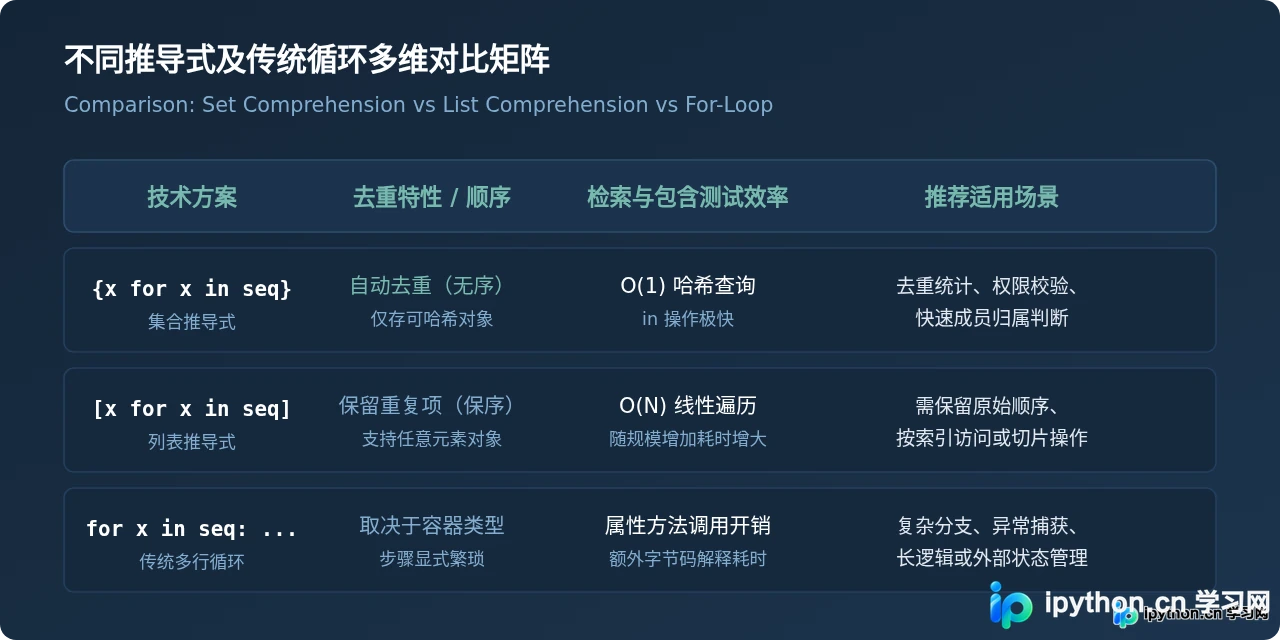
四、集合推导式 vs 列表推导式 vs 传统循环对比
在不同场景下选择合适的数据结构与构造方式,是衡量代码质量的关键。集合推导式适合需要去重且不依赖顺序的场景,列表推导式适合保留原顺序与重复项,而字典推导式用于键值对映射。
五、常见避坑指南与最佳实践
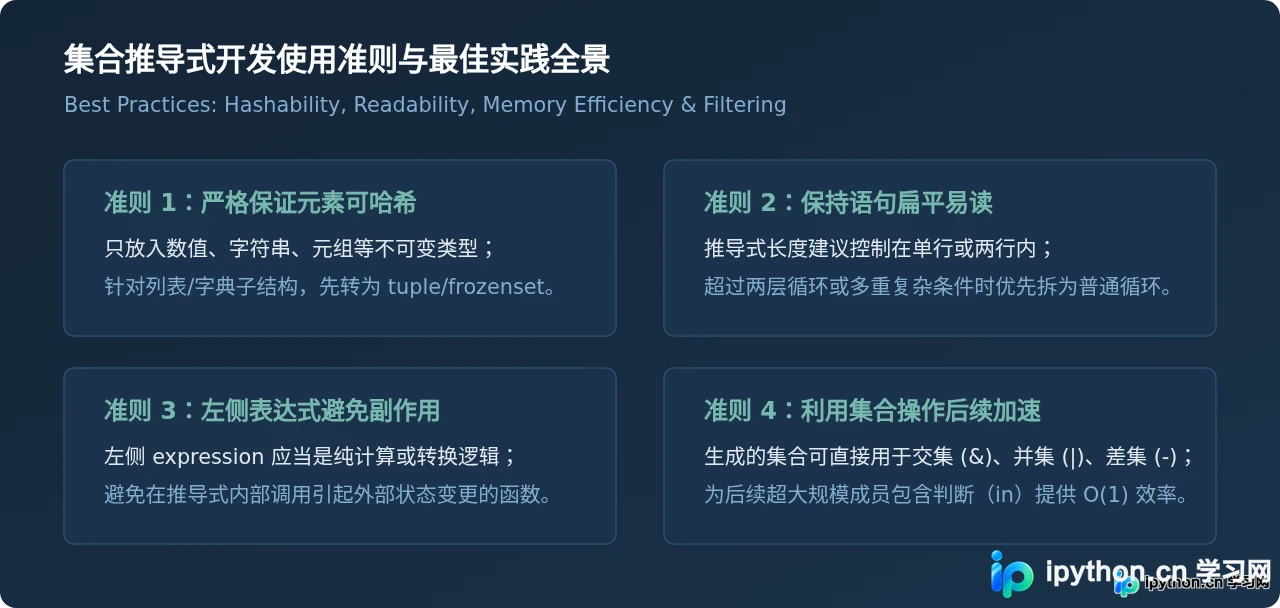
Python 中的
set 底层基于哈希表构建,因此集合内的每个元素都必须具备合法的 __hash__ 方法。列表 list、字典 dict 和集合 set 等可变对象是不可哈希的,直接放入集合推导式会导致 TypeError: unhashable type。
# 错误示例:试图将列表放入集合推导式
# data = [[1, 2], [2, 3], [1, 2]]
# bad_set = {item for item in data}  # 触发 TypeError: unhashable type: 'list'

# 正确做法:转换为不可变且可哈希的 tuple(元组)
data = [[1, 2], [2, 3], [1, 2]]
safe_set = {tuple(item) for item in data}
# 示例输出:{(1, 2), (2, 3)}在 Python 中,单独的一对大括号
{} 表示的是空字典(dict)而不是空集合。如果推导式没有匹配到任何元素,例如 {x for x in []},其运算结果依然会正确返回空集合 set();但如果需要直接声明一个空集合,请务必使用 set() 而非 {}。
尽管语法上支持多层
for 与多重 if,但当推导式超过两层嵌套时,代码的可读性会迅速下降。此时建议拆分为显式的普通循环或辅助生成函数。
六、总结
Python 集合推导式将迭代遍历、逻辑过滤、数据映射与哈希去重有机地融为一体,是编写地道、高性能 Python 代码的重要利器。在面对无序唯一数据清洗、字段抽取、黑白名单预处理等需求时,合理运用 {expr for item in iterable if cond} 结构,不仅能显著减少临时变量与样板代码,还能借助解释器底层优化提升执行效率。在实际编码中,只要谨记“元素必须可哈希”与“避免过度嵌套”两条核心底线,就能游刃有余地写出健壮优雅的数据处理逻辑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









