

Python自动化测试怎么实现数据驱动(DDT)
全面讲解Python自动化测试中数据驱动(DDT)的实现原理与落地方法,涵盖pytest参数化、外部YAML/JSON文件驱动、unittest+ddt实战及工程化避坑指南。
假设我们正在为一套用户管理系统编写登录接口自动化测试:测试用例包括“正确用户名密码成功登录”、“密码错误登录失败”、“用户名不存在”、“密码为空”等数种不同场景。如果为每个场景都独立编写一个测试函数,测试代码中除了传入的参数和断言的返回码不同之外,发起网络请求、解析响应、验证基础结构的代码几乎完全重复。当接口地址或字段名称发生微调时,就需要逐行修改十几个测试函数。针对这种代码冗余和维护成本高的问题,数据驱动测试(Data-Driven Testing,简称 DDT)提供了最直接的解决方案:将“测试执行逻辑”与“测试输入及预期数据”彻底分离,由单一测试函数复用相同的执行流程,测试框架根据提供的数据集合动态循环生成并执行每条独立的测试用例。
一、数据驱动测试的核心原理与架构解耦
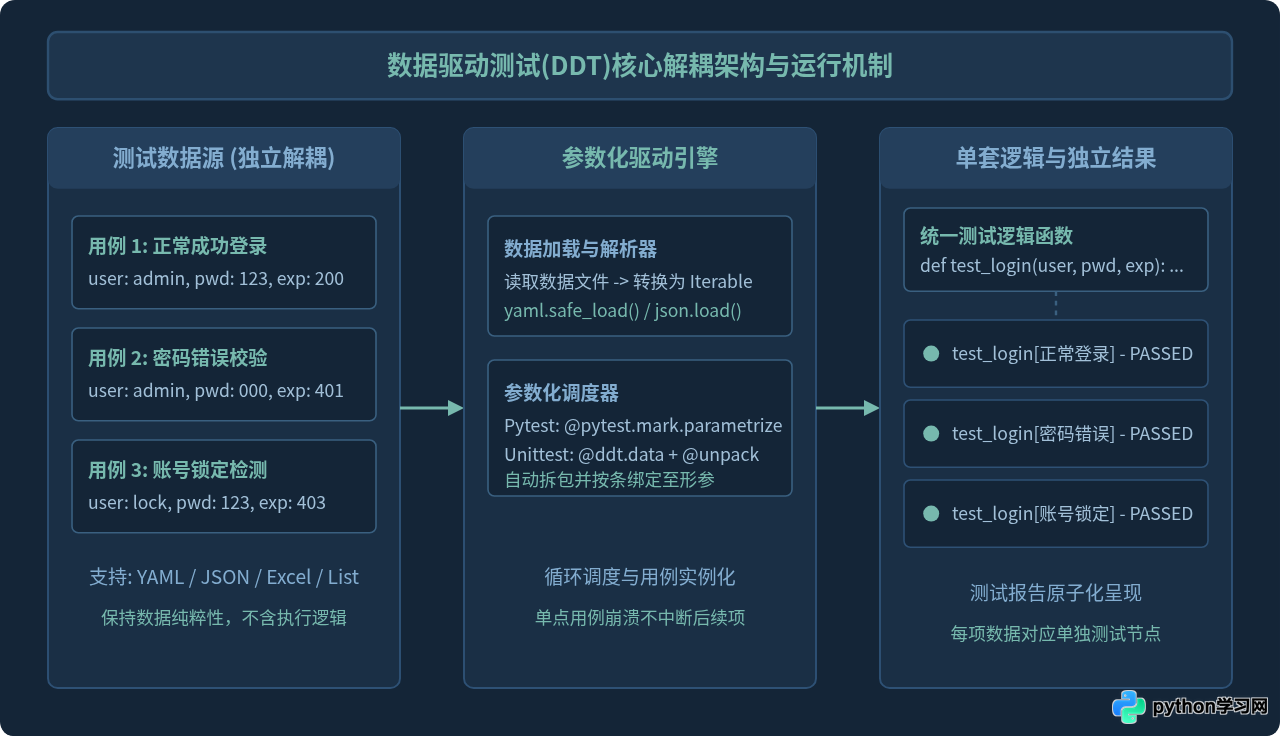
数据驱动测试的核心目标是“逻辑单例化、数据集合化”。在传统的测试组织形式中,数据被硬编码在测试方法体内;而在数据驱动模式下,测试方法演变为一个通用的执行模板,它定义了变量形参(如 username、password、expected_code),而具体的测试数据则存放于外部文件(如 YAML、JSON、Excel)或内存列表中。测试运行期间,驱动引擎负责按条读取数据,并将每组数据逐一注入测试方法,从而在测试报告中产生相互独立的执行记录与断言统计。
二、主流实现方案:Pytest 原生参数化驱动
在当前 Python 自动化测试技术栈中,pytest 已经成为事实上的标准工具。它不需要依赖第三方扩展,内置提供的装饰器 @pytest.mark.parametrize 即可优雅实现数据驱动。
1. 内存列表多参数驱动
最简单的参数化方式是在 Python 代码中直接定义由元组构成的列表。测试函数的形参与装饰器中声明的字符串名称一一对应:
import pytest

# 模拟被测登录验证函数
def login_service(username, password):
    if not username or not password:
        return {"code": 400, "message": "参数不能为空"}
    if username == "admin" and password == "123456":
        return {"code": 200, "message": "登录成功"}
    return {"code": 401, "message": "用户名或密码错误"}

# 测试数据定义:每条元组对应 (username, password, expected_code)
test_cases = [
    ("admin", "123456", 200),
    ("admin", "wrong_pwd", 401),
    ("", "123456", 400),
    ("admin", "", 400),
]

@pytest.mark.parametrize("username, password, expected_code", test_cases)
def test_login_builtin(username, password, expected_code):
    result = login_service(username, password)
    assert result["code"] == expected_code
执行该测试文件时,pytest 会自动识别到 4 组数据,并将 test_login_builtin 展开为 4 个独立的测试任务执行。即便其中某一条用例因断言失败报错,也不会影响其他用例的运行。
2. 使用外部 YAML 文件实现真正的数据解耦
在企业级项目中,测试数据通常由业务或测试人员维护,直接将海量数据写在 Python 代码中会导致代码文件臃肿。业界通常使用 YAML 格式来维护外部测试数据,因为 YAML 原生支持多行文本、注释和层级结构。
首先在项目目录下建立数据文件 data/login_cases.yaml:
- case_id: "TC01"
  title: "正常凭据登录"
  username: "admin"
  password: "correct_password"
  expected_code: 200

- case_id: "TC02"
  title: "错误密码拦截"
  username: "admin"
  password: "bad_password"
  expected_code: 401

- case_id: "TC03"
  title: "未输入用户名"
  username: ""
  password: "correct_password"
  expected_code: 400
接下来在测试模块中编写数据加载方法,并配合 ids 参数使测试报告展示更易读的中文标题:
import pytest
import yaml
from pathlib import Path

def load_yaml_cases(file_path):
    path = Path(file_path)
    with path.open(encoding="utf-8") as f:
        return yaml.safe_load(f)

# 加载测试数据集
raw_cases = load_yaml_cases("data/login_cases.yaml")

# 提取用例执行参数与报告标签 ids
case_data = [(item["username"], item["password"], item["expected_code"]) for item in raw_cases]
case_ids = [f"{item['case_id']}_{item['title']}" for item in raw_cases]

@pytest.mark.parametrize("username, password, expected_code", case_data, ids=case_ids)
def test_login_from_yaml(username, password, expected_code):
    # 模拟实际调用
    result = login_service(username, password)
    assert result["code"] == expected_code
使用命令 pytest -v test_login.py 运行测试,控制台输出将清晰呈现每条用例的自定义标识:
test_login.py::test_login_from_yaml[TC01_正常凭据登录] PASSED
test_login.py::test_login_from_yaml[TC02_错误密码拦截] PASSED
test_login.py::test_login_from_yaml[TC03_未输入用户名] PASSED
三、基于 Pytest 实现数据驱动的标准实施流程
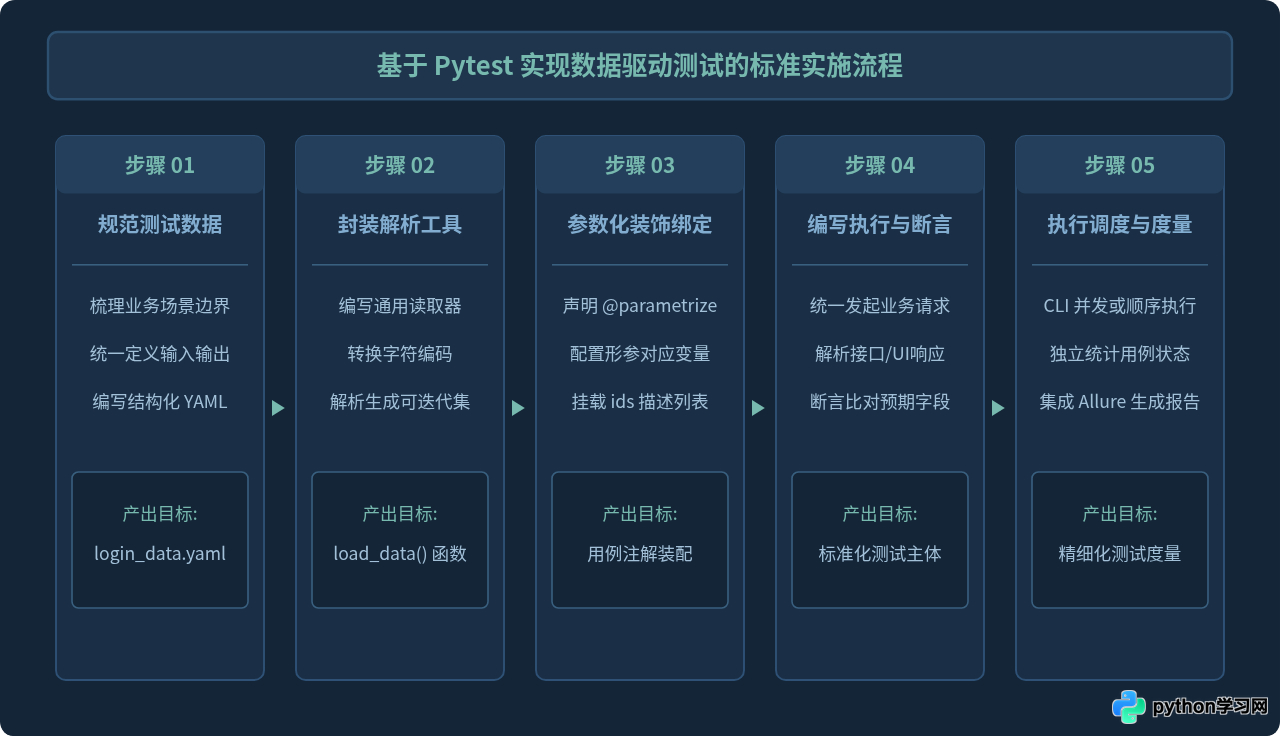
落地一套规范的数据驱动测试框架,需要遵循标准化的流水线步骤。从测试资产的分离规划、工具解析器的编写,到测试用例的装配与结果输出,各个环节需保持严密的逻辑闭环。
四、方案二:基于 Unittest 与 ddt 库的传统实现
如果维护的是基于 Python 原生 unittest 框架构建的历史遗留系统,由于 unittest 自身并没有内置参数化机制,通常会搭配第三方库 ddt(Data-Driven Tests)使用。
首先通过包管理工具安装依赖:
pip install ddt在代码中,需要在测试类上方标记 @ddt.ddt,在测试方法上方使用 @ddt.data() 传入数据集。若每条数据包含多个元素,还需配合 @ddt.unpack 进行解包:
import unittest
import ddt

# 假设的计算模块或业务验证函数
def calculate_discount(user_level, amount):
    if user_level == "VIP":
        return amount * 0.8
    elif user_level == "NORMAL":
        return amount * 0.95
    return amount

@ddt.ddt
class TestDiscountDDT(unittest.TestCase):

    # 1. 单参数驱动:每次传递单个值
    @ddt.data("VIP", "NORMAL", "GUEST")
    def test_level_validity(self, level):
        self.assertIn(level, ["VIP", "NORMAL", "GUEST"])

    # 2. 多参数解包驱动:每条元组解构成 (user_level, amount, expected)
    @ddt.data(
        ("VIP", 100, 80.0),
        ("NORMAL", 100, 95.0),
        ("GUEST", 100, 100.0)
    )
    @ddt.unpack
    def test_discount_calculation(self, user_level, amount, expected):
        actual = calculate_discount(user_level, amount)
        self.assertEqual(actual, expected)

if __name__ == "__main__":
    unittest.main(verbosity=2)
ddt 的底层原理是在类加载阶段利用 Python 元编程动态生成新的测试方法名(如 test_discount_calculation_1_VIP、test_discount_calculation_2_NORMAL),从而满足 unittest 发现和独立报告的要求。
五、常见外部数据源选型对比与决策
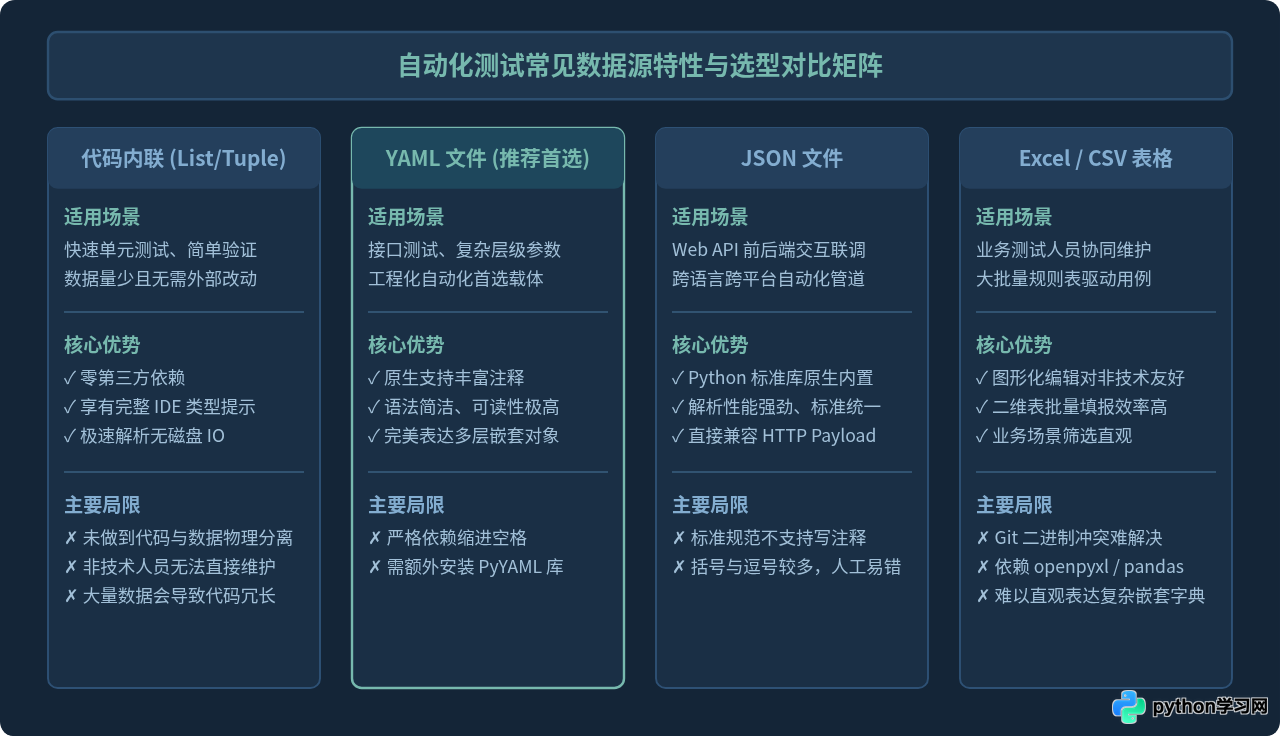
在设计自动化测试框架时,选择哪种数据载体直接决定了维护效率。常见的数据源包括内联数据、YAML、JSON 以及 Excel/CSV 表格,各自具备明确的优劣势和适用边界。
六、工程化落地关键规范与避坑要点
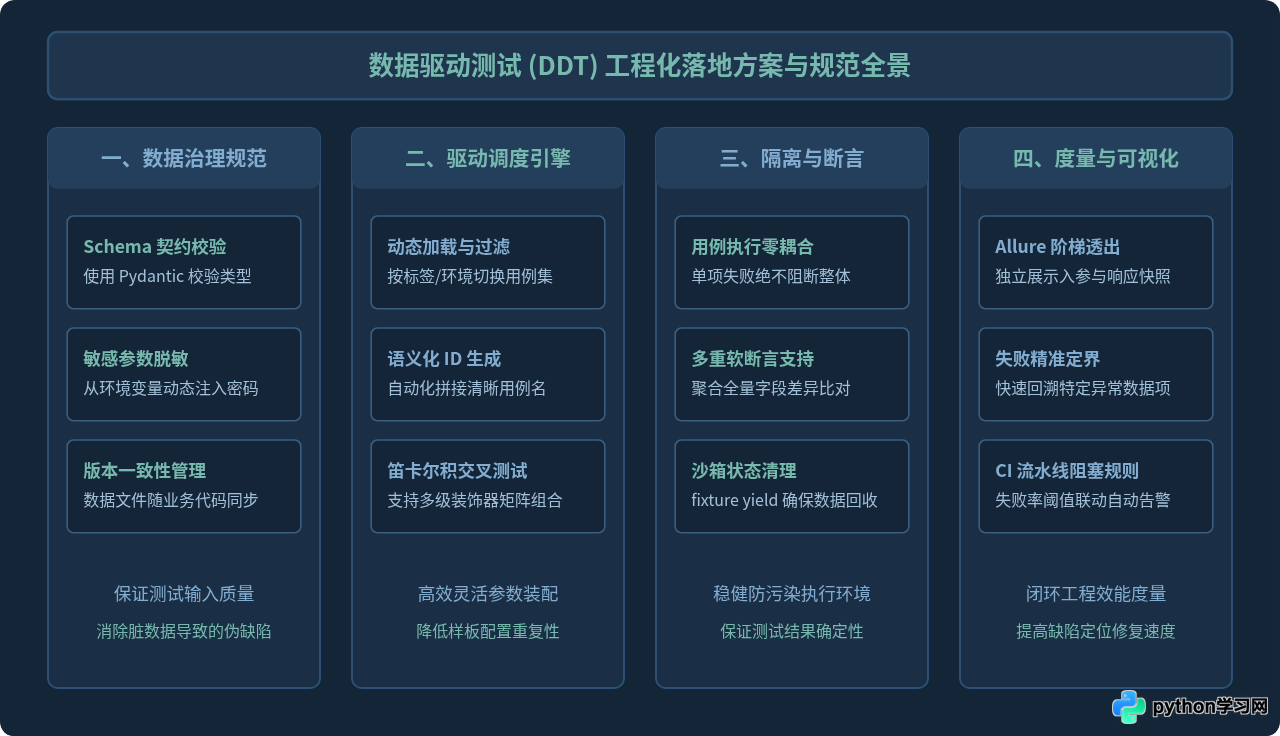
虽然数据驱动的语法实现相对清晰,但在大型项目持续集成(CI/CD)环境下,如果缺乏严密的工程规范,容易出现测试报告不可读、用例互相污染或敏感信息泄露等隐患。以下为实际落地中的核心控制点:
- 确保每项数据的原子性与独立性:数据驱动展开的每一个子用例都应该是完全自闭合的。严禁将“前置用例创建的数据 ID”隐式传递给下一条数据使用。如果必须测试关联流程,应该将其组织为专门的场景流,而非单接口的数据驱动列表。
- 强制使用显式 ID(避免中文转义):在 pytest 中使用
@pytest.mark.parametrize时,如果传入的ids包含中文字符,默认可能会被编码为 Unicode 字符集(如\u4e2d\u6587)。在pytest.ini配置文件中添加配置项disable_test_id_escaping_and_forfeit_all_rights_to_community_support = true,或者在conftest.py中实现pytest_collection_modifyitems钩子函数,可使控制台和报告完美显示原生中文。 - 解耦机密凭证:绝不要将真实的数据库密码、云平台 AccessKey 或支付私钥明文提交至公共 Git 仓库中的 YAML/JSON 文件中。敏感数据应当在数据文件中预留占位符(如
${AUTH_TOKEN}),在解析函数中通过os.getenv()动态完成环境变量注入。 - 空值与数据类型的强校验:YAML 和 Excel 在处理空字符串、
null、0以及科学计数法格式时容易出现类型隐式转换。在封装数据加载器时,建议使用 Pydantic 或 dataclass 对读取出来的字典进行 Schema 严格校验,确保传入测试方法的参数类型符合预期。
七、总结
实现 Python 数据驱动测试的精髓在于“让代码保持稳定,让数据自由延展”。新项目应当优先采用 pytest 及其原生自带的 @pytest.mark.parametrize 装饰器,结合 YAML 作为数据存储格式,形成兼顾可读性、维护性与扩展性的轻量级架构;而在旧系统改造中,借助 ddt 库亦能以最小成本完成数据与逻辑的彻底解耦。通过遵循用例独立性原则、规范用例标识以及做好敏感信息管理,数据驱动能够有效缩短测试脚本开发周期,并显著提升自动化测试体系的健壮性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









