

Python数据类型有哪些:内置类型完整分类与示例
全面梳理Python官方内置数据类型的分类体系,涵盖数字、序列、文本、映射、集合与布尔类型,深入剖析可变性与内存机制,并提供精炼代码示例与类型选择决策指南。
在 Python 中,所有数据在底层均以对象(Object)形式存在,而数据类型定义了对象所能承载的值域、支持的运算符以及内存中的分配与修改规则。Python 的内置类型体系严密而精炼,官方标准库主要将其划分为六大核心类别:数值类型、序列类型、文本序列、映射类型、集合类型以及二进制序列与单例对象。深入掌握这些内置类型的分类特征、可变性差异及运算边界,是写出健壮、高效 Python 代码的坚实基础。
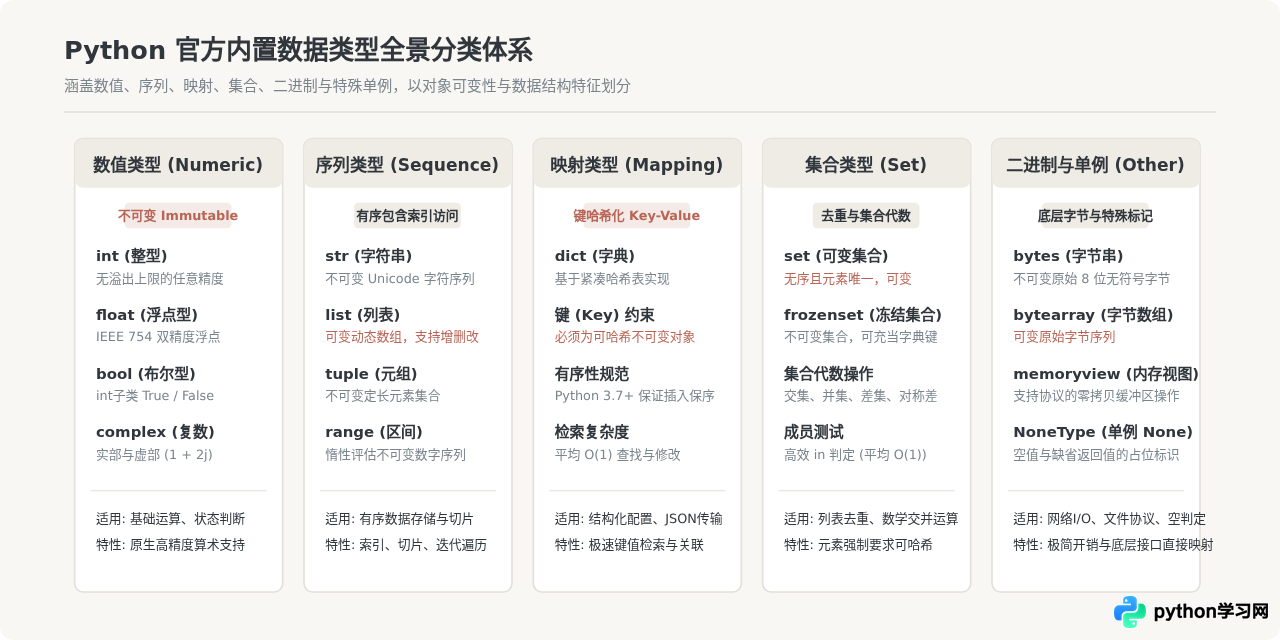
一、Python 内置数据类型全景分类
理解 Python 数据类型,最直接且科学的方法是依据其数据结构特征与底层内存行为(可变性)进行双重分类。不可变对象在初始化后其内存值无法就地修改,任何变更操作均会分配新对象;而可变对象则支持原地增删与修改,其内存标识(ID)在操作生命周期中保持恒定。
二、数值类型(Numeric Types):数值计算与布尔逻辑
Python 提供了四种基础数值类型:int、float、bool 与 complex。所有数值类型在底层均为不可变对象,对数值的运算结果会返回全新的对象。
1. 整数(int)
在 Python 3 中,传统的 int 与 long 已完全合并。Python 3 的整数具有任意精度(Arbitrary-precision)特征,仅受限于可用系统内存,不会像 C、Java 那样发生 32 位或 64 位整型溢出。
# 示例:整数任意精度特性验证
big_int = 2 ** 100
print(big_int)  # 输出: 1267650600228229401496703205376
print(type(big_int))  # 输出: <class 'int'>
2. 浮点数(float)与复数(complex)
float 基于底层 C 语言的 double 实现,遵循 IEEE 754 双精度浮点数标准(53 位二进制精度,约等于 15 到 17 位十进制有效数字)。由于二进制无法精确表示所有十进制小数,浮点计算存在微小截断误差。
# 浮点数运算与精度注意点
val = 0.1 + 0.2
print(val)  # 输出示例: 0.30000000000000004
print(val == 0.3)  # 输出: False

# 金融或高精度计算需使用 decimal 模块替代
from decimal import Decimal
d_val = Decimal('0.1') + Decimal('0.2')
print(d_val == Decimal('0.3'))  # 输出: True

# 复数表示法(以 j 或 J 结尾标识虚部)
comp = 3 + 4j
print(comp.real, comp.imag)  # 输出: 3.0 4.0
3. 布尔类型(bool)
布尔类型是整数类型的子类(issubclass(bool, int) 返回 True),仅有两个单例值:True(等价于整数 1)与 False(等价于整数 0)。
print(isinstance(True, int))  # 输出: True
print(True + True)            # 输出: 2 (参与算术运算时自动转为数值 1)
三、序列与文本类型(Sequence & Text Types):有序数据组织
序列类型是具备位置顺序的数据集合,支持正负整数索引、分段切片(slicing)、拼接与成员检索(in 运算符)。
1. 字符串(str)
str 是不可变的 Unicode 字符序列。Python 内部根据字符串中所含最高码位自动选用 1 字节(Latin-1)、2 字节(UCS-2)或 4 字节(UCS-4)内存存储紧凑表示,兼顾了国际化支持与内存经济性。
text = "Python数据类型"
print(text[0])       # 输出: 'P'
print(text[6:])      # 输出: '数据类型'
# text[0] = 'J'      # 触发 TypeError: 'str' object does not support item assignment
2. 列表(list)与元组(tuple)
list 与 tuple 都是异构元素的有序序列,可以容纳任意类型的对象指针。两者的核心分水岭在于可变性:
- 列表(list):动态数组实现,容量可根据需要自动倍增预分配,支持
append()、pop()等原地变更操作。 - 元组(tuple):定长且不可变,一旦创建内存即固化。由于没有额外的容量预分配开销,元组在结构创建与垃圾回收时比列表更轻量,且可以安全地用作字典的键或集合的元素。
# 列表操作示例
lst = [10, "alpha", 3.14]
lst.append(99)
lst[0] = 100
print(lst)  # 输出: [100, 'alpha', 3.14, 99]

# 元组操作示例
tup = (10, "alpha", 3.14)
print(tup[1])  # 输出: 'alpha'
# tup[0] = 20  # 触发 TypeError: 'tuple' object does not support item assignment
3. 范围对象(range)
range 表示不可变的等差数字序列。它不会在内存中预先生成全部数字,而是通过起始值、步长和索引进行惰性计算,因此无论 range(10) 还是 range(10**9),其占用的内存大小始终恒定为几十个字节。
import sys
r1 = range(10)
r2 = range(10**8)
print(sys.getsizeof(r1), sys.getsizeof(r2))  # 两者均仅占用约 48 字节
四、映射与集合类型(Mapping & Set Types):高效哈希检索
映射与集合基于底层高度优化的哈希表(Hash Table)实现,其核心优势是在理想状态下提供 \(O(1)\) 时间复杂度的键值查找与元素存在性检验。
1. 字典(dict)
字典是 Python 最核心的数据结构,代表无序或插入保序的键值对集合。从 Python 3.7 开始,字典在语言规范层面上正式保证了插入顺序(Insertion Order)。字典的键必须属于可哈希对象(Hashable),即其生命周期内哈希值保持恒定并实现了 __hash__() 和 __eq__() 方法。
user = {"id": 1001, "name": "Alice", "role": "admin"}
user["email"] = "alice@example.com"  # 插入新键值对
print(user.get("name"))              # 输出: Alice
print(list(user.keys()))             # 输出插入顺序保持的列表: ['id', 'name', 'role', 'email']
2. 集合(set)与冻结集合(frozenset)
集合是无序且元素不重复的容器:
set:支持原地增删元素(add()、remove()),属于可变对象,因此自身不可哈希,不能嵌套进其他集合或充当字典键。frozenset:不可变集合,在初始化后无法更改。因其具备哈希值,可作为外层字典的键或嵌套集合的元素。
# 集合运算与去重示例
a = {1, 2, 3, 4}
b = {3, 4, 5, 6}
print(a & b)  # 交集: {3, 4}
print(a | b)  # 并集: {1, 2, 3, 4, 5, 6}
print(a - b)  # 差集: {1, 2}

# frozenset 作为字典键
fs = frozenset([1, 2, 3])
cache = {fs: "cached_result"}
print(cache[fs])  # 输出: 'cached_result'
五、二进制序列与空值类型
对于文件系统底层 I/O、网络套接字通讯及高性能数据交换,Python 提供了专门处理原始字节的类型:
bytes:不可变 8 位无符号字节序列(取值范围 0~255),字面量以b"..."声明。bytearray:可变字节序列,允许原地更新字节值,常用于大文件块就地处理。memoryview:内存视图,允许在不产生数据内存拷贝的前提下对支持缓冲区协议的对象进行切片与共享。NoneType:内置单例类型,其唯一实例为None,用于表示无值、缺失数据或函数的默认返回值。
raw_bytes = b"Hello\x00\xFF"
b_arr = bytearray(raw_bytes)
b_arr[0] = ord('h')  # 原地修改第一个字节
print(b_arr)         # 输出: bytearray(b'hello\x00\xff')

# None 的身份判定推荐使用 is 运算符
result = None
if result is None:
    print("操作未返回有效结果")
六、底层机制剖析:可变对象与不可变对象的内存行为
在 Python 中,变量名本质上是指向内存对象的标签(引用),而非容纳数据的固定格子。不可变类型与可变类型的根本区别,直观体现在对变量进行修改操作时内存地址(id())的变化规律。
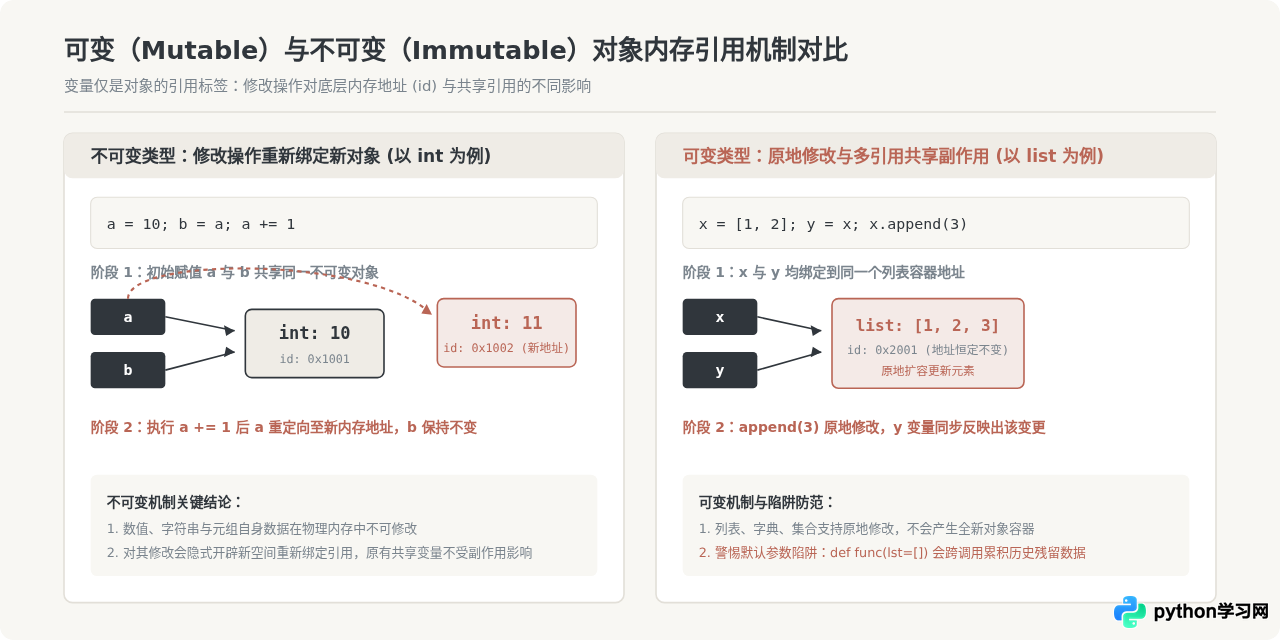
函数的默认参数在函数定义时完成求值并保存在函数的 __defaults__ 属性中。如果将列表或字典等可变类型作为默认参数(如 def append_item(val, container=[])),连续多次调用该函数将共享同一个容器对象,导致意外的状态污染。正确的做法是以 None 作为哨兵值,并在函数体内部动态判定并初始化。
七、实战选型:如何根据数据特征与业务场景选择最佳类型
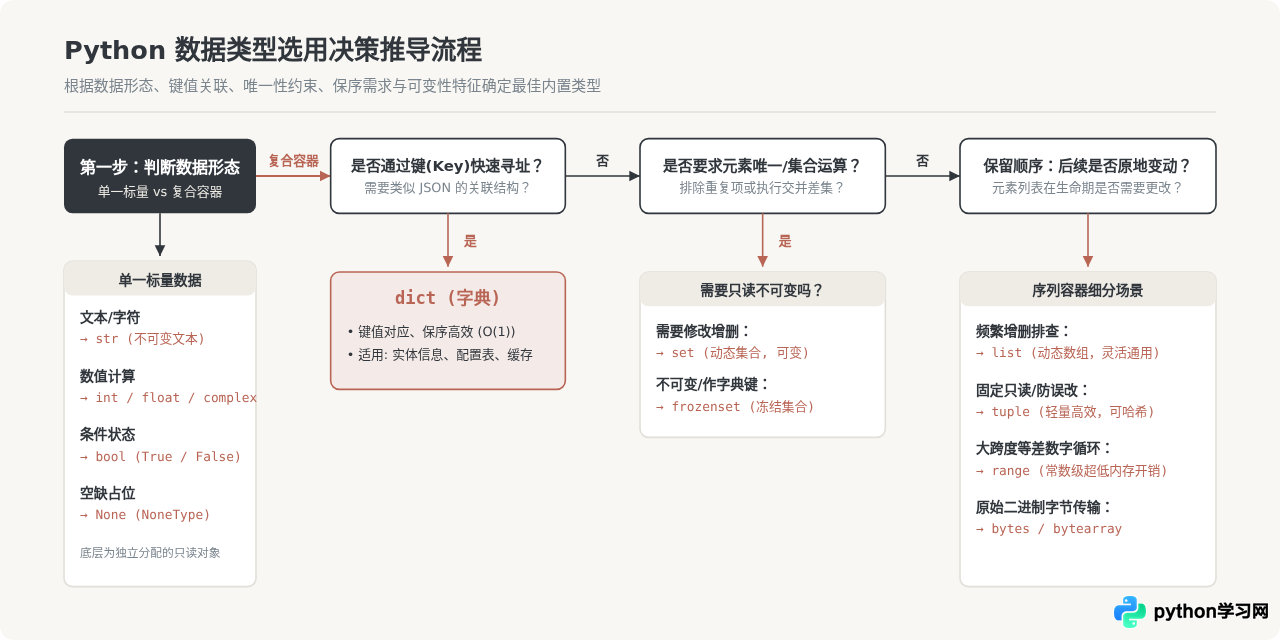
在面对具体的业务需求时,合理选择数据类型能显著减少内存开销并提升计算性能。通常可以依照维度形态、去重需求、是否保序以及原地修改频度等决策路径进行甄选。
八、核心内置类型速查与最佳实践
在日常开发与工程维护中,遵循标准的数据类型检查与操作规范能够规避绝大多数隐蔽缺陷:
- 类型检查规范:优先使用
isinstance(obj, cls)进行类型校验,尽量避免使用type(obj) == cls。因为isinstance()正确支持类的继承层级关系(例如isinstance(True, int)为True)。 - 单例比较:检查变量是否为
None时,必须使用is或is not,切勿使用== None,防止被自定义类中重写的__eq__方法误导。 - 浅拷贝与深拷贝:可变容器(如列表、字典)的
copy()或切片[:]仅为浅拷贝(Shallow Copy)。如果容器内部嵌套了其他可变对象,修改嵌套层仍会产生联动,此时应使用copy.deepcopy()。
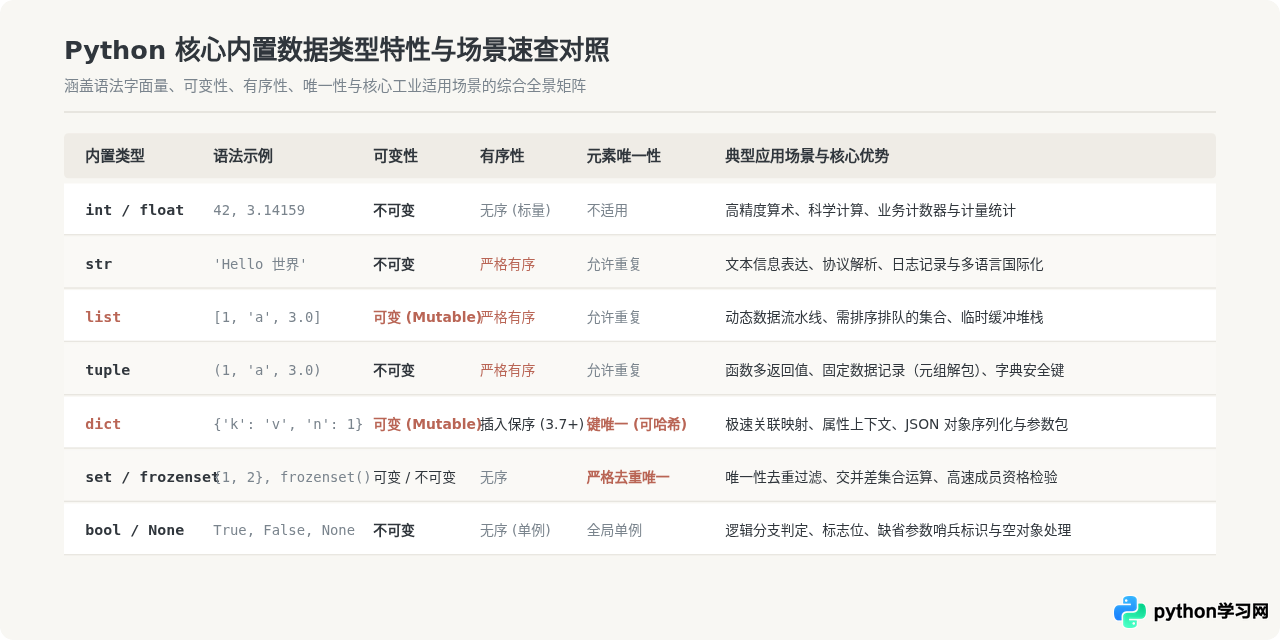
综上所述,Python 的内置数据类型并非孤立存在,而是共同构成了严整的对象生态。在工程实践中,围绕业务场景的数据是否需要改变(可变性)、是否依赖先后索引(序列保序)、是否需要高速键值查找或成员去重(哈希与集合),可以精准敲定最适配的类型组合,从而打造出兼具可读性与高运行效率的高质量 Python 应用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









