

Python中哪些数据类型支持遍历操作

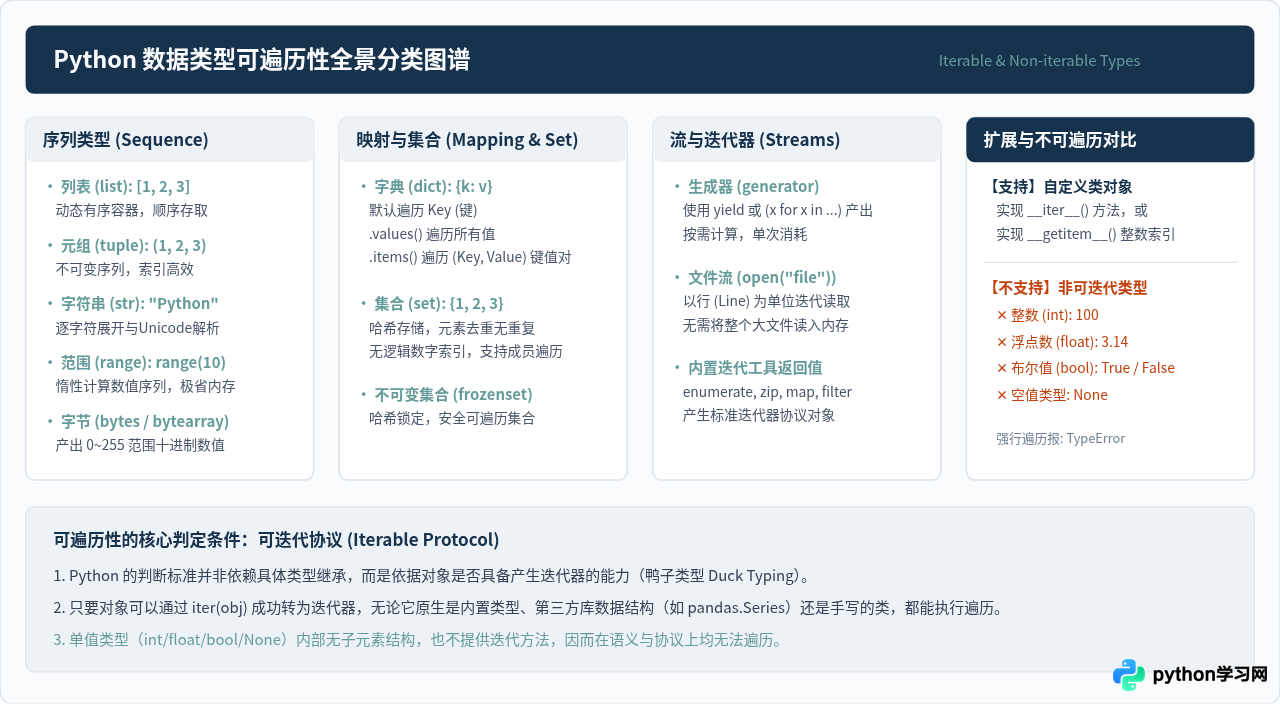
在 Python 中,所有实现了“可迭代协议(Iterable Protocol)”的数据类型都支持遍历操作,即可以直接放在 for ... in ... 循环中使用。核心支持遍历的内置类型包括:序列类型(列表 list、元组 tuple、字符串 str、范围对象 range、字节序列 bytes 等)、映射类型(字典 dict)、集合类型(集合 set、不可变集合 frozenset)以及流式与迭代生成对象(迭代器 iterator、生成器 generator、打开的文件对象 file)。相反,单一的数值类型(如 int、float、complex)、布尔值 bool 以及空值 None 均不支持遍历操作,强行遍历会触发 TypeError。
一、支持遍历的核心数据类型与具体用法
了解某种类型是否支持遍历,最直观的体现是看它在循环体中被依次取出的元素结构。Python 的内置容器与流对象各具特性,以下分类说明常见类型的遍历特征与实际代码。
1. 序列类型(Sequence Types)
序列是有序元素的集合,每个元素都有固定的整数索引。遍历序列类型时,Python 会严格按照索引从 0 开始自前向后依次提取元素。
- 列表(list)与元组(tuple):最基础的容器,循环直接获得内部的每一个子元素。
- 字符串(str):在 Python 中字符串本身就是字符序列,遍历字符串会逐个取出单个 Unicode 字符。
- 范围对象(range):常用于计数循环,它是一个惰性计算的序列,按设定的步长生成整数。
- 字节与字节数组(bytes / bytearray):遍历时按序产出每个字节对应的十进制整数(0 到 255)。
# 列表与字符串遍历示例
fruits = ["苹果", "香蕉", "橙子"]
for fruit in fruits:
    print(fruit)
# 示例输出:
# 苹果
# 香蕉
# 橙子

greeting = "Hi!"
for char in greeting:
    print(char)
# 示例输出:
# H
# i
# !
2. 映射类型(Mapping Types)
Python 中最核心的映射类型是字典(dict)。字典由键值对(Key-Value)构成,支持三种不同视角的遍历:
- 默认遍历:直接对字典对象进行
for k in my_dict循环,遍历的是字典的所有键(Keys)。 - 遍历值:调用
my_dict.values(),循环获得所有对应的值。 - 遍历键值对:调用
my_dict.items(),每次循环获得一个包含(key, value)的元组,通常配合元组解包使用。
user_scores = {"张三": 92, "李四": 88, "王五": 95}

# 默认遍历键
for name in user_scores:
    print(name)

# 同时遍历键和值(推荐写法)
for name, score in user_scores.items():
    print(f"{name}: {score}分")
# 示例输出:
# 张三: 92分
# 李四: 88分
# 王五: 95分
3. 集合类型(Set Types)
集合(set)与不可变集合(frozenset)是去重且无序(无数值索引)的数据容器。集合支持遍历,但在逻辑上不保证具备像列表那样按索引访问的能力。在遍历集合时,循环体能够无遗漏地访问其中的每一个唯一元素。
unique_ids = {101, 102, 103, 101}
for item in unique_ids:
    print(item)
# 示例输出:
# 101
# 102
# 103
4. 迭代器、生成器与文件流对象
除了传统数据容器,Python 中还有一大类以“流”方式存在的对象,它们支持逐项读取并具备极高内存效率:
- 生成器表达式与函数(Generator):利用
yield关键字或生成器推导式创建,每次遍历实时产出下一个值,不会一次性占用全部内存。 - 迭代器(Iterator):通过
iter()转换得来,或由内置工具如enumerate()、zip()、reversed()返回的对象。 - 文件对象(File Objects):通过
open()打开的文件句柄本身就是可迭代对象,遍历它会逐行读入文本,非常适合读取 GB 级别的大文件。
二、Python 底层如何实现遍历:迭代协议解析
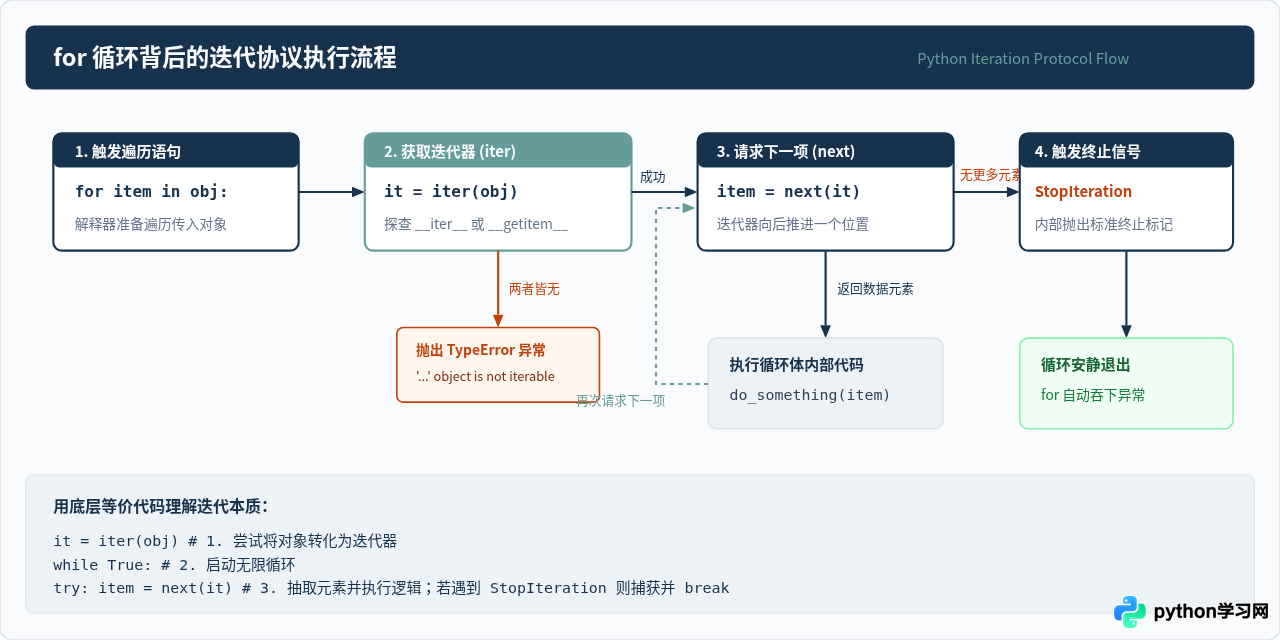
许多初学者以为 for 循环是通过计算长度后按下标递增读取的,但实际上,Python 采用的是迭代协议(Iteration Protocol)。这正是为什么即便没有数字下标的字典、集合以及无法提前知晓总长度的文件流对象,也能平滑进行 for 循环的根本原因。
1. 可迭代对象(Iterable)与迭代器(Iterator)
- 可迭代对象(Iterable):拥有
__iter__()方法,或者拥有支持从 0 开始连续整数索引的__getitem__()方法。容器本身通常是 Iterable。 - 迭代器(Iterator):除了拥有
__iter__()(返回自身),还必须实现__next__()方法。它像一个单向移动的游标,记录当前遍历状态,每次调用next()返回下一个元素。
2. for 循环的底层四个步骤
- 初始化获取迭代器:当执行
for x in obj:时,Python 解释器在底层自动调用内置函数iter(obj)。 - 查找底层协议:
iter()首先检查obj是否实现了__iter__(),如果是,调用它并获得一个专属的迭代器;若未实现,再退一步检查是否支持__getitem__();两者皆无则抛出TypeError: '...' object is not iterable。 - 逐次取值:进入循环,解释器不断在迭代器上调用
next(),将返回值赋给循环变量x,并执行循环体。 - 捕获终止异常:当所有元素取完时,
next()方法会抛出StopIteration异常。for循环在底层会自动捕获这个异常并安静地结束循环,对上层使用者完全透明。
三、如何判断一个未知对象是否支持遍历?
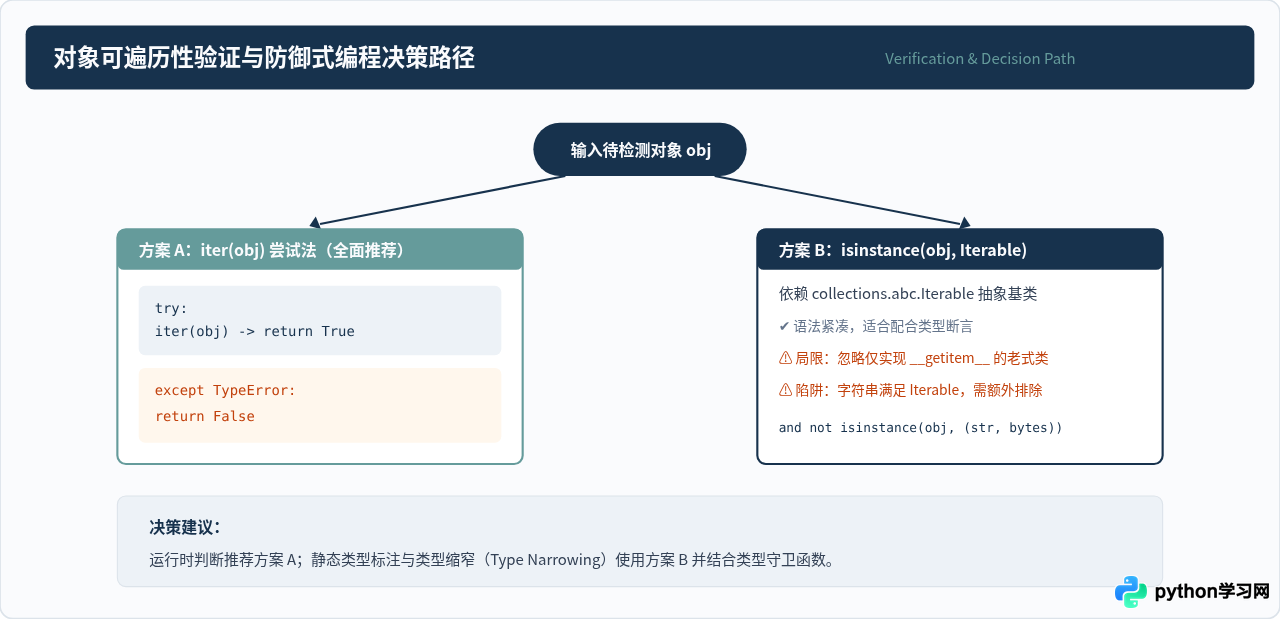
在日常开发、封装公共函数或编写装饰器时,我们往往需要提前检验传入的变量能否被 for 循环安全遍历。Python 提供了两种主要检测途径,各有侧重与使用边界。
方法 1:使用 iter() 函数与异常捕获(最稳健推荐)
最符合 Python “鸭子类型(Duck Typing)” 哲学的做法是直接尝试使用 iter(obj):如果该对象可以通过任何合法手段(包括现代的 __iter__ 或历史遗留但有效的 __getitem__)转为迭代器,则测试通过;若不能,系统会立即抛出 TypeError。
def is_iterable(obj):
    """
    判断对象是否支持遍历的最完整标准方法
    """
    try:
        iter(obj)
        return True
    except TypeError:
        return False

# 测试验证:
print(is_iterable([1, 2, 3]))    # True
print(is_iterable("hello"))      # True
print(is_iterable(100))          # False
print(is_iterable(None))         # False
方法 2:使用 collections.abc.Iterable 进行类型检测
Python 标准库的 collections.abc 模块提供了 Iterable 抽象基类。通过 isinstance(obj, Iterable) 可以快捷判断。但需要注意:这种方式仅检查对象是否实现了 __iter__ 方法,如果某老式自定义类仅实现了 __getitem__,isinstance 会返回 False,但它实际上完全能被 for 循环正常遍历。
字符串 str 也是合法的 Iterable。但在编写处理嵌套列表、平铺数据或序列化对象时,如果只写 if isinstance(x, Iterable):,字符串会被当成列表不断拆解成一个个字符,极易引发死循环或切片错误。通常应显式排查:
if isinstance(obj, Iterable) and not isinstance(obj, (str, bytes)):
四、常见不可遍历数据类型与排错处理
当尝试对不可遍历的对象使用 for 循环、列表推导式、* 解包或 iter() 时,程序会立即中断。理解常见报错场景有助于快速定位 Bug。
1. 常见报错形态
# 常见报错 1:对整型数字遍历
count = 5
for i in count:
    pass
# 触发报错:TypeError: 'int' object is not iterable

# 常见报错 2:函数无返回值时遍历
def get_user_list():
    # 忘记写 return 语句,默认返回 None
    pass

for user in get_user_list():
    pass
# 触发报错:TypeError: 'NoneType' object is not iterable
2. 典型失误场景与纠正方法
| 错误代码示例 | 根本原因 | 正确纠正方案 |
|---|---|---|
for i in 10: |
整型数值 10 是单一数字,不是序列容器 |
使用 range(10) 构造序列:for i in range(10): |
for row in db.execute(): 报 NoneType |
数据库查询无结果返回了 None,而非空列表 [] |
设置默认空容器:for row in (db.execute() or []): |
for k, v in my_dict: 报 cannot unpack |
直接遍历字典产出单个键,无法解包为两个变量 | 显式调用 items:for k, v in my_dict.items(): |
五、全数据类型遍历特征与选型总结
为了在实际开发中快速选用适合的数据类型并掌握正确的遍历语法,下表总结了各类支持遍历对象的关键特征、内存开销与典型应用场景:
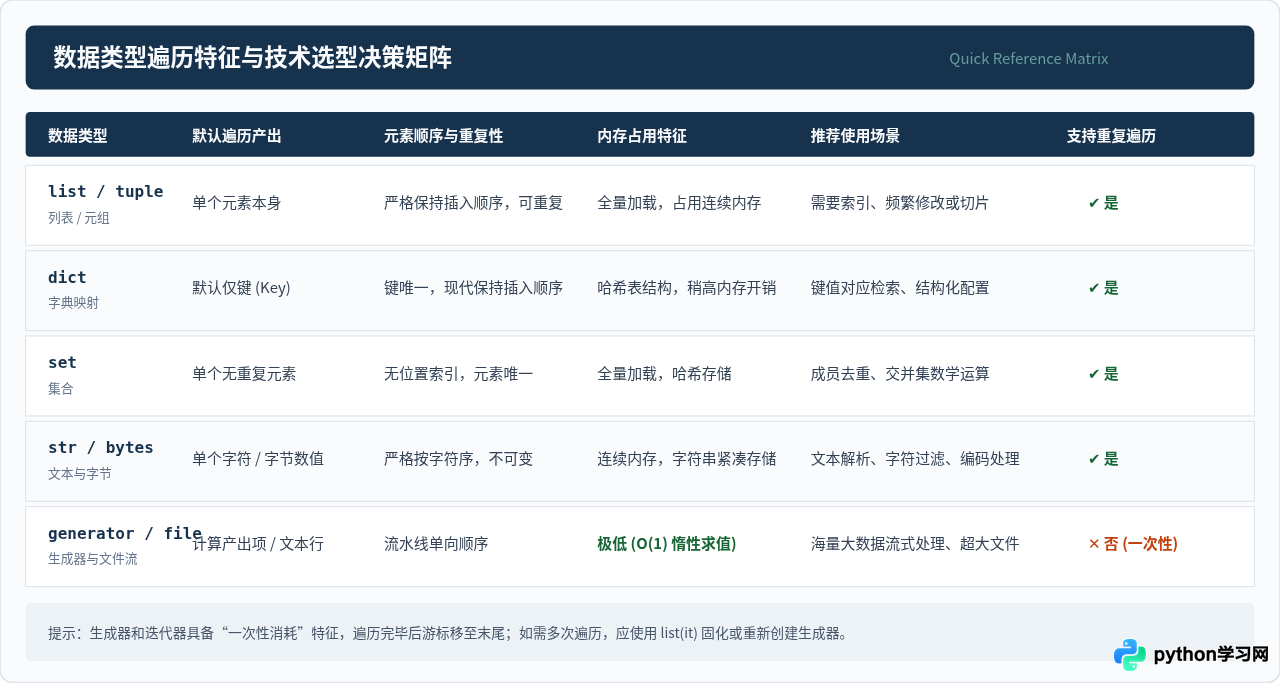
总结来说,判断 Python 数据类型能否遍历,不应只看其表面名字,而应关注其是否遵循了迭代协议。在日常编程中,凡涉及“批量集合、键值对映射、文本流以及由 yield 驱动的惰性计算”都天然支持遍历;而针对未知参数,使用 iter(obj) 进行防御式检测则是最优雅、健壮的工程实践。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









