

Python基础实战:用列表和字典完成5个新手练习项目
深入浅出掌握Python列表与字典:通过待办清单、成绩统计、词频分析、购物车与通讯录5个精选实战项目,掌握核心数据结构与实操技巧。
学习编程语言时,背诵语法规则和内置函数往往很快就会让人感到枯燥,而真正建立编程思维的有效途径,是在具体的小型任务中反复调度基础数据容器。在 Python 中,列表(list)与字典(dict)是支撑起绝大多数业务逻辑的基石:一个负责保持有序序列,另一个负责维护具名映射。本文将带你直接进入5个设计紧凑的新手练习项目,通过从零到一实现实际功能,牢固掌握列表与字典的核心操作、组合嵌套以及常见的边界处理方法。
一、核心选型:理解列表与字典的分工
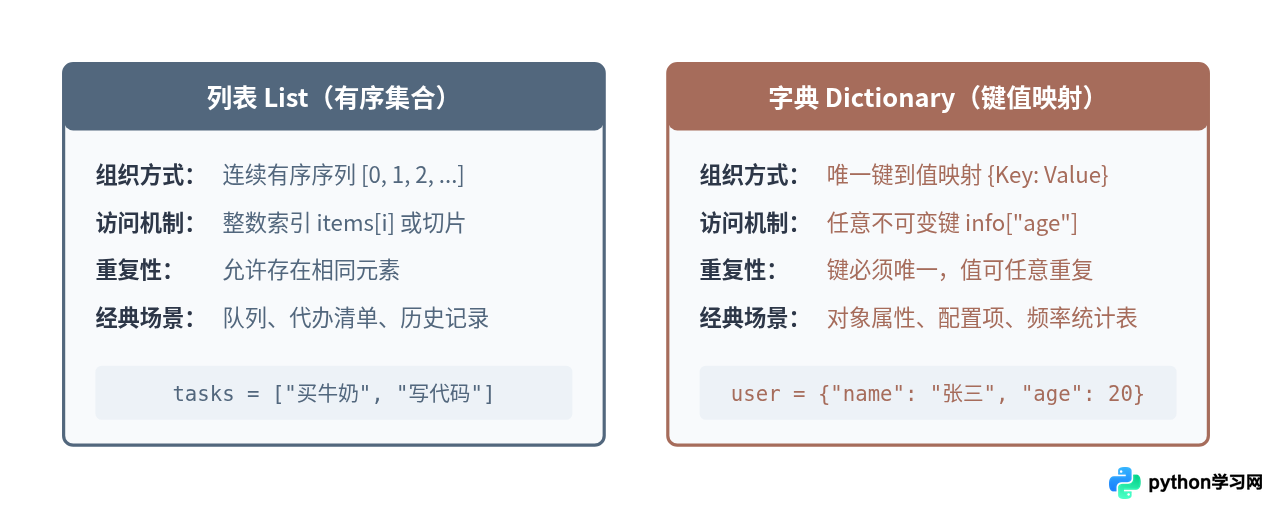
很多初学者在写代码时会陷入纠结:当前的数据到底应该存成列表还是字典?其实二者的选择取决于你对数据的访问方式与业务语义。列表关注“次序与批处理”,适合保存同质、有先后顺序或允许重复的元素集合;字典则关注“键值关联与精准检索”,适合保存具有明确字段属性或需要依据特定标识快速查找的数据。
二、从思路到代码:小型项目的通用开发步骤
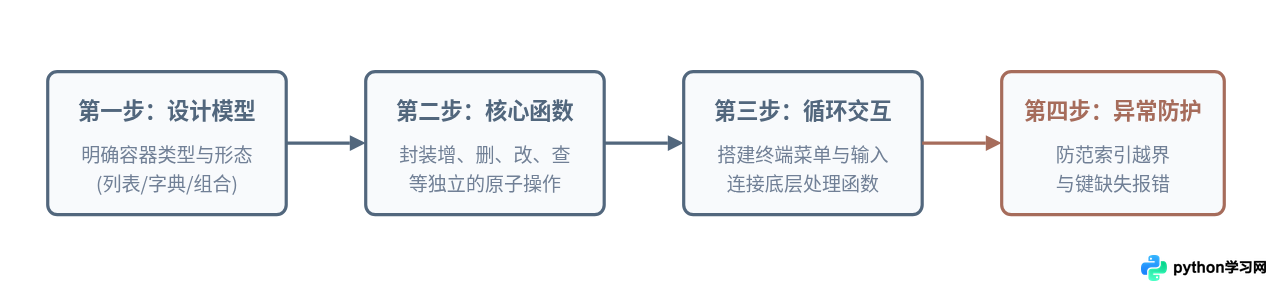
动手开发练习项目前,切忌提笔直接写 while True。合理的开发习惯是先界定数据格式,再编写基础操作函数,最后拼装交互流程。遵循结构化的开发路径,能够帮你理清逻辑、减少由于变量混乱带来的 Bug。
三、5个新手练习项目实战演练
项目一:轻量级命令行待办清单(To-Do List)
实战重点:列表初始化、append() 追加元素、pop() 按索引删除、enumerate() 配合遍历输出带序号的条目。
这个项目模拟生活中的清单工具,用户可以添加新任务、查看当前待办、以及勾销指定序号的任务。重点在于理解列表索引从 0 开始,而人类日常阅读习惯从 1 开始,两者的转换是初学者最容易踩的坑。
# todo_app.py

def show_tasks(tasks):
    if not tasks:
        print("\n[提示] 当前清单为空,没有待办事项。")
        return
    print("\n--- 当前待办事项 ---")
    for index, task in enumerate(tasks, start=1):
        print(f"{index}. {task}")
    print("-------------------")

def main():
    tasks = []
    while True:
        print("\n【待办清单菜单】 1.查看 2.添加 3.完成/删除 4.退出")
        choice = input("请输入操作编号 (1-4): ").strip()

        if choice == "1":
            show_tasks(tasks)
        elif choice == "2":
            new_task = input("请输入新任务内容: ").strip()
            if new_task:
                tasks.append(new_task)
                print(f"[成功] 已添加:{new_task}")
            else:
                print("[警告] 任务内容不能为空!")
        elif choice == "3":
            show_tasks(tasks)
            if not tasks:
                continue
            idx_str = input("请输入要删除的任务序号: ").strip()
            if idx_str.isdigit():
                idx = int(idx_str)
                # 检查序号是否合法
                if 1 <= idx <= len(tasks):
                    removed = tasks.pop(idx - 1)
                    print(f"[完成] 已移除任务:{removed}")
                else:
                    print("[错误] 序号超出范围,请输入有效序号!")
            else:
                print("[错误] 输入无效,请输入数字序号!")
        elif choice == "4":
            print("感谢使用,再见!")
            break
        else:
            print("[错误] 无效选项,请重新输入。")

if __name__ == "__main__":
    main()
tasks.pop(idx - 1) 巧妙地将用户输入的 1-based 序号映射为 Python 的 0-based 索引,并弹出目标任务;在弹出前通过 1 <= idx <= len(tasks) 进行范围防护,彻底避免 IndexError。
项目二:学生成绩统计分析器
实战重点:字典的键值存储 scores[name] = score、values() 列表提取、sum() 与 len() 聚合计算、items() 双变量遍历。
在学生成绩管理中,学生姓名是天然的唯一识别键(Key),分数则是对应的数据值(Value)。此项目实现录入、输出全班成绩单并一键计算最高分、最低分和平均分。
# grade_analyzer.py

def analyze_scores(scores):
    if not scores:
        print("[提示] 暂无成绩数据。")
        return

    vals = list(scores.values())
    total_students = len(vals)
    avg_score = sum(vals) / total_students
    max_score = max(vals)
    min_score = min(vals)

    print("\n====== 成绩单统计报表 ======")
    for student, score in scores.items():
        print(f"姓名: {student:<6} | 分数: {score}")
    print("----------------------------")
    print(f"总参考人数: {total_students}")
    print(f"全班平均分: {avg_score:.2f}")
    print(f"班级最高分: {max_score}")
    print(f"班级最低分: {min_score}")
    print("============================")

def main():
    # 使用字典存储 {姓名: 分数}
    class_scores = {}
    print("请输入学生成绩(输入 'q' 结束录入并查看分析):")
    while True:
        name = input("学生姓名: ").strip()
        if name.lower() == 'q':
            break
        if not name:
            print("姓名不能为空!")
            continue

        score_input = input(f"请输入 {name} 的分数 (0-100): ").strip()
        try:
            score = float(score_input)
            if 0 <= score <= 100:
                class_scores[name] = score
                print(f"[已记录] {name}: {score}")
            else:
                print("[错误] 分数必须在 0 到 100 之间!")
        except ValueError:
            print("[错误] 请输入合法的数值!")

    analyze_scores(class_scores)

if __name__ == "__main__":
    main()
项目三:文章高频词统计与敏感词过滤
实战重点:字符串拆分为列表 split()、字典计数字段更新 word_counts[w] = word_counts.get(w, 0) + 1、列表包含判断 w in banned_words。
这是自然语言处理最底层的核心雏形:利用字典统计单词出现的频次。我们结合一个禁用敏感词列表,既完成无用标点剔除与过滤,又计算出有效词汇出现的频次。
# word_counter.py

def count_words(text, banned_words):
    # 清洗标点符号
    for char in ",.!?;:'\",。!?;:“”":
        text = text.replace(char, " ")

    # 拆分成单词列表
    words = text.lower().split()
    frequency = {}

    for word in words:
        # 过滤敏感词及极短无意义词
        if word in banned_words or len(word) < 2:
            continue
        # 核心字典计数技巧:如果不存在则初始为0,再加1
        frequency[word] = frequency.get(word, 0) + 1

    return frequency

def main():
    sample_text = """
    Python is easy and Python is powerful. Many developers love Python because
    Python has clean syntax. Learning Python with projects makes coding fun!
    """
    banned = ["and", "is", "with", "has"]

    print("原始文本片段:", sample_text.strip())
    freq = count_words(sample_text, banned)

    print("\n--- 词频统计结果(按频次降序) ---")
    # 根据频次降序排序
    sorted_words = sorted(freq.items(), key=lambda item: item[1], reverse=True)
    for word, count in sorted_words:
        print(f"词汇: {word:<10} 出现次数: {count}")

if __name__ == "__main__":
    main()
项目四:简易电商购物车与结算系统
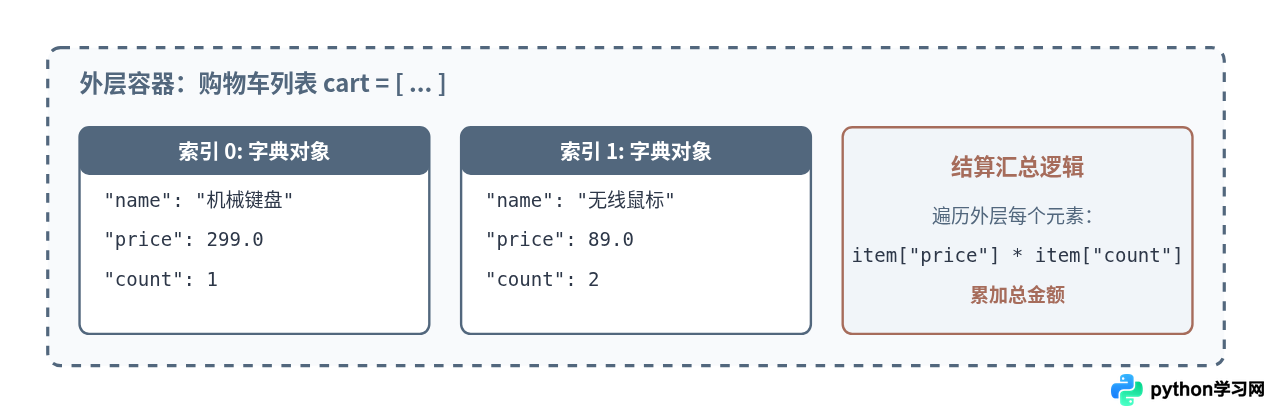
实战重点:复合数据模型——“列表中嵌套字典” [{"name": ..., "price": ..., "count": ...}]、复杂条件的循环查找与状态更新。
真实项目中的数据很少是单一维度的。一件商品同时具有“名称”、“单价”、“数量”等属性,使用字典描述非常合适;而购物车包含多件商品,使用列表容纳最为自然。这构成了 Python 中极为常见的“对象列表”模式。
# shopping_cart.py

def add_to_cart(cart, name, price, count=1):
    # 检查购物车中是否已经存在该商品
    for item in cart:
        if item["name"].lower() == name.lower():
            item["count"] += count
            print(f"[更新] {name} 数量增加至 {item['count']}")
            return
    # 不存在则追加新的字典条目
    cart.append({"name": name, "price": price, "count": count})
    print(f"[新增] 成功将 {name} 加入购物车!")

def checkout(cart):
    if not cart:
        print("[提示] 购物车空空如也,无需结算。")
        return

    print("\n========== 购物车明细 ==========")
    total_amount = 0.0
    for idx, item in enumerate(cart, 1):
        subtotal = item["price"] * item["count"]
        total_amount += subtotal
        print(f"{idx}. {item['name']:<10} 单价: ¥{item['price']:>6.2f}  数量: {item['count']:>2}  小计: ¥{subtotal:>7.2f}")

    print("--------------------------------")
    print(f"总计应付金额: ¥{total_amount:.2f}")
    print("================================")

def main():
    cart = []
    # 模拟用户加入商品
    add_to_cart(cart, "机械键盘", 299.0, 1)
    add_to_cart(cart, "无线鼠标", 89.0, 2)
    # 再次添加相同商品,触发数量累加
    add_to_cart(cart, "机械键盘", 299.0, 1)
    add_to_cart(cart, "Type-C拓展坞", 129.5, 1)

    checkout(cart)

if __name__ == "__main__":
    main()
项目五:支持模糊搜索的简易通讯录
实战重点:字典嵌套字典模型 contacts[name] = {"phone": ..., "email": ...}、子字段的检索与修改、模糊匹配算法(字符串 in 包含检测)。
在此项目中,联系人姓名作为外层字典的主键,内层字典存储电话、邮箱等多属性。我们支持根据关键字在所有联系人的姓名与电话中进行模糊匹配。
# contacts_manager.py

contacts = {}

def add_contact(name, phone, email):
    if name in contacts:
        print(f"[提示] 联系人 {name} 已存在,正在更新信息。")
    contacts[name] = {"phone": phone, "email": email}
    print(f"[成功] 联系人 {name} 保存成功!")

def search_contacts(keyword):
    keyword = keyword.lower()
    matches = {}
    for name, info in contacts.items():
        # 在姓名、电话或邮箱中进行匹配
        if keyword in name.lower() or keyword in info["phone"] or keyword in info["email"].lower():
            matches[name] = info

    if not matches:
        print(f"[查找] 未找到包含 '{keyword}' 的联系人。")
        return

    print(f"\n--- 找到 {len(matches)} 位匹配联系人 ---")
    for name, info in matches.items():
        print(f"姓名: {name:<8} | 电话: {info['phone']:<12} | 邮箱: {info['email']}")
    print("-----------------------------------")

def main():
    # 预填充测试数据
    add_contact("王小明", "13800138000", "xiaoming@example.com")
    add_contact("李晓华", "13912345678", "hua@company.com")
    add_contact("王大力", "13699887766", "dali@test.com")

    # 模糊查找包含“王”的联系人
    print("\n[搜索测试 1] 关键词:'王'")
    search_contacts("王")

    # 模糊查找电话包含“1234”的联系人
    print("\n[搜索测试 2] 关键词:'1234'")
    search_contacts("1234")

if __name__ == "__main__":
    main()
四、避坑指南:必须掌握的防错经验
在练习上述项目时,新手经常会遭遇几类典型异常与潜在陷阱,提前了解其成因能够极大提高调试效率:
- IndexError(索引越界):当尝试访问
my_list[len(my_list)]时必然报错。始终牢记最后一个元素的索引是len(my_list) - 1,或直接使用负索引my_list[-1]。 - KeyError(键不存在):访问
my_dict["unknown"]会直接导致程序崩溃。优先使用my_dict.get("unknown", 默认值),或者在访问前使用if "unknown" in my_dict进行判断。 - 引用赋值陷阱(浅拷贝 vs 赋值):执行
b = a并没有复制列表,两者指向内存中同一块区域,修改b会连带修改a。需要独立副本时请使用b = a.copy()或切片b = a[:]。
五、技能全景总结与进阶路径
通过这5个练习,我们由浅入深地经历了从简单列表维护到多重嵌套结构的演进。下方的技能矩阵概括了每个项目所锻造的核心能力:
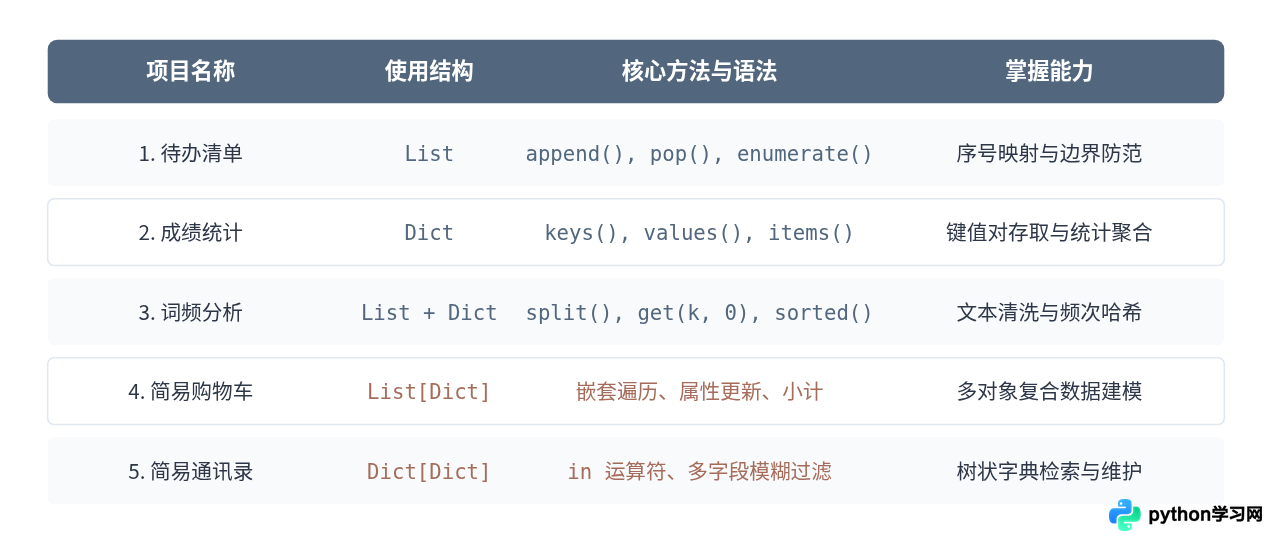
完成这五个基础练习后,你已经具备了管理中小型数据结构的能力。下一步可以尝试加入 json 模块,将列表与字典直接序列化保存到本地 .json 文件中,从而把这些纯内存工具真正升级为持久化运行的实用程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









